Diğer tüm tarayıcılar
User-agent: *
Kendine ait grubu olmayan her tarayıcı bu grubu okur.
- Sitenin tamamına izin verir.
Google bunu yok sayar; Bing okur.
Tema
Güvenebileceğiniz bir robots.txt oluşturun: her kural siz yazarken açıklanır, dosya robots.txt test aracımız tarafından RFC 9309'a ve Google'ın kendi yorumuna göre geri okunur ve yayımlamadan önce her tarayıcı ve her yol için anında bir karar görürsünüz.
Her ana makine ve protokol için bir dosya: www.example.com ve example.com ayrı ayrı birer dosya ister.
Kaynak: RFC 9309, okunma tarihi: 26 Ekim 2026.
Kendine ait grubu olmayan her tarayıcı bu grubu okur.
Bilinen her tarayıcının ne alacağını seçin. Kendine ait grubu olan bir tarayıcı yalnızca o grubu okur.
Bu tarayıcılar bir arama dizini oluşturmak için tarar. Engellenen sayfalar başka yerlerdeki bağlantılar üzerinden yine de listelenebilir, ama içlerinden hiçbir şey okunmadan.
Bu tarayıcılar model eğitmek için sayfa toplar. Ayrı bir belirteç, arama sonuçlarında görünmeye devam ederken eğitimi reddetmenizi sağlar.
Bu tarayıcılar soruları size geri bağlantı vererek yanıtlamak için sayfa getirir.
Bu tarayıcılar bir kişi istediği için tek bir sayfa getirir; bu yüzden bazı işletmeciler robots.txt'i yok sayabileceklerini söyler.
Bunları reddetmek bir taramayı değil, bir kişiyi reddetmektir: biri bir yapay zekâ asistanından sayfalarınızdan birini açmasını istediğinde, dosyaya uyan bir asistan o sayfayı bu kişi için okumaz. Kastettiğiniz eğitimse yukarıdaki eğitim tarayıcılarını reddedin.
Bağlantı önizlemeleri, site sahibi araçları, reklam kontrolleri, arşivler ve işletmecisi başka bir iş belirten ya da hiçbir şey belirtmeyen tarayıcılar.
robots.txt dosyanız/robots.txt
User-agent: *Allow: /HataUyarıNot23 B / 500 KiB
1 uyarı
Ne yapmalı Dosyadaki en zahmetsiz satırdır ve her tarayıcı onu okur. Sitemap dosyanızın tam adresiyle bir Sitemap: satırı ekleyin.
Bir tarayıcı ve bir yol seçin: karar, kararı veren kural ve tarayıcının okuduğu grup, Robots.txt Test Aracı'nın kendi eşleştiricisinden gelir.
Bu tarayıcı URL'yi isteyebilir.
User-agent: *başlangıç: satır 1
Hiçbir grupta bu tarayıcının adı geçmiyor, bu yüzden * grubu uygulanıyor.
Allow: /satır 2
/any-page
/
Yalnızca yol ve sorgu, yüzde kodlamasından sonra bayt bayt karşılaştırılır. Ana makine, protokol ve # işaretinden sonraki kısım hiçbir zaman bir kurala dahil değildir.
Kuralları yazın, bunları UTF-8 olarak kodlanmış ve robots.txt adını taşıyan düz bir metin dosyası olarak kaydedin ve sitenizin en üst düzeyine yükleyin; böylece dosya https://example.com/robots.txt adresinde yanıt verir. Gönderilecek bir şey yoktur: tarayıcılar bu adresi kendileri ister.
Google bunu üç cümleyle söyler: “Dosya, robots.txt olarak adlandırılmalıdır. Sitenizde yalnızca bir robots.txt dosyası olabilir. Robots.txt dosyası, geçerli olacağı sitenin ana makinesinin kök dizininde bulunmalıdır.” Dosya “UTF-8 olarak kodlanmış metin dosyası” olmalıdır ve “Google'ın tarayıcıları robots.txt dosyanızı otomatik olarak bulup kullanmaya başlar.”
Yukarıdaki oluşturucu bir hazır ayarla başlar, her kuralı siz yazarken açıklar ve sonucu siz kopyalamadan önce robots.txt test aracımızın ayrıştırıcısı ve eşleştiricisiyle geri okur. İndirilen dosyanın adı robots.txt olur: bayt sırası işareti olmadan UTF-8, yalnızca satır besleme karakterleri ve sizin istemediğiniz hiçbir tarih ya da yorum yok.
https://example.com/robots.txtGönderme adımı yoktur: Google'ın tarayıcıları dosyayı kendileri bulur.
 Hazır ayarın yaptıklarıVe yapmadıkları: bu hazır ayarların hiçbiri bir sayfayı Google'ın dışında tutmaz ve her biri bunu açıkça söyler.Her kural açıklanırBir kuralın engellediği ve kaçırdığı yollar, her kararı veren eşleştiricinin aynısından; bir de istisna açan daha uzun kural.Dosya ve bulgularıSatır numaralarıyla dosya; siz kopyalamadan önce Robots.txt Test Aracı'nın kendi denetimiyle geri okunur.KararBir tarayıcı ve bir yol seçin: izinli mi engelli mi, karar veren kural ve satırı, tarayıcının okuduğu grup.
Gruplar ve Sitemap satırları. Bir grup, tarayıcıları adlandıran bir veya daha fazla User-agent satırıyla başlar ve ardından bu tarayıcıların uyduğu Allow ve Disallow kuralları gelir; bir Sitemap satırı ise tüm grupların dışında, tek başına durur.
RFC 9309 bir grubu “ardından bir veya daha fazla kural gelen bir veya daha fazla user-agent satırı” olarak tanımlar ve bir tarayıcı tam olarak tek bir gruba uyar: kendi ürün belirtecinin geçtiği gruba ya da hiçbir grupta adı geçmiyorsa * grubuna. Google dört alanı okur, başkasını okumaz: user-agent, allow, disallow ve sitemap.
Yönerge adları büyük/küçük harfe duyarsızdır, yollar ise duyarlıdır: Google'ın kendi örneğinde disallow: /file.asp, /file.asp için geçerlidir “ancak” /FILE.asp için geçerli değildir. Bir Sitemap: satırı, protokol ve ana makine dahil tam bir adres olmalıdır; bu oluşturucu başka türlüsünü reddeder ve nedenini söyler.
User-agent: *Kendine ait grubu olmayan her tarayıcı için bir grup başlatırDisallow: /cart/Bu tarayıcıların getirmemesi gereken bir yolAllow: /cart/helpBir istisna: Disallow kuralından daha uzun, bu yüzden kazanır User-agent: GPTBotİki tarayıcıyı adlandıran bir grup başlatırUser-agent: ClaudeBotDisallow: /İkisi de sitenin tamamından reddedilir Sitemap: https://www.example.org/sitemap.xmlTüm grupların dışında: tam bir adres* ve $: bir kural nasıl eşleşir?Bir URL ile birden fazla kural eşleştiğinde, türü ne olursa olsun yolu en uzun olan kazanır; eşitlikte Allow kazanır. * herhangi bir karakter dizisinin yerini tutar, $ ise URL'nin sonunu belirtir; bir yolda başka hiçbir şeyin özel anlamı yoktur.
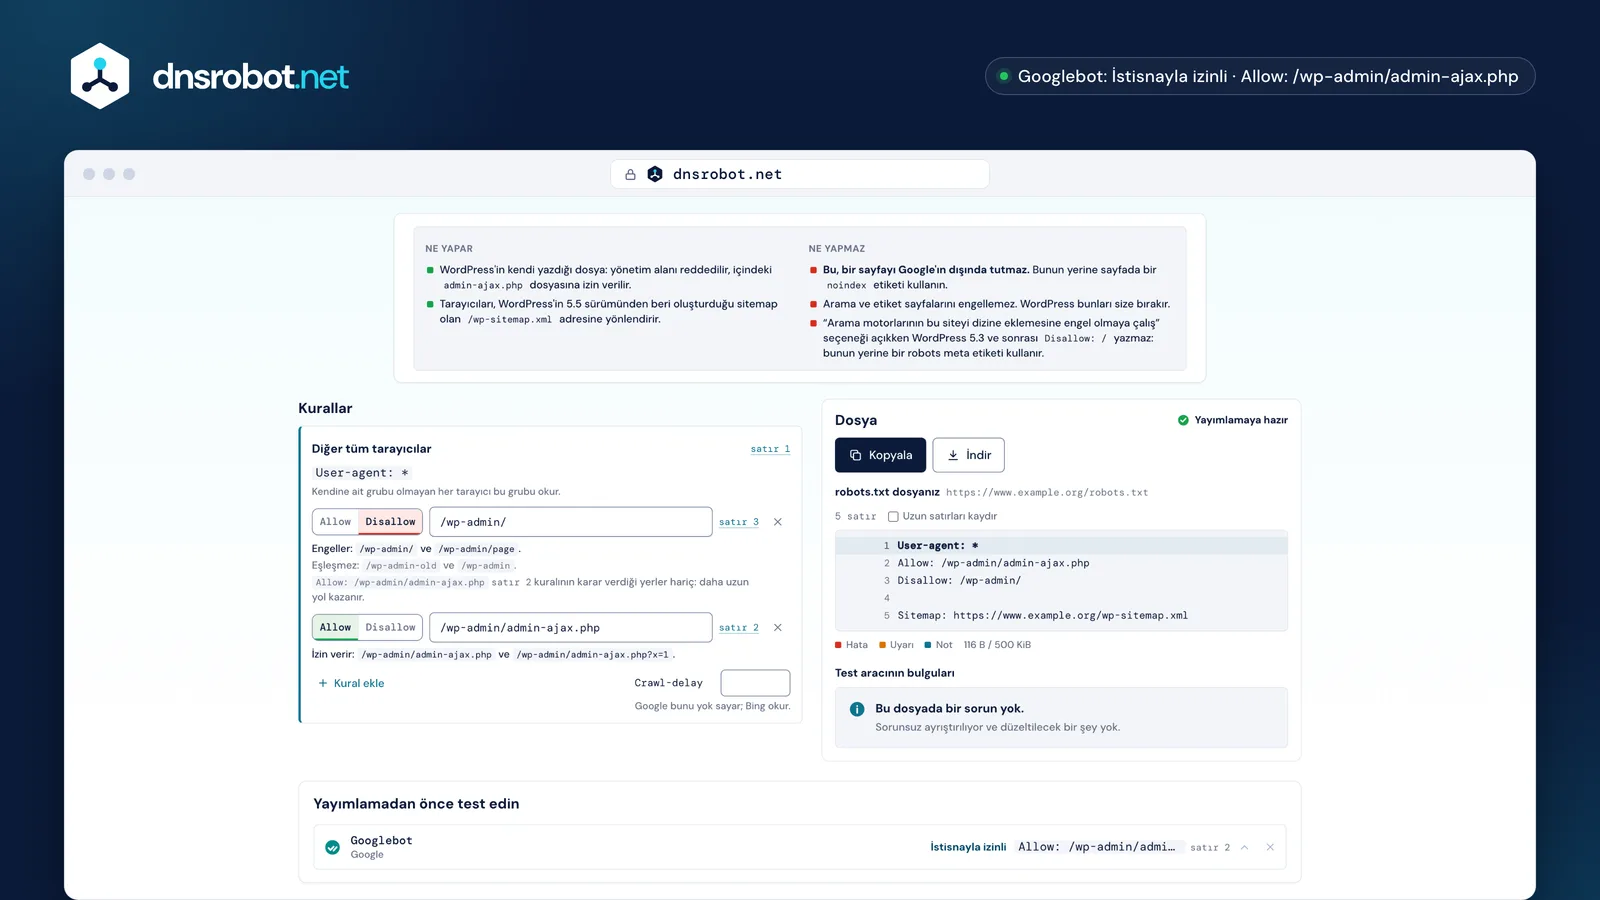
RFC 9309: “Bulunan en spesifik eşleşme KULLANILMALIDIR. En spesifik eşleşme, en çok oktete sahip eşleşmedir” ve “bir allow kuralı ile bir disallow kuralı eşdeğerse allow kuralının kullanılması ÖNERİLİR.” WordPress'in kendi dosyası da böyle çalışır: Disallow: /wp-admin/ klasörü kapatır, daha uzun olan Allow: /wp-admin/admin-ajax.php ise içindeki tek bir dosyayı açar.
$ içermeyen bir kural bir ön ektir, bu yüzden Disallow: /admin aynı zamanda /administrator yolunu da engeller; klasörü kastediyorsanız eğik çizgiyi ekleyin (/admin/). Yukarıdaki düzenleyici her kuralın altında, kuralın yakaladığı yolları ve yakalamadığı bazılarını, her kararı veren eşleştiricinin aynısıyla gösterir ve başka bir kuralın her zaman üstün geldiği bir kuralı işaretler.
* ile $ ve her kalıbın gerçekte yakaladıkları/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ ve + sıradan karakterlerdir. robots.txt'te düzenli ifade yoktur.
/admin/report.pdfAllow kazanır: yolun daha büyük kısmıyla eşleşir.
Disallow: /files/7 karakterAllow: /files/7 karakterUzunluklar eşit, bu yüzden Allow kazanır. Google'ın deyişiyle “en az kısıtlayıcı olan kural”.
Üçü de zaten bir robots.txt sunar ve yukarıdaki hazır ayarlar her platformun kendi belgelerinin anlattığını yazar: WordPress yönetim alanını reddeder ama admin-ajax.php dosyasına izin verir, Shopify sepetleri, ödeme sayfalarını ve filtrelenmiş ya da sıralanmış koleksiyonları reddeder, Next.js ise app/robots.txt içine koyduğunuz dosyayı sunar.
WordPress dosyasını kodda, do_robots() içinde yazar: User-agent: *, yönetim yolu için bir Disallow, admin-ajax.php için bir Allow ve herkese açık bir sitede WordPress 5.5 sürümünden beri /wp-sitemap.xml için bir Sitemap: satırı. “Arama motorlarının bu siteyi dizine eklemesine engel olmaya çalış” seçeneği açıkken WordPress 5.3 ve sonrası artık Disallow: / yazmaz; bunun yerine bir robots meta etiketi kullanır.
Shopify, varsayılan dosyasının “çoğu mağaza için işe yaradığını” söyler. Yüklenecek bir dosya yoktur: değiştirmek, temanın robots.txt.liquid şablonunu düzenlemek demektir ve Shopify bunu “desteklenmeyen bir özelleştirme” olarak adlandırır. Next.js, app/robots.txt dosyasını yazıldığı gibi sunar ya da dosyayı app/robots.ts üzerinden oluşturur.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlWordPress'in kendisi yazar. Bir eklentiyle veya robots_txt filtresiyle değiştirin.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlShopify'ın varsayılanı. Temanın robots.txt.liquid şablonunda değiştirin.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlapp/robots.txt içindeki kendi dosyanız ya da app/robots.ts; /robots.txt adresinde sunulur.
Tarayıcının adının geçtiği ve altında Disallow: / bulunan bir grup, işletmecisi robots.txt'e uyduğunu söyleyen her tarayıcı için işe yarar, yalnızca onlar için. Bu, tarayıcının uyduğu bir ricadır, bir kilit değil: dosyayı yok sayan bir tarayıcı yine de her sayfayı getirebilir.
Yapay zekâ şirketlerinin çoğu birden fazla tarayıcı çalıştırır, bu yüzden her iş için ayrı karar verin. GPTBot veya ClaudeBot gibi bir eğitim tarayıcısını reddetmek, modeller için sayfa toplayan tarayıcıyı reddeder; OAI-SearchBot veya PerplexityBot gibi bir yanıt tarayıcısını reddetmek ise sizi bu asistanların gösterdiği bağlantılardan da çıkarır. Google'ın eğitim belirteci Googlebot değildir: “Google-Extended, bir sitenin Google Arama'ya dahil edilmesini etkilemez ve Google Arama'da sıralama sinyali olarak kullanılmaz.”
Üçüncü tür farklıdır. ChatGPT-User, Claude-User, Perplexity-User ve Amzn-User, bir kişi bir asistandan bir sayfayı açmasını istediği için o tek sayfayı getirir; bu yüzden onları reddetmek o kişiyi reddetmektir ve bazı işletmeciler bu tarayıcıların robots.txt'i zaten yok sayabileceğini söyler. Yukarıdaki tarayıcı listesi bu nedenle onları kendilerine ait bir bölümde tutar.
GPTBotUyarOAI-SearchBotUyarChatGPT-UserYok sayabilirClaudeBotUyarClaude-SearchBotUyarClaude-UserUyarPerplexityBotUyarPerplexity-UserYok sayabilirGoogle-ExtendedYalnızca belirteçBöyle bir tarayıcı yokBöyle bir tarayıcı yokApplebot-ExtendedYalnızca belirteçBöyle bir tarayıcı yokBöyle bir tarayıcı yokmeta-externalagentUyarmeta-webindexerUyarmeta-externalfetcherYok sayabilirAmazonbotUyarBöyle bir tarayıcı yokAmzn-UserYok sayabilirrobots.txt tarayıcılardan bir sayfayı getirmemelerini ister; bir arama motorundan onu listelememesini istemez. Başka sayfalar ona bağlantı verdiğinde Google “URL'yi dizine ekleyip arama sonuçlarında snippet olmadan gösterebilir”. Bir sayfayı dışarıda tutmak için noindex kullanın ve etiketin okunabilmesi için sayfayı taranabilir bırakın.
Search Console buna “robots.txt tarafından engelleniyor olsa da dizine eklendi” der. Google da açıkça söylüyor: noindex kuralının etkili olabilmesi için sayfanın “robots.txt dosyası tarafından engellenmemesi” gerekir. İzin verilmeyen bir sayfanın kendi noindex etiketi hiçbir zaman görülmez, çünkü tarayıcı sayfayı hiç getirmez.
Bu yüzden yukarıdaki her hazır ayar ne yapmadığını da söyler. Staging hazır ayarındaki Disallow: / kibar tarayıcıları dışarıda tutar, ama herhangi bir yerden bağlantı verilen bir staging URL'si yine de listelenebilir: staging ortamını bir parolanın arkasına koyun ve bu satırı asla canlı siteye taşımayın.
<meta name="robots" content="noindex">Hiç okunmazBir sayfayı dışarıda tutmak için: tarayıcıyı içeri alıp noindex kullanın ya da giriş yapmayı zorunlu kılın.
Geçerli olduğu ana makinenin kökünde, /robots.txt olarak; her ana makine ve protokol için bir dosya. https://example.com/robots.txt, https://www.example.com veya https://shop.example.com hakkında hiçbir şey söylemez: her birinin kendi dosyası olmalıdır ve bir klasörün içindeki robots.txt hiçbir zaman okunmaz.
Google: “Robots.txt dosyasını, desteklenen bir protokol üzerinde sitenin en üst düzey dizinine yerleştirmelisiniz.” Search Console'un robots.txt raporu, bir mülkteki ilk 20 ana makinenin dosyalarını ayrı ayrı listeler; HTTP ve HTTPS ayrı sayılır.
Sitenizi oluşturucunun en üstüne yazın: oluşturucu, dosyanın yanıt vermesi gereken tam adresi verir, o ana makine için Sitemap: satırını doldurur ve dosya yayına girdiğinde canlı dosyayı okuyan Robots.txt Test Aracı'na bağlantı verir.
https://example.com/robots.txthttps://example.com üzerindeki her URLhttps://www.example.com/robots.txtYalnızca www.example.com: ayrı bir ana makinehttp://example.com/robots.txtYalnızca http:// sitesi: ayrı bir protokolhttps://shop.example.com/robots.txtYalnızca shop.example.comhttps://example.com/blog/robots.txtHiçbir yer: bir klasördeki robots.txt hiçbir zaman okunmazGoogle bunların hiçbirini okumaz. Crawl-delay yönergesini Bing, Clean-param yönergesini Yandex okur; Host ne standartta ne de Google'ın listesinde yer alır; Cloudflare'in Content-Signal satırı ise neyin taranabileceğini değil, içeriğinizin ne için kullanılabileceğini belirtir.
Google dört alanını sıralar ve “crawl-delay gibi diğer alanlar desteklenmez” diye ekler. Bing'in kendi blogu “crawl-delay yönergesi değer olarak yalnızca pozitif tam sayıları kabul eder” der; bu yüzden düzenleyici kesirli bir değer yazmak yerine onu reddeder. Bing'in güncel yardım sayfası bir aralığı veya birimi doğrulamak için okunamadı, bu yüzden bu sayfa ikisini de belirtmez.
Hiçbiri bir dosyayı bozmaz: RFC 9309'a göre diğer kayıtların ayrıştırılması “açıkça tanımlanmış kayıtların ayrıştırılmasına MÜDAHALE ETMEMELİDİR”. Bu dördünden oluşturucu yalnızca Crawl-delay yazar ve onu kimin okuduğunu belirten bir etiketle yazar.
User-agentOkurOkurOkurAllowOkurOkurOkurDisallowOkurOkurOkurSitemapOkurOkurOkurCrawl-delayYok sayarOkurDoğrulanmadıClean-paramYok sayarYok sayarOkurHostYok sayarYok sayarDoğrulanmadınoindexYok sayarDoğrulanmadıDoğrulanmadıContent-SignalYok sayarDoğrulanmadıDoğrulanmadıİki kez. Yayımlamadan önce, yukarıdaki Yayımlamadan önce test edin bölümüyle: bir tarayıcı ve bir yol seçin, karar veren kuralı görün. Dosyayı yükledikten sonra canlı dosyada Robots.txt Test Aracı'nı çalıştırın, çünkü sunucunun verdiği yanıt da dosyanın söyledikleri kadar önemlidir.
404 yanıtı veren bir dosya hiç dosya yokmuş gibi okunur, yani her tarayıcı her şeyi alabilir; 500 veya 503 yanıtı veren bir dosya ise standarda uyan bir tarayıcının hiçbir şey almaması gerektiği anlamına gelir. RFC 9309 §2.3.1.4: tarayıcı “tam bir engelleme olduğunu VARSAYMALIDIR”. Google bunu kendi basamaklarıyla yumuşatır; şekilde gösterilmiştir.
Google'ın kendi robots.txt test aracı artık yok: Search Central, 15 Kasım 2023'te aracın kullanımdan kaldırılacağını duyurdu ve onun yerini alan robots.txt raporu, Google'ın getirdiği dosyayı gösterir ama bir URL'yi bir kurala karşı test etmez. Bu testi yukarıdaki oluşturucudaki Yayımlamadan önce test edin bölümü ve robots.txt test aracımız yapar.
200Dosyadaki kurallara uyar.301, 302En az beş yönlendirme atlamasını izler, sonra durur. Google bundan sonra dosyayı 404 olarak okur.403, 404Dosya yokmuş gibi her şeyi tarar.429Hiçbir şey taramaz. Google bunu 4xx yanıtlarıyla değil, 5xx yanıtlarıyla birlikte sayar.500, 503Standarda göre hiçbir şey taramaz.Böyle bir ad yokOkunacak bir site yok, bu yüzden karar da yok.Pahalıya patlayan hataların her biri kısa tek bir satırdır: staging'den kalma bir Disallow: /, istediğinizden daha ileriye uzanan bir ön ek, yol olarak yazılmış bir Sitemap: satırı, başında eğik çizgi olmayan bir yol ve Google'ın 2019'da okumayı bıraktığı bir noindex satırı.
Her biri siz dosyayı kopyalamadan önce burada yakalanır. Test aracının kendi denetimi siz yazarken çalışır ve bulguları dosyanın altında durur; bir tarayıcının reddedeceği bir satır hiç yazılmaz ve düzenleyici, satırın neden dışarıda bırakıldığını ilgili kural satırında söyler.
Hatalardan biri tek bir satır değil, bir çifttir: burada izin verilmeyen ve sayfada noindex de taşıyan bir URL. Tarayıcı sayfayı hiç getirmez, bu yüzden noindex etiketini hiç görmez ve URL arama sonuçlarında kalabilir. Birini seçin: taramayı engelleyin ya da tarayıcıyı içeri alıp ona dizine eklememesini söyleyin.
Disallow: /Staging'den kalma: canlı sitenin tamamı her tarayıcıya kapalı.Disallow: /admin/administrator ve /admin-tools yollarını da engeller. Sona eğik çizgi ekleyin.User-agent: * altında Allow: /Dosyanın herhangi bir yerinde kendi grubu olan bir tarayıcı bunu hiç okumaz.Sitemap: /sitemap.xmlBir Sitemap satırı, ana makineyi içeren tam bir adres olmalıdır.Disallow: adminYol / ile başlar. Bu kural hiçbir şeyle eşleşmez.noindex: /private/2019'dan beri ölü. Sayfa taranabilir ve dizine eklenebilir kalır.* grubunu hiç okumaz. Yukarıdaki düzenleyici başka bir kuralın her zaman üstün geldiği kuralı işaretler; Yayımlamadan önce test edin ise karar veren kuralı ve tarayıcının okuduğu grubu gösterir.Herhangi bir sitenin robots.txt dosyasını getirin, bir URL'nin Googlebot veya AI tarayıcıları için engellenip engellenmediğini test edin ve söz dizimi hatalarını bulun
Web sitenizi tarayın ve bir XML site haritası, bir HTML site haritası ve görsel bir site ağacı edinin
Bir web sitesinin XML sitemap dosyasını bulun ve doğrulayın: söz dizimi, URL sınırları, lastmod tarihleri, robots.txt çakışmaları ve bozuk veya yönlendiren URL'ler
Bir sayfanın title, meta açıklama, canonical, hreflang, Open Graph ve X card etiketlerini Google ve sosyal medya önizlemeleriyle kontrol edin
HTTP yanıt başlıklarını ve güvenlik başlıkları derecelendirmesini analiz edin
User Agent dizgisinden tarayıcı, işletim sistemi, cihaz türü, oluşturma motoru ve CPU mimarisini algılayın