











Link Analizi
Link analizi ile bir sayfadaki her bağlantıyı Google'ın okuduğu gibi görün: iç bağlantı mı dış bağlantı mı, takip edilen mi nofollow mu, sponsored mı ugc mi, her biri gerçekte nereye varıyor ve hangileri kırık. Bağlantı kontrolü tek adımda.
Alan adı da olur: example.org için ana sayfa okunur.
- GetirmeHTML'i bir kez okur
- YönlendirmelerEn fazla 10, her biri kontrol edilir
- Robotsmeta + X-Robots-Tag
- Bulunan bağlantılar<a> ve <area>
Link analizi neyi kontrol eder?
Link analizi bir sayfayı okur ve üzerindeki her bağlantıyı listeler: her biri nereye gidiyor, arama motorları için nasıl işaretlenmiş, bağlantı metni ne diyor ve takip ettiğinizde gerçekte nereye varıyor.
Sayfanın HTML'ini Googlebot'un ilk gördüğü şekilde okur. Google, href içeren <a> öğelerini takip eder (Google); göreli bağlantılar sayfanın <base href> değerine, o yoksa yönlendirmelerden sonraki adresine göre çözümlenir (HTML).
Ardından her benzersiz URL bir kez GET ile istenir ve yönlendirmeler adım adım izlenir. HEAD isteği daha hızlıdır, ancak sunucular ona çoğu zaman gerçek bir ziyaretten farklı yanıt verir; bu yüzden bir yönlendirmenin arkasında 404'e varan bağlantı burada yine kırık sayılır.
- 1Nereye gidiyordışwww.rfc-editor.org
- 2Nasıl işaretlenmişnofollowmw:extlinkkorunur, SEO anlamı yok
- 3Ne diyor“1035”
- 4Nereye varıyor↳ 301 /info/rfc1035/OK 200185 ms
- 5Nerede duruyor1.117 bağlantıdan 187. bağlantı, “Contents” başlığının altında
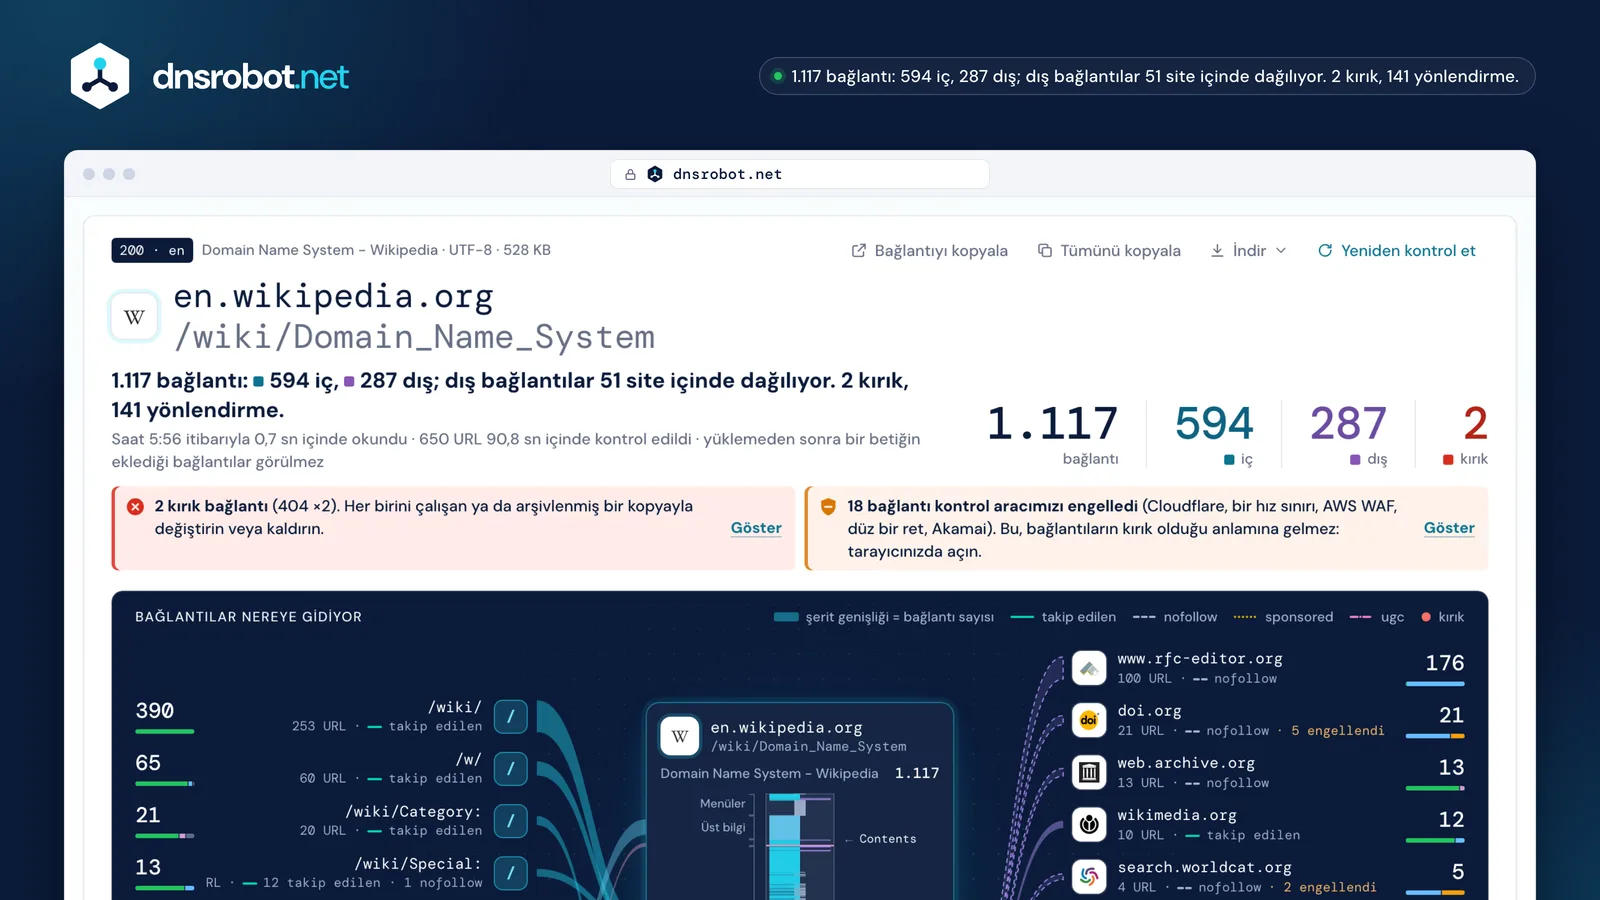
 Önce yanıtSayfada kaç bağlantı olduğu, kaçının siteden çıkmadığı, kaçının siteden çıktığı ve kaçının kırık olduğu.Çözümü olan notlarKırık bağlantılar, yalnızca bot korumasının durdurduğu bağlantılar, güncellemeye değer yönlendirmeler, boş bağlantı metinleri: her biri sayısı ve yapılacak işle birlikte.Sayfa, baştan sonaHer bağlantı için sayfadaki yerinde bir işaret: menüler, makale, kaynakça, alt bilgi.Bağlantılar nereye gidiyorHer bölüm ve her site için bağlantı sayısı kadar geniş bir şerit; bağlantılar nofollow ise kesikli çizgiyle gösterilir.
İç bağlantı ve dış bağlantı: hangisi neye sayılır?
İç bağlantı, sayfayla aynı ana makineye giden bağlantıdır; dış bağlantı başka bir web sitesine gider. Aynı sitenin başka bir ana makinesine giden bağlantılar, örneğin en.wikipedia.org'dan de.wikipedia.org'a, ayrı sayılır.
İç bağlantılar okurların ve tarayıcıların sitenin diğer sayfalarını bulmasına yardım eder; önemli her sayfaya en az bir başka sayfadan bağlantı verilmelidir (Google). Dış bağlantılar kendi başına risk değildir: iyi kaynaklara atıf yapmak okurun sayfaya güvenmesine yardım eder.
Google, nofollow'u her dış bağlantı için değil, yalnızca onaylamadığınız bağlantılar için önerir. #section bağlantısı aynı sayfada kalır ve Google parçaları ayrı sayfa saymaz (Google).
- aynı ana makine 514
- aynı site, başka ana makine 80
- başka site 287
- aynı sayfa 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_nameiçSayfayla aynı ana makine: iç bağlantı.
- de.wikipedia.org/wiki/Domain_Name_Systemaynı siteAynı site (wikipedia.org), başka ana makine: ayrı sayılır.
- www.wikidata.org/wiki/Q8767dışWikimedia işletse de başka bir alan adı: dış bağlantı.
- www.rfc-editor.org/rfc/rfc1035dışBaşka bir alan adı: dış bağlantı.
nofollow, sponsored ve ugc (ve “dofollow” neden bir öznitelik değil)
rel="nofollow" arama motorlarından bağlantıyı sizin onayınız saymamalarını ister, rel="sponsored" ücretli bir bağlantıyı veya reklamı, rel="ugc" ise kullanıcılarınızın yazdığı bir bağlantıyı işaretler. Bunların hiçbirini taşımayan bağlantı takip edilir: dofollow diye bir değer yoktur.
10 Eylül 2019'dan beri üçü de komut değil ipucudur, 1 Mart 2020'den beri tarama ve dizine ekleme için de öyledir (Google). Değerler ugc nofollow gibi birleştirilebilir; boşluk veya virgülle ayrılır.
En önemlisi şu: sponsored veya nofollow olmayan ücretli bir bağlantı Google'ın spam politikalarını ihlal eder (Google). Okuduğumuz Wikipedia makalesinde 287 dış bağlantının 267'si nofollow taşır; bunu MediaWiki her kaynağa ekler.
<a href>Takip edilir, varsayılan olarak: eklenecek bir şey yokrel="nofollow"Onaylamayın: başka hiçbir değer uymuyorsarel="sponsored"Ücretli veya reklam: ücretli bağlantılarda gerekir (veya nofollow)rel="ugc"Kullanıcıların yazdığı: yorumlar, forum gönderilerirel="ugc nofollow"İkisi birden: eski tarayıcılar için serbestrel="dofollow"Bir değer değil: tarayıcılar ve Google yok sayar
- 2005Google nofollow'u duyurur
- 2019-09-10sponsored ve ugc gelir; üçü de ipucu olur
- 2020-03-01tarama ve dizine ekleme için de ipucu
Sayfanın kendisi nofollow diyorsa?
O zaman Google, her bağlantının kendi rel değeri ne olursa olsun hiçbirini takip etmez. nofollow içeren bir robots meta etiketi veya X-Robots-Tag header tüm sayfa için geçerlidir; bu araç her bağlantıyı “nofollow (sayfa)” olarak işaretler.
Google, robots ve googlebot adlarını gövdede bile olsa her durumda okur ve none, noindex artı nofollow anlamına gelir (Google). Aynı kurallar X-Robots-Tag: nofollow gibi bir header olarak da gelebilir.
Wikipedia'nın sürüm geçmişi sayfaları bilerek noindex,nofollow taşır. Bu aracın önceki sürümü etiketi hiç okumuyordu ve bir geçmiş sayfasının ilk 200 bağlantısının 194'ünü takip edilen olarak sayıyordu.
ilk 200 bağlantıdan: meta etiketi hiç okunmuyordu
bağlantı, hepsi nofollow (sayfa): Google hiçbirini takip etmez
543 nofollow (sayfa)6 nofollowX-Robots-Tag: none
Kırık bağlantılar: nasıl bulunur ve düzeltilir
URL'si 404 Not Found veya 410 Gone gibi bir hatayla yanıt veriyorsa, böyle bir hataya yönlendiriyorsa ya da adı mevcut değilse bağlantı kırıktır. Sayfayı analiz edin, sonra Kırık sekmesini açın.
Her birini sayfanın yeni adresine, arşivlenmiş bir kopyaya bağlayarak ya da bağlantıyı tamamen kaldırarak düzeltin. Google 4xx sayfalarını dizininden çıkarır (Google) ve bağlantıyı izleyen okur hiçbir yere varmaz.
Her hata kırık demek değildir: 401 giriş ister, yani sayfa vardır (RFC 9110); 5xx veya zaman aşımı çoğu zaman geçer, bu yüzden bunları sonra tekrar kontrol edin. Okuduğumuz makalede 656 URL'nin 2'si kırıktı, ikisi de kaynakçasında; üçüncüsü düz bir 403 yanıtı verdi ve onu engellendi olarak listeliyoruz.
- umbrella.cisco.com404
Sayfa kalktı
Cisco blog yazısını kaldırdı; sunucu bunu açıkça söylüyor.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeweb.archive.org üzerindeki arşivlenmiş kopyaya bağlayın veya bağlantıyı kaldırın.- http://www.apwg.org301
- https://…/1H2010.pdf404
404'te biten bir yönlendirme
http:// adresi https:// adresine taşınıyor ve PDF orada değil. Yönlendirme olarak değil, kırık sayılır.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfRaporun şimdi nerede olduğunu bulun veya bir arşiv kaynak gösterin.- www.akamai.com403
Düz bir 403: engellendi, kırık değil
Sunucu, bot koruması izi olmadan kontrol aracımızı reddetti. Dosya kalkmış olabilir ya da sunucu botları geri çeviriyor olabilir.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfTarayıcınızda açın; açılıyorsa bağlantıyı koruyun.

Bağlantılardaki yönlendirmeler: düzeltmeye değer mi?
Yönlendiren bir bağlantı hâlâ çalışır, ancak her atlama bir istek ve zaman harcar. Bağlantıları son adrese yöneltin; en çok da iki ucunu da denetlediğiniz kendi sitenizdeki bağlantıları.
301 veya 308 taşınmanın kalıcı olduğunu söyler; 302, 303 veya 307 geçicidir ve Google eski adresi göstermeyi sürdürür (Google). Googlebot en fazla 10 atlamayı, tarayıcılar en fazla 20 atlamayı izler (Google).
rfc-editor.org artık /rfc/ sayfalarını /info/ adresine yönlendiriyor; bu yüzden okuduğumuz makaledeki 175 bağlantı fazladan bir atlama yapıyor. 404'te biten bir yönlendirme burada yönlendirme değil, kırık sayılır.
- doi.org/10.17487/RFC1035302302: geçici, kullanılacak adres eski URL olarak kalır
- www.rfc-editor.org/info/rfc1035301301: kalıcı taşındı, yeni URL'ye bağlantı verin
- www.rfc-editor.org/info/rfc1035/200
bağlantı rfc-editor.org/rfc/… adresine gidiyor; bu adres artık /info/… adresine yönleniyor
URL, sayfanın 656 URL'si içinde yönlendiriyor
Googlebot'un izlediği en fazla atlama; tarayıcılar 20'den sonra vazgeçer
“Burada engellendi ama tarayıcımda çalışıyor”
Birçok site sayfalarının önüne bot koruması koyar. JavaScript çalıştırmayan veya betik gibi görünen ziyaretçileri durdurur; bu yüzden kontrol aracımız 403 veya 429 alırken tarayıcınız geçer. Bu bağlantılar kırık değil, Engellendi olarak listelenir.
Cloudflare doğrulamalarını cf-mitigated: challenge header'ıyla işaretler (Cloudflare) ve olağandışı user agent'a sahip istemcileri varsayılan olarak doğrulamaya yönlendirir; 429 çok fazla istek anlamına gelir (RFC 6585).
Dürüst bir user agent gönderiyoruz ve hiçbir engeli aşmaya çalışmıyoruz. Okuduğumuz makalede 18 URL engellendi: 17'si Cloudflare, AWS WAF, Akamai ve hız sınırları, biri düz bir 403 nedeniyle. Herhangi bir şeyi değiştirmeden önce bunları kendiniz açın.
- Cloudflare doğrulaması7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Hız sınırı (429)3search.worldcat.org · api.semanticscholar.org · 429
- Akamai bot koruması1dyn.com → www.oracle.com · 403
Bir sayfada kaç bağlantı olabilir?
Sınır yoktur. Google'ın yönergeleri bir sayı belirlemez ve ideal bir sayı olmadığını söyler; 100 bağlantının altında kalma yönündeki eski tavsiye, Google'ın sayfanın yalnızca bir bölümünü okuduğu döneme aittir.
Önemli olan, her bağlantının okura yardım etmesi, önemli olanların HTML'de gerçek <a href> bağlantıları olması ve Googlebot'un Arama için okuduğu tek şey olan HTML'in ilk 2 MB'ı içinde yer almasıdır (Google).
Okuduğumuz Wikipedia makalesi 528 KB'lık HTML içinde 1.117 bağlantı taşır. example.com'un HTML'inde ise hiç bağlantı yok: tek bağlantısı sayfa yüklendikten sonra bir betikle ekleniyor.
- wikipedia.org/wiki/Domain_Name_System1.117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0tek bağlantısı bir betikle ekleniyor
Bağlantı metni ve görsel bağlantılar
Bağlantı metni, bağlantının tıklanabilir metnidir; okura ve Google'a hedefin ne hakkında olduğunu söyler. Görsel bağlantıda Google, görselin alt metnini bağlantı metni olarak okur; bu yüzden alt metni boş bir görsel bağlantı hiçbir şey söylemez.
İyi bağlantı metinleri kısa ve özgüldür, hedefi tanımlar; “buraya tıklayın” ve “devamını oku” kimseye bir şey anlatmaz (Google). Bir bağlantının metni yoksa Google title özniteliğine başvurur.
Bu araç her görsel bağlantının alt metnini gösterir, boş olanları işaretler ve tekrarlanan bağlantı metinlerini listeler. Okuduğumuz makalede “edit”, 49 bağlantının metni: bölüm düzenleme bağlantıları, Wikipedia'da sorun değil, başka yerde zayıf.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>bağlantı metniDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>bağlantı metniGörselWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>bağlantı metniBoşhiçbir şey: boş bir bağlantı
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank ve noopener: hâlâ gerekli mi?
Güncel tarayıcılarda hayır. target="_blank" içeren bir bağlantı yeni sekme açar ve her büyük tarayıcı artık bunu rel="noopener" gibi ele alır: yeni sayfa geriye uzanıp sizinkini değiştiremez. noopener eksikliği risk olarak değil, not olarak listelenir.
HTML standardı 2019'da _blank'in noopener anlamına geldiğini belirledi (HTML); Safari 12.1, Firefox 79 ve Chrome 88 bunu uyguladı. noreferrer ayrıca ziyaretçinin nereden geldiğini gizler: bir gizlilik ve analiz tercihidir, güvenlik düzeltmesi değil.
<a target="_blank">hiç rel yokwindow.opener→ null- 2019-02HTML: _blank, noopener anlamına gelirwhatwg/html #4330
- 2019Safari 12.1örtük noopener
- 2020Firefox 79örtük noopener
- 2021Chrome 88örtük noopener
- dnsrobot.net/blog/hosting-com-coupon23 bağlantının 23 tanesinde noopener veya noreferrer var
- github.com10 bağlantının 10 tanesinde noopener veya noreferrer var
- developer.mozilla.org/en-US/10 bağlantının 10 tanesinde noopener veya noreferrer var
Link efsaneleri, Google'ın kendi sayfalarına göre kontrol edildi
Çoğu bağlantı tavsiyesi birkaç eski kuralı tekrar eder. Google'ın belgelerinin bunların her biri hakkında bugün ne söylediği burada.
| Efsane | Google ne diyor | Kaynak |
|---|---|---|
| Yanlış“dofollow”, eklediğiniz bir özniteliktir | Bağlantılar varsayılan olarak takip edilir; yalnızca nofollow, sponsored ve ugc bir anlam taşır. | developers.google.com |
| YanlışDış bağlantılara nofollow koymak siteyi cezalandırtır | Google nofollow veya sponsored'ı yalnızca ücretli bağlantılarda ve onaylamadığınız bağlantılarda ister. | developers.google.com |
| EskimişBir sayfayı 100 bağlantının altında tutun | Sayfa başına bağlantı için sınır da ideal bir sayı da yoktur. | developers.google.com |
| YanlışNofollow bir sayfayı dizinin dışında tutar | Bir sayfayı Google'dan uzak tutmak için taramaya izin verin ve noindex kullanın. | developers.google.com |
| EskimişNofollow bağlantılar hiçbir şey aktarmaz | 2019'dan beri ipucudurlar: Google onları kullanabilir, ancak sıralama için genellikle hâlâ saymaz. | developers.google.com |
| Eskimişnoopener olmayan target=_blank bir güvenlik açığıdır | Güncel tarayıcılar, rel=opener açıkça istemedikçe _blank bağlantılarında noopener'ı örtük kabul eder. | html.spec.whatwg.org |
Kaynaklar
- Google Search Central: taranabilir bağlantılar, giden bağlantıları nitelendirme, robots meta etiketi, HTTP durum kodları
- HTML Living Standard (bağlantılar, rel değerleri, temel URL) ve RFC 9110 (durum kodları)
- Cloudflare: doğrulama sayfasını algılama
- Sayılar: en.wikipedia.org/wiki/Domain_Name_System adresinde 23 Ekim 2026'da yaptığımız kendi çalıştırmamız
Link Analizi SSS
Bu bağlantıya tıklamak güvenli mi?
Bir web sayfasındaki tüm bağlantıları nasıl bulurum?
İç bağlantı ile dış bağlantı arasındaki fark nedir?
nofollow ne demek ve dofollow gerçek bir öznitelik mi?
rel="sponsored" veya rel="ugc" ne zaman kullanılır?
Bir bağlantı neden kırık değil de “Engellendi” olarak işaretleniyor?
Bir bağlantı neden yönlendirir ve düzeltmeli miyim?
JavaScript ile eklenen bağlantıları buluyor mu?
Sayfa otomatik okuyucuları engelliyor. Yine de analiz edebilir miyim?
Kaç bağlantıyı kontrol ediyor?
Bir sayfada kaç bağlantı olmalı?
Link Analizi ücretsiz mi ve sayfaları saklıyor musunuz?
Eksik bir şey mi var?Bir özellik ya da yeni bir araç önerin
Diğer web sitesi ve SEO araçları
Alt Alan Adı Bulucu
Herhangi bir alan adının tüm alt alan adlarını keşfedin
Site Erişim Kontrolü
Site herkes için mi çöktü, yoksa sadece sizin için mi? Herhangi bir siteyi 11 konumdan ve kendi bağlantınızdan, canlı ekran görüntüsüyle kontrol edin
SSL Sertifika Kontrolü
SSL sertifika geçerliliğini ve güvenlik ayrıntılarını doğrulayın
Hosting Sorgulama
Herhangi bir sitenin nerede barındırıldığını bulun: hosting, CDN, CMS, e-posta sağlayıcısı, kayıt şirketi ve SSL sağlayıcısı
WHOIS Sorgulama
RDAP ile alan adı kayıt bilgileri, kayıtçı ve sahip bilgilerini sorgulayın
IP Kara Liste Kontrolü
IP adresinin spam veya zararlı yazılım kara listelerinde olup olmadığını kontrol edin