











Phân Tích Liên Kết
Tìm link và kiểm tra link của một trang đúng như Google đọc: nội bộ hay bên ngoài, được theo dõi hay nofollow, sponsored hay ugc, mỗi link thực sự dẫn đến đâu và link nào bị hỏng.
Chỉ cần tên miền cũng được: example.org sẽ đọc trang chủ của nó.
- Tải trangĐọc HTML một lần
- Chuyển hướngTối đa 10, mỗi lần đều được kiểm tra
- Robotsmeta + X-Robots-Tag
- Link tìm thấy<a> và <area>
Công cụ phân tích liên kết kiểm tra những gì?
Công cụ phân tích liên kết đọc một trang và liệt kê mọi link trên đó: mỗi link dẫn đến đâu, được đánh dấu thế nào cho công cụ tìm kiếm, anchor text của nó nói gì và nó thực sự dẫn đến đâu khi bạn theo nó.
Nó đọc HTML của trang đúng như Googlebot thấy lần đầu. Google theo các phần tử <a> có href (Google); link tương đối được phân giải theo <base href> của trang, nếu không có thì theo địa chỉ của trang sau chuyển hướng (HTML).
Sau đó, mỗi URL duy nhất được yêu cầu một lần bằng GET, và các chuyển hướng được theo từng bước. Yêu cầu HEAD nhanh hơn, nhưng máy chủ thường trả lời nó khác với một lượt truy cập thật, nên một link kết thúc bằng 404 sau chuyển hướng vẫn được tính là hỏng ở đây.
- 1Dẫn đến đâubên ngoàiwww.rfc-editor.org
- 2Được đánh dấu thế nàonofollowmw:extlinkđược giữ, không có ý nghĩa SEO
- 3Nó nói gì“1035”
- 4Cuối cùng đến đâu↳ 301 /info/rfc1035/OK 200185 ms
- 5Nằm ở đâulink 187/1.117, dưới “Contents”
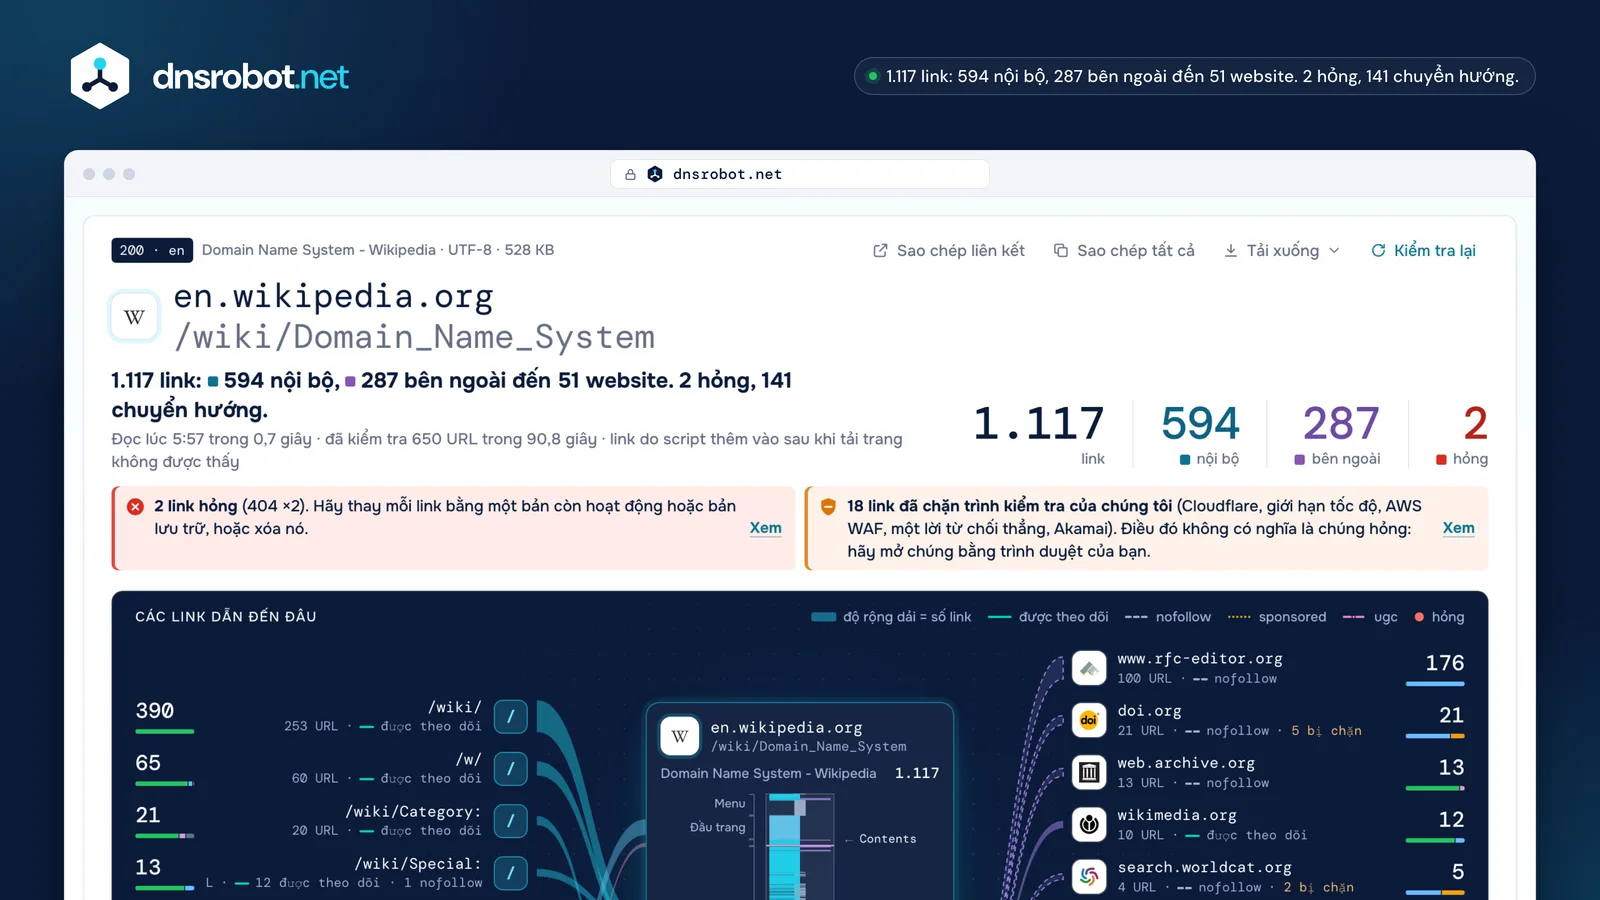
 Câu trả lời trước tiênTrang có bao nhiêu link, bao nhiêu link ở lại website và bao nhiêu link đi ra ngoài, và bao nhiêu link bị hỏng.Ghi chú kèm cách sửaLink hỏng, link chỉ bị tường chặn bot chặn, chuyển hướng nên cập nhật, anchor trống: mỗi mục kèm số lượng và việc cần làm.Trang, từ trên xuống dướiMỗi link một vạch tại đúng vị trí của nó trên trang: menu, bài viết, phần tham khảo, chân trang.Các link dẫn đến đâuMỗi khu vực và mỗi website một dải, rộng theo số link của nó, nét đứt khi các link là nofollow.
Link nội bộ và link bên ngoài: cái nào tính là cái nào?
Link nội bộ trỏ đến cùng host với trang; link bên ngoài trỏ đến một website khác. Link đến một host khác của cùng website, như de.wikipedia.org từ en.wikipedia.org, được đếm riêng.
Link nội bộ giúp người đọc và trình thu thập dữ liệu tìm thấy các trang khác của website; mọi trang quan trọng nên được ít nhất một trang khác liên kết tới (Google). Link bên ngoài tự nó không phải rủi ro: dẫn nguồn tốt giúp người đọc tin trang hơn.
Google chỉ gợi ý nofollow cho những link bạn không bảo chứng, không phải cho mọi link bên ngoài. Link đến #section ở lại cùng trang, và Google không coi phần fragment là trang riêng (Google).
- cùng host 514
- cùng website, host khác 80
- website khác 287
- cùng trang 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_namenội bộCùng host với trang: nội bộ.
- de.wikipedia.org/wiki/Domain_Name_Systemcùng websiteCùng website (wikipedia.org), host khác: được đếm riêng.
- www.wikidata.org/wiki/Q8767bên ngoàiTên miền khác, dù Wikimedia vận hành: bên ngoài.
- www.rfc-editor.org/rfc/rfc1035bên ngoàiTên miền khác: bên ngoài.
nofollow, sponsored và ugc (và vì sao “dofollow” không phải là thuộc tính)
rel="nofollow" đề nghị công cụ tìm kiếm không tính một link là sự giới thiệu của bạn, rel="sponsored" đánh dấu link trả phí hoặc quảng cáo, và rel="ugc" đánh dấu link do người dùng của bạn viết. Link không có giá trị nào trong số đó sẽ được theo dõi: không có giá trị dofollow.
Từ ngày 10 tháng 9 năm 2019, cả ba đều là gợi ý chứ không phải mệnh lệnh, và từ ngày 1 tháng 3 năm 2020 cũng áp dụng cho việc thu thập dữ liệu và lập chỉ mục (Google). Các giá trị có thể kết hợp, như ugc nofollow, ngăn cách bằng dấu cách hoặc dấu phẩy.
Điều quan trọng nhất: link trả phí không có sponsored hoặc nofollow vi phạm chính sách spam của Google (Google). Trong bài Wikipedia chúng tôi đã đọc, 267 trong 287 link bên ngoài mang nofollow, do MediaWiki thêm vào mọi trích dẫn.
<a href>Được theo dõi theo mặc định: không cần thêm gìrel="nofollow"Không bảo chứng: khi không có giá trị nào khác phù hợprel="sponsored"Trả phí hoặc quảng cáo: cần cho link trả phí (hoặc nofollow)rel="ugc"Do người dùng viết: bình luận, bài đăng diễn đànrel="ugc nofollow"Cả hai: được phép, cho các trình thu thập dữ liệu cũ hơnrel="dofollow"Không phải giá trị: trình duyệt và Google bỏ qua
- 2005Google giới thiệu nofollow
- 2019-09-10sponsored và ugc ra đời; cả ba trở thành gợi ý
- 2020-03-01gợi ý cho cả việc thu thập dữ liệu và lập chỉ mục
Nếu chính trang khai báo nofollow thì sao?
Khi đó Google không theo link nào của trang, bất kể rel của từng link ghi gì. Thẻ meta robots hoặc header X-Robots-Tag có nofollow áp dụng cho cả trang; công cụ này đánh dấu mỗi link là “nofollow (trang)”.
Google đọc tên robots và googlebot không phân biệt hoa thường, kể cả trong phần body, và none nghĩa là noindex cộng nofollow (Google). Quy tắc tương tự có thể đến dưới dạng header, như X-Robots-Tag: nofollow.
Các trang lịch sử chỉnh sửa của Wikipedia mang noindex,nofollow có chủ ý. Phiên bản trước của công cụ này chưa bao giờ đọc thẻ đó và tính 194 trong 200 link đầu của một trang lịch sử là được theo dõi.
trong 200 link đầu: thẻ meta chưa bao giờ được đọc
link, tất cả nofollow (trang): Google không theo link nào
543 nofollow (trang)6 nofollowX-Robots-Tag: none
Link hỏng: cách tìm và sửa
Một link bị hỏng khi URL của nó trả lời bằng lỗi như 404 Not Found hoặc 410 Gone, hoặc chuyển hướng đến một lỗi như vậy, hoặc khi tên của nó không tồn tại. Hãy phân tích trang, rồi mở thẻ Hỏng để kiểm tra link.
Sửa từng link bằng cách liên kết đến địa chỉ mới của trang, một bản lưu trữ, hoặc không liên kết gì cả. Google loại các trang 4xx khỏi chỉ mục (Google), và người đọc theo link sẽ chẳng đến đâu cả.
Không phải lỗi nào cũng nghĩa là hỏng: 401 yêu cầu đăng nhập, nên trang vẫn tồn tại (RFC 9110), còn 5xx hoặc hết thời gian chờ thường qua đi, nên hãy kiểm tra lại sau. Trong bài chúng tôi đã đọc, 2 trong 656 URL bị hỏng, cả hai nằm ở phần tham khảo; link thứ ba trả lời 403 thẳng, mà chúng tôi liệt kê là bị chặn.
- umbrella.cisco.com404
Trang đã biến mất
Cisco đã gỡ bài blog; máy chủ nói thẳng điều đó.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeLiên kết đến bản lưu trữ trên web.archive.org, hoặc xóa link.- http://www.apwg.org301
- https://…/1H2010.pdf404
Một chuyển hướng kết thúc bằng 404
http:// chuyển sang https://, và tệp PDF không có ở đó. Được tính là hỏng, không phải chuyển hướng.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfTìm xem báo cáo hiện nằm ở đâu, hoặc dẫn một bản lưu trữ.- www.akamai.com403
Một 403 thẳng: bị chặn, không phải hỏng
Máy chủ từ chối trình kiểm tra của chúng tôi mà không có dấu hiệu chặn bot. Tệp có thể đã mất, hoặc máy chủ từ chối bot.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfHãy mở nó trong trình duyệt; nếu mở được, hãy giữ lại.

Chuyển hướng trong link: có đáng sửa không?
Link chuyển hướng vẫn hoạt động, nhưng mỗi bước tốn một yêu cầu và thời gian. Hãy trỏ link đến địa chỉ cuối cùng, nhất là các link bên trong website của bạn, nơi bạn kiểm soát cả hai đầu.
301 hoặc 308 nói rằng việc chuyển là vĩnh viễn; 302, 303 hoặc 307 là tạm thời, và Google tiếp tục hiển thị địa chỉ cũ (Google). Googlebot theo tối đa 10 bước, trình duyệt tối đa 20 (Google).
rfc-editor.org hiện chuyển các trang /rfc/ sang /info/, nên 175 link trong bài chúng tôi đã đọc phải qua thêm một bước. Một chuyển hướng kết thúc bằng 404 được tính là hỏng ở đây, không phải là chuyển hướng.
- doi.org/10.17487/RFC1035302302: tạm thời, URL cũ vẫn là URL nên dùng
- www.rfc-editor.org/info/rfc1035301301: đã chuyển vĩnh viễn, hãy liên kết URL mới
- www.rfc-editor.org/info/rfc1035/200
link trỏ đến rfc-editor.org/rfc/…, nay chuyển sang /info/…
trong 656 URL của trang chuyển hướng
bước Googlebot theo tối đa; trình duyệt bỏ cuộc sau 20
“Bị chặn ở đây, nhưng mở được trong trình duyệt của tôi”
Nhiều website đặt tường chặn bot trước các trang của mình. Nó chặn những khách không chạy JavaScript hoặc trông giống tự động, nên trình kiểm tra của chúng tôi nhận 403 hoặc 429 trong khi trình duyệt của bạn vẫn qua được. Những link này được liệt kê là Bị chặn, không phải hỏng.
Cloudflare đánh dấu các thử thách của mình bằng header cf-mitigated: challenge (Cloudflare) và mặc định thử thách các client có user agent bất thường; 429 nghĩa là quá nhiều yêu cầu (RFC 6585).
Chúng tôi gửi user agent trung thực và không bao giờ tìm cách vượt tường chặn. Trong bài chúng tôi đã đọc, 18 URL bị chặn: 17 do Cloudflare, AWS WAF, Akamai và giới hạn tốc độ, một do 403 thẳng. Hãy tự mở chúng trước khi bạn thay đổi bất cứ điều gì.
- Thử thách của Cloudflare7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Giới hạn tốc độ (429)3search.worldcat.org · api.semanticscholar.org · 429
- Chặn bot của Akamai1dyn.com → www.oracle.com · 403
Một trang có thể có bao nhiêu link?
Không có giới hạn. Hướng dẫn của Google không đặt con số nào và nói rằng không có số lượng lý tưởng; lời khuyên cũ giữ dưới 100 link có từ thời Google chỉ đọc một phần của trang.
Điều quan trọng là mỗi link giúp ích cho người đọc, những link quan trọng là link <a href> thật trong HTML, và chúng nằm trong 2 MB HTML đầu tiên, phần duy nhất Googlebot đọc cho Tìm kiếm (Google).
Bài Wikipedia chúng tôi đã đọc có 1.117 link trong 528 KB HTML. example.com hoàn toàn không có link nào trong HTML: link duy nhất của nó do một script thêm vào sau khi trang tải xong.
- wikipedia.org/wiki/Domain_Name_System1.117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0link duy nhất của nó do một script thêm vào
Anchor text và link ảnh
Anchor text là phần chữ có thể nhấp của một link; nó cho người đọc và Google biết đích nói về điều gì. Với link ảnh, Google đọc văn bản alt của ảnh làm anchor, nên link ảnh có alt trống không nói lên điều gì.
Anchor tốt ngắn, cụ thể và mô tả đích đến; “bấm vào đây” và “xem thêm” chẳng cho ai biết gì (Google). Google quay về dùng thuộc tính title khi link không có chữ.
Công cụ này hiển thị văn bản alt của mọi link ảnh, đánh dấu các link trống và liệt kê các anchor lặp lại. Trong bài chúng tôi đã đọc, “edit” là anchor của 49 link: link sửa từng mục, ổn trên Wikipedia nhưng yếu ở bất kỳ nơi nào khác.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>anchorDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>anchorẢnhWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>anchorTrốngkhông gì cả: một link trống
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank và noopener: còn cần không?
Không cần với các trình duyệt hiện nay. Link có target="_blank" mở một thẻ mới, và mọi trình duyệt lớn giờ đều xử lý nó như rel="noopener": trang mới không thể quay lại và thay đổi trang của bạn. Thiếu noopener được liệt kê là ghi chú, không phải rủi ro.
Chuẩn HTML đã cho _blank ngầm hiểu noopener từ năm 2019 (HTML); Safari 12.1, Firefox 79 và Chrome 88 đã triển khai. noreferrer còn ẩn việc khách đến từ đâu: đó là lựa chọn về quyền riêng tư và phân tích, không phải bản vá bảo mật.
<a target="_blank">hoàn toàn không có relwindow.opener→ null- 2019-02HTML: _blank ngầm hiểu noopenerwhatwg/html #4330
- 2019Safari 12.1noopener ngầm định
- 2020Firefox 79noopener ngầm định
- 2021Chrome 88noopener ngầm định
- dnsrobot.net/blog/hosting-com-coupon23/23 có noopener hoặc noreferrer
- github.com10/10 có noopener hoặc noreferrer
- developer.mozilla.org/en-US/10/10 có noopener hoặc noreferrer
Những lầm tưởng về link, đối chiếu với chính các trang của Google
Hầu hết lời khuyên về link lặp lại vài quy tắc cũ. Dưới đây là điều tài liệu của Google nói về từng quy tắc hiện nay.
| Lầm tưởng | Google nói gì | Nguồn |
|---|---|---|
| Sai“dofollow” là một thuộc tính bạn thêm vào | Link được theo dõi theo mặc định; chỉ nofollow, sponsored và ugc mới có ý nghĩa. | developers.google.com |
| SaiDùng nofollow cho link bên ngoài khiến website bị phạt | Google chỉ yêu cầu nofollow hoặc sponsored cho link trả phí và link bạn không bảo chứng. | developers.google.com |
| Đã lỗi thờiGiữ một trang dưới 100 link | Không có giới hạn và không có số link lý tưởng cho mỗi trang. | developers.google.com |
| SaiNofollow giữ một trang ngoài chỉ mục | Để giữ một trang ngoài Google, hãy cho phép thu thập dữ liệu và dùng noindex. | developers.google.com |
| Đã lỗi thờiLink nofollow không truyền gì cả | Từ năm 2019 chúng là gợi ý: Google có thể dùng chúng, dù nhìn chung vẫn không tính chúng cho xếp hạng. | developers.google.com |
| Đã lỗi thờitarget=_blank không có noopener là một lỗ hổng bảo mật | Các trình duyệt hiện nay ngầm hiểu noopener cho link _blank, trừ khi rel=opener yêu cầu opener. | html.spec.whatwg.org |
Nguồn
- Google Search Central: link có thể thu thập, link ra ngoài đủ điều kiện, thẻ meta robots, mã trạng thái HTTP
- HTML Living Standard (link, giá trị rel, URL gốc) và RFC 9110 (mã trạng thái)
- Cloudflare: nhận biết một thử thách
- Các con số: lượt chạy của chính chúng tôi trên en.wikipedia.org/wiki/Domain_Name_System, ngày 23 tháng 10 năm 2026
Câu hỏi thường gặp về Phân Tích Liên Kết
Link này có an toàn để nhấp không?
Làm sao để tìm link và xem tất cả link trên một trang web?
Link nội bộ và link bên ngoài khác nhau thế nào?
nofollow nghĩa là gì, và dofollow có phải thuộc tính thật không?
Khi nào nên dùng rel="sponsored" hoặc rel="ugc"?
Vì sao một link bị đánh dấu “Bị chặn” mà không phải hỏng?
Vì sao một link chuyển hướng, và tôi có nên sửa không?
Công cụ có tìm được link do JavaScript thêm vào không?
Trang chặn trình đọc tự động. Tôi vẫn phân tích được không?
Công cụ kiểm tra link này xử lý được bao nhiêu link?
Một trang nên có bao nhiêu link?
Phân Tích Liên Kết có miễn phí không, và các bạn có lưu trang không?
Thêm công cụ về website và SEO
Tìm Tên Miền Phụ
Khám phá tất cả tên miền phụ của bất kỳ tên miền nào
Kiểm Tra Website Sập
Web sập với mọi người hay chỉ mình bạn? Kiểm tra bất kỳ website nào từ 11 địa điểm và từ kết nối của bạn, kèm ảnh chụp màn hình trực tiếp
Kiểm Tra Chứng Chỉ SSL
Xác minh tính hợp lệ chứng chỉ SSL và chi tiết bảo mật
Kiểm tra Hosting
Tìm ra ai đang host bất kỳ website nào: nhà cung cấp hosting, CDN, CMS, email, nhà đăng ký và đơn vị cấp SSL
Tra Cứu WHOIS
Tra cứu đăng ký tên miền, nhà đăng ký và chi tiết chủ sở hữu qua RDAP
Kiểm Tra Danh Sách Đen IP
Kiểm tra xem địa chỉ IP có nằm trong danh sách đen spam hoặc malware không