











Dịch Mã Nhị Phân
Văn bản sang mã nhị phân và ngược lại ngay khi gõ: dán 0 và 1, hex hay thập phân, xem bit từng chữ.
Trọng số
64 + 8 = 72 → H
- 1
- 0
- bit đánh dấu UTF-8
Trỏ vào một ký tự hoặc di con trỏ: các bit của nó được cộng lại bên dưới.Chạm vào một ký tự để xem các bit của nó cộng lại.
Dịch ngay trong trình duyệt của bạn: không gì bạn gõ bị gửi đi đâu cả.
Cách dùng công cụ dịch mã nhị phân
Gõ văn bản để có mã nhị phân, hoặc dán mã nhị phân để lấy lại văn bản: công cụ dịch ngay khi bạn gõ, và nhãn phía trên kết quả cho biết nó đã đọc dữ liệu của bạn theo cách nào.
Dán nhị phân có hoặc không có dấu cách, theo nhóm 7 bit hoặc có 0b phía trước; hex như 48 69, byte thập phân như 72 105 và điểm mã như U+0048 cũng đọc được. Chọn đầu ra nhị phân, hex, thập phân hoặc bát phân, dấu phân cách và 8 hoặc 7 bit mỗi byte, rồi sao chép hoặc tải về. Dải bên dưới hiển thị các byte của từng ký tự: chọn một byte để cộng các bit của nó.
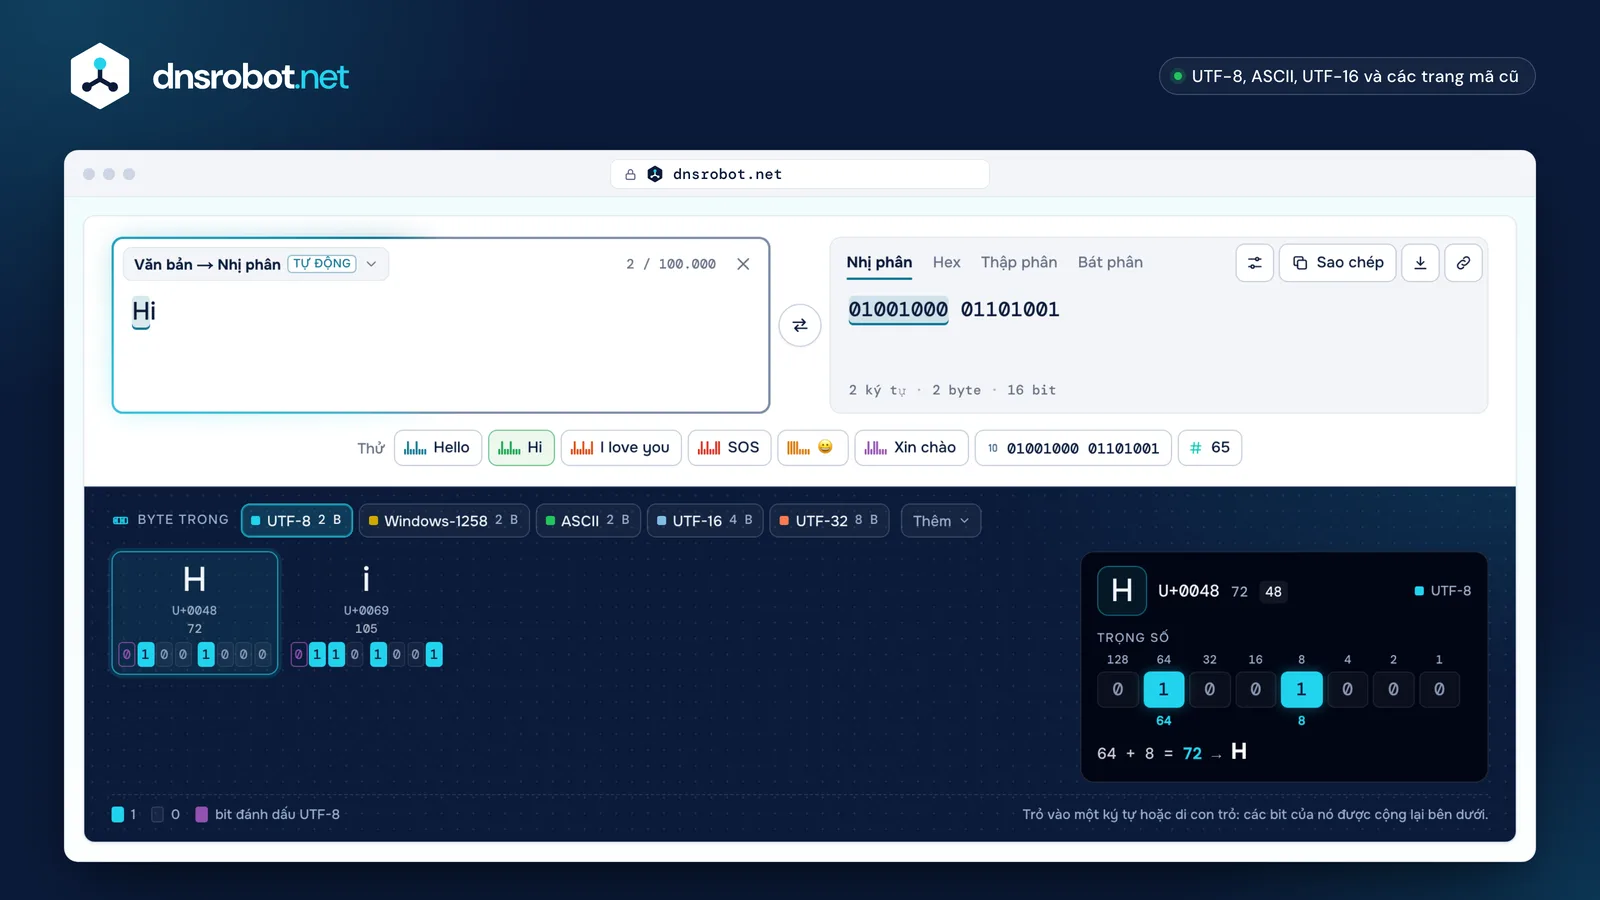
 Văn bản hoặc nhị phânGõ chữ hoặc dán nhị phân, hex hay thập phân: nhãn cho biết dữ liệu đã được đọc theo cách nào, và bạn có thể tự chọn.Kết quảNhị phân, hex, thập phân hoặc bát phân, tùy bạn: sao chép, tải về hoặc chia sẻ bằng liên kết.Bảng mãMặc định là UTF-8; ASCII, UTF-16 và các trang mã cũ cho ra những byte khác với cùng một văn bản.Dải byteMọi ký tự kèm điểm mã và các byte của nó; các bit đánh dấu của UTF-8 có màu riêng.Cộng các bitChọn một byte để xem trọng số của từng bit: 64 + 8 = 72, chữ H.
Làm sao chuyển văn bản thành mã nhị phân?
Tra số của từng ký tự, viết số đó bằng 8 chữ số nhị phân rồi nối các byte lại: H là 72, tức 01001000, nên “Hi” là 01001000 01101001.
Máy tính lưu văn bản dưới dạng những con số lấy từ một bảng chung. Trong ASCII và UTF-8, mỗi chữ cái tiếng Anh, chữ số và ký hiệu thông dụng là một byte: một số từ 0 đến 255 viết bằng 8 bit. Để viết một số ở dạng nhị phân, hãy tách nó thành các lũy thừa của 2: 72 = 64 + 8, nên các bit có trọng số 64 và 8 là 1, còn lại là 0. Chữ cái ngoài bảng chữ tiếng Anh chiếm từ 2 đến 4 byte trong UTF-8.
- HU+0048= 720x481 byte01001000
- iU+0069= 1050x691 byte01101001
- éU+00E9= 2330xC30xA92 byte1100001110101001
Hi01001000 01101001
Làm sao đọc mã nhị phân? Dịch nhị phân sang văn bản từng bước
Cắt các bit thành từng nhóm 8, cộng trọng số của các bit 1 (128, 64, 32, 16, 8, 4, 2, 1) rồi tra con số đó: 01001000 là 64 + 8 = 72, chữ H.
Bit ngoài cùng bên trái của một byte có trọng số 128, bit ngoài cùng bên phải là 1. Byte bắt đầu bằng 0 là ASCII thuần; byte bắt đầu bằng 11 mở đầu một ký tự UTF-8 dài hơn, còn byte bắt đầu bằng 10 là phần tiếp theo của ký tự đó. Khi ai đó bỏ số 0 ở đầu, bạn sẽ có các nhóm 7 bit như 1001000: công cụ dịch này tự thêm số 0 cho bạn, và báo khi một nhóm không thể là một byte trọn vẹn.
64 + 8 = 72 → H
64 + 32 + 8 + 1 = 105 → i
01001000 01101001Hi
Mã nhị phân bảng chữ cái: các chữ từ A đến Z
Chữ in hoa chạy từ A = 01000001 đến Z = 01011010, còn chữ thường từ a = 01100001 đến z = 01111010.
Một chữ in hoa và chữ thường của nó chỉ khác nhau một bit, bit có trọng số 32: A là 01000001 còn a là 01100001. Chữ số chạy từ 0 = 00110000 đến 9 = 00111001, nên bốn bit cuối của chúng chính là chữ số đó, và dấu cách là 00100000. Các mã này là của ASCII, công bố lần đầu năm 1963 (chữ thường có từ năm 1967), và UTF-8 giữ nguyên chúng.
- A01000001a01100001
- B01000010b01100010
- C01000011c01100011
- D01000100d01100100
- E01000101e01100101
- F01000110f01100110
- G01000111g01100111
- H01001000h01101000
- I01001001i01101001
- J01001010j01101010
- K01001011k01101011
- L01001100l01101100
- M01001101m01101101
- N01001110n01101110
- O01001111o01101111
- P01010000p01110000
- Q01010001q01110001
- R01010010r01110010
- S01010011s01110011
- T01010100t01110100
- U01010101u01110101
- V01010110v01110110
- W01010111w01110111
- X01011000x01111000
- Y01011001y01111001
- Z01011010z01111010
- Bit trọng số 32: 0 cho chữ hoa, 1 cho chữ thường
- Bit đầu tiên: luôn là 0 (ASCII dùng 7 bit)
- 1
“Hello”, “Hi” và “I love you” trong mã nhị phân
“Hello” trong mã nhị phân là 01001000 01100101 01101100 01101100 01101111; “Hi” là 01001000 01101001, còn “I love you” là 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101, tính cả dấu cách.
Mỗi chữ cái tiếng Anh là một byte trong ASCII và UTF-8, nên một từ có bao nhiêu chữ cái thì có bấy nhiêu byte, và chữ in hoa, chữ thường, dấu cách đều có mã riêng. “SOS” là 01010011 01001111 01010011. Gõ bất kỳ từ hay tên nào ở đầu trang để có mã nhị phân của nó, hoặc chọn một ví dụ dưới ô nhập.
| Từ | Nhị phân (ASCII và UTF-8) | Số bit |
|---|---|---|
| Hi | 01001000 01101001 | 16 |
| Hello | 01001000 01100101 01101100 01101100 01101111 | 40 |
| Hello World | 01001000 01100101 01101100 01101100 01101111 00100000 01010111 01101111 01110010 01101100 01100100 | 88 |
| I love you | 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101 | 80 |
| SOS | 01010011 01001111 01010011 | 24 |
| Yes | 01011001 01100101 01110011 | 24 |
| No | 01001110 01101111 | 16 |
| OK | 01001111 01001011 | 16 |
| Love | 01001100 01101111 01110110 01100101 | 32 |
| Thank you | 01010100 01101000 01100001 01101110 01101011 00100000 01111001 01101111 01110101 | 72 |
Vì sao có ký tự chiếm 16, 24 hay 32 bit? Giải thích UTF-8
UTF-8 viết tiếng Anh bằng một byte cho mỗi ký tự và mọi thứ khác bằng hai đến bốn byte: é chiếm 2 byte, € và hầu hết chữ Trung, Nhật, Hàn chiếm 3, còn emoji chiếm 4.
Byte đầu tiên cho biết ký tự dài bao nhiêu: 110 mở đầu một ký tự 2 byte, 1110 một ký tự 3 byte và 11110 một ký tự 4 byte, còn mọi byte theo sau đều bắt đầu bằng 10. Các bit còn lại ghép với nhau chính là điểm mã của ký tự: é là U+00E9. Một emoji bạn thấy có thể gồm nhiều điểm mã nối với nhau bằng ký tự nối không độ rộng (zero width joiner): emoji gia đình 👨👩👧 chiếm 18 byte. Dải byte ở đầu trang tô màu các bit đánh dấu tách khỏi bit của chính điểm mã.
- 1byte8 bitAU+004141001000001U+0000 – U+007FASCII: chữ cái tiếng Anh, chữ số, dấu câu
- 2byte16 bitàU+00E0C3 A0110110000111010100000U+0080 – U+07FFChữ Latinh có dấu, Kirin, Hy Lạp, Do Thái, Ả Rập
- 3byte24 bitệU+1EC7E1 BB 8711101110000110101110111010000111U+0800 – U+FFFFHầu hết chữ Trung, Nhật, Hàn, các chữ viết Ấn Độ, €
- 4byte32 bit😀U+1F600F0 9F 98 801111011110000101001111110100110001010000000U+10000 – U+10FFFFEmoji và những ký tự khác trên U+FFFF
- Bit đánh dấu: có mấy byte, hay “tiếp nối”
- Bit của chính ký tự
- x: một ô dành cho bit của ký tự
ASCII, UTF-8 hay UTF-16: nên dùng bảng mã nào?
Hãy dùng UTF-8: đây là chuẩn của web, được khoảng 99% trang web sử dụng (W3Techs, tháng 10 năm 2026). ASCII là phần 7 bit chỉ dành cho tiếng Anh của UTF-8, còn UTF-16 dùng hai byte cho hầu hết ký tự.
Cùng một từ có các bit khác nhau trong mỗi bảng mã: “Hello” là 5 byte trong UTF-8 và ASCII, 10 byte trong UTF-16 và 20 byte trong UTF-32. Bài tập tính 16 bit cho mỗi ký tự là đang dùng UTF-16. Các tệp cũ dùng những bảng mã cũ: trang mã một byte như KOI8-R và Windows-1251 cho tiếng Nga hay Windows-1252 cho Tây Âu, và Shift_JIS cho tiếng Nhật, với 2 byte cho mỗi chữ kanji. Khi nhị phân biến thành ký hiệu lạ, nguyên nhân thường là bảng mã: hãy chọn bảng mã khác trong công cụ.
“Hello” 5 ký tự
- UTF-85 byte · 40 bit
- UTF-16BE10 byte · 80 bit
- UTF-32BE20 byte · 160 bit
- ASCII5 byte · 40 bit
- Windows-12585 byte · 40 bit
“Xin chào” 8 ký tự
- UTF-89 byte · 72 bit
- UTF-16BE16 byte · 128 bit
- UTF-32BE32 byte · 256 bit
- ASCIIkhông viết được 1 ký tự
- Windows-12588 byte · 64 bit
Một chữ cái và các byte của nó: ệ U+1EC7
- UTF-8E1 BB 87
- UTF-16BE1E C7
- UTF-32BE00 00 1E C7
- Windows-1258EA F2
65 là số hay văn bản? Đổi thập phân sang nhị phân
Là một số, 65 trong nhị phân là 1000001; còn khi gõ như văn bản, nó là hai ký tự 6 và 5, tức 00110110 00110101.
Để đổi một số sang nhị phân, hãy chia nó cho 2 liên tiếp và đọc các số dư từ cuối lên đầu: 65 cho các số dư 1, 0, 0, 0, 0, 0, 1, nên là 1000001. Thêm số 0 cho đủ một byte thì thành 01000001, cũng chính là mã của chữ A in hoa. Gõ một con số đứng riêng ở đầu trang và bạn nhận được cả hai: giá trị của nó ở dạng nhị phân và mã nhị phân của các chữ số.
65 dưới dạng số
| Số | Thương | Số dư | |
|---|---|---|---|
| 65 | ÷ 2 = | 32 | 1 |
| 32 | ÷ 2 = | 16 | 0 |
| 16 | ÷ 2 = | 8 | 0 |
| 8 | ÷ 2 = | 4 | 0 |
| 4 | ÷ 2 = | 2 | 0 |
| 2 | ÷ 2 = | 1 | 0 |
| 1 | ÷ 2 = | 0 | 1 |
Đọc các số dư từ dưới lên: 1000001
64 + 1 = 65 · dưới dạng byte 01000001 = A
“65” dưới dạng văn bản
- 6U+0036 = 5400110110
- 5U+0035 = 5300110101
Hai ký tự, hai byte: 00110110 00110101
Các chữ số 0 đến 9 là 48 đến 57 trong ASCII, nên “6” là 54.
Cách chuyển văn bản thành mã nhị phân trong Python, JavaScript và các ngôn ngữ khác
Mã hóa văn bản thành các byte UTF-8, rồi viết mỗi byte ở hệ cơ số 2 với tám chữ số: ngôn ngữ nào cũng có cách làm ngắn gọn.
Mỗi ví dụ ở đây biến “Hi” thành 01001000 01101001 rồi đọc ngược lại, và từng ví dụ đều đã được chạy để kiểm tra kết quả. Tất cả đều dùng UTF-8, nên các bit khớp với công cụ dịch này; byte viết bằng bảng mã khác sẽ cho ra bit khác, vì vậy hãy dùng cùng một bảng mã ở cả hai phía.
 Python
text = "Hi"
bits = " ".join(f"{b:08b}" for b in text.encode("utf-8"))
print(bits)
print(bytes(int(b, 2) for b in bits.split()).decode("utf-8"))
Đã chạy trên Python 3.14, 25 tháng 10, 2026: in ra những dòng ở trên.
 JavaScript
const bits = [...new TextEncoder().encode("Hi")]
  .map((b) => b.toString(2).padStart(8, "0")).join(" ");
console.log(bits);
console.log(new TextDecoder().decode(
  Uint8Array.from(bits.split(" "), (b) => parseInt(b, 2))));
Đã chạy trên Node.js 22, 25 tháng 10, 2026: in ra những dòng ở trên.
 Java
StringBuilder sb = new StringBuilder();
for (byte b : "Hi".getBytes(StandardCharsets.UTF_8))
    sb.append(String.format("%8s", Integer.toBinaryString(b & 0xFF))
        .replace(' ', '0')).append(' ');
String bits = sb.toString().trim();
System.out.println(bits);
String[] parts = bits.split(" ");
byte[] back = new byte[parts.length];
for (int i = 0; i < parts.length; i++) back[i] = (byte) Integer.parseInt(parts[i], 2);
System.out.println(new String(back, StandardCharsets.UTF_8));
Đã chạy trên Java 25, 25 tháng 10, 2026: in ra những dòng ở trên.
 C# · .NET
using System.Text;

var bits = string.Join(" ", Encoding.UTF8.GetBytes("Hi")
    .Select(b => Convert.ToString(b, 2).PadLeft(8, '0')));
Console.WriteLine(bits);
Console.WriteLine(Encoding.UTF8.GetString(
    bits.Split(' ').Select(b => Convert.ToByte(b, 2)).ToArray()));
Đã chạy trên .NET 10, 25 tháng 10, 2026: in ra những dòng ở trên.
 Go
var parts []string
for _, b := range []byte("Hi") {
	parts = append(parts, fmt.Sprintf("%08b", b))
}
bits := strings.Join(parts, " ")
fmt.Println(bits)

var back []byte
for _, p := range strings.Fields(bits) {
	n, _ := strconv.ParseUint(p, 2, 8)
	back = append(back, byte(n))
}
fmt.Println(string(back))
Đã chạy trên Go 1.25, 25 tháng 10, 2026: in ra những dòng ở trên.
Ai phát minh ra mã nhị phân?
Gottfried Leibniz mô tả số nhị phân trong bài viết năm 1703 của ông gửi Viện Hàn lâm Khoa học Paris, nhưng Francis Bacon đã công bố cách viết chữ cái bằng năm ký hiệu thuộc hai loại từ năm 1623; các mã văn bản 8 bit mà máy tính dùng bắt nguồn từ ASCII (1963) và UTF-8 (1992).
Mã điện báo của Émile Baudot từ những năm 1870 dùng năm đơn vị bật-tắt cho mỗi chữ cái. Năm 1974, kính viễn vọng vô tuyến Arecibo gửi vào không gian một bức hình gồm 1.679 bit, và tháng 2 năm 2021, xe tự hành Perseverance của NASA hạ cánh xuống sao Hỏa dưới một chiếc dù ghi dòng chữ “Dare mighty things” (Hãy dám làm điều lớn lao) bằng mã nhị phân, mỗi chữ cái là số thứ tự của nó trong bảng chữ cái.
1623
Bảng chữ cái hai ký hiệu của Bacon
Francis Bacon viết mỗi chữ cái bằng năm ký hiệu thuộc hai loại, a và b: 32 tổ hợp cho bảng chữ cái 24 chữ của ông. Ông hé lộ ý tưởng này năm 1605 và công bố đầy đủ năm 1623.
aaaaa · aaaab · aaaba · aaabb … 2⁵ = 32
Nguồn: archive.org
1703
Số học nhị phân của Leibniz
Gottfried Leibniz giải thích cách đếm chỉ bằng 0 và 1 trong bài viết năm 1703 của ông gửi Viện Hàn lâm Khoa học Paris.
1 · 10 · 11 · 100 · 101 · 110 · 111
Nguồn: gallica.bnf.fr
Thập niên 1870
Mã 5 đơn vị của Baudot
Máy điện báo in của Émile Baudot gửi mỗi ký tự bằng năm đơn vị bật-tắt. Hậu duệ của nó, ITA2, đến nay vẫn là một Khuyến nghị của ITU-T (S.1).
5 → 2⁵ = 32
Nguồn: itu.int
1948
Từ “bit”
Công trình A Mathematical Theory of Communication của Claude Shannon dùng bit, nói tắt của binary digit, làm đơn vị thông tin, và ghi công từ này cho John W. Tukey.
bit = binary digit
Nguồn: people.math.harvard.edu
1956
Từ “byte”
Werner Buchholz đặt ra từ này tại IBM vào tháng 6 năm 1956 cho một nhóm từ 1 đến 6 bit; máy System/360 của IBM (1964) cố định nó ở 8.
1–6 bits → 8 bits
Nguồn: archive.computerhistory.org
1963
ASCII
Hiệp hội Tiêu chuẩn Hoa Kỳ phê duyệt ASCII ngày 17 tháng 6 năm 1963: 128 mã trong 7 bit.
A = 1000001
Nguồn: sensitiveresearch.com
1974
Thông điệp Arecibo
Ngày 16 tháng 11 năm 1974, kính viễn vọng Arecibo gửi 1.679 bit vào không gian. 1.679 = 73 × 23, hai số nguyên tố, nên các bit chỉ xếp vừa một lưới duy nhất: một bức hình.
1.679 = 73 × 23
23 × 73Nguồn: news.cornell.edu
1992
UTF-8
Ken Thompson thiết kế UTF-8 vào tháng 9 năm 1992, theo các tiêu chí của Rob Pike, cho hệ Plan 9 của Bell Labs. Nó giữ ASCII ở 1 byte và viết được mọi ký tự trong tối đa 4 byte.
é = 11000011 10101001
Nguồn: cl.cam.ac.uk
2021
Một thông điệp trên sao Hỏa
Ngày 18 tháng 2 năm 2021, chiếc dù của Perseverance hiện dòng chữ “DARE MIGHTY THINGS” (Hãy dám làm điều lớn lao) trên những ô màu cam và trắng: mỗi chữ cái là số thứ tự của nó trong bảng chữ cái, viết ở dạng nhị phân (A = 1).
DARE → 4 1 18 5 → 100 1 10010 101
Nguồn: photojournal.jpl.nasa.gov
Mã nhị phân: hỏi và đáp
Mã nhị phân là gì?
Làm sao dịch mã nhị phân sang chữ?
Từ “hello” trong mã nhị phân là gì?
Câu “I love you” trong mã nhị phân là gì?
Một chữ cái có bao nhiêu bit?
01001000 01101001 nghĩa là gì?
Có dán nhị phân không có dấu cách được không?
10101 trong hệ nhị phân nghĩa là gì?
Vì sao nhị phân biến thành ký hiệu lạ như �?
ASCII là mã 7 bit hay 8 bit?
Số 65 trong hệ nhị phân là gì?
Văn bản của tôi có bị gửi lên máy chủ không?
Còn thiếu điều gì?Đề xuất tính năng hoặc công cụ mới
Công cụ liên quan
Dịch Mã Morse
Văn bản sang mã Morse và ngược lại, phát bằng âm thanh, ánh sáng hoặc rung, giải mã từ âm thanh hoặc ảnh
Tạo Chữ Nhỏ
Chuyển đổi văn bản sang 44 kiểu chữ Unicode — chữ nhỏ, đậm, nghiêng, viết tay, fraktur & hơn thế
Kí Tự Trống
Sao chép và dán kí tự trống hoặc dấu cách tàng hình, tìm và xóa ký tự ẩn trong văn bản
Chuyển Đổi IP Sang Thập Phân
Đổi địa chỉ IP sang thập phân, hex, nhị phân, bát phân và ngược lại, kèm trọng số từng octet
Máy Tính Subnet
Địa chỉ mạng, broadcast, số host dùng được và mask cho mọi khối IPv4 hoặc IPv6, kèm VLSM, chia subnet và subnet trên cloud
Tạo UUID
Tạo UUID v4, v7, v1, v5 và v3 hoặc GUID hàng loạt, theo mọi định dạng, và giải mã phiên bản cùng timestamp của UUID