











Binärcode-Übersetzer: Text zu Binär und zurück
Text zu Binär und Binär zu Text beim Tippen: 0 und 1, Hex oder Dezimal einfügen, jedes Bit sehen.
Stellenwerte
64 + 8 = 72 → H
- 1
- 0
- UTF-8-Markierungsbits
Zeigen Sie auf ein Zeichen oder bewegen Sie den Cursor: Darunter werden seine Bits addiert.Tippen Sie ein Zeichen an, um seine Bits zu addieren.
Übersetzt in Ihrem Browser: Nichts, was Sie eingeben, wird irgendwohin gesendet.
So nutzen Sie den Binär-Übersetzer
Geben Sie Text ein, um Binärcode zu erhalten, oder fügen Sie Binärcode ein, um den Text zurückzubekommen: Die Übersetzung läuft schon beim Tippen, und die Anzeige über dem Ergebnis sagt, wie Ihre Eingabe gelesen wurde.
Fügen Sie Binärcode mit oder ohne Leerzeichen ein, in 7-Bit-Gruppen oder mit 0b davor; auch Hex wie 48 69, dezimale Bytes wie 72 105 und Codepunkte wie U+0048 werden gelesen. Wählen Sie die Ausgabe in Binär, Hex, Dezimal oder Oktal, das Trennzeichen und 8 oder 7 Bit pro Byte, dann kopieren Sie sie oder laden sie herunter. Der Streifen darunter zeigt die Bytes jedes Zeichens: Wählen Sie eines, um seine Bits zu addieren.
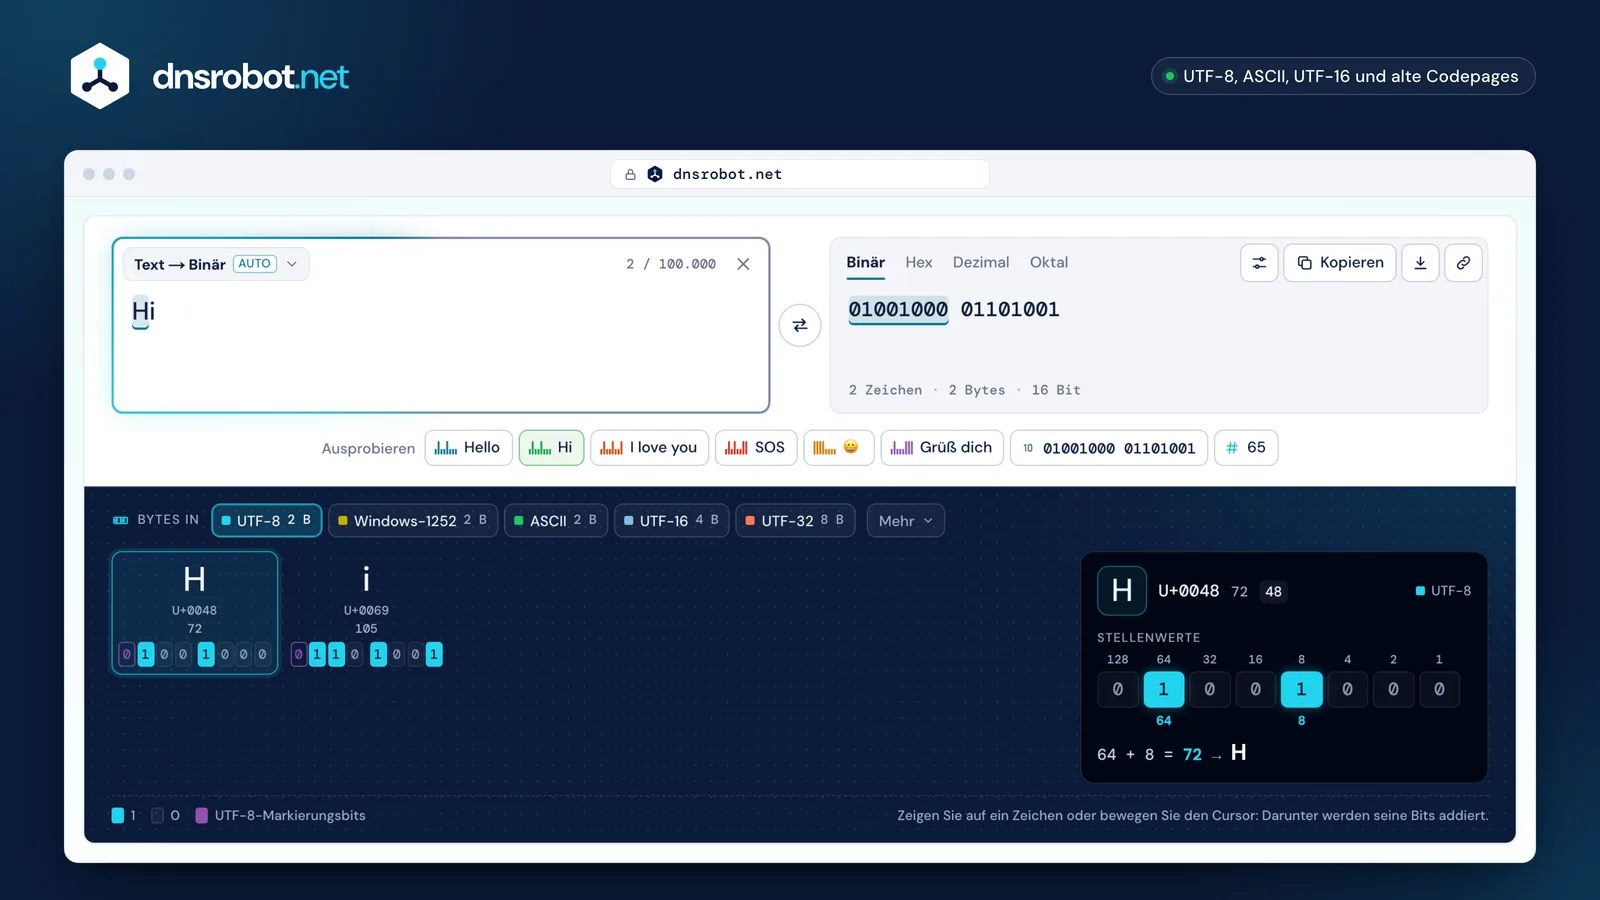
 Text oder BinärText eingeben oder Binär, Hex oder Dezimal einfügen: Die Anzeige sagt, wie die Eingabe gelesen wurde, und Sie können wählen.Das ErgebnisBinär, Hex, Dezimal oder Oktal, ganz wie Sie möchten: kopieren, herunterladen oder als Link teilen.KodierungStandardmäßig UTF-8; ASCII, UTF-16 und alte Codepages ergeben für denselben Text andere Bytes.Der Byte-StreifenJedes Zeichen mit Codepunkt und Bytes; die Markierungsbits von UTF-8 in eigener Farbe.Bits addierenWählen Sie ein Byte, um seine Stellenwerte zu sehen: 64 + 8 = 72, der Buchstabe H.
Wie wandelt man Text in Binärcode um?
Schlagen Sie die Zahl jedes Zeichens nach, schreiben Sie sie mit 8 Binärziffern und reihen Sie die Bytes aneinander: H ist 72, also 01001000, und „Hi“ ist damit 01001000 01101001.
Computer speichern Text als Zahlen aus einer gemeinsamen Tabelle. In ASCII und UTF-8 ist jeder englische Buchstabe, jede Ziffer und jedes gängige Zeichen ein Byte: eine Zahl von 0 bis 255, geschrieben mit 8 Bit. Um eine Zahl binär zu schreiben, zerlegen Sie sie in Zweierpotenzen: 72 = 64 + 8, also sind die Bits mit dem Wert 64 und 8 gleich 1 und alle anderen 0. Buchstaben jenseits des englischen Alphabets, etwa Umlaute, belegen in UTF-8 2 bis 4 Bytes.
- HU+0048= 720x481 Byte01001000
- iU+0069= 1050x691 Byte01101001
- éU+00E9= 2330xC30xA92 Bytes1100001110101001
Hi01001000 01101001
Wie liest man Binärcode? Binär in Text, Schritt für Schritt
Teilen Sie die Bits in Gruppen zu 8, addieren Sie die Stellenwerte der Einsen (128, 64, 32, 16, 8, 4, 2, 1) und schlagen Sie die Zahl nach: 01001000 ist 64 + 8 = 72, der Buchstabe H.
Das linke Bit eines Bytes ist 128 wert, das rechte 1. Ein Byte, das mit 0 beginnt, ist einfaches ASCII; eines, das mit 11 beginnt, eröffnet ein längeres UTF-8-Zeichen, und eines, das mit 10 beginnt, setzt es fort. Lässt jemand die führende Null weg, entstehen 7-Bit-Gruppen wie 1001000: Dieser Übersetzer ergänzt sie für Sie und sagt Bescheid, wenn eine Gruppe kein ganzes Byte sein kann.
64 + 8 = 72 → H
64 + 32 + 8 + 1 = 105 → i
01001000 01101001Hi
Binäralphabet: Buchstaben in Binär, von A bis Z
Großbuchstaben reichen von A = 01000001 bis Z = 01011010, Kleinbuchstaben von a = 01100001 bis z = 01111010.
Ein Großbuchstabe und sein Kleinbuchstabe unterscheiden sich in einem einzigen Bit, dem mit dem Wert 32: A ist 01000001 und a ist 01100001. Ziffern reichen von 0 = 00110000 bis 9 = 00111001, ihre letzten vier Bits sind also die Ziffer selbst, und ein Leerzeichen ist 00100000. Diese Codes stammen aus ASCII, das 1963 erstmals veröffentlicht wurde (die Kleinbuchstaben kamen 1967 dazu), und UTF-8 hat sie unverändert übernommen.
- A01000001a01100001
- B01000010b01100010
- C01000011c01100011
- D01000100d01100100
- E01000101e01100101
- F01000110f01100110
- G01000111g01100111
- H01001000h01101000
- I01001001i01101001
- J01001010j01101010
- K01001011k01101011
- L01001100l01101100
- M01001101m01101101
- N01001110n01101110
- O01001111o01101111
- P01010000p01110000
- Q01010001q01110001
- R01010010r01110010
- S01010011s01110011
- T01010100t01110100
- U01010101u01110101
- V01010110v01110110
- W01010111w01110111
- X01011000x01111000
- Y01011001y01111001
- Z01011010z01111010
- Das 32er-Bit: 0 für Großbuchstaben, 1 für Kleinbuchstaben
- Das erste Bit: immer 0 (ASCII hat 7 Bit)
- 1
Hello, Hi und I love you in Binärcode
„Hello“ ist in Binär 01001000 01100101 01101100 01101100 01101111; „Hi“ ist 01001000 01101001 und „I love you“ ist 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101, Leerzeichen inklusive.
Jeder englische Buchstabe ist in ASCII und UTF-8 ein Byte, ein Wort hat also so viele Bytes wie Buchstaben, und Groß- und Kleinbuchstaben sowie Leerzeichen haben jeweils ihren eigenen Code. „SOS“ ist 01010011 01001111 01010011. Um „Hallo“, ein anderes Wort oder Ihren Namen in Binär zu sehen, tippen Sie es oben ein oder wählen Sie ein Beispiel unter dem Feld.
| Wort | Binär (ASCII und UTF-8) | Bits |
|---|---|---|
| Hi | 01001000 01101001 | 16 |
| Hello | 01001000 01100101 01101100 01101100 01101111 | 40 |
| Hello World | 01001000 01100101 01101100 01101100 01101111 00100000 01010111 01101111 01110010 01101100 01100100 | 88 |
| I love you | 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101 | 80 |
| SOS | 01010011 01001111 01010011 | 24 |
| Yes | 01011001 01100101 01110011 | 24 |
| No | 01001110 01101111 | 16 |
| OK | 01001111 01001011 | 16 |
| Love | 01001100 01101111 01110110 01100101 | 32 |
| Thank you | 01010100 01101000 01100001 01101110 01101011 00100000 01111001 01101111 01110101 | 72 |
Warum belegen manche Zeichen 16, 24 oder 32 Bit? UTF-8 erklärt
UTF-8 schreibt Englisch mit einem Byte pro Zeichen und alles andere mit zwei bis vier: é belegt 2 Bytes, € und die meisten chinesischen, japanischen und koreanischen Zeichen 3, Emoji 4.
Das erste Byte sagt, wie lang das Zeichen ist: 110 beginnt ein 2-Byte-Zeichen, 1110 ein 3-Byte-Zeichen und 11110 ein 4-Byte-Zeichen, und jedes folgende Byte beginnt mit 10. Die übrigen Bits ergeben zusammen den Codepunkt des Zeichens: é ist U+00E9. Ein einziges sichtbares Emoji kann aus mehreren Codepunkten bestehen, verbunden durch einen Nullbreiten-Verbinder (ZWJ): Die Familie 👨👩👧 belegt 18 Bytes. Der Streifen oben färbt die Markierungsbits anders als die Bits des Codepunkts.
- 1Byte8 BitAU+004141001000001U+0000 – U+007FASCII: englische Buchstaben, Ziffern, Satzzeichen
- 2Bytes16 BitüU+00FCC3 BC110110000111010111100U+0080 – U+07FFLateinische Akzente, Kyrillisch, Griechisch, Hebräisch, Arabisch
- 3Bytes24 Bit€U+20ACE2 82 AC11101110001010100000101010101100U+0800 – U+FFFFDie meisten chinesischen, japanischen und koreanischen Zeichen, indische Schriften, €
- 4Bytes32 Bit😀U+1F600F0 9F 98 801111011110000101001111110100110001010000000U+10000 – U+10FFFFEmoji und andere Zeichen über U+FFFF
- Markierungsbits: wie viele Bytes, oder „setzt fort“
- Die eigenen Bits des Zeichens
- x: ein Platz für die Bits des Zeichens
ASCII vs. UTF-8 vs. UTF-16: Welche Kodierung sollten Sie verwenden?
Verwenden Sie UTF-8: Es ist der Standard des Webs und wird von etwa 99 % der Websites genutzt (W3Techs, Oktober 2026). ASCII ist sein 7-Bit-Teil nur für Englisch, und UTF-16 belegt für die meisten Zeichen zwei Bytes.
Dasselbe Wort hat in jeder Kodierung andere Bits: „Hello“ belegt in UTF-8 und ASCII 5 Bytes, in UTF-16 10 Bytes und in UTF-32 20. Wenn eine Aufgabe 16 Bit pro Zeichen zählt, ist UTF-16 gemeint. Ältere Dateien nutzen herkömmliche Kodierungen: Ein-Byte-Codepages wie KOI8-R und Windows-1251 für Russisch oder Windows-1252 für Westeuropa sowie Shift_JIS für Japanisch, mit 2 Bytes pro Kanji. Wenn aus Binärcode seltsame Zeichen werden, liegt es meist an der Kodierung: Wählen Sie im Tool eine andere.
“Hello” 5 Zeichen
- UTF-85 Bytes · 40 Bit
- UTF-16BE10 Bytes · 80 Bit
- UTF-32BE20 Bytes · 160 Bit
- ASCII5 Bytes · 40 Bit
- Windows-12525 Bytes · 40 Bit
“Grüß dich” 9 Zeichen
- UTF-811 Bytes · 88 Bit
- UTF-16BE18 Bytes · 144 Bit
- UTF-32BE36 Bytes · 288 Bit
- ASCIIkann 2 Zeichen nicht schreiben
- Windows-12529 Bytes · 72 Bit
Ein Buchstabe, seine Bytes: ü U+00FC
- UTF-8C3 BC
- UTF-16BE00 FC
- UTF-32BE00 00 00 FC
- Windows-1252FC
Ist 65 eine Zahl oder Text? Dezimal in Binär
Als Zahl ist 65 in Binär 1000001; als Text getippt sind es zwei Zeichen, 6 und 5, also 00110110 00110101.
Um eine Zahl in Binär umzuwandeln, teilen Sie sie immer wieder durch 2 und lesen die Reste vom letzten zum ersten: 65 ergibt die Reste 1, 0, 0, 0, 0, 0, 1, also 1000001. Auf ein Byte aufgefüllt ist das 01000001, zugleich der Code des großen A. Tippen Sie oben eine einzelne Zahl ein, und Sie erhalten beides: ihren Wert in Binär und den Binärcode ihrer Ziffern.
65 als Zahl
| Zahl | Quotient | Rest | |
|---|---|---|---|
| 65 | ÷ 2 = | 32 | 1 |
| 32 | ÷ 2 = | 16 | 0 |
| 16 | ÷ 2 = | 8 | 0 |
| 8 | ÷ 2 = | 4 | 0 |
| 4 | ÷ 2 = | 2 | 0 |
| 2 | ÷ 2 = | 1 | 0 |
| 1 | ÷ 2 = | 0 | 1 |
Lesen Sie die Reste von unten nach oben: 1000001
64 + 1 = 65 · als Byte 01000001 = A
„65“ als Text
- 6U+0036 = 5400110110
- 5U+0035 = 5300110101
Zwei Zeichen, zwei Bytes: 00110110 00110101
Die Ziffern 0 bis 9 sind in ASCII 48 bis 57, „6“ ist also 54.
Text in Binär umwandeln mit Python, JavaScript und anderen Sprachen
Kodieren Sie den Text als UTF-8-Bytes und schreiben Sie dann jedes Byte zur Basis 2 mit acht Ziffern: Jede Sprache hat dafür einen kurzen Weg.
Jedes Beispiel hier macht aus „Hi“ 01001000 01101001 und liest es zurück, und jedes wurde ausgeführt, um seine Ausgabe zu prüfen. Alle nutzen UTF-8, die Bits stimmen also mit denen dieses Übersetzers überein; Bytes in einer anderen Kodierung ergeben andere Bits, verwenden Sie also auf beiden Seiten dieselbe Kodierung.
 Python
text = "Hi"
bits = " ".join(f"{b:08b}" for b in text.encode("utf-8"))
print(bits)
print(bytes(int(b, 2) for b in bits.split()).decode("utf-8"))
Ausgeführt mit Python 3.14, 25. Oktober 2026: gibt die Zeilen oben aus.
 JavaScript
const bits = [...new TextEncoder().encode("Hi")]
  .map((b) => b.toString(2).padStart(8, "0")).join(" ");
console.log(bits);
console.log(new TextDecoder().decode(
  Uint8Array.from(bits.split(" "), (b) => parseInt(b, 2))));
Ausgeführt mit Node.js 22, 25. Oktober 2026: gibt die Zeilen oben aus.
 Java
StringBuilder sb = new StringBuilder();
for (byte b : "Hi".getBytes(StandardCharsets.UTF_8))
    sb.append(String.format("%8s", Integer.toBinaryString(b & 0xFF))
        .replace(' ', '0')).append(' ');
String bits = sb.toString().trim();
System.out.println(bits);
String[] parts = bits.split(" ");
byte[] back = new byte[parts.length];
for (int i = 0; i < parts.length; i++) back[i] = (byte) Integer.parseInt(parts[i], 2);
System.out.println(new String(back, StandardCharsets.UTF_8));
Ausgeführt mit Java 25, 25. Oktober 2026: gibt die Zeilen oben aus.
 C# · .NET
using System.Text;

var bits = string.Join(" ", Encoding.UTF8.GetBytes("Hi")
    .Select(b => Convert.ToString(b, 2).PadLeft(8, '0')));
Console.WriteLine(bits);
Console.WriteLine(Encoding.UTF8.GetString(
    bits.Split(' ').Select(b => Convert.ToByte(b, 2)).ToArray()));
Ausgeführt mit .NET 10, 25. Oktober 2026: gibt die Zeilen oben aus.
 Go
var parts []string
for _, b := range []byte("Hi") {
	parts = append(parts, fmt.Sprintf("%08b", b))
}
bits := strings.Join(parts, " ")
fmt.Println(bits)

var back []byte
for _, p := range strings.Fields(bits) {
	n, _ := strconv.ParseUint(p, 2, 8)
	back = append(back, byte(n))
}
fmt.Println(string(back))
Ausgeführt mit Go 1.25, 25. Oktober 2026: gibt die Zeilen oben aus.
Wer hat den Binärcode erfunden?
Gottfried Leibniz beschrieb Binärzahlen in seiner Abhandlung von 1703 für die Pariser Akademie der Wissenschaften, doch Francis Bacon hatte schon 1623 Buchstaben veröffentlicht, die aus fünf Zeichen zweier Arten bestehen; die 8-Bit-Textcodes der Computer gehen auf ASCII (1963) und UTF-8 (1992) zurück.
Der Telegrafencode von Émile Baudot aus den 1870er-Jahren nutzte fünf Ein-Aus-Einheiten pro Buchstabe. 1974 sandte das Radioteleskop Arecibo ein Bild aus 1.679 Bit ins All, und im Februar 2021 landete NASAs Rover Perseverance auf dem Mars, an einem Fallschirm, der „Dare mighty things“ („Wagt Großes“) in Binärcode buchstabiert, jeden Buchstaben als seine Position im Alphabet.
1623
Bacons zweibuchstabiges Alphabet
Francis Bacon schreibt jeden Buchstaben als fünf Zeichen zweier Arten, a und b: 32 Muster für sein Alphabet aus 24 Buchstaben. 1605 deutete er es an, 1623 veröffentlichte er es vollständig.
aaaaa · aaaab · aaaba · aaabb … 2⁵ = 32
Quelle: archive.org
1703
Leibniz' binäre Arithmetik
Gottfried Leibniz erklärt das Rechnen mit nur 0 und 1 in seiner Abhandlung von 1703 für die Pariser Akademie der Wissenschaften.
1 · 10 · 11 · 100 · 101 · 110 · 111
Quelle: gallica.bnf.fr
1870er
Baudots Code mit 5 Einheiten
Émile Baudots Drucktelegraf sendet jedes Zeichen als fünf Ein-Aus-Einheiten. Sein Nachfolger ITA2 ist bis heute eine ITU-T-Empfehlung (S.1).
5 → 2⁵ = 32
Quelle: itu.int
1948
„Bit“
Claude Shannons A Mathematical Theory of Communication verwendet das Bit, kurz für binary digit, als Einheit der Information und schreibt das Wort John W. Tukey zu.
bit = binary digit
Quelle: people.math.harvard.edu
1956
„Byte“
Werner Buchholz prägt das Wort im Juni 1956 bei IBM für eine Gruppe von 1 bis 6 Bit; IBMs System/360 (1964) legt es auf 8 fest.
1–6 bits → 8 bits
Quelle: archive.computerhistory.org
1963
ASCII
Die American Standards Association verabschiedet ASCII am 17. Juni 1963: 128 Codes in 7 Bit.
A = 1000001
Quelle: sensitiveresearch.com
1974
Die Arecibo-Botschaft
Am 16. November 1974 sendet das Arecibo-Teleskop 1.679 Bit ins All. 1.679 = 73 × 23, zwei Primzahlen, deshalb passen die Bits in genau ein Raster: ein Bild.
1.679 = 73 × 23
23 × 73Quelle: news.cornell.edu
1992
UTF-8
Ken Thompson entwirft UTF-8 im September 1992 nach Vorgaben von Rob Pike für Plan 9 der Bell Labs. Es behält ASCII als 1 Byte und schreibt jedes Zeichen mit höchstens 4.
é = 11000011 10101001
Quelle: cl.cam.ac.uk
2021
Eine Botschaft auf dem Mars
Am 18. Februar 2021 zeigt der Fallschirm von Perseverance „DARE MIGHTY THINGS“ in seinen orangefarbenen und weißen Bahnen: jeder Buchstabe seine Position im Alphabet, in Binär (A = 1).
DARE → 4 1 18 5 → 100 1 10010 101
Quelle: photojournal.jpl.nasa.gov
Binärcode: Fragen und Antworten
Was ist Binärcode?
Wie übersetze ich Binär in Text?
Was ist „hello“ in Binär?
Was ist „I love you“ in Binär?
Wie viele Bits hat ein Buchstabe?
Was bedeutet 01001000 01101001?
Kann ich Binärcode ohne Leerzeichen einfügen?
Was bedeutet 10101 in Binär?
Warum wird Binärcode zu seltsamen Zeichen wie �?
Ist ASCII 7-Bit oder 8-Bit?
Was ist 65 in Binär?
Wird mein Text an einen Server gesendet?
Fehlt Ihnen etwas?Funktion oder neues Tool vorschlagen
Verwandte Tools
Morsecode-Übersetzer
Text in Morsecode und zurück, als Ton, Licht oder Vibration abgespielt und aus Audio oder Foto gelesen
Kleintext-Generator
Text in 44 Unicode-Schriftstile umwandeln — Minitext, Fett, Kursiv, Schreibschrift, Fraktur & mehr
Unsichtbares Zeichen
Unsichtbares Zeichen oder Leerzeichen kopieren und einfügen sowie versteckte Zeichen in Text finden oder entfernen
IP-zu-Dezimal-Konverter
IP-Adresse in Dezimal, Hex, Binär und Oktal und zurück, mit den Stellenwerten jedes Oktetts
Subnetzrechner
Netzwerk, Broadcast, nutzbare Hosts und Masken für jeden IPv4- oder IPv6-Block, mit VLSM, Aufteilung und Cloud-Subnetzen
UUID-Generator
UUID v4, v7, v1, v5 und v3 oder GUIDs in großer Menge und in jedem Format erzeugen und Version und Zeitstempel einer UUID dekodieren