











Бинарный переводчик: текст в двоичный код
Текст в двоичный код и обратно при вводе: вставьте 0 и 1, hex или десятичные числа — и увидите биты.
Веса разрядов
64 + 8 = 72 → H
- 1
- 0
- служебные биты UTF-8
Наведите курсор на символ или переместите каретку: его биты сложатся ниже.Коснитесь символа, чтобы увидеть, как складываются его биты.
Перевод идёт в вашем браузере: ничего из того, что вы вводите, никуда не отправляется.
Как пользоваться переводчиком в двоичный код
Введите текст, чтобы получить двоичный код, или вставьте двоичный код, чтобы получить текст: перевод идёт прямо при вводе, а метка над результатом показывает, как прочитан ваш ввод.
Вставляйте двоичный код с пробелами или без, группами по 7 бит или с 0b впереди; читаются и hex вроде 48 69, и десятичные байты вроде 72 105, и кодовые точки вроде U+0048. Выберите вывод в двоичном, шестнадцатеричном, десятичном или восьмеричном виде, разделитель и 8 или 7 бит на байт, затем скопируйте или скачайте результат. Лента ниже показывает байты каждого символа: выберите любой, чтобы сложить его биты.
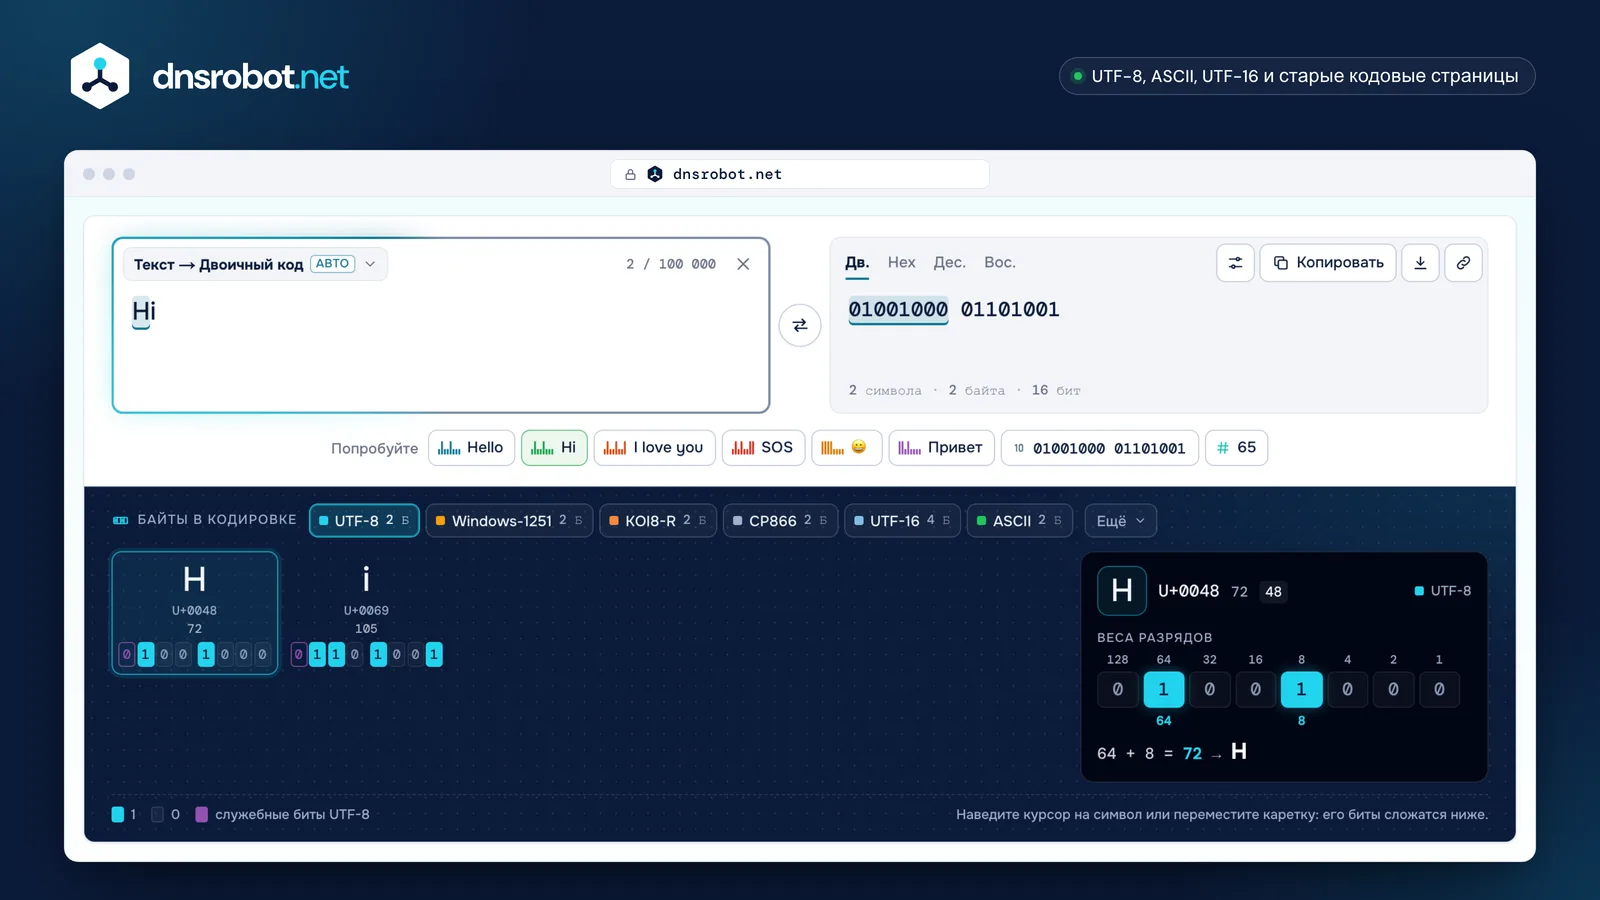
 Текст или двоичный кодВведите текст или вставьте двоичный код, hex или десятичные числа: метка показывает, как прочитан ввод, а прочтение можно выбрать самому.РезультатДвоичный код, hex, десятичные или восьмеричные числа — как вам удобно: скопируйте, скачайте или поделитесь ссылкой.КодировкаПо умолчанию UTF-8; ASCII, UTF-16 и старые кодовые страницы дают для того же текста другие байты.Лента байтовКаждый символ с кодовой точкой и байтами; служебные биты UTF-8 выделены своим цветом.Сложите битыВыберите байт, чтобы увидеть веса его разрядов: 64 + 8 = 72, буква H.
Как перевести текст в двоичный код?
Найдите номер каждого символа, запишите его восемью двоичными цифрами и соедините байты: H — это 72, то есть 01001000, поэтому «Hi» — это 01001000 01101001.
Компьютер хранит текст как числа из общей таблицы. В ASCII и UTF-8 каждая английская буква, цифра и распространённый знак занимают один байт: число от 0 до 255, записанное 8 битами. Чтобы записать число в двоичной системе, разложите его на степени двойки: 72 = 64 + 8, значит, биты с весами 64 и 8 равны 1, а остальные — 0. Буквы других алфавитов, в том числе кириллица, занимают в UTF-8 от 2 до 4 байт.
- HU+0048= 720x481 байт01001000
- iU+0069= 1050x691 байт01101001
- éU+00E9= 2330xC30xA92 байта1100001110101001
Hi01001000 01101001
Как читать двоичный код? Перевод двоичного кода в текст по шагам
Разбейте биты на группы по 8, сложите веса разрядов, где стоят единицы (128, 64, 32, 16, 8, 4, 2, 1), и найдите число в таблице: 01001000 — это 64 + 8 = 72, буква H.
Крайний левый бит байта весит 128, а крайний правый — 1. Байт, который начинается с 0, — обычный ASCII; байт, начинающийся с 11, открывает более длинный символ UTF-8, а байт, начинающийся с 10, продолжает его. Если кто-то отбросил ведущий ноль, получаются группы по 7 бит вроде 1001000: этот переводчик сам дополнит их и сообщит, если группа не может быть целым байтом.
64 + 8 = 72 → H
64 + 32 + 8 + 1 = 105 → i
01001000 01101001Hi
Двоичный алфавит: латинские буквы от A до Z в двоичном коде
Заглавные буквы идут от A = 01000001 до Z = 01011010, а строчные — от a = 01100001 до z = 01111010.
Заглавная и строчная буква отличаются одним битом, тем, что весит 32: A — это 01000001, а a — 01100001. Цифры идут от 0 = 00110000 до 9 = 00111001, поэтому их последние четыре бита и есть сама цифра, а пробел — это 00100000. Эти коды взяты из ASCII, впервые опубликованного в 1963 году (строчные буквы появились в 1967-м), и UTF-8 сохранил их без изменений.
- A01000001a01100001
- B01000010b01100010
- C01000011c01100011
- D01000100d01100100
- E01000101e01100101
- F01000110f01100110
- G01000111g01100111
- H01001000h01101000
- I01001001i01101001
- J01001010j01101010
- K01001011k01101011
- L01001100l01101100
- M01001101m01101101
- N01001110n01101110
- O01001111o01101111
- P01010000p01110000
- Q01010001q01110001
- R01010010r01110010
- S01010011s01110011
- T01010100t01110100
- U01010101u01110101
- V01010110v01110110
- W01010111w01110111
- X01011000x01111000
- Y01011001y01111001
- Z01011010z01111010
- Бит с весом 32: 0 — заглавные, 1 — строчные
- Первый бит: всегда 0 (ASCII — 7-битный)
- 1
Слова в двоичном коде: «Hello», «Hi» и «I love you»
«Hello» в двоичном коде — это 01001000 01100101 01101100 01101100 01101111; «Hi» — 01001000 01101001, а «I love you» — 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101, вместе с пробелами.
Каждая английская буква занимает в ASCII и UTF-8 один байт, поэтому байтов в слове столько же, сколько букв, а у заглавных, строчных букв и пробелов свои коды. «SOS» — это 01010011 01001111 01010011. Введите вверху любое слово или имя, чтобы получить его двоичный код, или выберите пример под полем.
| Слово | Двоичный код (ASCII и UTF-8) | Биты |
|---|---|---|
| Hi | 01001000 01101001 | 16 |
| Hello | 01001000 01100101 01101100 01101100 01101111 | 40 |
| Hello World | 01001000 01100101 01101100 01101100 01101111 00100000 01010111 01101111 01110010 01101100 01100100 | 88 |
| I love you | 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101 | 80 |
| SOS | 01010011 01001111 01010011 | 24 |
| Yes | 01011001 01100101 01110011 | 24 |
| No | 01001110 01101111 | 16 |
| OK | 01001111 01001011 | 16 |
| Love | 01001100 01101111 01110110 01100101 | 32 |
| Thank you | 01010100 01101000 01100001 01101110 01101011 00100000 01111001 01101111 01110101 | 72 |
Почему некоторые символы занимают 16, 24 или 32 бита? Как устроен UTF-8
UTF-8 записывает английский текст одним байтом на символ, а всё остальное — двумя–четырьмя: é занимает 2 байта, € и большинство китайских, японских и корейских символов — 3, а эмодзи — 4.
Первый байт сообщает длину символа: 110 начинает 2-байтовый символ, 1110 — 3-байтовый, 11110 — 4-байтовый, а каждый следующий байт начинается с 10. Оставшиеся биты, соединённые вместе, дают кодовую точку символа: у é это U+00E9. Один видимый эмодзи может состоять из нескольких кодовых точек, соединённых соединителем нулевой ширины (ZWJ): семья 👨👩👧 занимает 18 байт. Лента вверху раскрашивает служебные биты отдельно от битов кодовой точки.
- 1байт8 битAU+004141001000001U+0000 – U+007FASCII: английские буквы, цифры, знаки препинания
- 2байта16 битПU+041FD0 9F110110100001010011111U+0080 – U+07FFЛатиница с диакритикой, кириллица, греческий, иврит, арабский
- 3байта24 бита€U+20ACE2 82 AC11101110001010100000101010101100U+0800 – U+FFFFБольшинство китайских, японских и корейских знаков, индийские письменности, €
- 4байта32 бита😀U+1F600F0 9F 98 801111011110000101001111110100110001010000000U+10000 – U+10FFFFЭмодзи и другие символы выше U+FFFF
- Служебные биты: сколько байтов или «продолжение»
- Собственные биты символа
- x: место для битов символа
ASCII, UTF-8 или UTF-16: какую кодировку выбрать?
Используйте UTF-8: это стандарт веба, его используют около 99% сайтов (W3Techs, октябрь 2026 года). ASCII — его 7-битная часть только для английского, а UTF-16 тратит два байта на большинство символов.
У одного и того же слова в разных кодировках разные биты: «Hello» занимает 5 байт в UTF-8 и ASCII, 10 байт в UTF-16 и 20 в UTF-32. Если в задаче каждый символ кодируется 16 битами, имеется в виду UTF-16. В старых файлах встречаются устаревшие кодировки: однобайтовые кодовые страницы, например KOI8-R и Windows-1251 для русского или Windows-1252 для Западной Европы, и Shift_JIS для японского, где на каждый иероглиф кандзи приходится 2 байта. Когда двоичный код превращается в странные символы, причина обычно в кодировке: выберите в инструменте другую.
“Hello” 5 символов
- UTF-85 байт · 40 бит
- UTF-16BE10 байт · 80 бит
- UTF-32BE20 байт · 160 бит
- ASCII5 байт · 40 бит
- Windows-12515 байт · 40 бит
- KOI8-R5 байт · 40 бит
- CP8665 байт · 40 бит
“Привет” 6 символов
- UTF-812 байт · 96 бит
- UTF-16BE12 байт · 96 бит
- UTF-32BE24 байта · 192 бита
- ASCIIне запишет 6 символов
- Windows-12516 байт · 48 бит
- KOI8-R6 байт · 48 бит
- CP8666 байт · 48 бит
Одна буква и её байты: А U+0410
- UTF-8D0 90
- UTF-16BE04 10
- UTF-32BE00 00 04 10
- Windows-1251C0
- KOI8-RE1
- CP86680
65 — это число или текст? Перевод из десятичной системы в двоичную
Как число 65 в двоичной системе — это 1000001; набранное как текст, это два символа, 6 и 5, то есть 00110110 00110101.
Чтобы перевести число в двоичную систему, делите его на 2 снова и снова и читайте остатки от последнего к первому: 65 даёт остатки 1, 0, 0, 0, 0, 0, 1, то есть 1000001. Если дополнить его до байта, получится 01000001 — это ещё и код заглавной A. Введите вверху отдельное число, и вы получите и то и другое: его значение в двоичной системе и двоичный код его цифр.
65 как число
| Число | Частное | Остаток | |
|---|---|---|---|
| 65 | ÷ 2 = | 32 | 1 |
| 32 | ÷ 2 = | 16 | 0 |
| 16 | ÷ 2 = | 8 | 0 |
| 8 | ÷ 2 = | 4 | 0 |
| 4 | ÷ 2 = | 2 | 0 |
| 2 | ÷ 2 = | 1 | 0 |
| 1 | ÷ 2 = | 0 | 1 |
Читайте остатки снизу вверх: 1000001
64 + 1 = 65 · как байт 01000001 = A
«65» как текст
- 6U+0036 = 5400110110
- 5U+0035 = 5300110101
Два символа, два байта: 00110110 00110101
Цифры от 0 до 9 — это 48–57 в ASCII, поэтому «6» — это 54.
Как перевести текст в двоичный код на Python, JavaScript и других языках
Закодируйте текст в байты UTF-8, затем запишите каждый байт в двоичной системе восемью цифрами: в каждом языке для этого есть короткий способ.
Каждый пример здесь превращает «Hi» в 01001000 01101001 и читает обратно, и каждый был запущен, чтобы проверить вывод. Все они используют UTF-8, поэтому биты совпадают с битами этого переводчика; байты в другой кодировке дают другие биты, так что используйте одну и ту же кодировку на обеих сторонах.
 Python
text = "Hi"
bits = " ".join(f"{b:08b}" for b in text.encode("utf-8"))
print(bits)
print(bytes(int(b, 2) for b in bits.split()).decode("utf-8"))
Запущено на Python 3.14, 25 октября 2026 г.: выводит строки выше.
 JavaScript
const bits = [...new TextEncoder().encode("Hi")]
  .map((b) => b.toString(2).padStart(8, "0")).join(" ");
console.log(bits);
console.log(new TextDecoder().decode(
  Uint8Array.from(bits.split(" "), (b) => parseInt(b, 2))));
Запущено на Node.js 22, 25 октября 2026 г.: выводит строки выше.
 Java
StringBuilder sb = new StringBuilder();
for (byte b : "Hi".getBytes(StandardCharsets.UTF_8))
    sb.append(String.format("%8s", Integer.toBinaryString(b & 0xFF))
        .replace(' ', '0')).append(' ');
String bits = sb.toString().trim();
System.out.println(bits);
String[] parts = bits.split(" ");
byte[] back = new byte[parts.length];
for (int i = 0; i < parts.length; i++) back[i] = (byte) Integer.parseInt(parts[i], 2);
System.out.println(new String(back, StandardCharsets.UTF_8));
Запущено на Java 25, 25 октября 2026 г.: выводит строки выше.
 C# · .NET
using System.Text;

var bits = string.Join(" ", Encoding.UTF8.GetBytes("Hi")
    .Select(b => Convert.ToString(b, 2).PadLeft(8, '0')));
Console.WriteLine(bits);
Console.WriteLine(Encoding.UTF8.GetString(
    bits.Split(' ').Select(b => Convert.ToByte(b, 2)).ToArray()));
Запущено на .NET 10, 25 октября 2026 г.: выводит строки выше.
 Go
var parts []string
for _, b := range []byte("Hi") {
	parts = append(parts, fmt.Sprintf("%08b", b))
}
bits := strings.Join(parts, " ")
fmt.Println(bits)

var back []byte
for _, p := range strings.Fields(bits) {
	n, _ := strconv.ParseUint(p, 2, 8)
	back = append(back, byte(n))
}
fmt.Println(string(back))
Запущено на Go 1.25, 25 октября 2026 г.: выводит строки выше.
Кто изобрёл двоичный код?
Готфрид Лейбниц описал двоичные числа в своей статье 1703 года для Парижской академии наук, но Фрэнсис Бэкон ещё в 1623 году опубликовал запись букв пятью знаками двух видов; 8-битные текстовые коды компьютеров выросли из ASCII (1963) и UTF-8 (1992).
Телеграфный код Эмиля Бодо 1870-х годов использовал на каждую букву пять элементов «включено — выключено». В 1974 году радиотелескоп Arecibo отправил в космос изображение из 1679 бит, а в феврале 2021 года марсоход NASA Perseverance сел на Марс под парашютом, на котором двоичным кодом записано «Dare mighty things» («Дерзайте на великие дела»): каждая буква — своим номером в алфавите.
1623
Двухбуквенный алфавит Бэкона
Фрэнсис Бэкон записывает каждую букву пятью знаками двух видов, a и b: 32 сочетания на его алфавит из 24 букв. Он намекнул на это в 1605 году, а полностью опубликовал в 1623-м.
aaaaa · aaaab · aaaba · aaabb … 2⁵ = 32
Источник: archive.org
1703
Двоичная арифметика Лейбница
Готфрид Лейбниц объясняет счёт с помощью одних только 0 и 1 в своей статье 1703 года для Парижской академии наук.
1 · 10 · 11 · 100 · 101 · 110 · 111
Источник: gallica.bnf.fr
1870-е
5-элементный код Бодо
Буквопечатающий телеграф Эмиля Бодо передаёт каждый знак пятью элементами «включено — выключено». Его потомок ITA2 до сих пор остаётся рекомендацией ITU-T (S.1).
5 → 2⁵ = 32
Источник: itu.int
1948
«Бит»
В работе Клода Шеннона A Mathematical Theory of Communication бит, сокращение от binary digit, становится единицей информации, а авторство самого слова приписывает Джону Тьюки.
bit = binary digit
Источник: people.math.harvard.edu
1956
«Байт»
Вернер Буххольц придумывает это слово в IBM в июне 1956 года для группы от 1 до 6 бит; System/360 от IBM (1964) закрепляет за байтом 8 бит.
1–6 bits → 8 bits
Источник: archive.computerhistory.org
1963
ASCII
Американская ассоциация стандартов утверждает ASCII 17 июня 1963 года: 128 кодов в 7 битах.
A = 1000001
Источник: sensitiveresearch.com
1974
Послание Аресибо
16 ноября 1974 года телескоп Аресибо отправляет в космос 1679 бит. 1679 = 73 × 23, два простых числа, поэтому биты складываются только в одну сетку — в картинку.
1 679 = 73 × 23
23 × 73Источник: news.cornell.edu
1992
UTF-8
Кен Томпсон разрабатывает UTF-8 в сентябре 1992 года по требованиям Роба Пайка для Plan 9 из Bell Labs. Он оставляет ASCII в одном байте и записывает любой символ не более чем четырьмя.
é = 11000011 10101001
Источник: cl.cam.ac.uk
2021
Послание на Марсе
18 февраля 2021 года парашют Perseverance показывает «DARE MIGHTY THINGS» оранжевыми и белыми секторами: каждая буква — её номер в алфавите, записанный двоично (A = 1).
DARE → 4 1 18 5 → 100 1 10010 101
Источник: photojournal.jpl.nasa.gov
Двоичный код: вопросы и ответы
Что такое двоичный код?
Как перевести двоичный код в текст?
Как будет «hello» в двоичном коде?
Как будет «I love you» («я тебя люблю») в двоичном коде?
Сколько бит в одной букве?
Что значит 01001000 01101001?
Можно ли вставить двоичный код без пробелов?
Что значит 10101 в двоичном коде?
Почему двоичный код превращается в странные символы вроде �?
ASCII — 7-битная или 8-битная кодировка?
Как записать 65 в двоичной системе?
Отправляется ли мой текст на сервер?
Чего-то не хватает?Предложите функцию или новый инструмент
Похожие инструменты
Переводчик азбуки Морзе
Текст в азбуку Морзе и обратно: звук, свет или вибрация, расшифровка из аудио или по фото
Генератор мелкого текста
Преобразование текста в 44 стиля шрифтов Unicode — мелкий текст, жирный, курсив, рукописный, фрактура и др.
Невидимый символ
Копирование невидимого символа и пустого пробела, поиск и удаление скрытых символов в тексте
Конвертер IP в десятичный
IP-адрес в десятичное, hex, двоичное и восьмеричное число и обратно, с весами разрядов каждого октета
Калькулятор подсетей
Сеть, широковещательный адрес, доступные хосты и маски для любого блока IPv4 или IPv6, а также VLSM, разбиение и облачные подсети
Генератор UUID
Генерация UUID v4, v7, v1, v5 и v3 или GUID пачкой в любом формате и декодирование версии и времени создания UUID