











Генератор Sitemap
Бесплатный генератор sitemap, который сканирует сайт так же, как поисковый робот: он помогает создать файл sitemap автоматически, оставляет в нём только страницы, которым место в выдаче, и объясняет, почему каждый остальной адрес туда не попал.
Домена тоже достаточно: example.org — старт с главной страницы.
- robots.txtЧитаем первым, соблюдаем
- Ваш sitemapНайдём и сравним
- ПросканированоДо 500 страниц, по 3 сразу
- Решениеnoindex, canonical, редиректы
Как создать карту сайта онлайн, шаг за шагом
Введите адрес главной страницы выше и нажмите «Создать sitemap». Наш робот прочитает robots.txt, пройдёт по вашим ссылкам так же, как поисковая система, оставит только те страницы, которым там место, и отдаст вам sitemap.xml для загрузки в корень сайта.
Странице место в файле, когда она отвечает 200, отдаёт HTML, не закрыта noindex, называет каноническим саму себя и не запрещена в robots.txt. Любой другой адрес попадает в раздел «Исключено» со своей причиной, так что ошибку легко отличить от вашего же решения.
Залейте файл в корень, https://www.example.org/sitemap.xml: sitemap вправе перечислять только адреса из своей папки и вложенных в неё, поэтому в корне он охватывает весь сайт (Google). Затем добавьте в robots.txt строку Sitemap: и отправьте файл в Google Search Console и Bing Webmaster Tools.
1Введите адрес главной
example.orgили вставьте список адресов2Мы сканируем и решаем
robots.txt 200499/500412 в sitemap · 87 исключено3Скачайте файл
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML или CSV4Залейте и отправьте
/sitemap.xmlSitemap: https://www.example.org/…корень · robots.txt · Search Console



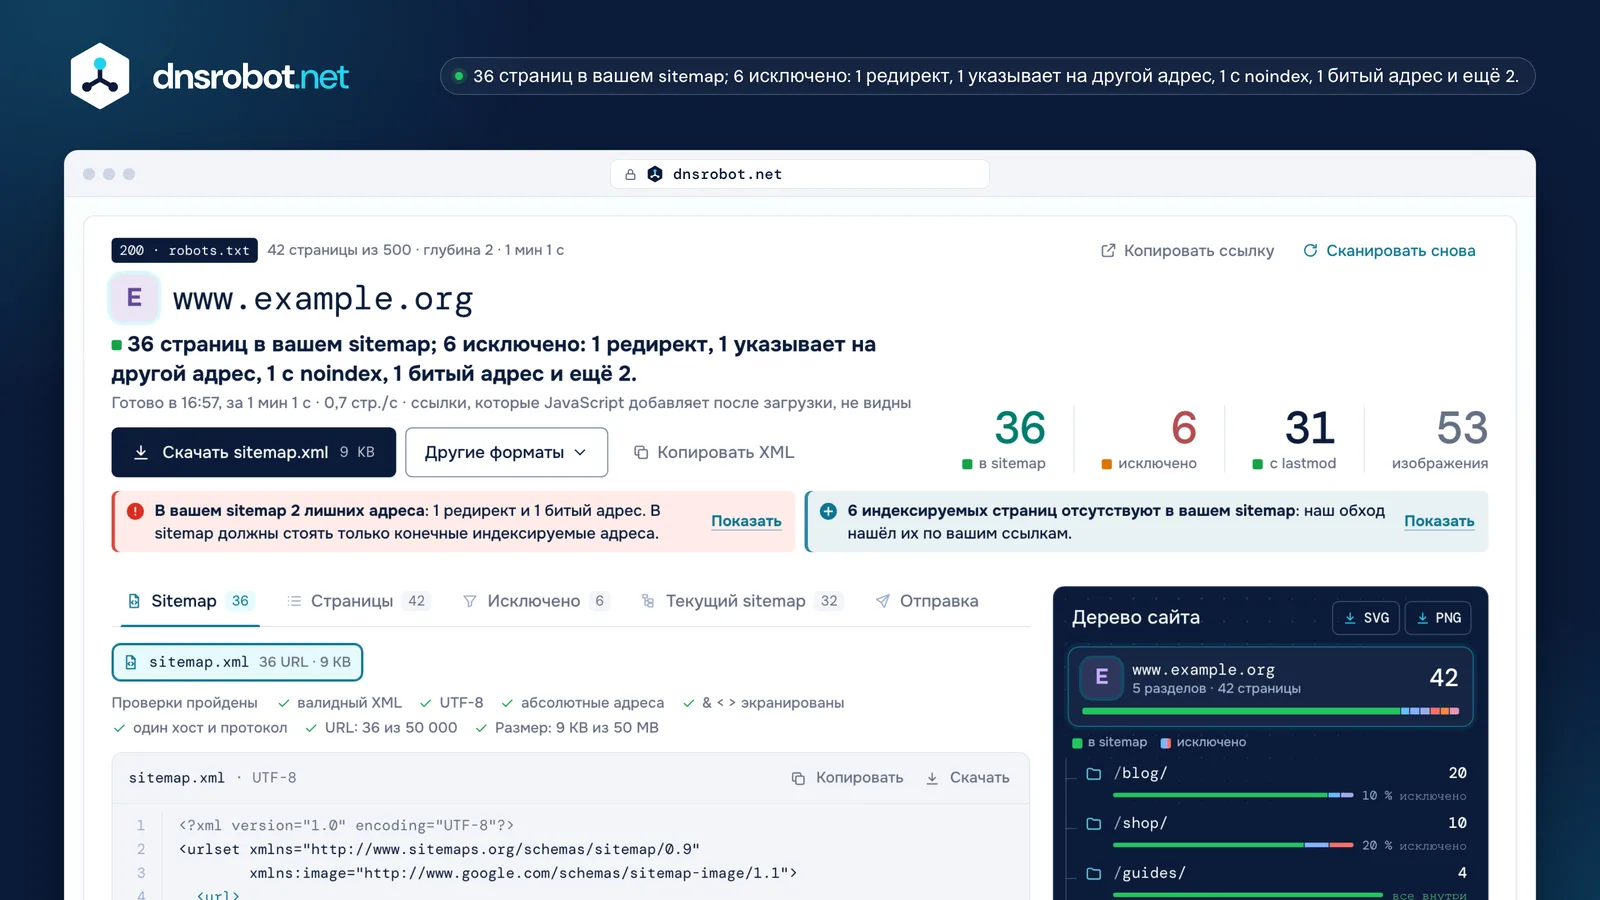
 ВердиктСколько страниц входит в файл, сколько исключено и почему — одним предложением. Крупные числа повторяют то же самое.Скачиваниеsitemap.xml или ZIP со всеми файлами и индексом, когда файл разбит; а ещё .xml.gz, TXT, HTML-карта сайта и CSV по каждой просканированной странице.ЗаметкиУстаревшие записи вашего текущего sitemap, страницы, которых в нём не хватает, и источник каждой даты lastmod.Дерево сайтаКаждый раздел с числом страниц и долей исключённых. Выберите ветку, чтобы отфильтровать страницы; дерево скачивается в SVG или PNG.
Как выглядит XML-карта сайта: пример sitemap
XML-карта сайта — это файл в UTF-8, где на каждую страницу приходится одна запись <url>. Обязательны только <urlset>, <url> и <loc>, всё остальное необязательно. Вот пример sitemap с разбором строка за строкой.
Каждый <loc> — это полный абсолютный адрес, который начинается с протокола и укладывается в 2048 символов, причём & записывается как & (sitemaps.org). <lastmod> — дата последнего изменения страницы в формате W3C, например 2026-09-14; время указывать необязательно, но вместе с ним нужен часовой пояс.
Пространство имён остаётся на http:// даже на сайте с https: это имя для парсеров, а не адрес, который кто-то загружает. <changefreq> и <priority> допустимы, но Google и Bing их игнорируют.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, объявлена в первой строке
- 2Пространство имён: http://, не https://
- 3Абсолютный адрес, & экранирован как &
- 4Настоящая дата изменения — или lastmod вовсе нет
- 5Google и Bing это игнорируют
- 6Без lastmod: главная только собирает другие страницы
Каким страницам место в sitemap и почему часть адресов исключается?
Каноническим адресам, которые вы хотите видеть в выдаче, по одному на страницу: конечным адресам, которые отвечают 200, индексируются и не запрещены в robots.txt. Всё остальное исключается, и причина написана рядом.
Редирект, страница с noindex или адрес, чей canonical указывает в другое место, подают поисковым системам противоречивый сигнал: sitemap говорит «индексируй это», а страница говорит обратное. Не называйте один адрес в sitemap, а другой в rel=canonical (Google); Search Console к тому же сообщает о картах сайта, где перечислены адреса, закрытые в robots.txt.
Любой адрес в sitemap — всего лишь предложение; какие страницы считать дублями, Google решает сам. Поэтому этот генератор и показывает причину для каждой исключённой страницы: noindex, который вы поставили сознательно, — это нормально, а noindex на вашем лучшем товаре — нет.
lastmod, changefreq и priority: что читают поисковые системы?
Google и Bing игнорируют changefreq и priority. Оба используют lastmod, но только пока он точен: дата, которая меняется при каждом обходе, приучает их ей не верить.
Google использует lastmod, «если он последовательно и достоверно точен», и дата должна отмечать последнее значимое изменение — основного содержимого, структурированных данных или ссылок, — а не новый год в копирайте (Google). Если lastmod раз за разом заявляет о свежих правках на старых страницах, ему перестают верить. Bing планирует обходы по lastmod и может не обращать внимания на даты, которые всегда сегодняшние. Yandex по-прежнему читает все три тега.
Поэтому этот генератор никогда не ставит сегодняшнюю дату. Он берёт lastmod из данных самой страницы в порядке ниже, а когда брать нечего — оставляет тег в стороне: для главной или для рубрики, которая просто собирает другие страницы, обойтись без него совершенно нормально.
| Тег | Bing | Yandex | |
|---|---|---|---|
| lastmod | использует, когда он точен | использует, когда он точен | читает |
| changefreq | игнорирует | игнорирует | читает |
| priority | игнорирует | игнорирует | читает |
Как выглядит «сегодня» у каждой страницы
412 записей, одна дата: это дата генерации, а не дата изменения.
50 000 адресов, 50 МБ и индекс sitemap
В один sitemap помещается не больше 50 000 адресов и 50 МБ в несжатом виде. За тем пределом, который вы перешагнёте первым, адреса разбивают на несколько файлов и перечисляют их в индексе sitemap, а отправляют уже индекс.
Предел считается по несжатому файлу, даже когда вы отдаёте его как .xml.gz — именно gzip, а не ZIP (sitemaps.org). Индекс вправе перечислять до 50 000 карт сайта, только файлы со своего же сайта, в своей папке или глубже, и никогда другой индекс. Naver Search Advisor не принимает файлы больше 10 МБ, поэтому для корейского сайта выберите предел 10 МБ в разделе «Больше настроек».
Языковые версии (xhtml:link) в счёт 50 000 не идут. Этот генератор разбивает файлы автоматически, а по вашей просьбе — по разделам: один файл для блога, другой для товаров.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Записи об изображениях и hreflang
Sitemap может перечислять ещё и изображения каждой страницы, и её версии на других языках — внутри записи <url> этой самой страницы.
Изображения используют пространство имён Google для картинок, до 1000 на страницу; в счёт идут только <image:image> и <image:loc>, а caption, title, license и geo_location отменены в 2022 году.
Для языков каждая запись перечисляет все версии страницы, включая её саму, через xhtml:link и код hreflang: язык по ISO 639-1 с необязательным регионом по ISO 3166-1, но никогда один только регион. Ссылки должны идти в обе стороны, иначе Google их игнорирует, поэтому генератор записывает кластер лишь тогда, когда каждая версия отвечает ссылкой, а остальные показывает вместе с ошибкой. x-default необязателен — он для посетителей, чьего языка у вас нет.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja ссылается на de, de в ответ не ссылается: кластер не записанзапись об изображении до 1000 на страницу
Как отправить sitemap в Google и Bing?
Добавьте в robots.txt строку Sitemap:, которую читает любой робот, и отправьте файл в Google Search Console и Bing Webmaster Tools. О новых и изменённых страницах IndexNow сообщает Bing, Yandex, Naver и другим сразу.
Отправлять в Search Console могут только подтверждённые владельцы сайта; строка в robots.txt работает у кого угодно. Search Console не идёт по редиректам для отправленного sitemap, поэтому указывайте конечный адрес файла. Bing читает sitemap, как только находит его, а дальше примерно раз в сутки.
Старых анонимных пингов больше нет: Bing отключил bing.com/ping 13 мая 2022 года, а Google объявил 26 июня 2023 года, что его пинг перестанет работать; теперь он отвечает 404. Инструмент, который до сих пор «пингует Google», не делает ничего.


XML- и HTML-карта сайта (и визуальная карта сайта)
XML-карта сайта — для роботов, HTML-карта сайта — страница со ссылками для посетителей, а визуальная карта сайта — картинка со структурой сайта для планирования. Отправить в поисковые системы можно только XML или список в TXT.
HTML-карта сайта по-прежнему помогает посетителям и распределяет ссылки на глубокие страницы, но заменить XML-файл она не может. Текстовая карта сайта — это просто адреса, по одному в строке, в файле с расширением .txt.
Этот генератор делает все три из одного обхода: sitemap.xml, HTML-карту сайта, которую можно вставить в страницу, и дерево сайта. Как генератор визуальной карты сайта он не стоит ничего: дерево скачивается в SVG или PNG, а сервисы визуальных карт сайта обычно берут за это деньги.
XML-карта сайтадля поисковых систем
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
HTML-карта сайтадля посетителей
Example Garden Co.
Садовый дневникУход за грядкамиСхема посадки перцаМагазинСтартовый набор для капельного поливаРуководства по выращиваниюВизуальная карта сайтадля планирования
А нужен ли вам sitemap вообще?
Небольшому сайту, все страницы которого ссылаются друг на друга, он может и не понадобиться: Google оценивает такой размер примерно в 500 страниц или меньше. Больше всего выигрывают крупные сайты, новые сайты, на которые мало ссылаются со стороны, и сайты со множеством изображений или видео.
Собственное руководство для начинающих от Google называет sitemap необязательным, а его отправку — подсказкой, а не приказом. Стоит он при этом немного, а обход, который его строит, показывает важные вещи: страницы, до которых не доводит ни одна ссылка, редиректы, на которые до сих пор указывают ваши меню, и разделы, почти целиком закрытые noindex.
может и не понадобиться
около 500 страниц или меньше, хорошо связаны ссылками
выигрывают больше всех
- крупные сайты
- новые сайты, на которые мало ссылаются
- много изображений или видео
- 5 страниц, до которых доводит только sitemap
Ошибки sitemap в Search Console и как их исправить
Почти все ошибки sitemap в Search Console сводятся к адресу, которому в файле не место, к неэкранированному символу, к дате без часового пояса или к файлу сверх пределов. В каждом случае ниже показана строка, из-за которой это происходит.
Нельзя использовать URL
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Ошибка синтаксического анализа
<loc>https://www.example.org/search?q=soil&page=2</loc>
Неправильно введена дата
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Неподдерживаемый формат файла
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
Слишком много URL
<url> × 50 001
Файл Sitemap содержит URL, доступ к которым заблокирован в файле robots.txt
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
Также: «Не получено» (блокировка, 404, ошибка сервера, ручные меры или низкий спрос на сканирование), «Ошибка сжатия» (пережмите файл gzip-ом) и «Неполные URL» (каждому файлу в индексе нужен полный адрес).
Может ли ИИ создать sitemap?
ИИ способен набросать структуру сайта для планирования, но sitemap — это список фактов о живых адресах: какие отвечают 200, какие закрыты noindex, какие редиректят. Узнать это можно, только загрузив каждый адрес.
Модель, у которой просят sitemap существующего сайта, угадывает адреса по шаблонам. Она не видит, что карточка товара теперь отвечает 404, что архив меток закрыт noindex, а старая запись редиректит, — и каждый такой адрес в файле Search Console может вам предъявить. Используйте ИИ для плана, а сам файл собирайте обходом.
Источники
- Протокол sitemaps.org и его FAQ: формат, пределы 50 000 / 50 МБ, индекс, текстовые карты сайта
- Google Search Central: как собрать sitemap, большие карты сайта, версии на других языках, карты сайта для изображений, lastmod и отключённый пинг и ошибки в отчёте «Файлы Sitemap»
- Bing: карты сайта в поиске с ИИ (2025), тег lastmod (2023) и убранный пинг (2022)
- Yandex: sitemap, Naver Search Advisor: фиды и IndexNow
- RFC 9309 — стандарт robots.txt, которому следует наш робот
| URL | Угадано | Просканировано |
|---|---|---|
| /blog/raised-care/ | включить | В sitemap200 |
| /product/fern-varieties/ | включить | 4xx404 |
| /tag/native-bed/ | включить | noindexmeta |
| /2019/07/raised-care/ | включить | Редирект301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | включить | Canonical на другой адрес→ /blog/pollinator-kit/ |
Генератор sitemap: частые вопросы
Этот XML-генератор sitemap бесплатный?
Почему часть моих страниц не попала в sitemap?
Куда положить файл sitemap.xml?
Сколько адресов помещается в один sitemap?
Использует ли Google priority и changefreq?
Почему у части страниц нет даты lastmod?
Должны ли в sitemap попадать редиректы и страницы с noindex?
Как отправить мой sitemap в Google?
Моя CMS уже делает карту сайта. Нужна ли мне эта?
Соблюдает ли этот сканер robots.txt?
Сможет ли он просканировать сайт на JavaScript?
Что такое IndexNow и нужен ли sitemap вместе с ним?
Чего-то не хватает?Предложите функцию или новый инструмент
Ещё инструменты для сканирования и SEO
Анализ ссылок
Анализ всех ссылок на странице с определением dofollow/nofollow и проверкой HTTP статуса
Проверка редиректов
Проверка редиректов URL, цепочек перенаправлений и кодов HTTP статуса для SEO
Проверка HTTP-заголовков
Анализ HTTP заголовков ответа и оценка заголовков безопасности
Проверка доступности сайта
Сайт не работает у всех или только у вас? Проверьте доступность сайта из 11 точек и с вашего подключения, со скриншотом в реальном времени
Поиск поддоменов
Поиск всех поддоменов любого домена
Определить CMS сайта
Какая CMS, тема, плагины и технологии у сайта, с доказательством для каждого