











Générateur de Sitemap
Un générateur de sitemap gratuit pour la création d'un sitemap XML : il explore votre site comme le fait un moteur de recherche, ne garde que les pages qui ont leur place dans les résultats et vous dit pourquoi il a laissé de côté chacune des autres URL.
Un domaine suffit : example.org démarre à sa page d'accueil.
- robots.txtLu en premier, respecté
- Votre sitemapTrouvé et comparé
- ExploréesJusqu'à 500 pages, 3 à la fois
- Décidéesnoindex, canonical, redirections
Comment créer un sitemap XML, étape par étape
Saisissez votre page d'accueil ci-dessus et choisissez Générer le sitemap. Le robot lit robots.txt, suit vos liens comme le fait un moteur de recherche, ne garde que les pages qui ont leur place et vous remet un sitemap.xml à déposer à la racine de votre site.
Une page a sa place quand elle répond 200, qu'elle est en HTML, qu'elle n'est pas en noindex, qu'elle se désigne elle-même comme canonical et qu'elle n'est pas bloquée par robots.txt. Toute autre URL atterrit dans Laissées de côté avec son motif : vous distinguez ainsi une erreur d'un choix.
Déposez le fichier à la racine, https://www.example.org/sitemap.xml : un sitemap ne peut lister que les URL de son propre dossier et de ceux qui en dépendent, donc la racine couvre tout le site (Google). Ajoutez ensuite une ligne Sitemap: à robots.txt et envoyez-le dans Google Search Console et Bing Webmaster Tools.
1Saisissez votre page d'accueil
example.orgou collez une liste d'URL2Nous explorons et nous décidons
robots.txt 200499/500412 dans le sitemap · 87 laissées de côté3Téléchargez le fichier
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML ou CSV4Déposez et envoyez
/sitemap.xmlSitemap: https://www.example.org/…la racine · robots.txt · Search Console



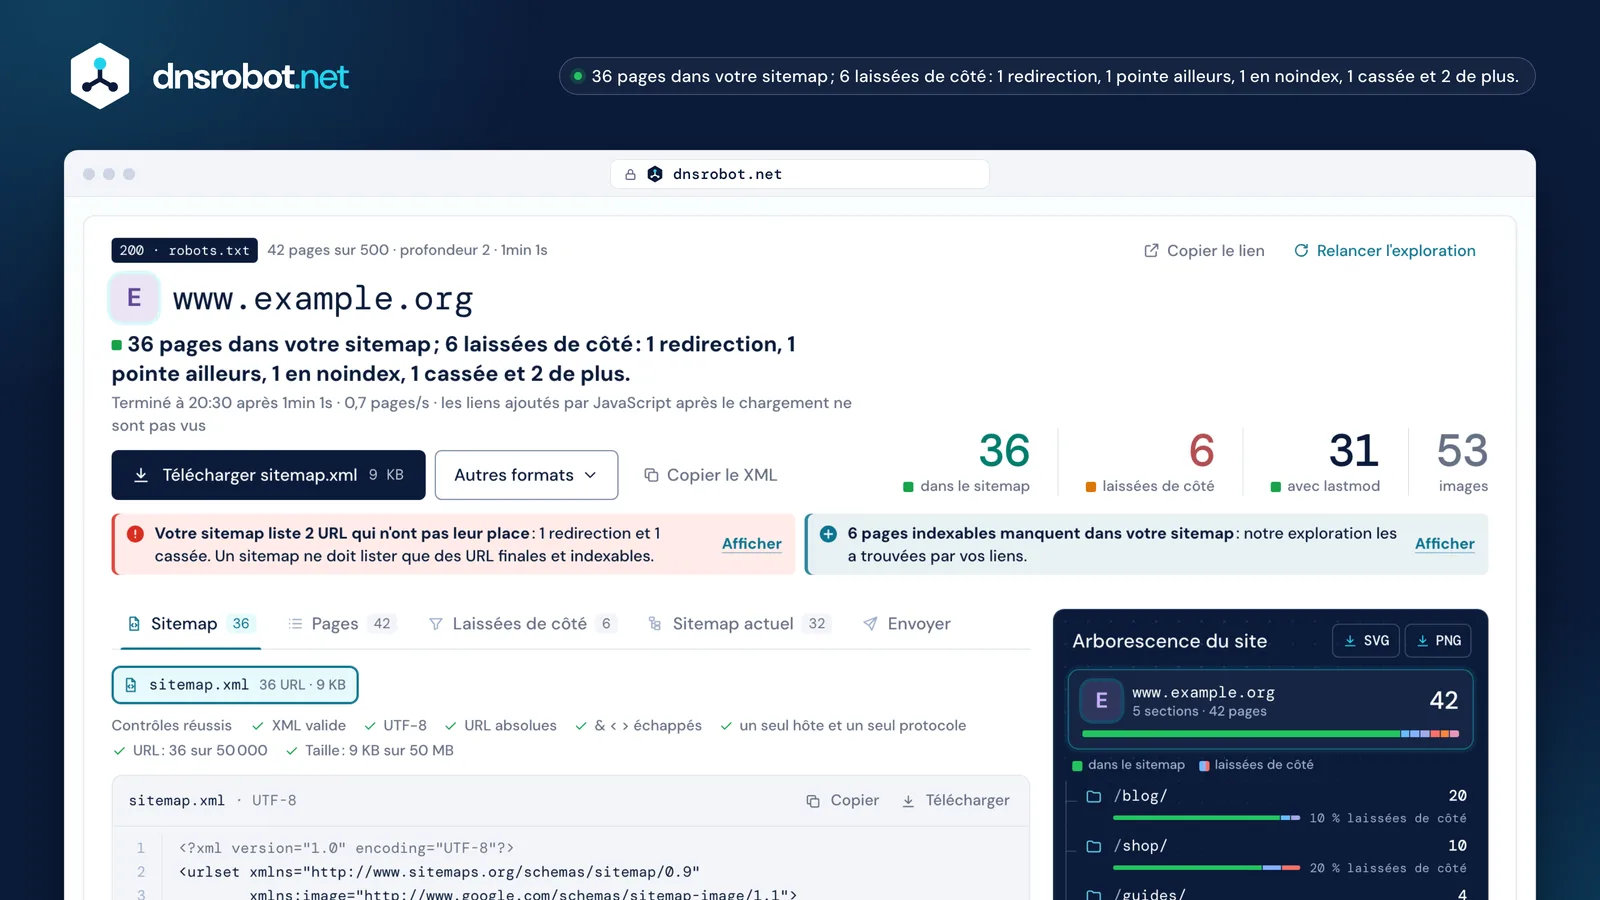
 Le verdictCombien de pages entrent, combien sont laissées de côté et pourquoi, en une phrase. Les grands chiffres le répètent.Téléchargersitemap.xml, ou un ZIP avec tous les fichiers et l'index quand il est réparti ; aussi .xml.gz, TXT, un plan du site HTML et un CSV de chaque page explorée.Les notesLes entrées périmées de votre sitemap actuel, les pages qui lui manquent, et d'où vient chaque date lastmod.L'arborescence du siteChaque section avec son nombre de pages et la part laissée de côté. Sélectionnez une branche pour filtrer les pages ; téléchargez-la en SVG ou en PNG.
À quoi ressemble un sitemap XML ? Un exemple de sitemap
Un sitemap XML est un fichier UTF-8 avec une entrée <url> par page. Seuls <urlset>, <url> et <loc> sont obligatoires ; tout le reste est facultatif. Voici un exemple de sitemap, annoté ligne par ligne.
Chaque <loc> est une URL complète et absolue, qui commence par le protocole et reste sous 2 048 caractères, avec & écrit & (sitemaps.org). <lastmod> est la date de la dernière modification de la page, au format W3C comme 2026-09-14 ; l'heure est facultative, mais elle exige un fuseau horaire.
L'espace de noms reste en http://, même sur un site en https : c'est un nom pour les analyseurs, pas une adresse que quelqu'un va chercher. <changefreq> et <priority> sont permis, mais Google et Bing les ignorent.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, déclaré sur la première ligne
- 2L'espace de noms : http://, pas https://
- 3Une URL absolue, avec & échappé en &
- 4La vraie date de modification, ou pas de lastmod du tout
- 5Ignoré par Google et Bing
- 6Pas de lastmod : une page d'accueil ne fait que rassembler d'autres pages
Quelles pages ont leur place dans un sitemap, et pourquoi certaines sont-elles laissées de côté ?
Les URL canoniques que vous voulez voir dans les résultats, une par page : des URL finales qui répondent 200, qui sont indexables et qui ne sont pas bloquées par robots.txt. Tout le reste est laissé de côté, avec le motif écrit à côté.
Une redirection, une page en noindex ou une URL dont le canonical pointe ailleurs envoie un message contradictoire aux moteurs de recherche : le sitemap dit « indexez ceci » pendant que la page dit le contraire. Ne nommez pas une URL dans le sitemap et une autre dans rel=canonical (Google), et Search Console signale les sitemaps qui listent des URL bloquées par robots.txt.
Chaque URL d'un sitemap n'est qu'une suggestion ; c'est Google qui décide encore quelles pages sont des doublons. C'est pourquoi ce générateur montre le motif de chaque page qu'il laisse de côté : un noindex voulu, c'est très bien ; un noindex sur votre meilleur produit, non.
lastmod, changefreq et priority : que lisent les moteurs de recherche ?
Google et Bing ignorent changefreq et priority. Tous les deux utilisent lastmod, mais seulement quand il est exact : une date qui change à chaque exploration leur apprend à ne plus lui faire confiance.
Google utilise lastmod « s'il est systématiquement et vérifiablement exact », et il doit marquer la dernière modification importante — le contenu principal, les données structurées ou les liens — et non une nouvelle année de copyright (Google). Un lastmod qui continue d'annoncer des changements récents sur de vieilles pages cesse d'être pris au sérieux. Bing programme ses explorations avec lastmod et peut ignorer des dates qui sont toujours celles du jour. Yandex, lui, lit encore les trois balises.
Ce générateur n'écrit donc jamais la date du jour. Il prend lastmod dans les données de la page elle-même, dans l'ordre ci-dessous, et le laisse de côté quand il n'y en a pas : s'en passer convient très bien à une page d'accueil ou à une page de catégorie qui ne fait que rassembler les autres.
| Balise | Bing | Yandex | |
|---|---|---|---|
| lastmod | l'utilise quand elle est exacte | l'utilise quand elle est exacte | la lit |
| changefreq | l'ignore | l'ignore | la lit |
| priority | l'ignore | l'ignore | la lit |
À quoi ressemble un « aujourd'hui » pour chaque page
412 entrées, une seule date : une date de création, pas des dates de modification.
50 000 URL, 50 MB et l'index de sitemaps
Un sitemap contient au plus 50 000 URL et 50 MB décompressés. Dès que vous franchissez la première de ces deux limites, répartissez les URL dans plusieurs fichiers et listez-les dans un index de sitemaps ; c'est ensuite l'index que vous envoyez.
La limite compte le fichier décompressé, même quand vous le servez en .xml.gz — gzip, pas ZIP (sitemaps.org). Un index peut lister jusqu'à 50 000 sitemaps, uniquement des fichiers de son propre site, dans son dossier ou plus bas, et jamais un autre index. Naver Search Advisor refuse les fichiers de plus de 10 MB : choisissez donc la limite de 10 MB dans Plus d'options pour un site coréen.
Les alternatives de langue (xhtml:link) ne comptent pas dans les 50 000. Ce générateur répartit automatiquement et, si vous le demandez, par section : un fichier pour le blog, un pour les produits.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Entrées d'image et hreflang
Un sitemap peut aussi lister les images de chaque page et ses versions dans d'autres langues, à l'intérieur de l'entrée <url> de cette page.
Les images utilisent l'espace de noms image de Google, jusqu'à 1 000 par page ; seuls <image:image> et <image:loc> comptent encore, et caption, title, license et geo_location ont été retirés en 2022.
Pour les langues, chaque entrée liste toutes les versions de la page, elle-même comprise, avec xhtml:link et un code hreflang : une langue ISO 639-1 avec une région ISO 3166-1 facultative, jamais une région seule. Les liens doivent aller dans les deux sens, sinon Google les ignore : ce générateur n'écrit donc un groupe que lorsque toutes les versions pointent en retour, et montre les autres avec leur défaut. x-default est facultatif, pour les visiteurs dont vous n'avez pas la langue.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja pointe vers de, de ne pointe pas en retour : le groupe n'est pas écritentrée image jusqu'à 1 000 par page
Comment envoyer un sitemap à Google et à Bing ?
Ajoutez une ligne Sitemap: à robots.txt, que tous les robots lisent, et envoyez le fichier dans Google Search Console et Bing Webmaster Tools. Pour les pages nouvelles et modifiées, IndexNow prévient Bing, Yandex, Naver et d'autres d'un seul coup.
Seuls les propriétaires vérifiés d'un site peuvent l'envoyer dans Search Console ; la ligne dans robots.txt, elle, marche pour tout le monde. Search Console ne suit pas les redirections pour un sitemap envoyé : donnez-lui donc son adresse finale. Bing lit un sitemap dès qu'il le trouve, puis environ une fois par jour.
Les vieux pings anonymes ont disparu : Bing a coupé bing.com/ping le 13 mai 2022, et Google a annoncé le 26 juin 2023 que son ping cesserait de fonctionner ; il répond aujourd'hui 404. Un outil qui « ping encore Google » ne fait rien.


Sitemaps XML et plans du site HTML (et sitemaps visuels)
Un sitemap XML est fait pour les robots, un plan du site HTML est une page de liens pour les visiteurs, et un sitemap visuel est une image de la structure du site, pour la préparer. Seul le XML, ou une liste TXT, peut être envoyé aux moteurs de recherche.
Un plan du site HTML aide toujours les visiteurs et répartit des liens vers les pages profondes, mais il ne peut pas remplacer le fichier XML. Un sitemap en texte simple n'est qu'une liste d'URL, une par ligne, dans un fichier qui finit par .txt.
Ce générateur fabrique les trois à partir d'une seule exploration : sitemap.xml, un plan du site HTML à coller dans une page, et l'arborescence du site. Comme générateur de sitemap visuel, il ne coûte rien : l'arborescence se télécharge en SVG ou en PNG, ce que les services de sitemap visuel font en général payer.
Sitemap XMLpour les moteurs de recherche
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
Plan du site HTMLpour les visiteurs
Example Garden Co.
Journal du jardinEntretien des carrés potagersPlan des poivronsBoutiqueKit goutte-à-goutte de démarrageGuides de cultureSitemap visuelpour préparer
Avez-vous vraiment besoin d'un sitemap ?
Un petit site dont toutes les pages se lient entre elles peut s'en passer : Google avance le chiffre d'environ 500 pages ou moins. Ce sont les grands sites, les sites récents avec peu de liens extérieurs et les sites riches en images ou en vidéos qui en profitent le plus.
Le guide de démarrage de Google qualifie le sitemap de facultatif, et l'envoyer est une indication, pas un ordre. Il coûte pourtant peu, et l'exploration qui le construit montre des choses qu'il vaut mieux savoir : des pages qu'aucun lien n'atteint, des redirections vers lesquelles vos menus pointent encore, et des sections presque entièrement en noindex.
peut s'en passer
environ 500 pages ou moins, bien liées
en profite le plus
- grands sites
- sites récents, peu de liens extérieurs
- beaucoup d'images ou de vidéos
- 5 pages que seul le sitemap atteint
Les erreurs de sitemap dans Search Console, et comment les corriger
La plupart des erreurs de sitemap dans Search Console se ramènent à une URL que le sitemap n'a pas le droit de lister, à un caractère non échappé, à une date sans fuseau horaire ou à un fichier au-delà des limites. Chaque cas ci-dessous montre la ligne qui le provoque.
URL non autorisée
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Erreur d'analyse syntaxique
<loc>https://www.example.org/search?q=soil&page=2</loc>
Date incorrecte
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Format non compatible
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
Trop d'URL
<url> × 50 001
Le sitemap contient des URL bloquées par le fichier robots.txt
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
Également : Impossible de récupérer le sitemap (bloqué, 404, une erreur serveur, une action manuelle ou une faible demande d'exploration), Erreur de compression (recompressez-le en gzip) et URL incomplète (chaque fichier d'un index a besoin de son URL complète).
L'IA peut-elle créer un sitemap ?
L'IA peut esquisser la structure d'un site pour la préparer, mais un sitemap est une liste de faits sur des URL en ligne : lesquelles répondent 200, lesquelles sont en noindex, lesquelles redirigent. Seule la récupération de chaque URL vous le dit.
Un modèle à qui l'on demande le sitemap d'un site existant devine les URL à partir de motifs. Il ne peut pas voir qu'une fiche produit répond désormais 404, qu'une archive de tags est en noindex ou qu'un vieil article redirige, et chacune de ces URL dans le fichier est une URL que Search Console pourra signaler. Utilisez l'IA pour le plan, puis explorez pour le fichier.
Sources
- Le protocole sitemaps.org et sa FAQ : le format, les limites de 50 000 / 50 MB, l'index, les sitemaps en texte
- Google Search Central : créer un sitemap, les grands sitemaps, les versions localisées, les sitemaps d'images, lastmod et le ping retiré et les erreurs du rapport Sitemaps
- Bing : les sitemaps dans la recherche dopée à l'IA (2025), la balise lastmod (2023) et le ping retiré (2022)
- Yandex : sitemap, Naver Search Advisor : les flux et IndexNow
- RFC 9309, la norme robots.txt que ce robot suit
| URL | Devinée | Explorée |
|---|---|---|
| /blog/raised-care/ | inclure | Dans le sitemap200 |
| /product/fern-varieties/ | inclure | 4xx404 |
| /tag/native-bed/ | inclure | noindexmeta |
| /2019/07/raised-care/ | inclure | Redirection301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | inclure | Canonical ailleurs→ /blog/pollinator-kit/ |
Questions fréquentes sur le générateur de sitemap
Ce générateur de sitemap XML est-il gratuit ?
Pourquoi certaines de mes pages manquent-elles dans le sitemap ?
Où faut-il placer le fichier sitemap.xml ?
Combien d'URL un sitemap peut-il contenir ?
Google utilise-t-il priority et changefreq ?
Pourquoi certaines pages n'ont-elles aucune date lastmod ?
Un sitemap doit-il contenir des redirections ou des pages en noindex ?
Comment envoyer mon sitemap à Google ?
Mon CMS crée déjà un sitemap. Ai-je besoin de celui-ci ?
Ce robot d'exploration respecte-t-il robots.txt ?
Peut-il explorer un site construit en JavaScript ?
Qu'est-ce qu'IndexNow, et faut-il encore un sitemap avec ?
Plus d'outils d'exploration et de SEO
Analyseur de Liens
Analysez tous les liens d'une page avec détection dofollow/nofollow et vérification de statut HTTP
Vérificateur de Redirections
Vérifiez les redirections d'URL, les chaînes de redirection et les codes de statut HTTP pour le SEO
Vérificateur d'en-têtes HTTP
Analysez les en-têtes de réponse HTTP et la notation des en-têtes de sécurité
Vérificateur de site en panne
En panne pour tout le monde ou juste chez vous ? Vérifiez un site depuis 11 lieux et votre propre connexion, avec une capture en direct
Recherche de Sous-domaines
Découvrez tous les sous-domaines de n'importe quel domaine
Détecteur de CMS
Quel CMS, thème, plugins et technologies un site utilise, avec la preuve de chacun