











Analyseur de liens
Lancez l'analyse de liens d'une page comme Google la lit : liens internes ou externes, suivis ou nofollow, sponsored ou ugc, où chacun mène vraiment et lesquels sont cassés. Un moyen simple de vérifier les liens d'une page.
Un domaine suffit aussi : example.org lit sa page d'accueil.
- LectureLit le HTML une fois
- RedirectionsJusqu'à 10, chacune vérifiée
- Robotsmeta + X-Robots-Tag
- Liens trouvés<a> et <area>
Que vérifie une analyse de liens ?
Une analyse de liens lit une page et dresse la liste de tous ses liens : où mène chacun, comment il est balisé pour les moteurs de recherche, ce que dit son texte d'ancre et où il aboutit vraiment quand on le suit.
Elle lit le HTML de la page comme Googlebot le voit d'abord. Google suit les éléments <a> qui ont un href (Google) ; les liens relatifs sont résolus à partir du <base href> de la page, sinon de son adresse après redirections (HTML).
Ensuite, chaque URL unique est interrogée une fois, par un GET dont les redirections sont suivies saut par saut. Une requête HEAD est plus rapide, mais les serveurs y répondent souvent autrement que pour une vraie visite : un lien qui finit en 404 derrière une redirection compte donc ici comme cassé.
- 1Où il mèneexternewww.rfc-editor.org
- 2Comment il est balisénofollowmw:extlinkconservé, sans effet SEO
- 3Ce qu'il dit“1035”
- 4Où il aboutit↳ 301 /info/rfc1035/OK 200185 ms
- 5Où il se trouvelien 187 sur 1 117, sous « Contents »
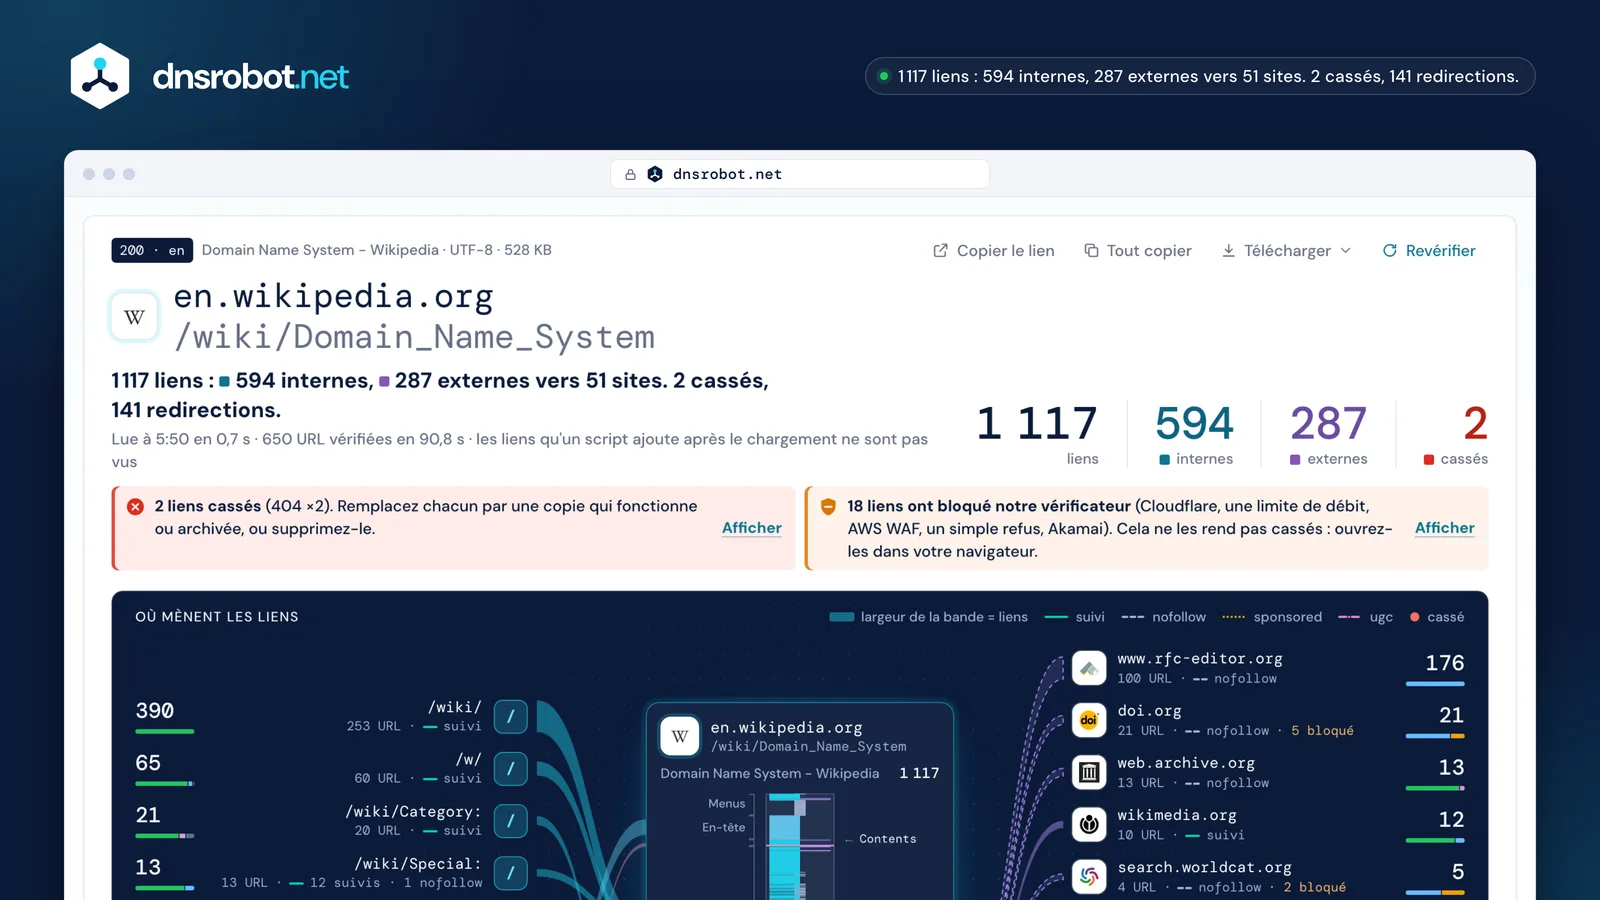
 La réponse d'abordCombien de liens compte la page, combien restent sur le site, combien en sortent et combien sont cassés.Des remarques avec une correctionLiens cassés, liens que seule une protection anti-bots a arrêtés, redirections à mettre à jour, ancres vides : chacun avec son nombre et ce qu'il faut faire.La page, de haut en basUn trait par lien, à sa place dans la page : menus, article, références, pied de page.Où mènent les liensUne bande par section et par site, aussi large que son nombre de liens, en pointillés quand les liens sont nofollow.
Liens internes et liens externes : lequel est lequel ?
Un lien interne pointe vers le même hôte que la page ; un lien externe pointe vers un autre site web. Les liens vers un autre hôte du même site, comme de.wikipedia.org depuis en.wikipedia.org, sont comptés à part.
Les liens internes aident les lecteurs et les robots à trouver les autres pages d'un site ; chaque page importante devrait être liée depuis au moins une autre (Google). Les liens externes ne sont pas un risque en eux-mêmes : citer de bonnes sources aide les lecteurs à faire confiance à une page.
Google suggère nofollow seulement pour les liens dont vous ne vous portez pas garant, pas pour tous les liens externes. Un lien vers #section reste sur la même page, et Google ne traite pas les fragments comme des pages distinctes (Google).
- même hôte 514
- même site, autre hôte 80
- autre site 287
- même page 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_nameinterneMême hôte que la page : interne.
- de.wikipedia.org/wiki/Domain_Name_Systemmême siteMême site (wikipedia.org), autre hôte : compté à part.
- www.wikidata.org/wiki/Q8767externeAutre domaine, même si Wikimedia l'exploite : externe.
- www.rfc-editor.org/rfc/rfc1035externeAutre domaine : externe.
nofollow, sponsored et ugc (et pourquoi « dofollow » n'est pas un attribut)
rel="nofollow" demande aux moteurs de recherche de ne pas compter un lien comme votre recommandation, rel="sponsored" signale un lien payant ou une publicité, et rel="ugc" un lien écrit par vos utilisateurs. Un lien sans aucune de ces valeurs est suivi : il n'existe pas de valeur dofollow.
Depuis le 10 septembre 2019, les trois sont des indications et non des ordres, et depuis le 1er mars 2020 aussi pour l'exploration et l'indexation (Google). Les valeurs se combinent, comme ugc nofollow, séparées par des espaces ou des virgules.
Le point le plus important : un lien payant sans sponsored ni nofollow enfreint les règles anti-spam de Google (Google). Sur l'article Wikipedia que nous avons lu, 267 des 287 liens externes portent nofollow, que MediaWiki ajoute à chaque citation.
<a href>Suivi par défaut : rien à ajouterrel="nofollow"Je ne m'en porte pas garant : quand aucune autre valeur ne convientrel="sponsored"Payant ou publicité : requis sur les liens payants (ou nofollow)rel="ugc"Écrit par des utilisateurs : commentaires, messages de forumrel="ugc nofollow"Les deux : autorisé, pour les anciens robotsrel="dofollow"Pas une valeur : navigateurs et Google l'ignorent
- 2005Google introduit nofollow
- 2019-09-10sponsored et ugc arrivent ; les trois deviennent des indications
- 2020-03-01indications aussi pour l'exploration et l'indexation
Et si la page elle-même indique nofollow ?
Alors Google ne suit aucun de ses liens, quel que soit le rel de chacun. Une balise meta robots ou un en-tête X-Robots-Tag avec nofollow s'applique à toute la page ; cet outil marque chaque lien « nofollow (page) ».
Google lit les noms robots et googlebot quelle que soit la casse, même dans le body, et none signifie noindex plus nofollow (Google). Les mêmes règles peuvent venir d'un en-tête, comme X-Robots-Tag: nofollow.
Les pages d'historique des révisions de Wikipedia portent noindex,nofollow volontairement. La version précédente de cet outil ne lisait jamais la balise et comptait 194 des 200 premiers liens d'une page d'historique comme suivis.
sur les 200 premiers liens : la balise meta n'était jamais lue
liens, tous nofollow (page) : Google n'en suit aucun
543 nofollow (page)6 nofollowX-Robots-Tag: none
Liens cassés : comment les trouver et les corriger
Un lien est cassé quand son URL répond par une erreur comme 404 Not Found ou 410 Gone, ou redirige vers l'une d'elles, ou quand son nom n'existe pas. Analysez la page, puis ouvrez l'onglet Cassés.
Corrigez chacun en liant la nouvelle adresse de la page, une copie archivée, ou rien. Google retire les pages 4xx de son index (Google), et le lecteur qui suit le lien n'arrive nulle part.
Toute erreur ne signifie pas cassé : 401 demande une connexion, donc la page existe (RFC 9110), et un 5xx ou un délai dépassé passe souvent, alors revérifiez-les plus tard. Sur l'article que nous avons lu, 2 URL sur 656 étaient cassées, toutes deux dans ses références ; une troisième a répondu un simple 403, que nous classons comme bloquée.
- umbrella.cisco.com404
La page a disparu
Cisco a retiré l'article de blog ; le serveur le dit clairement.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeLiez la copie archivée sur web.archive.org, ou supprimez le lien.- http://www.apwg.org301
- https://…/1H2010.pdf404
Une redirection qui finit en 404
http:// passe à https://, et le PDF n'y est pas. Compté comme cassé, pas comme redirection.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfTrouvez où se trouve désormais le rapport, ou citez une archive.- www.akamai.com403
Un simple 403 : bloqué, pas cassé
Le serveur a refusé notre vérificateur sans aucun signe de protection anti-bots. Le fichier a peut-être disparu, ou le serveur écarte les robots.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfOuvrez-le dans votre navigateur ; s'il s'ouvre, gardez-le.

Redirections dans les liens : faut-il les corriger ?
Un lien qui redirige fonctionne encore, mais chaque saut coûte une requête et du temps. Faites pointer les liens vers l'adresse finale, surtout ceux de votre propre site, où vous maîtrisez les deux extrémités.
Un 301 ou 308 indique un déplacement définitif ; un 302, 303 ou 307 est temporaire, et Google continue d'afficher l'ancienne adresse (Google). Googlebot suit jusqu'à 10 sauts, les navigateurs jusqu'à 20 (Google).
rfc-editor.org renvoie désormais ses pages /rfc/ vers /info/, si bien que 175 liens de l'article que nous avons lu prennent un saut de plus. Une redirection qui finit en 404 est comptée ici comme cassée, pas comme redirection.
- doi.org/10.17487/RFC1035302302 : temporaire, l'ancienne URL reste celle à utiliser
- www.rfc-editor.org/info/rfc1035301301 : déplacé définitivement, liez la nouvelle URL
- www.rfc-editor.org/info/rfc1035/200
liens pointent vers rfc-editor.org/rfc/…, qui renvoie désormais vers /info/…
des 656 URL de la page redirigent
sauts suivis au maximum par Googlebot ; les navigateurs abandonnent après 20
« Bloqué ici, mais ça marche dans mon navigateur »
De nombreux sites placent une protection anti-bots devant leurs pages. Elle arrête les visiteurs qui n'exécutent pas JavaScript ou paraissent automatisés : notre vérificateur reçoit alors un 403 ou un 429 alors que votre navigateur passe. Ces liens sont classés Bloqués, pas cassés.
Cloudflare signale ses défis par un en-tête cf-mitigated: challenge (Cloudflare) et soumet par défaut à un défi les clients dont le user agent est inhabituel ; 429 signifie trop de requêtes (RFC 6585).
Nous envoyons un user agent honnête et n'essayons jamais de contourner une protection. Sur l'article que nous avons lu, 18 URL étaient bloquées : 17 par Cloudflare, AWS WAF, Akamai et des limites de débit, une par un simple 403. Ouvrez-les vous-même avant de modifier quoi que ce soit.
- Défi Cloudflare7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Limite de débit (429)3search.worldcat.org · api.semanticscholar.org · 429
- Protection anti-bots Akamai1dyn.com → www.oracle.com · 403
Combien de liens une page peut-elle avoir ?
Il n'y a pas de limite. Les consignes de Google ne fixent aucun nombre et indiquent qu'il n'existe pas de nombre idéal ; l'ancien conseil de rester sous 100 liens date de l'époque où Google ne lisait qu'une partie d'une page.
Ce qui compte, c'est que chaque lien aide le lecteur, que les plus importants soient de vrais liens <a href> dans le HTML, et qu'ils se trouvent dans les 2 premiers Mo de HTML, la seule partie que Googlebot lit pour la recherche (Google).
L'article Wikipedia que nous avons lu contient 1 117 liens dans 528 Ko de HTML. example.com n'en contient aucun dans son HTML : son unique lien est ajouté par un script après le chargement de la page.
- wikipedia.org/wiki/Domain_Name_System1 117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0son unique lien est ajouté par un script
Texte d'ancre et liens d'images
Le texte d'ancre est le texte cliquable d'un lien ; il dit aux lecteurs et à Google de quoi parle la cible. Pour un lien d'image, Google lit le texte alt de l'image comme ancre : un lien d'image à alt vide ne dit donc rien.
Une bonne ancre est courte, précise et décrit la cible ; « cliquez ici » et « en savoir plus » n'apprennent rien à personne (Google). Google se rabat sur l'attribut title quand un lien n'a pas de texte.
Cet outil affiche le texte alt de chaque lien d'image, repère les ancres vides et liste les ancres répétées. Sur l'article que nous avons lu, « edit » est l'ancre de 49 liens : des liens de modification de section, acceptables sur Wikipedia, faibles partout ailleurs.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>ancreDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>ancreImageWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>ancreViderien : un lien vide
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank et noopener : encore nécessaire ?
Pas dans les navigateurs actuels. Un lien avec target="_blank" ouvre un nouvel onglet, et tous les grands navigateurs le traitent désormais comme rel="noopener" : la nouvelle page ne peut pas revenir modifier la vôtre. Un noopener manquant est signalé comme une remarque, pas comme un risque.
Le standard HTML a fait de _blank un équivalent de noopener en 2019 (HTML) ; Safari 12.1, Firefox 79 et Chrome 88 l'ont livré. noreferrer masque aussi la provenance du visiteur : un choix de confidentialité et d'analyse, pas un correctif de sécurité.
<a target="_blank">aucun relwindow.opener→ null- 2019-02HTML : _blank implique noopenerwhatwg/html #4330
- 2019Safari 12.1noopener implicite
- 2020Firefox 79noopener implicite
- 2021Chrome 88noopener implicite
- dnsrobot.net/blog/hosting-com-coupon23 sur 23 ont noopener ou noreferrer
- github.com10 sur 10 ont noopener ou noreferrer
- developer.mozilla.org/en-US/10 sur 10 ont noopener ou noreferrer
Mythes sur les liens, vérifiés dans les pages de Google
La plupart des conseils sur les liens répètent quelques vieilles règles. Voici ce que dit aujourd'hui la documentation de Google sur chacune.
| Le mythe | Ce que dit Google | Source |
|---|---|---|
| Faux« dofollow » est un attribut à ajouter | Les liens sont suivis par défaut ; seuls nofollow, sponsored et ugc ont un sens. | developers.google.com |
| FauxLe nofollow sur les liens externes fait pénaliser un site | Google demande nofollow ou sponsored seulement sur les liens payants et ceux dont vous ne vous portez pas garant. | developers.google.com |
| DépasséGardez une page sous 100 liens | Il n'y a ni limite ni nombre idéal de liens par page. | developers.google.com |
| FauxNofollow garde une page hors de l'index | Pour garder une page hors de Google, autorisez l'exploration et utilisez noindex. | developers.google.com |
| DépasséLes liens nofollow ne transmettent rien du tout | Depuis 2019, ce sont des indications : Google peut les utiliser, même s'il ne les compte généralement pas pour le classement. | developers.google.com |
| Dépassétarget=_blank sans noopener est une faille de sécurité | Les navigateurs actuels appliquent noopener aux liens _blank, sauf si rel=opener demande l'opener. | html.spec.whatwg.org |
Sources
- Google Search Central : liens explorables, qualifier les liens sortants, balise meta robots, codes d'état HTTP
- HTML Living Standard (liens, valeurs rel, URL de base) et RFC 9110 (codes d'état)
- Cloudflare : détecter un défi
- Les chiffres : notre propre analyse de en.wikipedia.org/wiki/Domain_Name_System, 23 octobre 2026
FAQ de l'analyseur de liens
Ce lien est-il sans danger à ouvrir ?
Comment trouver tous les liens d'une page web ?
Quelle est la différence entre liens internes et liens externes ?
Que signifie nofollow, et dofollow est-il un vrai attribut ?
Quand utiliser rel="sponsored" ou rel="ugc" ?
Pourquoi un lien est-il marqué « Bloqué » et non cassé ?
Pourquoi un lien redirige-t-il, et faut-il le corriger ?
Trouve-t-il les liens ajoutés par JavaScript ?
La page bloque les lecteurs automatisés. Puis-je quand même l'analyser ?
Combien de liens vérifie-t-il ?
Combien de liens une page devrait-elle avoir ?
L'analyseur de liens est-il gratuit, et conservez-vous les pages ?
Plus d'outils pour votre site web et le SEO
Recherche de Sous-domaines
Découvrez tous les sous-domaines de n'importe quel domaine
Vérificateur de site en panne
En panne pour tout le monde ou juste chez vous ? Vérifiez un site depuis 11 lieux et votre propre connexion, avec une capture en direct
Vérification du Certificat SSL
Vérifiez la validité et les détails de sécurité du certificat SSL
Vérificateur d'hébergement
Découvrez qui héberge n'importe quel site : hébergeur, CDN, CMS, fournisseur e-mail, registrar et émetteur SSL
Recherche WHOIS
Consultez l'enregistrement de domaine, le registrar et les détails du propriétaire via RDAP
Vérification de Liste Noire IP
Vérifiez si une adresse IP est sur des listes noires de spam ou de malware