











링크 분석기
링크 분석이 필요한 페이지의 주소를 입력하세요. 모든 링크를 Google이 읽는 방식 그대로 보여 줍니다. 내부 링크인지 외부 링크인지, follow인지 nofollow인지, sponsored인지 ugc인지, 각 링크가 실제로 어디에 도착하는지, 어떤 링크가 깨졌는지 한 번에 링크 검사를 할 수 있습니다.
도메인만 입력해도 됩니다. example.org를 입력하면 홈페이지를 읽습니다.
- 가져오기HTML을 한 번 읽습니다
- 리다이렉트최대 10회, 각각 확인
- Robotsmeta + X-Robots-Tag
- 찾은 링크<a> 및 <area>
링크 분석 사이트는 무엇을 검사하나요?
링크 분석은 페이지 하나를 읽고 그 안의 모든 링크를 나열합니다. 각 링크가 어디로 가는지, 검색 엔진용으로 어떻게 표시되어 있는지, 앵커 텍스트가 무엇인지, 따라가 보면 실제로 어디에 도착하는지 보여 줍니다.
Googlebot이 처음 보는 방식 그대로 페이지의 HTML을 읽습니다. Google은 href가 있는 <a> 요소를 따라갑니다(Google). 상대 링크는 페이지의 <base href>를 기준으로 해석하고, 없으면 리다이렉트 후의 페이지 주소를 기준으로 합니다(HTML).
그다음 고유 URL마다 GET 요청을 한 번씩 보내고 리다이렉트를 한 단계씩 따라갑니다. HEAD 요청이 더 빠르지만 서버가 실제 방문과 다르게 응답하는 경우가 많습니다. 그래서 리다이렉트 끝에 404가 나오는 링크도 여기서는 깨진 링크로 집계합니다.
- 1어디로 가는가외부www.rfc-editor.org
- 2어떻게 표시되었는가nofollowmw:extlink유지됨, SEO 의미 없음
- 3무엇이라고 쓰였는가“1035”
- 4어디에 도착하는가↳ 301 /info/rfc1035/정상 200185 ms
- 5어디에 있는가링크 1,117개 중 187번째, “Contents” 아래
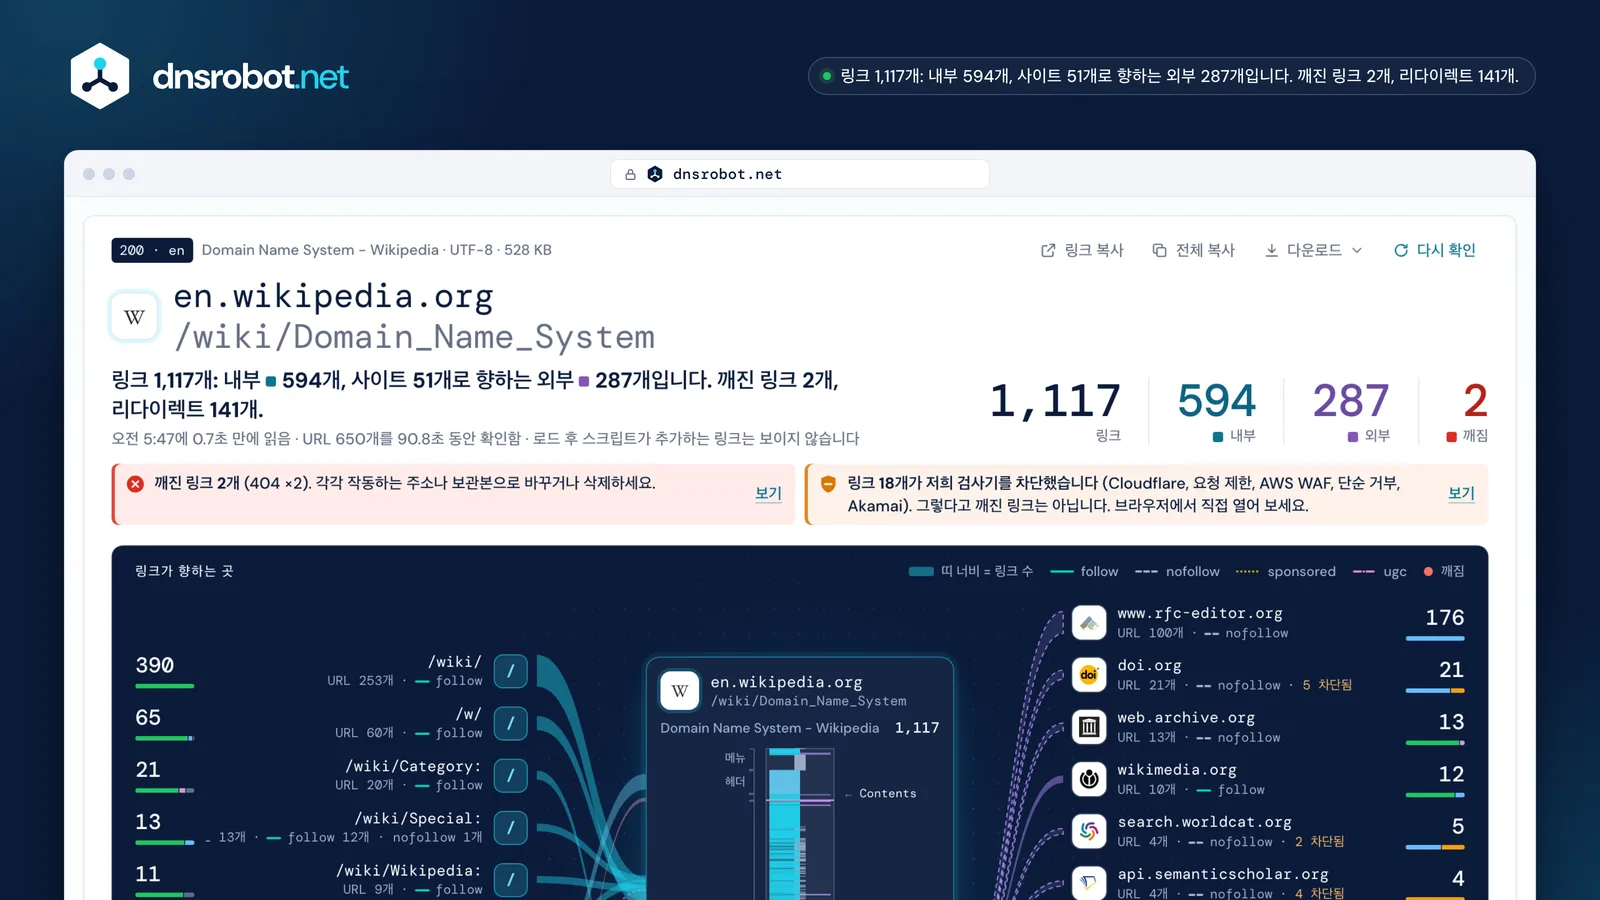
 결과부터페이지에 링크가 몇 개인지, 사이트 안에 머무는 링크와 밖으로 나가는 링크는 몇 개인지, 깨진 링크는 몇 개인지 보여 줍니다.해결 방법이 붙은 참고 사항깨진 링크, 봇 차단 때문에 확인하지 못한 링크, 수정할 만한 리다이렉트, 빈 앵커를 개수와 조치 방법과 함께 알려 줍니다.위에서 아래로 본 페이지링크마다 페이지에서 위치한 곳에 눈금 하나씩 표시합니다. 메뉴, 본문, 참고 문헌, 푸터가 구분됩니다.링크가 향하는 곳섹션과 사이트마다 띠 하나가 있고, 띠의 너비는 링크 수에 비례하며 링크가 nofollow이면 점선으로 표시됩니다.
내부 링크와 외부 링크: 무엇이 어디에 해당하나요?
내부 링크는 페이지와 같은 호스트를 가리키고, 외부 링크는 다른 웹사이트를 가리킵니다. en.wikipedia.org에서 de.wikipedia.org로 가는 링크처럼 같은 사이트의 다른 호스트로 가는 링크는 따로 집계합니다.
내부 링크는 독자와 크롤러가 사이트의 다른 페이지를 찾는 데 도움이 되며, 중요한 페이지는 최소한 다른 페이지 하나에서 링크되어야 합니다(Google). 외부 링크 자체는 위험이 아닙니다. 좋은 출처를 인용하면 독자가 페이지를 신뢰하는 데 도움이 됩니다.
Google은 모든 외부 링크가 아니라 보증하지 않는 링크에만 nofollow를 쓰라고 권장합니다. #section 링크는 같은 페이지에 머물며, Google은 프래그먼트를 별도의 페이지로 취급하지 않습니다(Google).
- 같은 호스트 514
- 같은 사이트, 다른 호스트 80
- 다른 사이트 287
- 같은 페이지 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_name내부페이지와 같은 호스트: 내부 링크입니다.
- de.wikipedia.org/wiki/Domain_Name_System같은 사이트같은 사이트(wikipedia.org)의 다른 호스트: 따로 집계합니다.
- www.wikidata.org/wiki/Q8767외부Wikimedia가 운영하지만 다른 도메인이므로 외부 링크입니다.
- www.rfc-editor.org/rfc/rfc1035외부다른 도메인: 외부 링크입니다.
nofollow, sponsored, ugc (그리고 “dofollow”가 속성이 아닌 이유)
rel="nofollow"는 검색 엔진에 링크를 내 보증으로 세지 말라고 요청하고, rel="sponsored"는 유료 링크나 광고를, rel="ugc"는 사용자가 작성한 링크를 표시합니다. 셋 중 아무것도 없는 링크는 follow로 처리되며, dofollow라는 값은 없습니다.
2019년 9월 10일부터 세 값 모두 명령이 아닌 힌트이고, 2020년 3월 1일부터는 크롤링과 색인에도 힌트로 적용됩니다(Google). ugc nofollow처럼 공백이나 쉼표로 구분해 값을 함께 쓸 수 있습니다.
가장 중요한 점은, sponsored나 nofollow 없는 유료 링크는 Google의 스팸 정책을 위반한다는 것입니다(Google). 저희가 읽은 Wikipedia 문서에서는 외부 링크 287개 중 267개가 nofollow이며, MediaWiki가 모든 인용에 이를 추가합니다.
<a href>기본적으로 follow: 추가할 것 없음rel="nofollow"보증하지 않음: 다른 값이 맞지 않을 때rel="sponsored"유료 링크 또는 광고: 유료 링크에 필요(또는 nofollow)rel="ugc"사용자가 작성함: 댓글, 포럼 게시물rel="ugc nofollow"둘 다: 허용됨, 오래된 크롤러용rel="dofollow"값이 아님: 브라우저와 Google은 무시함
- 2005Google이 nofollow 도입
- 2019-09-10sponsored와 ugc 등장, 세 값 모두 힌트가 됨
- 2020-03-01크롤링과 색인에도 힌트로 적용
페이지 자체에 nofollow가 지정되어 있다면?
그러면 각 링크의 rel과 관계없이 Google은 그 페이지의 어떤 링크도 따라가지 않습니다. nofollow가 지정된 robots meta 태그나 X-Robots-Tag 헤더는 페이지 전체에 적용되며, 이 도구는 각 링크를 “nofollow(페이지)”로 표시합니다.
Google은 본문에 있더라도 robots와 googlebot 이름을 읽으며, none은 noindex와 nofollow를 합친 값입니다(Google). 같은 규칙을 X-Robots-Tag: nofollow처럼 헤더로 보낼 수도 있습니다.
Wikipedia의 편집 기록 페이지는 의도적으로 noindex,nofollow를 지정합니다. 이 도구의 이전 버전은 이 태그를 읽지 않아서, 편집 기록 페이지의 처음 링크 200개 중 194개를 follow로 집계했습니다.
처음 링크 200개 중: meta 태그를 읽지 않았습니다
링크 전부 nofollow(페이지): Google은 어느 것도 따라가지 않습니다
543 nofollow(페이지)6 nofollowX-Robots-Tag: none
깨진 링크 찾는 방법과 수정 방법
URL이 404 Not Found나 410 Gone 같은 오류로 응답하거나, 그런 오류로 리다이렉트되거나, 이름이 존재하지 않으면 깨진 링크입니다. 페이지를 분석한 뒤 깨짐 탭을 여세요.
각 링크는 페이지의 새 주소, 보관본으로 바꾸거나 링크를 없애서 고치세요. Google은 4xx 페이지를 색인에서 제외하며(Google), 링크를 따라간 독자는 아무 곳에도 도착하지 못합니다.
모든 오류가 깨진 링크를 뜻하지는 않습니다. 401은 로그인을 요구하므로 페이지가 존재하고(RFC 9110), 5xx나 시간 초과는 시간이 지나면 해결되는 경우가 많으니 나중에 다시 확인하세요. 저희가 읽은 문서에서는 URL 656개 중 2개가 깨져 있었고 둘 다 참고 문헌에 있었습니다. 세 번째 링크는 단순한 403으로 응답했으며, 이는 차단으로 분류합니다.
- umbrella.cisco.com404
페이지가 사라짐
Cisco가 블로그 글을 내렸고, 서버가 그렇게 분명히 알려 줍니다.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeweb.archive.org의 보관본으로 연결하거나 링크를 삭제하세요.- http://www.apwg.org301
- https://…/1H2010.pdf404
404로 끝나는 리다이렉트
http://가 https://로 이동하지만 PDF가 없습니다. 리다이렉트가 아니라 깨진 링크로 집계합니다.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdf보고서가 지금 어디에 있는지 찾거나 보관본을 인용하세요.- www.akamai.com403
단순한 403: 차단이지 깨진 링크가 아님
봇 차단의 흔적 없이 서버가 저희 검사기를 거부했습니다. 파일이 사라졌거나 서버가 봇을 막는 것일 수 있습니다.
www.akamai.com/dl/technical_publications/network_overview_osr.pdf브라우저에서 열어 보고, 열리면 그대로 두세요.

링크의 리다이렉트: 고쳐야 할까요?
리다이렉트되는 링크도 작동은 하지만, 단계마다 요청과 시간이 듭니다. 링크는 최종 주소로 연결하세요. 특히 양쪽 끝을 모두 관리하는 내 사이트 안의 링크에서 중요합니다.
301이나 308은 영구 이동을 뜻하고, 302, 303, 307은 임시 이동이어서 Google은 기존 주소를 계속 표시합니다(Google). Googlebot은 최대 10단계, 브라우저는 최대 20단계까지 따라갑니다(Google).
rfc-editor.org는 이제 /rfc/ 페이지를 /info/로 보내므로, 저희가 읽은 문서의 링크 175개는 한 단계가 더 필요합니다. 끝이 404인 리다이렉트는 여기서 리다이렉트가 아니라 깨진 링크로 집계합니다.
- doi.org/10.17487/RFC1035302302: 임시, 기존 URL을 계속 사용
- www.rfc-editor.org/info/rfc1035301301: 영구 이동, 새 URL로 연결
- www.rfc-editor.org/info/rfc1035/200
링크가 rfc-editor.org/rfc/…를 가리키며, 이 주소는 이제 /info/…로 이동합니다
페이지의 URL 656개 중 리다이렉트되는 수
Googlebot이 따라가는 최대 단계 수, 브라우저는 20단계 후 중단
“여기서는 차단되지만 브라우저에서는 열려요”
많은 사이트가 페이지 앞에 봇 차단을 둡니다. JavaScript를 실행하지 않거나 스크립트처럼 보이는 방문자를 막기 때문에, 내 브라우저는 통과해도 저희 검사기는 403이나 429를 받습니다. 이런 링크는 깨짐이 아니라 차단됨으로 표시합니다.
Cloudflare는 챌린지에 cf-mitigated: challenge 헤더를 붙이며(Cloudflare), 기본적으로 특이한 user agent의 클라이언트에 챌린지를 보냅니다. 429는 요청이 너무 많다는 뜻입니다(RFC 6585).
저희는 정직한 user agent를 보내며 차단을 우회하려 하지 않습니다. 저희가 읽은 문서에서는 URL 18개가 차단되었습니다. 17개는 Cloudflare, AWS WAF, Akamai, 요청 제한 때문이었고 1개는 단순한 403이었습니다. 무엇이든 고치기 전에 직접 열어 보세요.
- Cloudflare 챌린지7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- 요청 제한(429)3search.worldcat.org · api.semanticscholar.org · 429
- Akamai 봇 차단1dyn.com → www.oracle.com · 403
페이지에는 링크를 몇 개까지 둘 수 있나요?
제한은 없습니다. Google의 안내에는 정해진 개수가 없고 이상적인 개수도 없다고 되어 있습니다. 링크를 100개 이하로 유지하라는 오래된 조언은 Google이 페이지의 일부만 읽던 시절의 이야기입니다.
중요한 것은 링크마다 독자에게 도움이 되는지, 중요한 링크가 HTML 안의 실제 <a href> 링크인지, 그리고 Googlebot이 검색용으로 읽는 HTML의 처음 2 MB 안에 있는지입니다(Google).
저희가 읽은 Wikipedia 문서에는 528 KB의 HTML에 링크 1,117개가 있습니다. example.com은 HTML에 링크가 전혀 없습니다. 유일한 링크는 페이지가 로드된 뒤 스크립트가 추가합니다.
- wikipedia.org/wiki/Domain_Name_System1,117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0유일한 링크는 스크립트가 추가함
앵커 텍스트와 이미지 링크
앵커 텍스트는 링크의 클릭 가능한 글자로, 독자와 Google에 대상 페이지가 무엇에 관한 것인지 알려 줍니다. 이미지 링크에서는 Google이 이미지의 alt 텍스트를 앵커로 읽으므로, alt가 비어 있는 이미지 링크는 아무 정보도 주지 못합니다.
좋은 앵커는 짧고 구체적이며 대상을 설명합니다. “여기를 클릭”이나 “더 보기”는 아무것도 알려 주지 않습니다(Google). 링크에 텍스트가 없으면 Google은 title 속성을 대신 사용합니다.
이 도구는 모든 이미지 링크의 alt 텍스트를 보여 주고, 비어 있는 것을 표시하며, 반복되는 앵커를 나열합니다. 저희가 읽은 문서에서는 “edit”이 링크 49개의 앵커입니다. 섹션 편집 링크로, Wikipedia에서는 문제없지만 다른 곳에서는 좋지 않습니다.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>앵커DNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>앵커이미지Wikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>앵커비어 있음없음: 빈 링크
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank와 noopener: 아직도 필요한가요?
최신 브라우저에서는 필요하지 않습니다. target="_blank" 링크는 새 탭을 열며, 이제 모든 주요 브라우저가 이를 rel="noopener"로 처리해서 새 페이지가 내 페이지에 접근해 바꿀 수 없습니다. noopener가 없는 경우는 위험이 아니라 참고 사항으로 표시합니다.
HTML 표준은 2019년에 _blank가 noopener를 의미하도록 정했고(HTML), Safari 12.1, Firefox 79, Chrome 88이 이를 적용했습니다. noreferrer는 방문자가 어디서 왔는지도 숨깁니다. 이는 보안 수정이 아니라 개인정보와 분석에 관한 선택입니다.
<a target="_blank">rel 전혀 없음window.opener→ null- 2019-02HTML: _blank는 noopener를 의미함whatwg/html #4330
- 2019Safari 12.1암묵적 noopener
- 2020Firefox 79암묵적 noopener
- 2021Chrome 88암묵적 noopener
- dnsrobot.net/blog/hosting-com-coupon23개 중 23개에 noopener 또는 noreferrer 있음
- github.com10개 중 10개에 noopener 또는 noreferrer 있음
- developer.mozilla.org/en-US/10개 중 10개에 noopener 또는 noreferrer 있음
링크에 관한 오해, Google 공식 문서로 확인
링크에 관한 조언 대부분은 몇 가지 오래된 규칙을 되풀이합니다. 각 항목에 대해 Google 문서가 지금 말하는 내용은 다음과 같습니다.
| 오해 | Google의 설명 | 출처 |
|---|---|---|
| 사실 아님“dofollow”는 직접 추가하는 속성이다 | 링크는 기본적으로 follow이며, nofollow, sponsored, ugc만 의미가 있습니다. | developers.google.com |
| 사실 아님외부 링크에 nofollow를 쓰면 사이트가 불이익을 받는다 | Google은 유료 링크와 보증하지 않는 링크에만 nofollow 또는 sponsored를 요청합니다. | developers.google.com |
| 오래된 정보페이지의 링크는 100개 이하로 유지해야 한다 | 페이지당 링크 수에는 제한도, 이상적인 개수도 없습니다. | developers.google.com |
| 사실 아님nofollow를 쓰면 페이지가 색인되지 않는다 | 페이지를 Google에서 제외하려면 크롤링을 허용하고 noindex를 사용하세요. | developers.google.com |
| 오래된 정보nofollow 링크는 아무것도 전달하지 않는다 | 2019년부터 힌트입니다. Google이 활용할 수 있지만, 일반적으로 순위에는 여전히 반영하지 않습니다. | developers.google.com |
| 오래된 정보noopener 없는 target=_blank는 보안 구멍이다 | 최신 브라우저는 _blank 링크에 noopener를 암묵적으로 적용하며, rel=opener로 요청한 경우만 예외입니다. | html.spec.whatwg.org |
출처
- Google Search Central: 크롤링 가능한 링크, 외부 링크 한정, robots meta 태그, HTTP 상태 코드
- HTML Living Standard(링크, rel 값, base URL)와 RFC 9110(상태 코드)
- Cloudflare: 챌린지 감지
- 수치: en.wikipedia.org/wiki/Domain_Name_System을 대상으로 한 저희 자체 실행 결과, 2026년 10월 23일
링크 분석기 자주 묻는 질문
이 링크는 클릭해도 안전한가요?
링크 검색 사이트처럼 웹페이지의 모든 링크를 찾으려면 어떻게 하나요?
링크 분석에서 내부 링크와 외부 링크는 어떻게 다른가요?
nofollow는 무슨 뜻이고, dofollow는 실제 속성인가요?
rel="sponsored"나 rel="ugc"는 언제 써야 하나요?
링크 검사에서 깨진 링크가 아니라 “차단됨”으로 표시되는 이유는 무엇인가요?
링크가 리다이렉트되는 이유는 무엇이고, 고쳐야 하나요?
JavaScript로 추가된 링크도 찾나요?
페이지가 자동 읽기를 막습니다. 그래도 분석할 수 있나요?
링크를 몇 개까지 확인하나요?
페이지에는 링크가 몇 개 있어야 하나요?
링크 분석기는 무료인가요? 페이지를 저장하나요?
부족한 점이 있습니까?기능 또는 새 도구 제안하기