











Analiza linków
Analiza linków pokazuje każdy link na stronie tak, jak czyta go Google: wewnętrzny czy zewnętrzny, z follow czy nofollow, sponsored czy ugc, dokąd naprawdę prowadzi i które linki nie działają.
Domena też wystarczy: example.org czyta swoją stronę główną.
- PobranieCzyta HTML raz
- PrzekierowaniaDo 10, każde sprawdzone
- Robotsmeta + X-Robots-Tag
- Znalezione linki<a> i <area>
Co sprawdza analiza linków?
Analiza linków czyta jedną stronę i wypisuje każdy link na niej: dokąd prowadzi, jak jest oznaczony dla wyszukiwarek, co mówi jego tekst kotwicy i gdzie naprawdę ląduje, gdy za nim pójdziesz.
Czyta HTML strony tak, jak widzi go najpierw Googlebot. Google śledzi elementy <a>, które mają href (Google); linki względne są rozwiązywane względem <base href> strony, a w razie jego braku jej adresu po przekierowaniach (HTML).
Potem każdy unikalny URL jest pobierany raz, żądaniem GET, z przekierowaniami śledzonymi po jednym przeskoku. Żądanie HEAD jest szybsze, ale serwery często odpowiadają na nie inaczej niż na prawdziwą wizytę, więc link, który za przekierowaniem kończy się na 404, nadal liczy się tu jako niedziałający.
- 1Dokąd prowadzizewnętrznywww.rfc-editor.org
- 2Jak jest oznaczonynofollowmw:extlinkzachowane, bez znaczenia dla SEO
- 3Co mówi“1035”
- 4Gdzie ląduje↳ 301 /info/rfc1035/OK 200185 ms
- 5Gdzie leżylink 187 z 1117, pod „Contents”
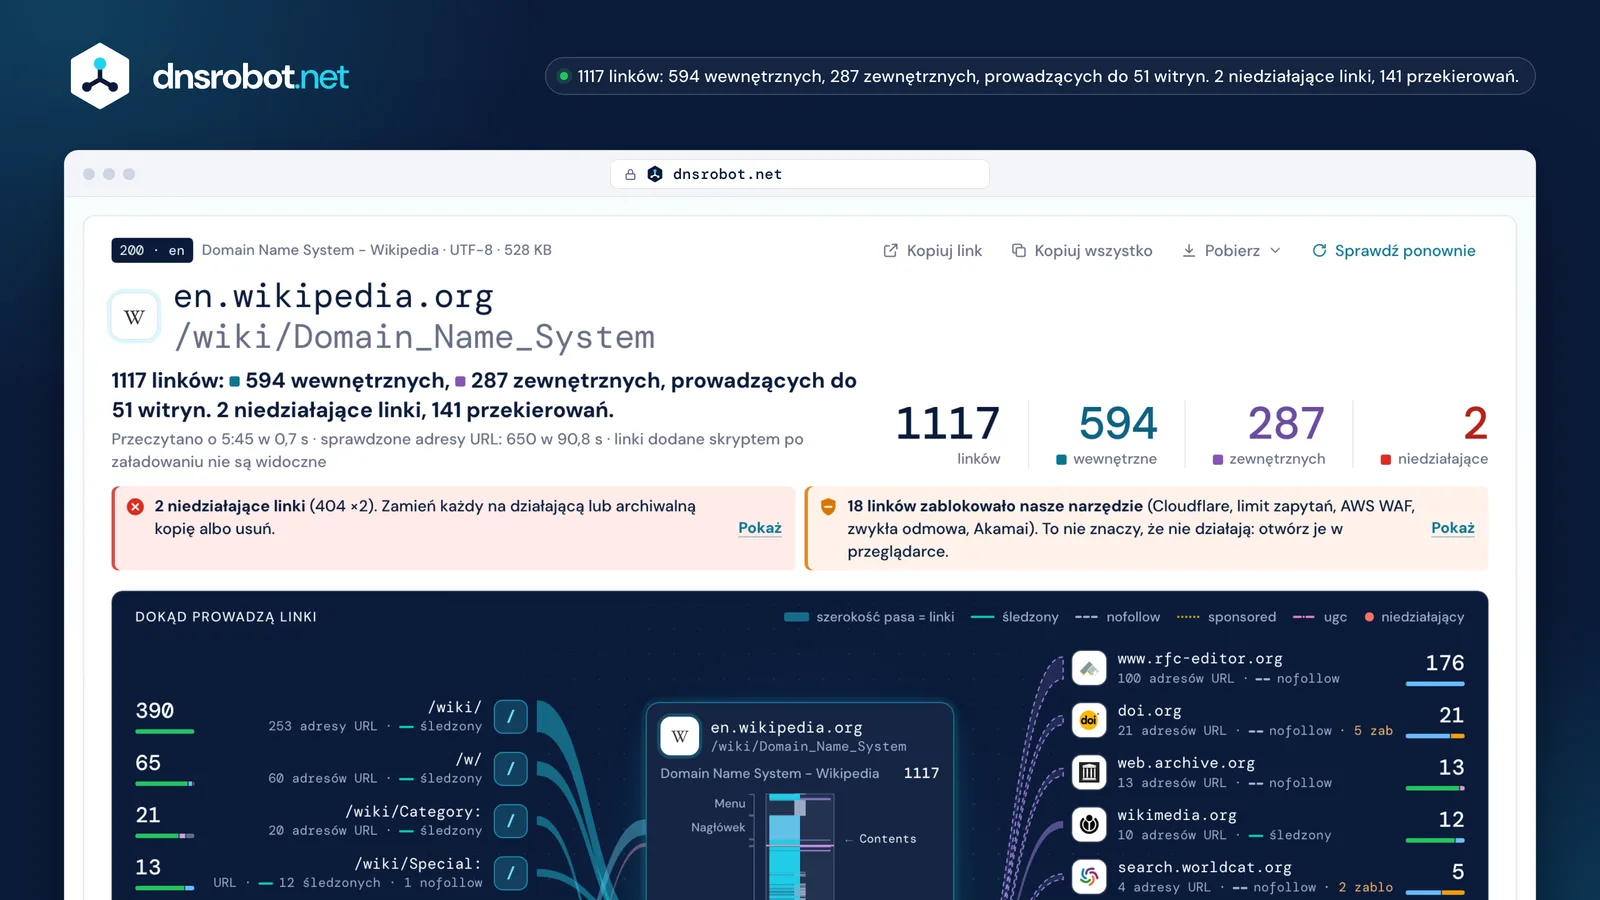
 Najpierw odpowiedźIle linków ma strona, ile zostaje w witrynie, ile z niej wychodzi i ile nie działa.Uwagi z rozwiązaniemNiedziałające linki, linki zatrzymane tylko przez ochronę przed botami, przekierowania warte poprawy, puste kotwice: każda uwaga z liczbą i podpowiedzią, co zrobić.Strona od góry do dołuJedna kreska na link, w miejscu, w którym leży na stronie: menu, artykuł, przypisy, stopka.Dokąd prowadzą linkiJeden pas na sekcję i na witrynę, tak szeroki, ile ma linków, przerywany, gdy linki mają nofollow.
Linki wewnętrzne i zewnętrzne: co jest czym?
Link wewnętrzny prowadzi na ten sam host co strona; link zewnętrzny prowadzi do innej witryny. Linki do innego hosta tej samej witryny, na przykład de.wikipedia.org z en.wikipedia.org, są liczone osobno.
Linki wewnętrzne pomagają czytelnikom i robotom znaleźć inne strony witryny; każda ważna strona powinna mieć link z co najmniej jednej innej (Google). Linki zewnętrzne same w sobie nie są ryzykiem: cytowanie dobrych źródeł pomaga czytelnikom zaufać stronie.
Google proponuje nofollow tylko dla linków, za które nie ręczysz, a nie dla każdego linku zewnętrznego. Link do #section zostaje na tej samej stronie, a Google nie traktuje fragmentów jak osobnych stron (Google).
- ten sam host 514
- ta sama witryna, inny host 80
- inna witryna 287
- ta sama strona 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_namewewnętrznyTen sam host co strona: wewnętrzny.
- de.wikipedia.org/wiki/Domain_Name_Systemta sama witrynaTa sama witryna (wikipedia.org), inny host: liczony osobno.
- www.wikidata.org/wiki/Q8767zewnętrznyInna domena, chociaż prowadzi ją Wikimedia: zewnętrzny.
- www.rfc-editor.org/rfc/rfc1035zewnętrznyInna domena: zewnętrzny.
Atrybuty linków: nofollow, sponsored i ugc (i dlaczego „dofollow” nie jest atrybutem)
rel="nofollow" prosi wyszukiwarki, by nie liczyły linku jako twojej rekomendacji, rel="sponsored" oznacza link płatny lub reklamę, a rel="ugc" oznacza link napisany przez twoich użytkowników. Link bez żadnego z nich jest śledzony: wartości dofollow nie ma.
Od 10 września 2019 wszystkie trzy są wskazówkami, a nie poleceniami, a od 1 marca 2020 także przy crawlowaniu i indeksowaniu (Google). Wartości można łączyć, na przykład ugc nofollow, oddzielając je spacjami lub przecinkami.
Najważniejsze: płatny link bez sponsored lub nofollow łamie zasady Google dotyczące spamu (Google). W artykule z Wikipedii, który przeczytaliśmy, 267 z 287 linków zewnętrznych ma nofollow, które MediaWiki dodaje do każdego przypisu.
<a href>Śledzony domyślnie: nic nie trzeba dodawaćrel="nofollow"Nie ręczę za niego: gdy nie pasuje żadna inna wartośćrel="sponsored"Płatny lub reklama: wymagany przy linkach płatnych (albo nofollow)rel="ugc"Napisany przez użytkowników: komentarze, posty na forumrel="ugc nofollow"Oba: dozwolone, dla starszych robotówrel="dofollow"To nie wartość: przeglądarki i Google ją ignorują
- 2005Google wprowadza nofollow
- 2019-09-10pojawiają się sponsored i ugc; wszystkie trzy stają się wskazówkami
- 2020-03-01wskazówki także przy crawlowaniu i indeksowaniu
A jeśli sama strona ma nofollow?
Wtedy Google nie śledzi żadnego z jej linków, niezależnie od rel każdego z nich. Znacznik meta robots lub nagłówek X-Robots-Tag z nofollow dotyczy całej strony; to narzędzie oznacza każdy link jako „nofollow (strona)”.
Google czyta nazwy robots i googlebot w każdym wariancie wielkości liter, nawet w body, a none oznacza noindex plus nofollow (Google). Te same reguły mogą przyjść jako nagłówek, na przykład X-Robots-Tag: nofollow.
Strony historii wersji w Wikipedii celowo mają noindex,nofollow. Poprzednia wersja tego narzędzia nigdy nie czytała tego znacznika i zaliczała 194 z pierwszych 200 linków strony historii jako śledzone.
z pierwszych 200 linków: znacznik meta nigdy nie został przeczytany
linków, wszystkie nofollow (strona): Google nie śledzi żadnego z nich
543 nofollow (strona)6 nofollowX-Robots-Tag: none
Niedziałające linki: jak je znaleźć i naprawić
Link nie działa, gdy jego URL odpowiada błędem, takim jak 404 Not Found lub 410 Gone, albo przekierowuje na taki błąd, albo gdy jego nazwa nie istnieje. Przeanalizuj stronę, a potem otwórz zakładkę Niedziałające.
Każdy napraw, linkując nowy adres strony, jej archiwalną kopię albo nic. Google usuwa strony 4xx ze swojego indeksu (Google), a czytelnik, który kliknie taki link, trafia donikąd.
Nie każdy błąd oznacza, że link nie działa: 401 prosi o logowanie, więc strona istnieje (RFC 9110), a 5xx lub przekroczony czas często mijają, więc sprawdź je później. W artykule, który przeczytaliśmy, 2 z 656 adresów URL nie działały, oba w przypisach; trzeci odpowiedział zwykłym 403, który pokazujemy jako zablokowany.
- umbrella.cisco.com404
Strony już nie ma
Cisco wycofało wpis na blogu; serwer mówi to wprost.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timePodlinkuj kopię w web.archive.org albo usuń link.- http://www.apwg.org301
- https://…/1H2010.pdf404
Przekierowanie, które kończy się na 404
http:// przechodzi na https://, a pliku PDF tam nie ma. Liczone jako niedziałający, nie jako przekierowanie.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfZnajdź, gdzie raport leży teraz, albo zacytuj archiwum.- www.akamai.com403
Zwykłe 403: zablokowany, nie niedziałający
Serwer odrzucił nasze narzędzie bez śladu ochrony przed botami. Plik mógł zniknąć albo serwer odrzuca boty.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfOtwórz go w przeglądarce; jeśli się otwiera, zostaw go.

Przekierowania w linkach: czy warto je poprawiać?
Link, który przekierowuje, nadal działa, ale każdy przeskok kosztuje żądanie i czas. Kieruj linki na adres docelowy, zwłaszcza te wewnątrz własnej witryny, gdzie kontrolujesz oba końce.
301 lub 308 mówi, że przeniesienie jest na stałe; 302, 303 lub 307 jest tymczasowe, a Google nadal pokazuje stary adres (Google). Googlebot śledzi do 10 przeskoków, przeglądarki do 20 (Google).
rfc-editor.org przekierowuje teraz swoje strony /rfc/ na /info/, więc 175 linków w przeczytanym artykule wymaga dodatkowego przeskoku. Przekierowanie, które kończy się na 404, jest tu liczone jako niedziałający link, a nie jako przekierowanie.
- doi.org/10.17487/RFC1035302302: tymczasowe, stary URL nadal jest tym właściwym
- www.rfc-editor.org/info/rfc1035301301: przeniesione na stałe, linkuj nowy URL
- www.rfc-editor.org/info/rfc1035/200
linków wskazuje rfc-editor.org/rfc/…, które teraz przekierowuje na /info/…
z 656 adresów URL strony przekierowuje
przeskoków śledzi Googlebot najwyżej; przeglądarki poddają się po 20
„Zablokowany tutaj, ale w mojej przeglądarce działa”
Wiele witryn ustawia przed swoimi stronami ochronę przed botami. Zatrzymuje ona odwiedzających, którzy nie uruchamiają JavaScriptu albo wyglądają na skrypt, więc nasze narzędzie dostaje 403 lub 429, a twoja przeglądarka przechodzi. Takie linki są pokazane jako zablokowane, a nie niedziałające.
Cloudflare oznacza swoje wyzwania nagłówkiem cf-mitigated: challenge (Cloudflare) i domyślnie wystawia wyzwania klientom z nietypowym user agentem; 429 oznacza zbyt wiele żądań (RFC 6585).
Wysyłamy uczciwy user agent i nigdy nie próbujemy obchodzić blokad. W przeczytanym artykule zablokowanych było 18 adresów URL: 17 przez Cloudflare, AWS WAF, Akamai i limity zapytań, jeden przez zwykłe 403. Otwórz je sam, zanim cokolwiek zmienisz.
- Wyzwanie Cloudflare7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Limit zapytań (429)3search.worldcat.org · api.semanticscholar.org · 429
- Ochrona przed botami Akamai1dyn.com → www.oracle.com · 403
Ile linków może mieć strona?
Nie ma limitu. Wytyczne Google nie podają żadnej liczby i mówią, że nie ma idealnej ilości; stara rada, by nie przekraczać 100 linków, pochodzi z czasów, gdy Google czytał tylko część strony.
Liczy się to, żeby każdy link pomagał czytelnikowi, żeby te ważne były prawdziwymi linkami <a href> w HTML i żeby leżały w pierwszych 2 MB kodu HTML, czyli tyle, ile Googlebot czyta dla wyszukiwarki (Google).
Artykuł z Wikipedii, który przeczytaliśmy, ma 1117 linków w 528 KB kodu HTML. example.com nie ma ich w HTML wcale: jego jedyny link dodaje skrypt po załadowaniu strony.
- wikipedia.org/wiki/Domain_Name_System1117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0jego jedyny link dodaje skrypt
Tekst kotwicy i linki obrazkowe
Tekst kotwicy to klikalny tekst linku; mówi czytelnikom i Google, czego dotyczy cel. W linku obrazkowym Google czyta jako kotwicę tekst alt obrazka, więc link obrazkowy z pustym alt nic nie mówi.
Dobre kotwice są krótkie, konkretne i opisują cel; „kliknij tutaj” i „czytaj więcej” nikomu nic nie mówią (Google). Gdy link nie ma tekstu, Google sięga po atrybut title.
To narzędzie pokazuje tekst alt każdego linku obrazkowego, oznacza puste i wypisuje powtarzające się kotwice. W przeczytanym artykule „edit” jest kotwicą 49 linków: to linki edycji sekcji, na Wikipedii w porządku, gdzie indziej słabe.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>kotwicaDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>kotwicaObrazWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>kotwicaPustanic: pusty link
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank i noopener: nadal potrzebne?
Nie w obecnych przeglądarkach. Link z target="_blank" otwiera nową kartę, a każda duża przeglądarka traktuje go teraz jak rel="noopener": nowa strona nie sięgnie wstecz, by zmienić twoją. Brak noopener jest pokazany jako uwaga, a nie ryzyko.
Standard HTML sprawił w 2019 roku, że _blank oznacza noopener (HTML); wprowadziły to Safari 12.1, Firefox 79 i Chrome 88. noreferrer ukrywa też, skąd przyszedł odwiedzający: to wybór dotyczący prywatności i analityki, a nie poprawka bezpieczeństwa.
<a target="_blank">w ogóle bez relwindow.opener→ null- 2019-02HTML: _blank oznacza noopenerwhatwg/html #4330
- 2019Safari 12.1domyślne noopener
- 2020Firefox 79domyślne noopener
- 2021Chrome 88domyślne noopener
- dnsrobot.net/blog/hosting-com-coupon23 z 23 mają noopener lub noreferrer
- github.com10 z 10 ma noopener lub noreferrer
- developer.mozilla.org/en-US/10 z 10 ma noopener lub noreferrer
Mity o linkach, sprawdzone na stronach samego Google
Większość porad o linkach powtarza kilka starych reguł. Oto, co dziś mówi o każdej z nich dokumentacja Google.
| Mit | Co mówi Google | Źródło |
|---|---|---|
| Fałsz„dofollow” to atrybut, który się dodaje | Linki są domyślnie śledzone; coś znaczą tylko nofollow, sponsored i ugc. | developers.google.com |
| FałszNofollow na linkach zewnętrznych skutkuje karą dla witryny | Google prosi o nofollow lub sponsored tylko przy linkach płatnych i takich, za które nie ręczysz. | developers.google.com |
| NieaktualneStrona powinna mieć mniej niż 100 linków | Nie ma limitu ani idealnej liczby linków na stronie. | developers.google.com |
| FałszNofollow trzyma stronę poza indeksem | Aby trzymać stronę poza Google, zezwól na crawlowanie i użyj noindex. | developers.google.com |
| NieaktualneLinki nofollow nie przekazują niczego | Od 2019 roku to wskazówki: Google może ich użyć, choć zwykle nadal nie liczy ich do rankingu. | developers.google.com |
| Nieaktualnetarget=_blank bez noopener to dziura w zabezpieczeniach | Obecne przeglądarki domyślnie stosują noopener dla linków _blank, chyba że rel=opener prosi o opener. | html.spec.whatwg.org |
Źródła
- Google Search Central: linki możliwe do crawlowania, oznaczanie linków wychodzących, znacznik meta robots, kody statusu HTTP
- HTML Living Standard (linki, wartości rel, bazowy URL) i RFC 9110 (kody statusu)
- Cloudflare: wykrywanie wyzwania
- Liczby: nasz własny przebieg na en.wikipedia.org/wiki/Domain_Name_System, 23 października 2026
Analiza linków: najczęstsze pytania
Czy ten link jest bezpieczny do kliknięcia?
Jak znaleźć wszystkie linki na stronie?
Czym różnią się linki wewnętrzne i zewnętrzne?
Co oznacza nofollow i czy atrybut dofollow istnieje?
Które atrybuty linków wybrać: kiedy użyć sponsored lub ugc?
Dlaczego link jest oznaczony jako „Zablokowany”, a nie niedziałający?
Dlaczego link przekierowuje i czy trzeba to poprawiać?
Czy znajduje linki dodane przez JavaScript?
Strona blokuje automatyczne czytniki. Czy mogę ją mimo to przeanalizować?
Ile linków sprawdza?
Ile linków powinna mieć strona?
Czy analiza linków jest darmowa i czy zapisujecie strony?
Czegoś brakuje?Zaproponuj funkcję lub nowe narzędzie
Więcej narzędzi dla stron i SEO
Wyszukiwarka Subdomen
Odkryj wszystkie subdomeny dowolnej domeny
Czy strona działa?
Awaria dla wszystkich czy tylko u Ciebie? Sprawdź dowolną stronę z 11 miejsc i ze swojego łącza, ze zrzutem ekranu na żywo
Sprawdzanie Certyfikatu SSL
Weryfikuj ważność certyfikatu SSL i szczegóły bezpieczeństwa
Sprawdzanie hostingu
Sprawdź, kto hostuje dowolną stronę: hosting, CDN, CMS, dostawca poczty, rejestrator i wystawca SSL
Wyszukiwanie WHOIS
Wyszukaj rejestrację domeny, rejestratora i dane właściciela przez RDAP
Sprawdzanie Czarnej Listy IP
Sprawdź, czy adres IP jest na czarnych listach spamu lub złośliwego oprogramowania