











Sprawdzanie meta tagów
Narzędzie do sprawdzania meta tagów, które mierzy zamiast liczyć: tytuł i meta description strony w pikselach, tam, gdzie wyniki Google je ucinają, a potem, czy strona może być zaindeksowana i jak wygląda jej link po udostępnieniu.
Czytamy stronę z naszego serwera tak, jak Google czyta jej sekcję head, i mierzymy tytuł oraz opis w pikselach.
Jak długa powinna być meta description?
Tak długa, jak trzeba, by opisać stronę: Google nie ustala maksimum i ucina snippet do szerokości ekranu, a nie po liczbie znaków. Według pomiarów innych firm to miejsce ma około 920 pikseli na komputerze i 680 na telefonie; typowe polskie zdanie wypełnia je, jak wynika z naszych pomiarów, przy około 145 i 105 znakach.
Słowami Google: „Metaopis nie ma limitu długości, ale krótkie opisy w wynikach wyszukiwania zwykle są przycinane do szerokości ekranu” (Google). Jednostką jest szerokość, więc decydują litery. Zmierzone w Arial przy 14 px iiiiii ma 19 px szerokości, a WWWWWW 79 px; znaki japońskie są pełnej szerokości, więc to samo miejsce mieści ich mniej więcej o połowę mniej, a koreańskich, pisanych ze spacjami, mniej więcej o jedną trzecią mniej.
Dlatego znane „155 do 160 znaków” to reguła kciuka, a nie limit, i dlatego narzędzie do sprawdzania meta description, które liczy znaki, może się mylić w obie strony. Opis ze 122 znakami pisany normalnie mieści się w wyniku na komputerze z zapasem; te same słowa wielkimi literami wychodzą 159 px poza krawędź. Rady w rodzaju „50–60 znaków, czyli 580 pikseli” traktują obie jednostki jak wymienne, a takie nie są.
Długość nic nie kosztuje w rankingu: Google powiedział w 2009 roku, że nie używa opisu do rankingu, a jego dokumentacja nie wymienia żadnej kary za długi ani za brakujący opis. Google i tak często sam pisze snippet ze strony; dwa badania innych firm zaobserwowały, że zastępuje opis mniej więcej w dwóch wynikach na trzy. Pisz dla czytelnika: opis unikalny dla strony, prawdziwe podsumowanie, nigdy lista słów kluczowych, ważne słowa na początku.
Jedyne miejsce, w którym Google naprawdę liczy znaki, to reguła robots max-snippet: jej liczba to liczba znaków, przy czym 0 oznacza brak snippetu, a -1 zostawia wybór Google (Google).
Darmowy zwrot butów trekkingowych. Wodoodporna skóra, przyczepna podeszwa i dwa lata gwarancji. Zamów dziś, dostawa jutro.
DARMOWY ZWROT BUTÓW TREKKINGOWYCH. WODOODPORNA SKÓRA, PRZYCZEPNA PODESZWA I DWA LATA GWARANCJI. ZAMÓW DZIŚ, DOSTAWA JUTRO.
Miejsce zaobserwowane przez inne firmy; Google go nie publikuje.
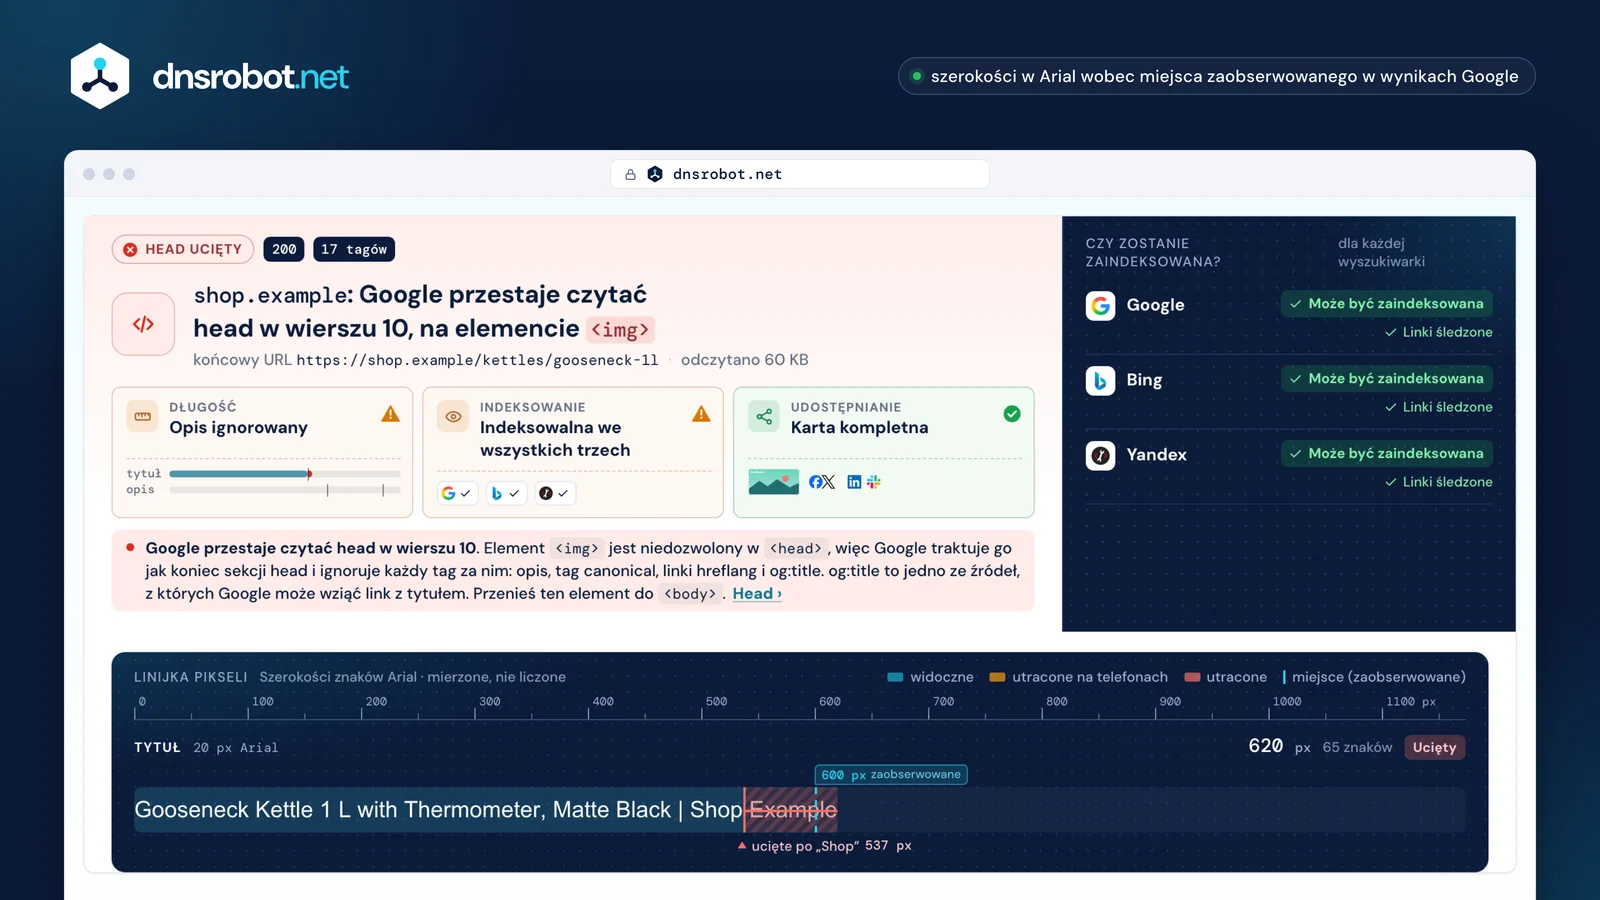
 Zmierzone, nie policzoneTytuł i opis w rozmiarze, w jakim rysuje je strona wyników, z linijką, która pokazuje, gdzie każde z nich jest ucinane na komputerze i na telefonie.Indeksowanie w każdej wyszukiwarceTagi meta robots i nagłówek X-Robots-Tag, odczytane tak, jak czyta je każda z wyszukiwarek: Google, Bing i Yandex.Czego Google nigdy nie czytaElement, który za wcześnie kończy sekcję head, jego wiersz i każdy tag, który ukrywa.Jak wygląda po udostępnieniuKarty, które Facebook i X budują z tagów, z prawdziwym rozmiarem obrazu odczytanym z pliku.
Jak długi powinien być tag title?
Na tyle długi, by nazwać stronę, i na tyle krótki, by zmieścić się w około 600 pikselach, czyli w miejscu, jakie inne firmy mierzą dla linku z tytułem na komputerze: mniej więcej 50 do 60 znaków typowego tekstu. Google sam nie ustala limitu i skraca link z tytułem „do szerokości urządzenia”.
Przewodnik po linkach z tytułem Google mówi, że „nie ma limitu długości elementu <title>”, ale prosi, by nie umieszczać w nim „niepotrzebnie długich ani zbyt szczegółowych tekstów”. Badanie 80 959 tytułów w 2370 witrynach wykazało, że Google przepisywał tytuły dłuższe niż 70 znaków niemal za każdym razem, a te o długości 51–55 znaków w około 40% przypadków.
Element <title> to dane wejściowe, a nie wynik. Google automatycznie buduje link z tytułem z elementu title, głównego widocznego tytułu strony, nagłówków takich jak <h1>, og:title, innego wyraźnego tekstu, tekstu kotwic, tekstu linków prowadzących do strony i danych strukturalnych WebSite. Zastępuje tytuł, którego brakuje, który jest szablonowy, przeładowany słowami kluczowymi albo napisany w innym języku lub piśmie niż strona.
Daj więc każdej stronie własny, opisowy tytuł, nazwę witryny umieść raz na początku albo na końcu, po separatorze takim jak pionowa kreska, i unikaj ogólnikowych tytułów w rodzaju „Strona główna”. Narzędzie powyżej czyta też pierwszy <h1> strony, bo Google może wziąć link z tytułem z jednego lub drugiego.
- 1Element title
- 2Główny tytuł widoczny na stronie
- 3Nagłówki takie jak h1
- 4Tag og:title
- 5Inny duży, wyraźny tekst
- 6Inny tekst na stronie
- 7Tekst kotwic na stronie
- 8Tekst linków prowadzących do strony
- 9Dane strukturalne WebSite
Sprawdzanie noindex: jak sprawdzić, czy strona ma noindex?
Zajrzyj w dwa miejsca: do tagu meta robots w HTML i do nagłówka HTTP X-Robots-Tag. Nagłówka nigdy nie widać w kodzie źródłowym strony, więc narzędzie do sprawdzania noindex, które czyta tylko HTML, może uznać stronę za indeksowalną, choć nią nie jest; to narzędzie czyta oba miejsca, dla Google, Bing i Yandex.
Tag noindex i nagłówek niosą te same reguły, a Google je sumuje: przy noindex w nagłówku i all w tagu strona ma noindex, bo „w przypadku sprzecznych reguł dla robotów obowiązuje ta bardziej restrykcyjna” (Google). none oznacza noindex, nofollow; strona Google o noindex nazywa nofollow wskazówką. Bez żadnego tagu domyślnie obowiązuje index, follow. Narzędzie Sprawdzanie Nagłówków HTTP pokazuje każdy nagłówek, który wysyła strona.
Yandex rozstrzyga konflikt odwrotnie: „Dyrektywy zezwalające mają pierwszeństwo, gdy są połączone z zakazującymi”, więc all obok noindex, follow zostaje tam zaindeksowane (Yandex). Dlatego werdykt powyżej podajemy osobno dla każdej wyszukiwarki, a nie raz dla wszystkich.
Pułapką jest robots.txt. Zablokowany tam URL nigdy nie jest pobierany, więc jego noindex nigdy nie zostaje odczytany, a mimo to może pojawić się w wynikach, gdy linkują do niego inne strony (Google). Aby wykluczyć stronę, pozwól ją skanować i daj jej noindex; noindex wpisany w robots.txt w ogóle nie jest obsługiwany. A nowy noindex działa dopiero wtedy, gdy Google ponownie przeskanuje stronę, co może potrwać miesiące.
X-Robots-Tag: noindex| Wyszukiwarka | Jak rozstrzyga konflikt | Ta strona |
|---|---|---|
| Wygrywa najbardziej restrykcyjna reguła | Poza wynikami | |
| Bing | Wygrywa najbardziej restrykcyjna regułaBrak opublikowanej reguły; odczytane jak w Google | Poza wynikami |
| Yandex | Wygrywa reguła zezwalająca | Może być zaindeksowana |

Zablokowana w robots.txt: strona nigdy nie jest pobierana, więc jej noindex nigdy nie zostaje odczytany.
Dlaczego Google ignoruje niektóre moje meta tagi?
Często dlatego, że nad nimi stoi element, który nie należy do <head>, na przykład <img> albo <iframe>. Google traktuje go jak koniec sekcji head i ignoruje każdy element za nim (Google).
W sekcji head poprawnych jest tylko osiem elementów: title, meta, link, script, style, base, noscript i template. Piksel śledzący wklejony z fragmentem kodu tagu, zabłąkany <div> albo osadzony <iframe> kończy ją za wcześnie, a canonical, linki hreflang i opis poniżej przepadają bez żadnego komunikatu o błędzie. Analiza meta tagów, która tylko zbiera każdy tag z pliku, i tak zgłosi je wszystkie jako obecne.
Nie wszystko przepada. Google respektuje tagi meta robots także w body, więc noindex za cięciem nadal działa. Canonical nie: Google przyjmuje go tylko w sekcji head (Google). Narzędzie powyżej podaje element i jego wiersz oraz wymienia tagi, których Google już nie czyta.
Tagi, które JavaScript dodaje lub zmienia, to drugi martwy punkt. Google zaleca, by w miarę możliwości tego unikać i ustawiać canonical w źródłowym kodzie HTML (Google), dlatego to narzędzie czyta HTML, który wysyła serwer.
<meta charset="utf-8"><title>Wodoodporne buty trekkingowe damskie i męski…</title><link rel="stylesheet" href="/theme.css"><img src="https://px.example/p.gif" alt="">Tu Google się zatrzymuje<meta name="description" content="Darmowy zwrot butów tr…">Ignorowane przez Google<link rel="canonical" href="https://store.example/boots">Ignorowane przez Google<link rel="alternate" hreflang="de" href="https://store.example/de/stiefel">Ignorowane przez Google<meta name="robots" content="max-snippet:160">Nadal działa: tagi robots liczą się też w bodyDo czego służy tag canonical?
Mówi wyszukiwarkom, który z kilku adresów URL z tą samą treścią chcesz pokazywać, i jest wskazówką, a nie regułą: „Google może wybrać jako kanoniczną inną stronę” (Google).
Google waży go razem z innymi sygnałami: przekierowanie to sygnał najsilniejszy, rel=canonical silny, sitemap słaby, i żaden z nich nie jest wymagany (Google). Umieść canonical wskazujący samą stronę na stronie, którą chcesz pokazywać, zapisz go jako bezwzględny URL, trzymaj go w <head> i nie dodawaj do niego hreflang, lang, media ani type, bo inaczej Google zignoruje go przy wyborze adresu kanonicznego. Narzędzie Sprawdzanie Przekierowań śledzi każdy krok przekierowania.
Dwa konflikty, których warto unikać. Canonical na stronie z noindex wysyła sygnały, które sobie przeczą, a Google w ogóle odradza używanie noindex do wyboru adresu kanonicznego. A canonical wskazujący inną witrynę, którego nikt tutaj nie ustawił, wymaga uważnego przyjrzenia się: Google wymienia wstrzyknięty canonical między domenami jako oznakę zhakowanej witryny.
Wersje językowe łączy się zamiast tego przez hreflang: każda wersja wymienia samą siebie i wszystkie pozostałe pełnymi adresami URL, a dwie strony, które nie wskazują siebie nawzajem, są ignorowane. Kody to język według ISO 639-1 z opcjonalnym regionem według ISO 3166-1: en-GB, nigdy en-UK, a es-419 nie jest obsługiwany (Google). Canonical każdej wersji językowej kieruj na URL w tym samym języku.
Ta sama treść, kilka adresów URL
http://store.example/bootshttps://store.example/boots?utm_source=mailhttps://www.store.example/bootshttps://store.example/boots/https://store.example/bootsWskazówka: Google może wybrać innySygnały, od najsilniejszego
rel=canonicalSitemapPara hreflang
/en/boots/de/stiefelOba linkują z powrotem: używane
/en/boots/fr/bottesTylko w jedną stronę: ignorowane
Których meta tagów Google naprawdę używa?
Krótka lista: description, robots i googlebot, notranslate, nopagereadaloud, google-site-verification, deklaracje Content-Type i charset, refresh, viewport oraz rating. Meta tagi, których Google nie obsługuje, po prostu ignoruje (Google).
Najbardziej znanym z ignorowanych jest tag meta keywords: dokumentacja Google mówi, że „nie jest wykorzystywany przez wyszukiwarkę Google i nie ma żadnego wpływu na indeksowanie i ranking”, a w 2009 roku Google ogłosił, że przestał go używać. Google nie używa też atrybutu lang do rozpoznania języka strony, a rel=next i rel=prev nic już nie robią. Z tagów Open Graph Google dokumentuje tylko og:title, jako jedno ze źródeł linków z tytułem.
Niektóre tagi mają znaczenie nawet tam, gdzie Google ich nie uwzględnia. Czytniki ekranu i przeglądarki używają lang. Bez tagu viewport telefon układa stronę na szerokość około 980 pikseli CSS i ją zmniejsza, więc style dla wąskich ekranów nigdy nie działają (MDN); według Google sama obecność tego tagu wskazuje mu, że strona jest dostosowana do urządzeń mobilnych. A <meta charset> musi stać w pierwszych 1024 bajtach pliku, jedynej części, w której przeglądarki go szukają (HTML).
Dwa kolejne warto sprawdzić. refresh działa jak przekierowanie, ale Google zaleca zamiast niego przekierowanie 301 po stronie serwera. A noarchive, wycofany w Google, w Bing nadal decyduje, czy treść może trafić do odpowiedzi jego czatu (Bing).
Google go używa
<meta name="description">Czasem staje się snippetemrobots · googlebotReguły indeksowania i snippetu<title>Jedno ze źródeł linku z tytułemog:titleKolejne źródło linku z tytułemviewportOdczytywany jako znak strony przyjaznej urządzeniom mobilnymcharsetSzukany tylko w pierwszych 1024 bajtachrefreshDziała, ale 301 jest lepszeGoogle go ignoruje
keywordsBez wpływu na indeksowanie i rankingrel=next · rel=prevJuż nieużywaneNie dla Google, ale ma znaczenie
<html lang>Nie służy do rozpoznania języka; używają go czytniki ekranuog:imageUżywany przez Facebooka i X

noarchiveWycofany w Google, używany przez BingŹródła
- Google Search Central: snippety, linki z tytułem, tag meta robots i X-Robots-Tag, noindex, meta tagi obsługiwane przez Google, prawidłowe metadane strony, adresy kanoniczne i wersje zlokalizowane
- HTML Living Standard (tytuł, opis, kodowanie znaków) i MDN o tagu meta viewport
- Protokół Open Graph i Meta for Developers o obrazach przy udostępnianiu
- Dokumentacja kart X w ostatniej opublikowanej wersji, odczytana z Internet Archive: znaczniki i summary_large_image
- Yandex o dyrektywach meta robots i Bing Webmaster Blog
- Zaobserwowane, nie opublikowane przez Google: szerokości w pikselach i odsetki przepisanych tytułów i opisów pochodzą z badań innych firm, takich jak badanie tytułów Zyppy; szerokości na tej stronie to nasze własne pomiary w Arial
Sprawdzanie meta tagów: pytania i odpowiedzi
Jaki jest limit znaków meta description?
Jak długi powinien być tag title?
Jak sprawdzić, czy strona ma noindex?
Co oznacza noindex, nofollow?
Zablokować stronę w robots.txt czy użyć noindex?
Czym różni się tag meta robots od X-Robots-Tag?
Dlaczego Google pokazuje inny tytuł i opis niż te z mojej strony?
Jak sprawdzić tagi Open Graph dla Facebooka?
Czy Twitter Card Validator nadal działa?
Czy Google nadal używa tagu meta keywords?
Czy potrzebuję tagu meta viewport?
Czy to narzędzie do sprawdzania meta tagów uruchamia JavaScript?
Czegoś brakuje?Zaproponuj funkcję lub nowe narzędzie
Więcej narzędzi dla stron i SEO
Analiza Linków
Analizuj wszystkie linki na stronie z wykrywaniem dofollow/nofollow i sprawdzaniem statusu HTTP
Sprawdzanie Przekierowań
Sprawdź przekierowania URL, łańcuchy przekierowań i kody statusu HTTP dla SEO
Sprawdzanie Nagłówków HTTP
Analizuj nagłówki odpowiedzi HTTP i ocenę nagłówków bezpieczeństwa
Detektor CMS
Jaki CMS, motyw, wtyczki i technologie ma strona, z dowodem dla każdego
Czym są tagi Open Graph i Twitter Cards?
To meta tagi, które decydują o tytule, tekście i obrazie, jakie pokazuje link po udostępnieniu. Open Graph ma cztery wymagane właściwości,
og:title,og:type,og:imageiog:url(OGP); X czyta własne tagitwitter:, a w pozostałych sięga po te tagi og.Facebook prosi o obraz co najmniej 1200 × 630 px, w proporcjach zbliżonych do 1,91:1 i nie większy niż 8 MB; 600 × 315 px to minimum dla posta z linkiem, a niczego poniżej 200 × 200 px nie przyjmuje (Facebook). Dodaj
og:image:widthiog:image:height: bez nich robot musi najpierw pobrać obraz, więc pierwsza osoba, która udostępni link, nie zobaczy obrazu. Jako narzędzie do sprawdzania Open Graph ta strona odczytuje prawdziwy rozmiar obrazu z samego pliku.Ostatnia opublikowana dokumentacja kart X, zarchiwizowana w grudniu 2023, wymagała dla
summary_large_imageobrazu 2:1 o wymiarach co najmniej 300 × 157 px, dlasummarykwadratu co najmniej 144 × 144 px, poniżej 5 MB i nigdy w SVG (X, archiwum). Bez tagówtwitter:X używaog:title,og:descriptioniog:image, ale może pokazać tylko małą kartę summary, dopókitwitter:cardnie poprosi o dużą.Oba serwisy zapamiętują to, co odczytały: Facebook trzyma obraz, dopóki nie zmieni się jego URL. Jego Sharing Debugger odczytuje stronę ponownie i wymaga logowania do Facebooka. X nie oferuje już publicznego Card Validatora, który działa: 26 października 2026 jego adres prowadził tylko do logowania, a potem do błędu. Praktycznym sprawdzeniem pozostaje wklejenie linku do nowego posta bez publikowania go.
summary_large_imagesummaryBrak tagów twitter:? X sięga po og:title, og:description i og:image.