











Vérificateur de balises meta
Un vérificateur de balises meta qui mesure au lieu de compter : le titre et la meta description d'une page en pixels, là où les résultats de Google les coupent, puis si la page peut être indexée et à quoi ressemble son lien quand on le partage.
Nous lisons la page depuis notre serveur comme Google lit son head, et mesurons le titre et la description en pixels.
Quelle longueur pour une meta description ?
Aussi longue qu'il le faut pour décrire la page : Google ne fixe aucun maximum et coupe l'extrait à la largeur de l'écran, pas à un nombre de caractères. Des tiers mesurent cet espace à environ 920 pixels sur ordinateur et 680 sur mobile, ce qu'une phrase française typique remplit, selon nos mesures, vers 150 et 110 caractères.
Selon Google : « Il n'y a pas de limite à la longueur des meta descriptions, mais l'extrait est tronqué dans les résultats de recherche Google si nécessaire, généralement pour s'adapter à la largeur de l'appareil » (Google). L'unité est la largeur : ce sont donc les lettres qui décident. Mesurés en Arial à 14 px, iiiiii fait 19 px de large et WWWWWW 79 px ; les caractères japonais sont en pleine chasse, et le même espace en contient donc environ moitié moins ; le coréen, écrit avec des espaces, environ deux tiers.
Voilà pourquoi les fameux « 155 à 160 caractères » sont une règle empirique, pas une limite, et pourquoi un vérificateur de meta description qui compte les caractères peut se tromper dans les deux sens. Une description de 128 caractères en casse normale tient dans un résultat sur ordinateur avec de la marge ; les mêmes mots en majuscules dépassent le bord de 159 px. Des conseils comme « 50–60 caractères, soit 580 pixels » traitent les deux unités comme interchangeables, et elles ne le sont pas.
La longueur ne coûte rien au classement : Google a déclaré en 2009 qu'il n'utilise pas la description pour le classement, et sa documentation ne cite aucune pénalité pour une description longue ou absente. Google rédige d'ailleurs souvent son propre extrait à partir de la page ; deux études tierces l'ont vu remplacer la description dans environ deux résultats sur trois. Écrivez pour le lecteur : propre à la page, un vrai résumé, jamais une liste de mots-clés, avec les mots importants en premier.
Le seul endroit où Google compte vraiment des caractères est la règle robots max-snippet : son nombre est un nombre de caractères, 0 signifiant aucun extrait et -1 laissant Google choisir (Google).
Retour gratuit sur nos chaussures de randonnée. Cuir imperméable, semelles adhérentes et garantie de deux ans. Livraison demain.
RETOUR GRATUIT SUR NOS CHAUSSURES DE RANDONNÉE. CUIR IMPERMÉABLE, SEMELLES ADHÉRENTES ET GARANTIE DE DEUX ANS. LIVRAISON DEMAIN.
Espaces observés par des tiers ; Google n'en publie aucun.
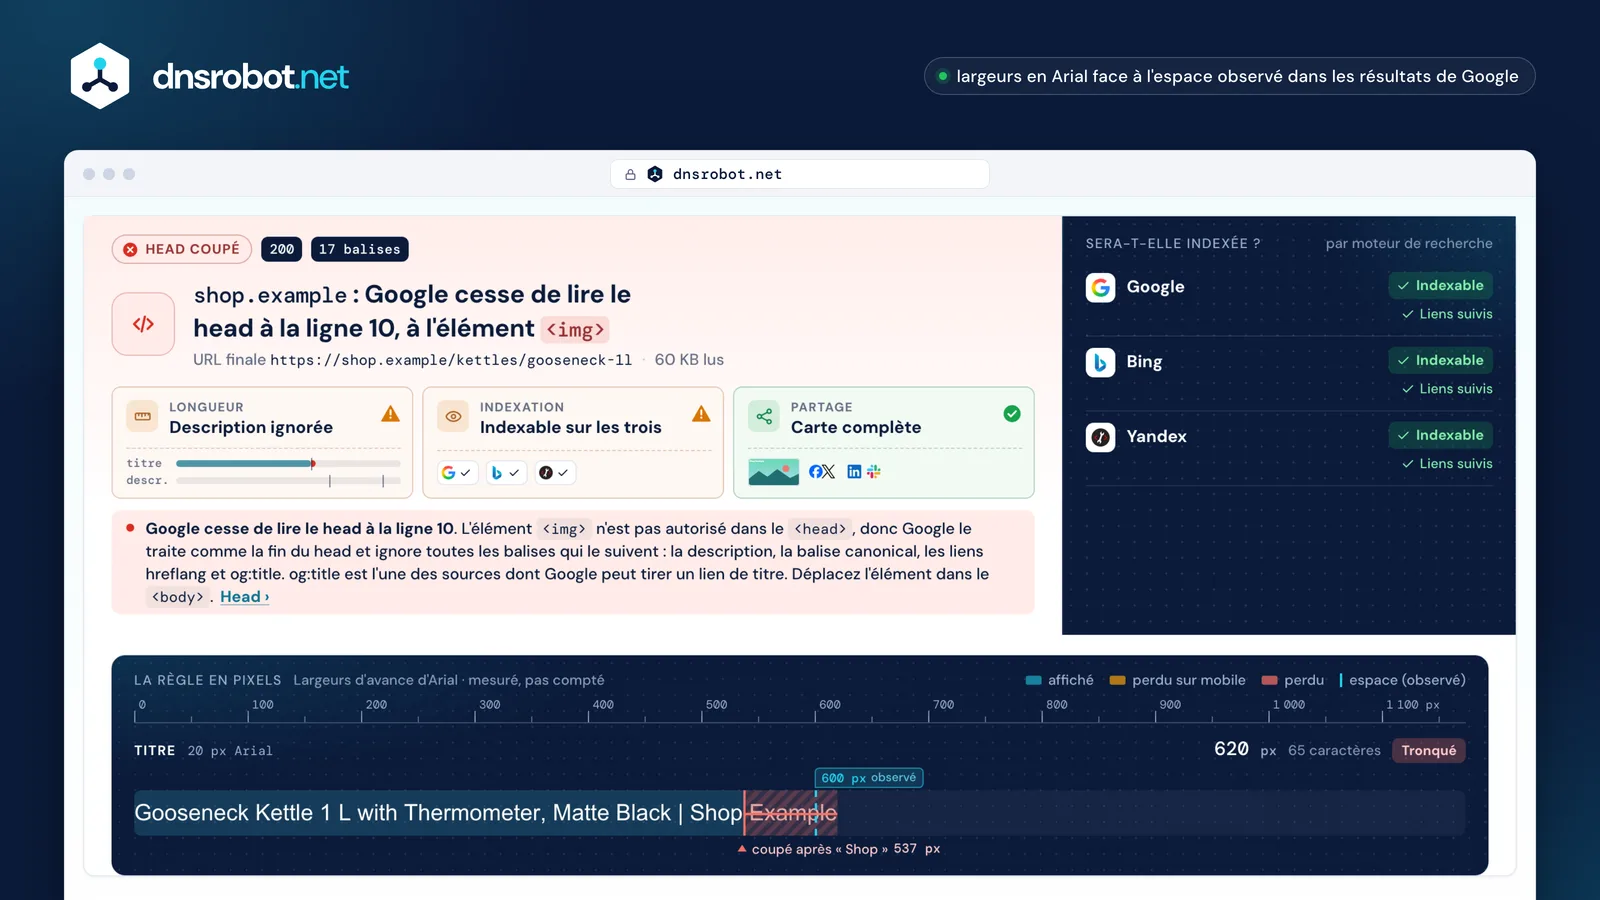
 Mesuré, pas comptéLe titre et la description à la taille où une page de résultats les dessine, avec la règle qui montre où chacun est coupé sur ordinateur et sur mobile.L'indexation, moteur par moteurLes balises meta robots et l'en-tête X-Robots-Tag, lus comme Google, Bing et Yandex les lisent chacun.Ce que Google ne lit jamaisUn élément qui termine le head trop tôt, sa ligne, et chaque balise qu'il masque.L'aspect une fois partagéLes cartes que Facebook et X construisent à partir des balises, avec la taille réelle de l'image lue dans le fichier.
Quelle longueur pour une balise title ?
Assez longue pour nommer la page, et assez courte pour tenir dans environ 600 pixels, l'espace que des tiers mesurent pour un lien de titre sur ordinateur : en gros 50 à 60 caractères d'un texte typique. Google lui-même ne fixe aucune limite et tronque le lien de titre si nécessaire, « pour s'adapter à la largeur de l'appareil ».
Le guide des liens de titre de Google indique qu'il n'y a « aucune limite de longueur pour l'élément <title> », mais demande d'éviter « les titres inutilement longs ou trop détaillés ». Une étude de 80 959 titres sur 2 370 sites a montré que Google réécrivait presque à chaque fois les titres de plus de 70 caractères, et ceux de 51 à 55 caractères environ 40 % du temps.
Le <title> est une donnée d'entrée, pas le résultat. Google construit automatiquement le lien de titre à partir de l'élément title, du titre principal visible de la page, des titres comme <h1>, de og:title, d'autres textes bien visibles, du texte d'ancrage, du texte des liens qui pointent vers la page et des données structurées WebSite. Il remplace un titre absent, passe-partout, bourré de mots-clés, ou écrit dans une autre langue ou une autre écriture que la page.
Donnez donc à chaque page son propre titre descriptif, placez le nom du site une seule fois au début ou à la fin, après un séparateur comme une barre verticale, et évitez les titres vagues comme « Accueil ». Le vérificateur ci-dessus lit aussi le premier <h1> de la page, puisque Google peut tirer le lien de titre de l'un comme de l'autre.
- 1L'élément title
- 2Le titre principal affiché sur la page
- 3Les titres comme h1
- 4La balise og:title
- 5D'autres textes grands et bien visibles
- 6D'autres textes de la page
- 7Le texte d'ancrage de la page
- 8Le texte des liens qui pointent vers la page
- 9Les données structurées WebSite
Vérificateur noindex : comment savoir si une page est en noindex ?
Regardez à deux endroits : la balise meta robots dans le HTML et l'en-tête HTTP X-Robots-Tag. L'en-tête n'apparaît jamais dans le code source de la page : un vérificateur noindex qui ne lit que le HTML peut donc déclarer indexable une page qui ne l'est pas ; celui-ci lit les deux, pour Google, Bing et Yandex.
Une balise noindex et l'en-tête portent les mêmes règles, et Google les additionne : avec noindex dans l'en-tête et all dans la balise, la page est en noindex, car « en cas de règles contradictoires, celle qui est la plus restrictive s'applique » (Google). none signifie noindex, nofollow ; la page de Google consacrée à noindex qualifie nofollow d'indication. Sans aucune balise, la valeur par défaut est index, follow. Le Vérificateur d'en-têtes HTTP montre chaque en-tête qu'envoie une page.
Yandex règle un conflit dans l'autre sens : « Les directives d'autorisation ont la priorité lorsqu'elles sont combinées à des directives d'interdiction », si bien que all à côté de noindex, follow reste indexé chez lui (Yandex). Voilà pourquoi le verdict ci-dessus est donné moteur par moteur, et non une fois pour tous.
Le piège, c'est robots.txt. Une URL bloquée par ce fichier n'est jamais récupérée, son noindex n'est donc jamais lu, et elle peut quand même apparaître dans les résultats quand d'autres pages pointent vers elle (Google). Pour exclure une page, laissez-la explorer et donnez-lui un noindex ; un noindex écrit dans robots.txt n'est pas du tout pris en charge. Et un nouveau noindex ne fonctionne qu'une fois que Google a de nouveau exploré la page, ce qui peut prendre des mois.
X-Robots-Tag: noindex| Moteur de recherche | Comment il règle un conflit | Cette page |
|---|---|---|
| La règle la plus restrictive l'emporte | Exclue | |
| Bing | La règle la plus restrictive l'emporteAucune règle publiée ; lu comme Google | Exclue |
| Yandex | La règle qui autorise l'emporte | Indexable |

Bloquée dans robots.txt : la page n'est jamais récupérée, donc son noindex n'est jamais lu.
Pourquoi Google ignore-t-il certaines de mes balises meta ?
Souvent parce qu'un élément qui n'a pas sa place dans le <head>, comme un <img> ou un <iframe>, se trouve au-dessus d'elles. Google le traite comme la fin du head et ignore tous les éléments qui le suivent (Google).
Seuls huit éléments sont valides dans le head : title, meta, link, script, style, base, noscript et template. Un pixel de suivi collé avec un extrait de code de balise, un <div> égaré ou un <iframe> intégré le termine trop tôt, et la balise canonical, les liens hreflang et la description situés en dessous sont perdus sans la moindre erreur affichée. Un analyseur de balises meta qui se contente de collecter toutes les balises du fichier les signale pourtant toutes comme présentes.
Tout n'est pas perdu. Google respecte aussi les balises meta robots dans le body : un noindex situé après la coupure s'applique donc toujours. Pas une canonical : Google ne l'accepte que dans le head (Google). Le vérificateur ci-dessus nomme l'élément et sa ligne, et liste les balises que Google ne lit plus.
Les balises que JavaScript ajoute ou modifie sont l'autre angle mort. Google recommande de l'éviter autant que possible et de définir la canonical dans le code source HTML (Google) : ce vérificateur lit donc le HTML que le serveur envoie.
<meta charset="utf-8"><title>Chaussures de randonnée imperméables – Retou…</title><link rel="stylesheet" href="/theme.css"><img src="https://px.example/p.gif" alt="">Google s'arrête ici<meta name="description" content="Retour gratuit sur nos…">Ignoré par Google<link rel="canonical" href="https://store.example/boots">Ignoré par Google<link rel="alternate" hreflang="de" href="https://store.example/de/stiefel">Ignoré par Google<meta name="robots" content="max-snippet:160">S'applique toujours : les balises robots comptent aussi dans le bodyÀ quoi sert une balise canonical ?
Elle indique aux moteurs de recherche laquelle de plusieurs URL au même contenu vous voulez voir affichée, et c'est une indication, pas une règle : « Google peut choisir une autre page canonique » (Google).
Google la pondère avec d'autres signaux : une redirection est le plus fort, rel=canonical un signal fort, un sitemap un signal faible, et aucun n'est obligatoire (Google). Placez une canonical autoréférente sur la page que vous voulez voir affichée, écrivez-la comme une URL absolue, gardez-la dans le <head>, et n'y ajoutez ni hreflang, ni lang, ni media, ni type, sinon Google l'ignore pour choisir l'URL canonique. Le Vérificateur de Redirections suit chaque étape d'une redirection.
Deux conflits à éviter. Une canonical sur une page en noindex envoie des signaux qui se contredisent, et Google déconseille tout simplement d'utiliser noindex pour choisir une URL canonique. Et une canonical qui pointe vers un autre site sans que personne ici l'ait définie mérite qu'on s'y arrête : Google cite une canonical inter-domaines injectée comme un signe de site piraté.
Les versions linguistiques s'associent plutôt avec hreflang : chaque version se liste elle-même ainsi que toutes les autres avec des URL complètes, et deux pages qui ne pointent pas l'une vers l'autre sont ignorées. Les codes sont une langue ISO 639-1 avec une région ISO 3166-1 facultative : en-GB, jamais en-UK, et es-419 n'est pas pris en charge (Google). Faites pointer la canonical de chaque version linguistique vers une URL dans cette même langue.
Même contenu, plusieurs URL
http://store.example/bootshttps://store.example/boots?utm_source=mailhttps://www.store.example/bootshttps://store.example/boots/https://store.example/bootsUne indication : Google peut en choisir une autreSignaux, du plus fort au plus faible
rel=canonicalSitemapUne paire hreflang
/en/boots/de/stiefelLiens dans les deux sens : utilisée
/en/boots/fr/bottesDans un seul sens : ignorée
Quelles balises meta Google utilise-t-il vraiment ?
Une courte liste : description, robots et googlebot, notranslate, nopagereadaloud, google-site-verification, les déclarations Content-Type et charset, refresh, viewport et rating. Google ignore tout simplement les balises meta qu'il ne prend pas en charge (Google).
La balise meta keywords est la plus connue de celles qu'il ignore : la documentation de Google indique qu'elle « n'est pas utilisée par la recherche Google et n'a aucune incidence sur l'indexation ni sur le classement », et Google a annoncé en 2009 qu'il avait cessé de l'utiliser. Google n'utilise pas non plus l'attribut lang pour détecter la langue d'une page, et rel=next et rel=prev ne font plus rien. Parmi les balises Open Graph, Google ne documente que og:title, comme l'une des sources des liens de titre.
Certaines balises comptent même là où Google ne les prend pas en compte. Les lecteurs d'écran et les navigateurs utilisent lang. Sans balise viewport, un téléphone met la page en page sur environ 980 pixels CSS de large puis la réduit, si bien que les styles pour écrans étroits ne s'appliquent jamais (MDN) ; Google dit que la présence de la balise lui indique qu'une page est adaptée aux mobiles. Et <meta charset> doit se trouver dans les 1 024 premiers octets du fichier, la seule partie où les navigateurs la cherchent (HTML).
Deux autres méritent un coup d'œil. refresh fonctionne comme une redirection, mais Google recommande plutôt une redirection 301 côté serveur. Et noarchive, retirée chez Google, décide encore chez Bing si un contenu peut apparaître dans ses réponses de chat (Bing).
Google l'utilise
<meta name="description">Devient parfois l'extraitrobots · googlebotRègles d'indexation et d'extrait<title>Une source du lien de titreog:titleUne autre source du lien de titreviewportLue comme le signe d'une page adaptée aux mobilescharsetTrouvée seulement dans les 1 024 premiers octetsrefreshFonctionne, mais une 301 vaut mieuxGoogle l'ignore
keywordsAucun effet sur l'indexation ni le classementrel=next · rel=prevPlus utiliséesPas pour Google, mais utile
<html lang>Pas utilisée pour détecter la langue ; les lecteurs d'écran l'utilisentog:imageUtilisée par Facebook et X

noarchiveRetirée chez Google, utilisée par BingSources
- Google Search Central : extraits, liens de titre, balise meta robots et X-Robots-Tag, noindex, balises meta prises en charge par Google, métadonnées de page valides, URL canoniques et versions localisées
- Le HTML Living Standard (titre, description, encodage des caractères) et MDN sur la balise meta viewport
- Le protocole Open Graph et Meta for Developers sur les images de partage
- La documentation des cartes de X telle que publiée en dernier, lue dans l'Internet Archive : balisage et summary_large_image
- Yandex sur les directives meta robots et le Bing Webmaster Blog
- Observé, non publié par Google : les espaces en pixels et les taux de réécriture viennent d'études tierces comme l'étude de Zyppy sur les titres ; les largeurs de cette page sont nos propres mesures en Arial
Vérificateur de balises meta : questions et réponses
Quelle est la limite de caractères d'une meta description ?
Quelle longueur pour une balise title ?
Comment savoir si une page est en noindex ?
Que signifie noindex, nofollow ?
Faut-il bloquer une page dans robots.txt ou utiliser noindex ?
Quelle différence entre la balise meta robots et X-Robots-Tag ?
Pourquoi Google affiche-t-il un titre et une description différents des miens ?
Comment vérifier les balises Open Graph pour Facebook ?
Le Twitter Card Validator est-il encore disponible ?
Google utilise-t-il encore la balise meta keywords ?
Ai-je besoin d'une balise meta viewport ?
Ce vérificateur de balises meta exécute-t-il JavaScript ?
Il vous manque quelque chose ?Suggérez une fonction ou un nouvel outil
Plus d'outils pour votre site web et le SEO
Analyseur de Liens
Analysez tous les liens d'une page avec détection dofollow/nofollow et vérification de statut HTTP
Vérificateur de Redirections
Vérifiez les redirections d'URL, les chaînes de redirection et les codes de statut HTTP pour le SEO
Vérificateur d'en-têtes HTTP
Analysez les en-têtes de réponse HTTP et la notation des en-têtes de sécurité
Détecteur de CMS
Quel CMS, thème, plugins et technologies un site utilise, avec la preuve de chacun
Que sont les balises Open Graph et les Twitter Cards ?
Ce sont les balises meta qui décident du titre, du texte et de l'image qu'affiche un lien quand on le partage. Open Graph a quatre propriétés obligatoires,
og:title,og:type,og:imageetog:url(OGP) ; X lit ses propres balisestwitter:et se rabat sur ces balises og pour le reste.Facebook demande une image d'au moins 1200 × 630 px, proche de 1,91:1 et de 8 MB au plus ; 600 × 315 px est le minimum pour une publication avec lien, et rien en dessous de 200 × 200 px n'est accepté (Facebook). Ajoutez
og:image:widthetog:image:height: sans elles, le robot doit d'abord télécharger l'image, et la première personne qui partage le lien ne voit donc aucune image. En tant que vérificateur Open Graph, cette page lit la taille réelle de l'image dans le fichier lui-même.La dernière documentation des cartes publiée par X, archivée en décembre 2023, demandait pour
summary_large_imageune image en 2:1 d'au moins 300 × 157 px, poursummaryun carré d'au moins 144 × 144 px, moins de 5 MB et jamais de SVG (X, archivée). Sans balisestwitter:, X utiliseog:title,og:descriptionetog:image, mais peut n'afficher que la petite carte summary jusqu'à ce quetwitter:carddemande la grande.Les deux réseaux gardent en cache ce qu'ils lisent : Facebook conserve une image jusqu'à ce que son URL change. Son Sharing Debugger relit une page et demande une connexion Facebook. X ne propose plus de Card Validator public qui fonctionne : le 26 octobre 2026, son adresse ne menait qu'à une connexion puis à une erreur. La vérification pratique qui reste consiste à coller le lien dans un nouveau post sans le publier.
summary_large_imagesummaryPas de balises twitter: ? X se rabat sur og:title, og:description et og:image.