











Vérificateur de Sitemap
Testez votre sitemap à partir d'un domaine ou de son URL, et obtenez une vue complète : chaque fichier de l'index, chaque règle fixée par le protocole, les URL que les moteurs de recherche refuseront et pourquoi, et si ses dates veulent dire quelque chose.
Un domaine suffit : nous lisons robots.txt et regardons aux emplacements habituels. Un fichier fonctionne aussi, comme example.com/sitemap.xml.
- robots.txtLu en premier, avec ce qu'il implique
- Sitemaprobots.txt, puis les chemins habituels
- Fichiers lusL'index et dix de ses fichiers
- VérifiéToutes les règles, confrontées à robots.txt
Comment vérifier un sitemap XML
Saisissez votre domaine ci-dessus et choisissez Vérifier le sitemap : nous lisons robots.txt, trouvons le fichier qu'il nomme, le lisons avec jusqu'à dix de ses fichiers et récupérons un échantillon de ses URL, puis nous montrons ce qu'un moteur de recherche ferait de tout cela.
Vous pouvez donner un simple domaine ou l'adresse du fichier lui-même. À partir d'un domaine, nous prenons d'abord les lignes Sitemap: de robots.txt, puis nous essayons les chemins habituels ; à partir d'une adresse, nous lisons exactement ce que vous avez donné. Dans les deux cas, le fichier est lu en entier, pas seulement les cent premières URL, ainsi que jusqu'à dix fichiers d'un index de sitemaps.
Quatre choses décident si un sitemap fait son travail : le fichier s'analyse, il reste dans les limites du protocole, rien en lui ne contredit robots.txt ou le propre noindex des pages, et ses dates veulent dire quelque chose. Les vues ci-dessus les couvrent : Fichiers et Problèmes pour le format et les limites, robots.txt et Pages échantillons pour les contradictions, et URL pour les dates.
200sitemap_index.xml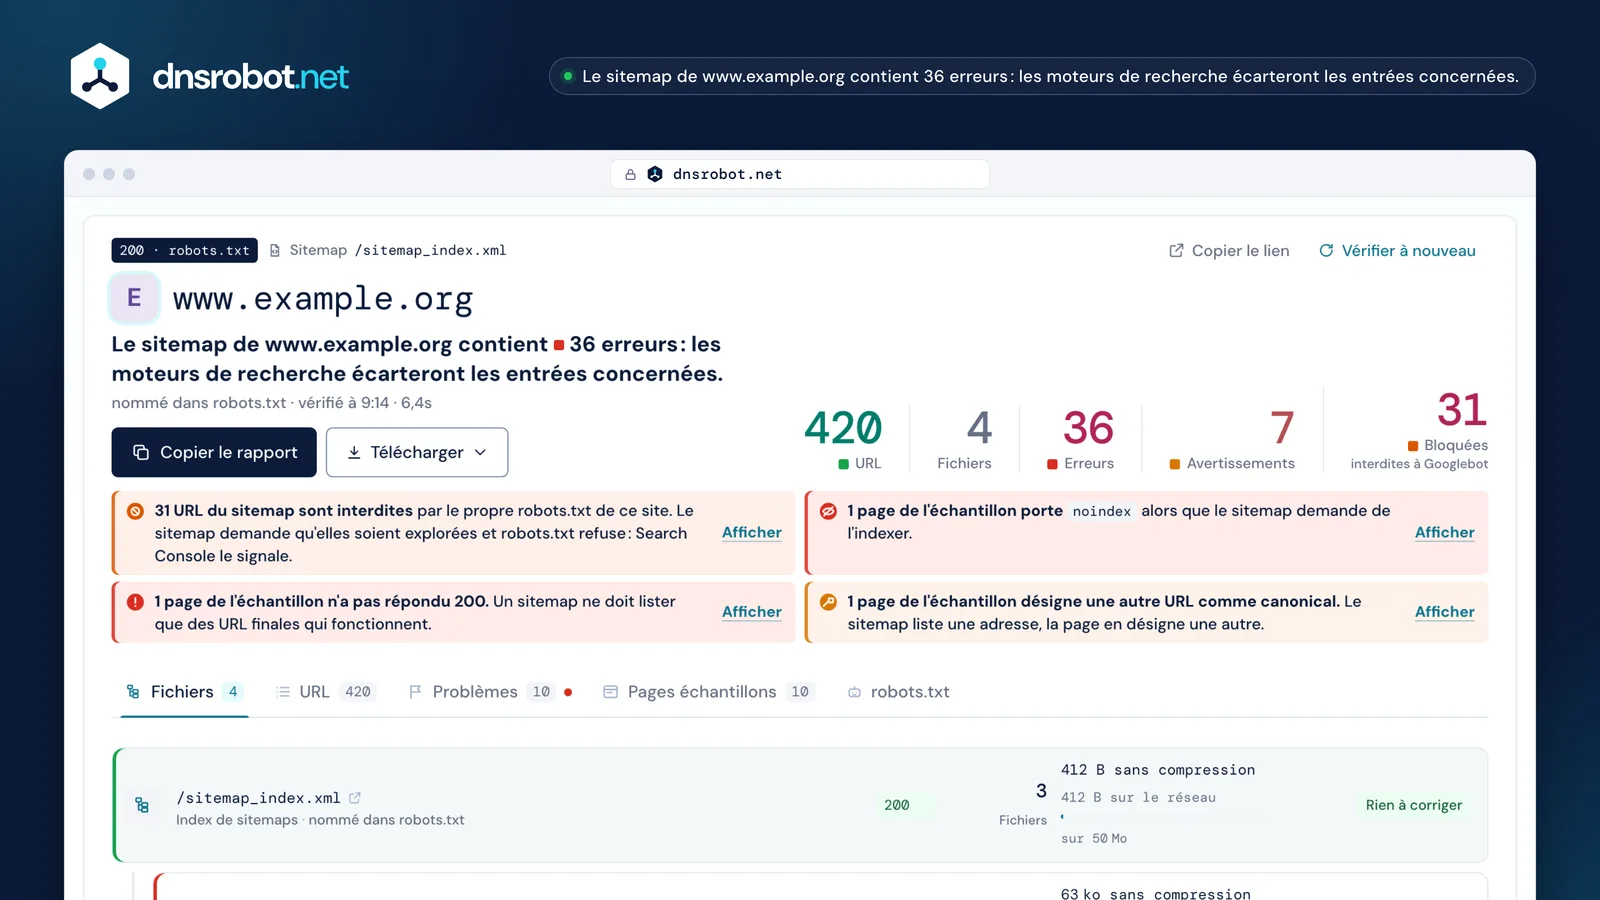
 Le verdictCe qui ne va pas dans ce sitemap, en une phrase, avec les cinq chiffres qui la portent : les URL, les fichiers, les erreurs, les avertissements et les URL que robots.txt refuse.robots.txt et ce qu'il impliquePas seulement le code d'état : ce que ce code signifie pour tout le site. Un 4xx veut dire que tout peut être exploré ; un 5xx, que rien ne doit l'être.Chaque fichier de l'indexChaque fichier avec les URL qu'il contient, sa taille décompressée face à la limite de 50 MB, la taille transférée à côté, et ses propres constats.Les contradictionsLes URL que le sitemap demande aux moteurs de recherche d'explorer alors que robots.txt les refuse, et les pages de l'échantillon qui portent noindex ou désignent une autre URL comme canonical.
Qu'est-ce qui rend un sitemap invalide ?
Un sitemap est invalide quand un analyseur ne peut pas le lire : un & nu, un mauvais élément racine, un espace de noms manquant, une URL relative ou des espaces écrits avant la déclaration XML. Tout le reste est un avertissement, pas un refus.
La plus courante de toutes est une esperluette non échappée. XML lit & comme le début d'une référence de caractère : il suffit d'une seule esperluette nue pour mettre fin au fichier aux yeux d'un analyseur, et tout ce qui suit reste non lu. Écrivez-la &, et échappez de la même façon <, >, " et ' (sitemaps.org). Un <loc> doit être une URL complète qui commence par le protocole et reste sous 2 048 caractères.
L'espace de noms doit être exactement http://www.sitemaps.org/schemas/sitemap/0.9, en http:// même pour un site en https : c'est un nom pour les analyseurs, pas une adresse que quelqu'un va chercher. Le fichier doit être en UTF-8, et rien, pas même une ligne vide, ne doit précéder <?xml ; une marque d'ordre des octets UTF-8 est la seule chose permise à cet endroit.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Une ligne vide avant la déclaration
- 2L'espace de noms doit être exactement cette chaîne, en http://
- 3Un & nu met fin au fichier pour un analyseur
- 4Un chemin n'est pas une URL : elle doit commencer par le protocole
- 5Une heure exige un fuseau horaire ; sinon, omettez l'heure
Les erreurs de sitemap dans Search Console, et ce que chacune signifie
Google Search Console attribue à un sitemap l'un de trois statuts — Opération effectuée, Contient des erreurs ou Impossible de récupérer le sitemap —, pour les propriétés validées uniquement, et sans vous dire quelle ligne est en cause. Cette page vérifie n'importe quel sitemap public et nomme la ligne.
Impossible de récupérer le sitemap (la page d'informations dit alors « Impossible de lire le sitemap ») signifie que la requête de Google n'a pas ramené de fichier lisible : un 4xx ou un 5xx, une chaîne de redirections, un délai dépassé, un pare-feu qui refuse Google, ou une règle robots.txt qui interdit le chemin du sitemap lui-même. Contient des erreurs signifie que le fichier a été lu et que quelque chose en lui enfreint une règle — la figure à côté liste les messages que vous verrez le plus probablement, et la ligne qui se cache derrière chacun.
Deux de ces messages portent sur la taille plutôt que sur le format : un sitemap qui liste plus de 50 000 URL, et un index de sitemaps qui liste plus de 50 000 sitemaps (Google). Divisez un sitemap trop gros en fichiers listés dans un index ; un index trop gros devient plusieurs index, chacun envoyé séparément. Un sitemap qui liste des URL bloquées par robots.txt est signalé lui aussi, et celui-là est une contradiction dans vos propres fichiers plutôt qu'une erreur de format.
Les trois statuts
Les messages que vous verrez le plus probablement
- Impossible de lire le sitemapUn 4xx ou un 5xx, une chaîne de redirections, un pare-feu, ou robots.txt qui interdit le chemin du sitemap lui-même.
- Trop d'URLPlus de 50 000 URL dans un seul sitemap : une erreur, pas un avertissement. Divisez-le sous un index.
- Erreur d'analyse syntaxiqueSouvent un & nu dans une URL. Écrivez-le &.
- Date incorrecteUn lastmod qui n'est pas un W3C Datetime, ou une heure sans fuseau horaire.
- URL incorrecteUn espace, un guillemet ou un autre caractère qu'une URL ne peut pas contenir, ou un protocole cassé comme htp://.
- Le sitemap contient des URL bloquées par le fichier robots.txtLes deux fichiers se contredisent. Décidez lequel a raison.
Propriétés validées uniquementSearch Console ne rend compte d'un sitemap que pour une propriété qui vous appartient. Cette page vérifie n'importe quel sitemap public, et nomme la ligne.
La date lastmod doit-elle être honnête ?
Oui. Google utilise <lastmod> « s'il est systématiquement et vérifiablement exact » : une date identique sur toutes les URL, ou qui change à chaque écriture du fichier, est donc pire que pas de date du tout — elle apprend à Google à ignorer la balise.
Tous les autres vérificateurs de sitemap lisent le format d'une date : est-ce un W3C Datetime, l'heure porte-t-elle un fuseau horaire. Le format est la moitié facile. Ce qui décide si la balise sert à quelque chose, c'est de savoir si la valeur dit vrai, et deux indices trahissent le contraire : un même horodatage répété sur toutes les entrées, et une date qui est toujours celle du jour. Bing programme lui aussi ses explorations avec lastmod et peut ignorer les dates qui sont toujours actuelles.
Ce vérificateur indique donc ce que sont les dates, pas seulement comment elles sont écrites : combien d'entrées en portent une, la plus ancienne et la plus récente, et s'il s'agit d'une seule valeur répétée. Omettre <lastmod> est valide et ne coûte rien ; en inventer un coûte à la balise sa crédibilité pour tout le site. Marquez la dernière modification importante — le contenu principal, les données structurées, les liens —, pas une nouvelle année de copyright (Google).
Aucun lastmodValide. Rien pour programmer, et rien à mettre en doute.
50 000 URL et 50 MB : quand diviser un sitemap
Un sitemap contient au plus 50 000 URL et 50 MB décompressés. Dès que vous franchissez la première de ces deux limites, répartissez les URL dans plusieurs fichiers, listez ces fichiers dans un index de sitemaps, puis envoyez l'index.
La limite de taille compte le fichier décompressé, même quand vous le servez en .xml.gz : c'est pourquoi ce vérificateur montre la taille décompressée, avec la taille transférée à côté. Un sitemap de 30 KB servi en gzip peut peser 1,6 KB sur le réseau, et ce chiffre ne dit rien de la limite. Naver Search Advisor refuse les fichiers de plus de 10 MB : un site coréen a donc un plafond plus bas que celui du protocole.
Un index peut lister jusqu'à 50 000 sitemaps, uniquement des fichiers de son propre site, et jamais un autre index : un index imbriqué n'est pas lu. Les alternatives de langue écrites avec xhtml:link ne comptent pas dans les 50 000. Ce vérificateur lit l'index et jusqu'à dix de ses fichiers en une seule exécution, chacun avec son propre nombre d'URL, sa taille et ses constats.
6,2 MoSur le réseau812 kogzip réduit la taille du fichier à l'envoi ; la limite compte toujours la taille après décompression.sitemap_index.xmlUn index ne peut pas nommer un autre indexrobots.txt et votre sitemap : les contradictions qui vous coûtent des pages
Votre sitemap demande aux moteurs de recherche d'explorer une liste d'URL ; robots.txt leur dit ce qu'ils n'ont pas le droit d'explorer. Quand les deux ne sont pas d'accord, robots.txt l'emporte et l'entrée du sitemap est perdue — et Search Console le signale.
Le statut de robots.txt lui-même est la première chose à lire, et presque personne ne dit ce qu'il signifie. Un 4xx veut dire « indisponible » : il n'y a pas de règles, donc tout peut être exploré. Un 5xx, ou pas de réponse du tout, veut dire « inaccessible », et un robot qui suit la RFC 9309 ne doit alors rien explorer sur le site ; Google lit un 429 de la même façon. Le même fichier défaillant produit des issues opposées, et un outil qui affiche « aucune URL n'est bloquée » au-dessus d'un robots.txt illisible se trompe chaque fois que le fichier a répondu 5xx ou 429, ou n'a pas répondu du tout.
Viennent ensuite les contradictions à l'intérieur d'un fichier qui fonctionne : les URL que le sitemap liste et que robots.txt interdit, et — facile à manquer — le chemin du sitemap lui-même interdit, ce qui publie un fichier qu'aucun robot n'a le droit de lire. Dans l'autre sens, c'est peu coûteux et cela vaut la peine : une ligne Sitemap: dans robots.txt ne demande aucun compte nulle part, et tous les robots la lisent.
Le statut, et sa conséquence
La contradiction
/search/?q=pepperDisallow: /search/L'entrée ne sert à rien, et Search Console le signale
Et le chemin du sitemap lui-même, interdit : un fichier publié qu'aucun robot n'a le droit de lire.
Quelles URL n'ont pas leur place dans un sitemap ?
Seules y ont leur place les URL canoniques que vous voulez voir dans les résultats, une par page : des adresses finales qui répondent 200, sont indexables et ne sont pas bloquées par robots.txt. Les redirections, les pages en noindex, les URL dont le canonical pointe ailleurs, les erreurs et les variantes à paramètres ont toutes leur place ailleurs.
Un sitemap qui liste une URL qui redirige envoie un robot un saut plus loin que nécessaire, et Google demande plutôt l'URL où la redirection aboutit. Une page en noindex dans un sitemap est une contradiction pure et simple : le fichier dit « indexez ceci », la page dit « non ». La page l'emporte, et l'entrée ne sert à rien.
Rien de tout cela n'est fatal — chaque URL d'un sitemap est une suggestion, et c'est Google qui décide encore de ce qu'il indexe —, mais chaque entrée erronée en est une qu'un moteur de recherche apprend à moins prendre en compte. C'est pourquoi ce vérificateur récupère un échantillon des URL au lieu de seulement analyser le fichier : l'analyse ne peut pas vous dire qu'une page listée répond désormais 404.
/shop/raised-beds/ValideIndexée telle que listée/shop/raised-bed/Redirectionperdue/shop/?sort=priceCanonical ailleursperdue/tags/autumn/noindexperdue/shop/old-kit/404perdue/search/?q=pepperBloquéeperdueEntrées d'image, de vidéo et hreflang
Une entrée <url> peut porter plus qu'une adresse : les images de la page, ses versions dans d'autres langues et des métadonnées vidéo ou d'actualités, chacune dans son propre espace de noms à l'intérieur de cette entrée.
Les images utilisent l'espace de noms image de Google, jusqu'à 1 000 par page ; seuls <image:image> et <image:loc> comptent encore, et caption, title, license et geo_location ont été retirés en 2022. Ce vérificateur compte les entrées d'image qu'il trouve et les montre URL par URL.
Les versions de langue utilisent xhtml:link avec un code hreflang : une langue ISO 639-1 avec une région ISO 3166-1 facultative, jamais une région seule. Chaque version d'une page doit lister toutes les autres, elle-même comprise, sinon Google ignore l'ensemble. Les alternatives ne comptent pas dans la limite de 50 000 URL : lister douze versions de langue dans chaque entrée ne multiplie donc pas le compte par douze.
https://www.example.org/guides/raised-beds/2026-09-143jusqu'à 1 000 par pageen · de · frchaque version liste toutes les versions, elle-même compriseLes alternatives ne comptent pas dans les 50 000
À quelle fréquence les moteurs de recherche lisent-ils votre sitemap ?
Google lit un sitemap selon son propre calendrier, qu'il ne publie pas : en envoyer un est une indication, pas un ordre. Bing en lit un dès qu'il le trouve, puis en général au moins une fois par jour. Aucun des deux ne relit un fichier plus souvent parce que vous le lui demandez.
Les vieux pings anonymes ont disparu : Bing a coupé bing.com/ping le 13 mai 2022, et Google a annoncé en juin 2023 que son ping cesserait de fonctionner ; il répond aujourd'hui 404. Un outil qui propose encore de « pinguer Google » ne fait rien du tout.
Ce qui avance vraiment la prochaine exploration d'une page modifiée, c'est un lastmod exact — toute la raison pour laquelle l'honnêteté de la balise compte —, et IndexNow pour les URL modifiées une à une : un seul envoi atteint Bing, Yandex, Naver, Seznam et d'autres, mais pas Google. Renvoyer à la main un sitemap inchangé ne sert à rien.
Un lastmod exact avance la prochaine exploration d'une page modifiée
Avez-vous vraiment besoin d'un sitemap ?
Un petit site dont toutes les pages se lient entre elles peut s'en passer : Google avance le chiffre d'environ 500 pages ou moins. Ce sont les grands sites, les sites récents avec peu de liens extérieurs et les sites riches en images ou en vidéos qui en profitent le plus.
Le guide de démarrage de Google qualifie le sitemap de facultatif, et l'envoyer est une indication plutôt qu'une instruction : il ne fait pas mieux classer une page et ne garantit pas l'indexation. Ce qu'il fait, c'est s'assurer qu'un robot sait qu'une URL existe, ce qui compte surtout pour les pages que vos propres liens n'atteignent pas.
Si vous en avez un, autant qu'il soit juste. Un sitemap plein de redirections, de pages en noindex et d'URL bloquées par robots.txt n'est pas neutre — c'est une liste à laquelle un moteur de recherche apprend à moins se fier. Le vérifier prend une minute ; en créer un nouveau à partir de votre propre site demande une exploration.
Sources
- Le protocole sitemaps.org et sa FAQ : le format, les balises obligatoires et facultatives, les limites de 50 000 / 50 MB, l'index et la règle d'emplacement
- Google Search Central : créer un sitemap, les grands sitemaps, le rapport sur les sitemaps et ses erreurs, les versions localisées et lastmod et le ping retiré
- Bing : la balise lastmod (2023), les sitemaps dans la recherche dopée à l'IA (2025) et le ping retiré (2022)
- RFC 9309, la norme robots.txt : ce que signifient un 4xx et un 5xx pour un robot
- Naver Search Advisor : les flux et IndexNow
- grands sites
- sites récents, peu de liens extérieurs
- beaucoup d'images ou de vidéos
- pages qu'aucun lien interne n'atteint
Vérificateur de sitemap : questions fréquentes
Comment tester mon sitemap XML et vérifier qu'il est valide ?
Quelles sont les erreurs de sitemap les plus courantes ?
Pourquoi Search Console affiche-t-il « Impossible de lire le sitemap » ?
Est-ce un problème si une URL de mon sitemap est interdite dans robots.txt ?
La date lastmod doit-elle être exacte ?
Combien d'URL un sitemap peut-il contenir ?
Google utilise-t-il priority et changefreq ?
Ce vérificateur de sitemap est-il gratuit, et y a-t-il une limite d'URL ?
En quoi est-ce différent de Google Search Console ?
Qu'est-ce qu'un index de sitemaps, et peut-il nommer un autre index ?
Mon sitemap doit-il être indiqué dans robots.txt ?
Un sitemap fera-t-il indexer mes pages ?
Il vous manque quelque chose ?Suggérez une fonction ou un nouvel outil
Plus d'outils d'exploration et de SEO
Testeur de Robots.txt
Récupérez le robots.txt de n'importe quel site, testez si une URL est bloquée pour Googlebot ou les crawlers IA et trouvez les erreurs de syntaxe
Générateur de Sitemap
Explorez votre site et obtenez un sitemap XML, un plan du site HTML et une arborescence visuelle
Analyseur de Liens
Analysez tous les liens d'une page avec détection dofollow/nofollow et vérification de statut HTTP
Vérificateur de Redirections
Vérifiez les redirections d'URL, les chaînes de redirection et les codes de statut HTTP pour le SEO
Vérificateur d'en-têtes HTTP
Analysez les en-têtes de réponse HTTP et la notation des en-têtes de sécurité
Vérificateur de site en panne
En panne pour tout le monde ou juste chez vous ? Vérifiez un site depuis 11 lieux et votre propre connexion, avec une capture en direct
Détecteur de CMS
Quel CMS, thème, plugins et technologies un site utilise, avec la preuve de chacun