











Sitemap Checker
Geben Sie eine Domain oder eine Sitemap-URL ein und lassen Sie die ganze Sitemap auslesen: jede Datei im Index, jede Regel, die das Protokoll setzt, die URLs, die Suchmaschinen ablehnen werden, samt Grund, und ob die Daten darin etwas aussagen.
Eine Domain genügt: Wir lesen die robots.txt und suchen an den üblichen Stellen. Eine Datei geht auch, etwa example.com/sitemap.xml.
- robots.txtZuerst gelesen – und was sie bedeutet
- Sitemaprobots.txt, dann die üblichen Pfade
- Gelesene DateienDer Index und zehn seiner Dateien
- GeprüftJede Regel, abgeglichen mit der robots.txt
XML-Sitemap prüfen und auslesen: So geht's
Geben Sie oben Ihre Domain ein und wählen Sie „Sitemap prüfen“: Wir lesen die robots.txt, finden die Datei, die sie nennt, lesen diese und bis zu zehn ihrer Dateien und rufen eine Stichprobe ihrer URLs ab – und zeigen dann, was eine Suchmaschine aus all dem machen würde.
Sie können eine bloße Domain oder die Adresse der Datei selbst angeben. Bei einer Domain nehmen wir zuerst die Sitemap:-Zeilen der robots.txt und versuchen dann die üblichen Pfade; bei einer Adresse lesen wir genau das, was Sie angegeben haben. So oder so wird die ganze Datei gelesen, nicht nur die ersten hundert URLs, und dazu bis zu zehn Dateien eines Sitemap-Index.
Vier Dinge entscheiden, ob eine Sitemap ihre Arbeit tut: Die Datei lässt sich parsen, sie bleibt innerhalb der Limits des Protokolls, nichts darin widerspricht der robots.txt oder dem noindex der Seiten selbst, und ihre Daten sagen etwas aus. Die Ansichten oben zeigen sie: Dateien und Probleme für das Format und die Limits, robots.txt und Stichprobe für die Widersprüche und URLs für die Daten.
200sitemap_index.xml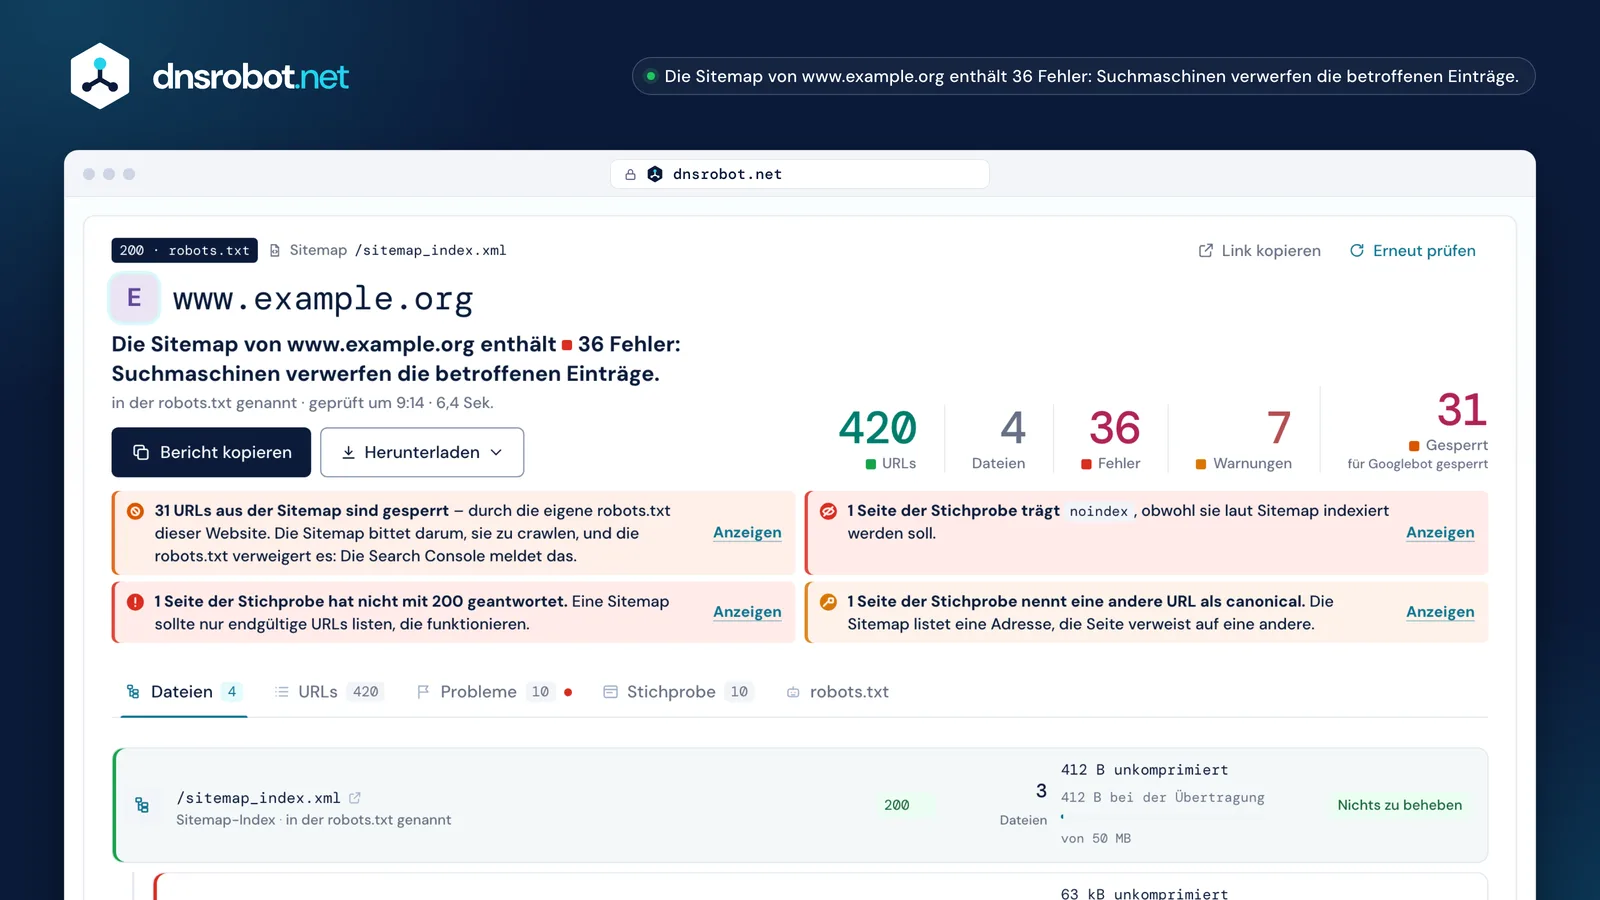
 Das UrteilWas mit dieser Sitemap nicht stimmt, in einem Satz, mit den fünf Zahlen, die es belegen: URLs, Dateien, Fehler, Warnungen und die URLs, die die robots.txt verweigert.Die robots.txt und ihre FolgeNicht nur der Statuscode, sondern was er für die ganze Website bedeutet. Bei einem 4xx darf alles gecrawlt werden, bei einem 5xx nichts.Jede Datei des IndexJede Datei mit den URLs, die sie enthält, ihrer unkomprimierten Größe gemessen an der Grenze von 50 MB, der Übertragungsgröße daneben und ihren eigenen Befunden.Die WidersprücheURLs, die Suchmaschinen laut Sitemap crawlen sollen, während die robots.txt sie verweigert, und Seiten der Stichprobe, die noindex tragen oder eine andere URL als canonical nennen.
Was macht eine Sitemap ungültig?
Eine Sitemap ist ungültig, wenn ein Parser sie nicht lesen kann: ein unmaskiertes &, ein falsches Wurzelelement, ein fehlender Namensraum, eine relative URL oder Leerraum vor der XML-Deklaration. Alles andere ist eine Warnung, keine Ablehnung.
Am häufigsten ist ein nicht maskiertes kaufmännisches Und. XML liest & als Beginn einer Zeichenreferenz, ein einziges unmaskiertes beendet die Datei für einen Parser also, und alles danach bleibt ungelesen. Schreiben Sie es als & und maskieren Sie <, >, " und ' genauso (sitemaps.org). Ein <loc> muss eine vollständige URL sein, die mit dem Protokoll beginnt und unter 2.048 Zeichen bleibt.
Der Namensraum muss genau http://www.sitemaps.org/schemas/sitemap/0.9 lauten, mit http:// auch auf einer https-Website: Er ist ein Name für Parser, keine Adresse, die jemand abruft. Die Datei muss UTF-8 sein, und vor <?xml darf nichts stehen, nicht einmal eine Leerzeile; ein UTF-8-Byte-Order-Mark ist das Einzige, was dort erlaubt ist.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Eine Leerzeile vor der Deklaration
- 2Der Namensraum muss genau diese Zeichenfolge sein, mit http://
- 3Ein unmaskiertes & beendet die Datei für einen Parser
- 4Ein Pfad ist keine URL: Eine URL beginnt mit dem Protokoll
- 5Eine Uhrzeit braucht eine Zeitzone – oder lassen Sie die Uhrzeit weg
Sitemap-Fehler in der Search Console und was sie bedeuten
Die Google Search Console gibt einer Sitemap einen von drei Statuswerten – Erfolgreich, Sitemap kann gelesen werden, enthält aber Fehler oder Konnte nicht abgerufen werden –, nur für bestätigte Properties, und sie sagt nicht, welche Zeile falsch ist. Diese Seite prüft jede öffentliche Sitemap und nennt die Zeile.
Konnte nicht abgerufen werden – auf der Detailseite steht dann „Sitemap konnte nicht gelesen werden“ – heißt, dass Googles Anfrage keine lesbare Datei zurückbrachte: ein 4xx oder 5xx, eine Weiterleitungskette, eine Zeitüberschreitung, eine Firewall, die Google abweist, oder eine Regel in der robots.txt, die den Pfad der Sitemap selbst sperrt. Sitemap kann gelesen werden, enthält aber Fehler heißt, dass die Datei gelesen wurde und etwas darin gegen eine Regel verstößt – die Abbildung daneben zeigt die Meldungen, die Sie am ehesten sehen, und die Zeile hinter jeder davon.
Zwei davon betreffen die Größe, nicht das Format: eine Sitemap, die mehr als 50.000 URLs listet, und ein Sitemap-Index, der mehr als 50.000 Sitemaps listet (Google). Teilen Sie eine zu große Sitemap in Dateien auf, die ein Index listet; ein zu großer Index wird zu mehreren Indexen, die jeweils einzeln eingereicht werden. Auch eine Sitemap, die durch robots.txt gesperrte URLs listet, wird gemeldet, und das ist ein Widerspruch in Ihren eigenen Dateien, kein Formatfehler.
Die drei Statuswerte
Die Meldungen, die Sie am ehesten sehen
- Sitemap konnte nicht gelesen werdenEin 4xx oder 5xx, eine Weiterleitungskette, eine Firewall oder eine robots.txt, die den Pfad der Sitemap selbst sperrt.
- Zu viele URLsMehr als 50.000 URLs in einer Sitemap: ein Fehler, keine Warnung. Teilen Sie sie unter einem Index auf.
- Fehlerhafter AufbauOft ein unmaskiertes & in einer URL. Schreiben Sie es als &.
- Ungültiges DatumEin lastmod, das kein W3C-Datetime ist, oder eine Uhrzeit ohne Zeitzone.
- Ungültige URLEin Leerzeichen, ein Anführungszeichen oder ein anderes Zeichen, das eine URL nicht enthalten kann, oder ein kaputtes Schema wie htp://.
- Sitemap enthält URLs, die von der robots.txt-Datei blockiert werdenDie beiden Dateien widersprechen sich. Entscheiden Sie, welche recht hat.
Nur bestätigte PropertiesDie Search Console meldet eine Sitemap nur für eine Property, die Ihnen gehört. Diese Seite prüft jede öffentliche Sitemap und nennt die Zeile.
Muss lastmod ehrlich sein?
Ja. Google nutzt <lastmod>, „wenn es durchgängig und nachweislich korrekt ist“ – ein Datum, das auf jeder URL gleich ist oder sich bei jedem Schreiben der Datei ändert, ist also schlimmer als gar keins: Es bringt Google bei, das Tag zu ignorieren.
Jeder andere Sitemap-Checker liest das Format eines Datums: ob es ein W3C-Datetime ist, ob die Uhrzeit eine Zeitzone trägt. Das Format ist die leichte Hälfte. Ob das Tag etwas bewirkt, entscheidet die Frage, ob der Wert bedeutet, was er behauptet, und die beiden Erkennungszeichen sind ein einziger Stempel, der sich über alle Einträge wiederholt, und ein Datum, das immer heute ist. Auch Bing plant Crawls mit lastmod und kann Daten ignorieren, die immer aktuell sind.
Deshalb meldet dieser Checker, was die Daten sind, nicht nur, wie sie geschrieben sind: wie viele Einträge eines tragen, das älteste und das neueste, und ob sie ein einziger wiederholter Wert sind. <lastmod> wegzulassen ist gültig und kostet nichts; eines zu erfinden kostet das Tag seine Glaubwürdigkeit für die ganze Website. Markieren Sie die letzte wesentliche Änderung – am Hauptinhalt, an den strukturierten Daten, an den Links –, nicht eine neue Jahreszahl im Copyright (Google).
Gar kein lastmodGültig. Nichts, wonach sich planen lässt, und nichts, dem man misstrauen könnte.
50.000 URLs und 50 MB: Wann Sie aufteilen sollten
Eine Sitemap fasst höchstens 50.000 URLs und 50 MB unkomprimiert. Sobald Sie eine der beiden Grenzen überschreiten, verteilen Sie die URLs auf mehrere Dateien, listen diese in einem Sitemap-Index und reichen dann den Index ein.
Das Größenlimit zählt die entpackte Datei, auch wenn Sie sie als .xml.gz ausliefern; deshalb zeigt dieser Checker die unkomprimierte Größe mit der Übertragungsgröße daneben: Eine Sitemap mit 30 KB kann gzip-komprimiert bei der Übertragung 1,6 KB groß sein, und diese Zahl sagt nichts über das Limit. Naver Search Advisor lehnt Dateien über 10 MB ab, eine koreanische Website hat also eine niedrigere Grenze als das Protokoll.
Ein Index darf bis zu 50.000 Sitemaps listen, nur Dateien auf seiner eigenen Website, und niemals einen weiteren Index: Ein verschachtelter Index wird nicht gelesen. Sprachversionen, die mit xhtml:link angegeben sind, zählen nicht zu den 50.000. Dieser Checker liest in einem Durchlauf den Index und bis zu zehn seiner Dateien, jede mit eigener Zahl, eigener Größe und eigenen Befunden.
6,2 MBBei der Übertragung812 kBgzip macht die Datei zum Senden kleiner; das Limit zählt trotzdem die Größe nach dem Entpacken.sitemap_index.xmlEin Index darf keinen weiteren Index nennenrobots.txt und Ihre Sitemap: die Widersprüche, die Sie Seiten kosten
Ihre Sitemap bittet Suchmaschinen, eine Liste von URLs zu crawlen; die robots.txt sagt ihnen, was sie nicht crawlen dürfen. Widersprechen sich die beiden, gewinnt die robots.txt, und der Sitemap-Eintrag ist verschenkt – und die Search Console meldet es.
Der Status der robots.txt selbst ist das Erste, was zu lesen ist, und kaum jemand meldet, was er bedeutet. Ein 4xx heißt „nicht verfügbar“: Es gibt keine Regeln, also darf alles gecrawlt werden. Ein 5xx oder gar keine Antwort heißt „nicht erreichbar“, und ein Crawler, der RFC 9309 folgt, darf dann auf der Website nichts crawlen; Google liest ein 429 genauso. Dieselbe kaputte Datei führt zu gegenteiligen Folgen, und ein Tool, das über einer unlesbaren robots.txt „keine URLs gesperrt“ anzeigt, liegt immer dann falsch, wenn die Datei mit 5xx oder 429 oder gar nicht geantwortet hat.
Dann kommen die Widersprüche innerhalb einer funktionierenden Datei: URLs, die die Sitemap listet und die robots.txt sperrt, und – leicht zu übersehen – der gesperrte Pfad der Sitemap selbst, womit eine Datei veröffentlicht ist, die kein Crawler lesen darf. Die andere Richtung ist billig und lohnt sich: Eine Sitemap:-Zeile in der robots.txt braucht nirgends ein Konto, und jeder Crawler liest sie.
Der Status und seine Folge
Der Widerspruch
/search/?q=pepperDisallow: /search/Der Eintrag bewirkt nichts, und die Search Console meldet ihn
Und der Pfad der Sitemap selbst, gesperrt: eine veröffentlichte Datei, die kein Crawler lesen darf.
Welche URLs gehören nicht in eine Sitemap?
In eine Sitemap gehören nur kanonische URLs, die Sie in den Suchergebnissen haben wollen, eine pro Seite: endgültige Adressen, die mit 200 antworten, indexierbar sind und nicht durch die robots.txt gesperrt werden. Weiterleitungen, noindex-Seiten, URLs, deren canonical woandershin zeigt, Fehler und Parameter-Varianten gehören nicht hinein.
Eine Sitemap, die eine weiterleitende URL listet, schickt einen Crawler einen Schritt weiter, als nötig wäre, und Google verlangt stattdessen die URL, bei der die Weiterleitung endet. Eine noindex-Seite in einer Sitemap ist ein glatter Widerspruch: Die Datei sagt „indexieren“, die Seite sagt „nicht indexieren“. Die Seite gewinnt, und der Eintrag bewirkt nichts.
Nichts davon ist fatal – jede URL in einer Sitemap ist ein Vorschlag, und was indexiert wird, entscheidet weiterhin Google –, aber jeder falsche Eintrag ist einer, den eine Suchmaschine geringer zu gewichten lernt. Deshalb ruft dieser Checker eine Stichprobe der URLs ab, statt nur die Datei zu parsen: Das Parsen kann Ihnen nicht sagen, dass eine gelistete Seite inzwischen mit 404 antwortet.
/shop/raised-beds/GültigIndexiert wie gelistet/shop/raised-bed/Weiterleitungverschenkt/shop/?sort=priceCanonical woandershinverschenkt/tags/autumn/noindexverschenkt/shop/old-kit/404verschenkt/search/?q=pepperGesperrtverschenktBild-, Video- und hreflang-Einträge
Ein <url>-Eintrag kann mehr tragen als eine Adresse: die Bilder der Seite, ihre Versionen in anderen Sprachen sowie Video- oder News-Metadaten, jeweils in einem eigenen Namensraum innerhalb dieses Eintrags.
Bilder nutzen Googles Bild-Namensraum, bis zu 1.000 pro Seite; es zählen nur noch <image:image> und <image:loc>, denn caption, title, license und geo_location wurden 2022 abgeschafft. Dieser Checker zählt die gefundenen Bild-Einträge und zeigt sie pro URL.
Sprachversionen nutzen xhtml:link mit einem hreflang-Code: eine Sprache nach ISO 639-1 mit optionaler Region nach ISO 3166-1, nie eine Region allein. Jede Version einer Seite muss jede andere Version auflisten, sich selbst eingeschlossen, sonst ignoriert Google die Gruppe. Alternates zählen nicht zum Limit von 50.000 URLs: Zwölf Sprachversionen in jedem Eintrag multiplizieren die Zahl also nicht mit zwölf.
https://www.example.org/guides/raised-beds/2026-09-143bis zu 1.000 pro Seiteen · de · frjede Version listet jede Version, sich selbst eingeschlossenAlternates zählen nicht zu den 50.000
Wie oft lesen Suchmaschinen Ihre Sitemap?
Google liest eine Sitemap nach einem eigenen Zeitplan, den es nicht veröffentlicht: Das Einreichen ist ein Hinweis, kein Befehl. Bing liest sie, sobald es sie findet, und danach meist mindestens einmal am Tag. Keine der beiden liest eine Datei öfter, weil Sie darum bitten.
Die alten anonymen Pings gibt es nicht mehr: Bing hat bing.com/ping am 13. Mai 2022 abgeschaltet, und Google hat im Juni 2023 angekündigt, dass sein Ping nicht mehr funktionieren wird; heute antwortet er mit 404. Ein Tool, das noch immer anbietet, „Google anzupingen“, tut gar nichts.
Was den nächsten Crawl einer geänderten Seite tatsächlich vorzieht, ist ein genaues lastmod – der ganze Grund, warum die Ehrlichkeit des Tags zählt – und IndexNow für einzelne geänderte URLs: Eine Übermittlung erreicht Bing, Yandex, Naver, Seznam und andere, Google allerdings nicht. Eine unveränderte Sitemap von Hand erneut einzureichen bringt nichts.
Ein genaues lastmod zieht den nächsten Crawl einer geänderten Seite vor
Brauchen Sie überhaupt eine Sitemap?
Eine kleine Website, deren Seiten alle untereinander verlinkt sind, braucht womöglich keine: Google beziffert das auf etwa 500 Seiten oder weniger. Am meisten profitieren große Websites, neue Websites mit wenigen Links von außen und Websites mit vielen Bildern oder Videos.
Googles eigener Einsteigerleitfaden nennt eine Sitemap optional, und das Einreichen ist ein Hinweis, keine Anweisung: Es verschafft einer Seite kein Ranking und garantiert keine Indexierung. Was eine Sitemap leistet: Ein Crawler erfährt sicher, dass eine URL existiert, und das zählt am meisten bei Seiten, die Ihre eigenen Links nicht erreichen.
Wenn Sie eine haben, sollte sie stimmen. Eine Sitemap voller Weiterleitungen, noindex-Seiten und durch robots.txt gesperrter URLs ist nicht neutral – sie ist eine Liste, der eine Suchmaschine immer weniger traut. Die Prüfung kostet eine Minute; eine neue aus Ihrer eigenen Website zu erstellen einen Crawl.
Quellen
- sitemaps.org-Protokoll und seine FAQ: das Format, die Pflicht- und die optionalen Tags, die Limits von 50.000 URLs und 50 MB, der Index und die Regel zum Speicherort
- Google Search Central: Sitemap erstellen, große Sitemaps, der Sitemaps-Bericht und seine Fehler, lokalisierte Versionen sowie lastmod und der abgeschaltete Ping
- Bing: das lastmod-Tag (2023), Sitemaps in der KI-gestützten Suche (2025) und der entfernte Ping (2022)
- RFC 9309, der robots.txt-Standard: was ein 4xx und ein 5xx für einen Crawler bedeuten
- Naver Search Advisor: Feeds und IndexNow
- große Websites
- neue Websites mit wenigen Links von außen
- viele Bilder oder Videos
- Seiten, die kein interner Link erreicht
FAQ zum Sitemap Checker
Wie prüfe ich, ob meine XML-Sitemap gültig ist?
Was sind die häufigsten Sitemap-Fehler?
Warum meldet die Search Console „Sitemap konnte nicht gelesen werden“?
Ist es ein Problem, wenn eine URL aus meiner Sitemap in der robots.txt gesperrt ist?
Muss lastmod genau sein?
Wie viele URLs darf eine Sitemap enthalten?
Nutzt Google priority und changefreq?
Ist dieser Sitemap Checker kostenlos, und gibt es ein URL-Limit?
Was unterscheidet diesen Checker von der Google Search Console?
Was ist ein Sitemap-Index, und darf er einen weiteren Index nennen?
Muss meine Sitemap in der robots.txt stehen?
Bringt eine Sitemap meine Seiten in den Index?
Fehlt Ihnen etwas?Funktion oder neues Tool vorschlagen
Weitere Tools zum Crawlen und für SEO
Robots.txt-Checker
Die robots.txt jeder Website abrufen, testen, ob eine URL für Googlebot oder KI-Crawler blockiert ist, und Syntaxfehler finden
Sitemap-Generator
Ihre Website crawlen und eine XML-Sitemap, eine HTML-Sitemap und einen visuellen Website-Baum erhalten
Link-Analyse
Alle Links einer Webseite mit Dofollow/Nofollow-Erkennung und HTTP-Statusprüfung analysieren
Redirect Checker
URL-Weiterleitungen, Weiterleitungsketten und HTTP-Statuscodes für SEO prüfen
HTTP-Header-Checker
HTTP-Antwort-Header und Sicherheits-Header-Bewertung analysieren
Website-Down-Checker
Ist die Seite für alle down oder nur für Sie? Prüfen Sie jede Website von 11 Orten und Ihrer eigenen Verbindung aus, mit Live-Screenshot
CMS Detector
Welches CMS, Theme, welche Plugins und Technologien eine Website nutzt, mit Nachweis für jedes