Alle anderen Crawler
User-agent: *
Gilt für jeden Crawler, der keine eigene Gruppe hat.
- Erlaubt die ganze Website.
Google ignoriert es, Bing liest es.
Design
Erstellen Sie mit diesem Robots.txt Generator auf Deutsch eine robots.txt, der Sie vertrauen können: Jede Regel wird erklärt, während Sie sie eingeben, unser robots.txt-Checker liest die Datei nach RFC 9309 und nach Googles eigener Lesart gegen, und noch vor dem Veröffentlichen sehen Sie für jeden Crawler und jeden Pfad ein Live-Urteil.
Eine Datei pro Host und Protokoll: www.example.com und example.com brauchen jeweils eine eigene.
Quelle: RFC 9309, gelesen am 26. Oktober 2026.
Gilt für jeden Crawler, der keine eigene Gruppe hat.
Legen Sie fest, was jeder bekannte Crawler bekommt. Ein Crawler mit eigener Gruppe liest nur diese Gruppe.
Diese Crawler crawlen, um einen Suchindex aufzubauen. Gesperrte Seiten können trotzdem über Links von anderswo aufgeführt werden, nur wird nichts aus ihnen gelesen.
Diese Crawler sammeln Seiten, um Modelle zu trainieren. Ein eigenes Token erlaubt es, das Training abzulehnen und trotzdem in Suchergebnissen zu erscheinen.
Diese Crawler rufen Seiten ab, um Fragen mit einem Link zurück zu Ihnen zu beantworten.
Diese Crawler rufen eine Seite ab, weil eine Person danach gefragt hat; manche Betreiber sagen deshalb, dass sie robots.txt ignorieren können.
Wer diese sperrt, sperrt eine Person aus, keinen Crawl: Bittet jemand einen KI-Assistenten, eine Ihrer Seiten zu öffnen, liest ein Assistent, der die Datei befolgt, sie für diese Person nicht. Sperren Sie die Trainings-Crawler oben, wenn es Ihnen um das Training geht.
Linkvorschauen, Tools für Website-Inhaber, Werbeprüfungen, Archive und Crawler, deren Betreiber eine andere oder gar keine Aufgabe nennen.
Ihre robots.txt/robots.txt
User-agent: *Allow: /FehlerWarnungHinweis23 B von 500 KiB
1 Warnung
Was zu tun ist Die Sitemap-Zeile ist die günstigste Zeile der Datei, und jeder Crawler liest sie. Fügen Sie Sitemap: mit der vollständigen Adresse Ihrer Sitemap hinzu.
Wählen Sie einen Crawler und einen Pfad: Das Urteil, die Regel, die es fällt, und die Gruppe, die der Crawler liest, kommen aus dem Matcher des Robots.txt Checkers selbst.
Dieser Crawler darf die URL abrufen.
User-agent: *beginnt in Zeile 1
Keine Gruppe nennt diesen Crawler, deshalb gilt die *-Gruppe.
Allow: /Zeile 2
/any-page
/
Verglichen werden nur Pfad und Query, Byte für Byte nach der Prozentkodierung. Host, Schema und Fragment sind nie Teil einer Regel.
Schreiben Sie die Regeln, speichern Sie sie als reine Textdatei namens robots.txt in UTF-8 und laden Sie sie in die oberste Ebene Ihrer Website hoch, sodass sie unter https://example.com/robots.txt abrufbar ist. Einreichen müssen Sie nichts: Crawler fragen diese Adresse von selbst ab.
Google fasst es in drei Sätzen zusammen: „Die Datei muss den Namen ‚robots.txt‘ haben. Die Website darf nur genau eine robots.txt-Datei enthalten. Die robots.txt-Datei muss sich im Stammverzeichnis des Websitehosts befinden, für den sie eingerichtet wird.“ Die Datei muss „eine UTF-8-codierte Textdatei“ sein, und ist sie hochgeladen, „finden und verwenden die Google-Crawler sie automatisch“.
Der Generator oben beginnt mit einer Vorlage, erklärt jede Regel, während Sie sie eingeben, und liest das Ergebnis mit dem Parser und dem Matcher unseres robots.txt-Checkers gegen, bevor Sie es kopieren. Der Download heißt robots.txt: UTF-8 ohne Byte Order Mark, nur LF-Zeilenumbrüche und weder ein Datum noch ein Kommentar, um den Sie nicht gebeten haben.
https://example.com/robots.txtEinen Schritt zum Einreichen gibt es nicht: Die Crawler von Google finden die Datei von selbst.
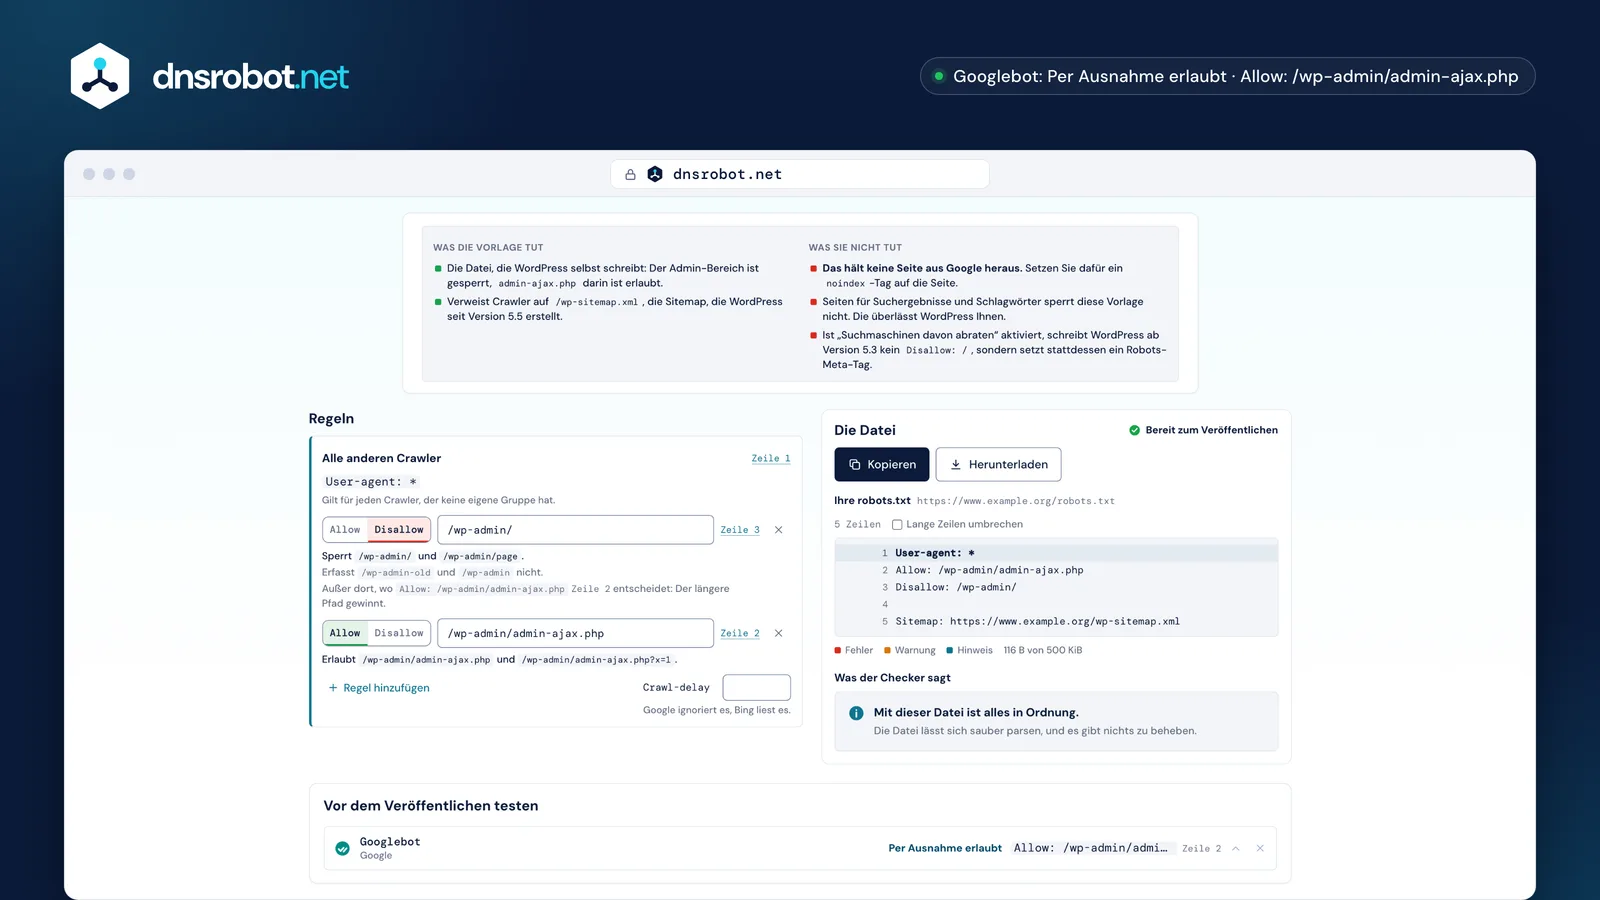
 Was die Vorlage tutUnd was sie nicht tut: Keine dieser Vorlagen hält eine Seite aus Google heraus, und jede sagt das auch.Jede Regel erklärtDie Pfade, die eine Regel sperrt, und die, die sie verfehlt, aus demselben Matcher, der jedes Urteil fällt, dazu die längere Regel, die eine Ausnahme schafft.Die Datei und ihre BefundeDie Datei mit ihren Zeilennummern, gegengelesen von der Prüfung des Robots.txt Checkers, bevor Sie sie kopieren.Das UrteilWählen Sie einen Crawler und einen Pfad: erlaubt oder gesperrt, die Regel, die entschieden hat, mit ihrer Zeile, und die Gruppe, die der Crawler liest.
Gruppen und Sitemap-Zeilen. Eine Gruppe beginnt mit einer oder mehreren User-agent-Zeilen, die Crawler nennen, gefolgt von den Allow- und Disallow-Regeln, die diese Crawler befolgen; eine Sitemap-Zeile steht für sich, außerhalb jeder Gruppe.
RFC 9309 definiert eine Gruppe als „eine oder mehrere user-agent-Zeilen, auf die eine oder mehrere Regeln folgen“, und ein Crawler befolgt genau eine Gruppe: die, die sein eigenes Produkt-Token nennt, oder die *-Gruppe, wenn keine das tut. Google liest vier Felder und keine anderen: user-agent, allow, disallow und sitemap.
Bei Feldnamen spielt die Groß- und Kleinschreibung keine Rolle, bei Pfaden schon: In Googles eigenem Beispiel gilt disallow: /file.asp für /file.asp, „aber nicht für“ /FILE.asp. Eine Sitemap:-Zeile muss eine vollständige Adresse mit Protokoll und Host sein; dieser Generator lehnt jede andere Form ab und sagt, warum.
User-agent: *Beginnt eine Gruppe für jeden Crawler ohne eigene GruppeDisallow: /cart/Ein Pfad, den diese Crawler nicht abrufen dürfenAllow: /cart/helpEine Ausnahme: länger als das Disallow, also gewinnt sie User-agent: GPTBotBeginnt eine Gruppe, die zwei Crawler nenntUser-agent: ClaudeBotDisallow: /Beide sind für die ganze Website gesperrt Sitemap: https://www.example.org/sitemap.xmlAußerhalb jeder Gruppe: eine vollständige Adresse* und $: Wie eine Regel greiftPassen mehrere Regeln auf eine URL, gewinnt die mit dem längsten Pfad, egal welcher Art sie ist, und bei Gleichstand gewinnt Allow. * steht für eine beliebige Zeichenfolge, $ markiert das Ende der URL; sonst hat nichts in einem Pfad eine besondere Bedeutung.
RFC 9309: „Der spezifischste Treffer MUSS verwendet werden. Der spezifischste Treffer ist der mit den meisten Oktetten“, und „wenn eine allow-Regel und eine disallow-Regel gleichwertig sind, SOLLTE die allow-Regel verwendet werden.“ Die Datei von WordPress funktioniert genau so: Disallow: /wp-admin/ schließt den Ordner, und das längere Allow: /wp-admin/admin-ajax.php öffnet eine Datei darin.
Eine Regel ohne $ ist ein Präfix, Disallow: /admin sperrt also auch /administrator; setzen Sie den Schrägstrich ans Ende (/admin/), wenn Sie den Ordner meinen. Unter jeder Regel zeigt der Editor oben die Pfade, die sie erfasst, und einige, die sie nicht erfasst, aus dem Matcher, der jedes Urteil fällt, und er markiert eine Regel, gegen die sich immer eine andere durchsetzt.
* und $ und was jedes Muster wirklich erfasst/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ und + sind gewöhnliche Zeichen. In der robots.txt gibt es keine regulären Ausdrücke.
/admin/report.pdfDas Allow gewinnt: Es deckt mehr vom Pfad ab.
Disallow: /files/7 ZeichenAllow: /files/7 ZeichenGleiche Länge, also gewinnt das Allow. Die „am wenigsten restriktive“ Regel, wie Google es ausdrückt.
Alle drei liefern bereits eine aus, und die Vorlagen oben schreiben, was die eigene Dokumentation jeder Plattform beschreibt: WordPress sperrt seinen Admin-Bereich, erlaubt aber admin-ajax.php, Shopify sperrt Warenkörbe, Checkouts sowie gefilterte oder sortierte Kollektionen, und Next.js liefert die Datei aus, die Sie in app/robots.txt ablegen.
WordPress schreibt seine Datei im Code, in do_robots(): User-agent: *, ein Disallow für den Admin-Pfad und ein Allow für admin-ajax.php, dazu auf einer öffentlichen Website seit WordPress 5.5 eine Sitemap:-Zeile für /wp-sitemap.xml. Ist „Suchmaschinen davon abraten“ aktiviert, schreibt WordPress ab Version 5.3 kein Disallow: / mehr, sondern setzt stattdessen ein Robots-Meta-Tag.
Shopify sagt, dass seine Standarddatei „für die meisten Shops funktioniert“. Eine Datei zum Hochladen gibt es nicht: Wer sie ändern will, bearbeitet das Template robots.txt.liquid des Themes, was Shopify „eine nicht unterstützte Anpassung“ nennt. Next.js liefert app/robots.txt so aus, wie die Datei geschrieben ist, oder erzeugt sie aus app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlVon WordPress selbst geschrieben. Ändern lässt sie sich per Plugin oder mit dem Filter robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlShopifys Standard. Ändern lässt er sich im Template robots.txt.liquid des Themes.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlIhre eigene Datei in app/robots.txt oder app/robots.ts, ausgeliefert unter /robots.txt.
Eine Gruppe, die den Crawler nennt, mit Disallow: / darunter, wirkt bei jedem Crawler, dessen Betreiber sagt, dass er die robots.txt befolgt, und nur bei diesen. Das ist eine Bitte, die der Crawler respektiert, kein Schloss: Ein Crawler, der die Datei ignoriert, kann trotzdem jede Seite abrufen.
Die meisten KI-Unternehmen betreiben mehr als einen Crawler, entscheiden Sie also je Aufgabe. Wer einen Trainings-Crawler wie GPTBot oder ClaudeBot sperrt, sperrt den, der Seiten für Modelle sammelt; wer einen Antwort-Crawler wie OAI-SearchBot oder PerplexityBot sperrt, verschwindet auch aus den Links, die diese Assistenten zeigen. Googles Trainings-Token ist nicht Googlebot: „Google-Extended hat keinen Einfluss auf die Aufnahme einer Website in die Google Suche und wird auch nicht als Ranking-Signal in der Google Suche verwendet.“
Die dritte Art ist anders. ChatGPT-User, Claude-User, Perplexity-User und Amzn-User rufen eine einzelne Seite ab, weil eine Person einen Assistenten gebeten hat, sie zu öffnen; wer sie sperrt, sperrt also diese Person aus, und manche ihrer Betreiber sagen, dass diese Abrufe die robots.txt ohnehin ignorieren können. Die Crawler-Liste oben führt sie deshalb in einem eigenen Abschnitt.
GPTBotBefolgtOAI-SearchBotBefolgtChatGPT-UserKann ignorierenClaudeBotBefolgtClaude-SearchBotBefolgtClaude-UserBefolgtPerplexityBotBefolgtPerplexity-UserKann ignorierenGoogle-ExtendedNur TokenKein solcher CrawlerKein solcher CrawlerApplebot-ExtendedNur TokenKein solcher CrawlerKein solcher Crawlermeta-externalagentBefolgtmeta-webindexerBefolgtmeta-externalfetcherKann ignorierenAmazonbotBefolgtKein solcher CrawlerAmzn-UserKann ignorierenDie Datei bittet Crawler, eine Seite nicht abzurufen; sie bittet keine Suchmaschine, die Seite nicht aufzulisten. Verlinken andere Seiten auf sie, kann die URL laut Google „möglicherweise dennoch indexiert und ohne Snippet in den Suchergebnissen angezeigt werden“. Um eine Seite herauszuhalten, nutzen Sie noindex und lassen die Seite crawlbar, damit das Tag gelesen werden kann.
Die Search Console nennt das „Indexiert, obwohl durch robots.txt-Datei blockiert“. Und Google sagt es ausdrücklich: „Damit die Regel noindex wirksam wird, darf die Seite oder Ressource nicht durch eine robots.txt-Datei blockiert werden“. Das eigene noindex einer gesperrten Seite wird nie gesehen, weil der Crawler die Seite nie abruft.
Deshalb sagt jede Vorlage oben, was sie nicht tut. Das Disallow: / der Staging-Vorlage hält höfliche Crawler fern, aber eine Staging-URL, auf die irgendwo verlinkt wird, kann trotzdem aufgelistet werden: Schützen Sie das Staging mit einem Passwort, und bringen Sie diese Zeile nie auf die Live-Website.
<meta name="robots" content="noindex">Nie gelesenUm eine Seite herauszuhalten: den Crawler hereinlassen und noindex verwenden, oder eine Anmeldung verlangen.
Im Wurzelverzeichnis des Hosts, für den sie gilt, als /robots.txt, eine Datei pro Host und Protokoll. https://example.com/robots.txt sagt nichts über https://www.example.com oder https://shop.example.com: Jeder dieser Hosts braucht eine eigene Datei, und eine robots.txt in einem Ordner wird nie gelesen.
Google: „Die robots.txt-Datei muss, unter Berücksichtigung der unterstützten Protokolle, im Stammverzeichnis der Website abgelegt werden.“ Der robots.txt-Bericht der Search Console listet die Dateien der 20 wichtigsten Hosts einer Property getrennt auf, HTTP und HTTPS jeweils für sich gezählt.
Geben Sie oben im Generator Ihre Website ein: Er nennt die genaue Adresse, unter der die Datei abrufbar sein muss, füllt die Sitemap:-Zeile für diesen Host aus und verlinkt auf den Robots.txt Checker, der die Live-Datei liest, sobald sie online ist.
https://example.com/robots.txtJede URL auf https://example.comhttps://www.example.com/robots.txtNur www.example.com: ein eigener Hosthttp://example.com/robots.txtNur die http://-Website: ein eigenes Protokollhttps://shop.example.com/robots.txtNur shop.example.comhttps://example.com/blog/robots.txtNichts: Eine robots.txt in einem Ordner wird nie gelesenGoogle liest keine davon. Crawl-delay liest Bing, Clean-param Yandex, Host steht weder im Standard noch in Googles Liste, und Cloudflares Content-Signal sagt, wofür Ihre Inhalte verwendet werden dürfen, nicht, was gecrawlt werden darf.
Google nennt seine vier Felder und ergänzt: „andere Felder wie crawl-delay werden nicht unterstützt“. Bings eigener Blog sagt: „Die crawl-delay-Anweisung akzeptiert als Werte nur positive ganze Zahlen“, deshalb lehnt der Editor einen Dezimalwert ab, statt ihn zu schreiben. Bings aktuelle Hilfeseite ließ sich nicht lesen, um einen Wertebereich oder eine Einheit zu bestätigen, deshalb nennt diese Seite keines von beiden.
Keine davon macht eine Datei kaputt: RFC 9309 verlangt, dass das Parsen anderer Einträge „das Parsen ausdrücklich definierter Einträge NICHT beeinträchtigen DARF“. Von den vieren schreibt der Generator nur Crawl-delay, mit dem Hinweis, wer es liest.
User-agentLiest sieLiest sieLiest sieAllowLiest sieLiest sieLiest sieDisallowLiest sieLiest sieLiest sieSitemapLiest sieLiest sieLiest sieCrawl-delayIgnoriert sieLiest sieNicht bestätigtClean-paramIgnoriert sieIgnoriert sieLiest sieHostIgnoriert sieIgnoriert sieNicht bestätigtnoindexIgnoriert sieNicht bestätigtNicht bestätigtContent-SignalIgnoriert sieNicht bestätigtNicht bestätigtZweimal. Zuerst hier, mit Vor dem Veröffentlichen testen oben: Wählen Sie einen Crawler und einen Pfad und sehen Sie die Regel, die entscheidet. Dann, nach dem Hochladen, mit dem Robots.txt Checker auf der Live-Datei, denn was der Server antwortet, zählt genauso viel wie das, was in der Datei steht.
Eine Datei, die mit 404 antwortet, gilt als gar keine Datei, jeder Crawler darf also alles abrufen; antwortet sie mit 500 oder 503, darf ein Crawler, der dem Standard folgt, nichts abrufen. RFC 9309 §2.3.1.4: Dann „MUSS der Crawler von einem vollständigen Disallow ausgehen“. Google entschärft das mit einer eigenen Stufenfolge, die die Abbildung zeigt.
Googles eigener robots.txt-Tester ist Geschichte: Search Central kündigte am 15. November 2023 sein Aus an, und der robots.txt-Bericht, der ihn ersetzt hat, zeigt die Datei, die Google abgerufen hat, ohne eine URL gegen eine Regel zu testen. Diesen Test machen Vor dem Veröffentlichen testen im Generator oben und der robots.txt-Checker.
200Befolgt die Regeln in der Datei.301, 302Folgt mindestens fünf Hops und bricht dann ab. Google wertet die Datei danach als 404.403, 404Crawlt alles, als gäbe es keine Datei.429Crawlt nichts. Google zählt das zu den 5xx-Antworten, nicht zu den 4xx.500, 503Crawlt laut Standard gar nichts.Kein solcher NameEs gibt keine Website zu lesen, also gibt es kein Urteil.Die teuren Fehler sind jeweils eine kurze Zeile: ein Disallow: /, das vom Staging übrig geblieben ist, ein Präfix, das weiter reicht als gewollt, eine Sitemap:-Zeile mit einem Pfad, ein Pfad ohne führenden Schrägstrich und eine noindex-Zeile, die Google seit 2019 nicht mehr liest.
Jeder davon wird hier abgefangen, bevor Sie die Datei kopieren. Die Prüfung des Checkers läuft beim Tippen mit, und ihre Befunde stehen unter der Datei; eine Zeile, die ein Crawler ablehnen würde, wird gar nicht erst geschrieben, und der Editor sagt direkt an der Eingabe, warum sie ausgelassen wurde.
Ein Fehler ist ein Paar, keine einzelne Zeile: eine URL, die hier gesperrt ist und auf der Seite zugleich noindex trägt. Der Crawler ruft die Seite nie ab, sieht also nie das noindex, und die URL kann in den Suchergebnissen bleiben. Entscheiden Sie sich: das Crawlen sperren, oder den Crawler hereinlassen und ihm sagen, dass er nicht indexieren soll.
Disallow: /Vom Staging übrig geblieben: Die ganze Live-Website ist für jeden Crawler gesperrt.Disallow: /adminSperrt auch /administrator und /admin-tools. Setzen Sie den Schrägstrich ans Ende.Allow: / unter User-agent: *Ein Crawler, der irgendwo in der Datei eine eigene Gruppe hat, liest es nie.Sitemap: /sitemap.xmlEine Sitemap-Zeile muss eine vollständige Adresse mit Host sein.Disallow: adminEin Pfad beginnt bei /. Diese Regel passt auf nichts.noindex: /private/Seit 2019 tot. Die Seite bleibt crawlbar und indexierbar.*-Gruppe, in der Ihr Allow steht. Der Editor oben markiert eine Regel, gegen die sich immer eine andere durchsetzt, und Vor dem Veröffentlichen testen nennt die entscheidende Regel und die Gruppe, die der Crawler gelesen hat.Fehlt Ihnen etwas?Funktion oder neues Tool vorschlagen
Die robots.txt jeder Website abrufen, testen, ob eine URL für Googlebot oder KI-Crawler blockiert ist, und Syntaxfehler finden
Ihre Website crawlen und eine XML-Sitemap, eine HTML-Sitemap und einen visuellen Website-Baum erhalten
Die XML-Sitemap einer Website finden und validieren: Syntax, URL-Limits, lastmod-Daten, robots.txt-Konflikte und defekte oder umgeleitete URLs
Title, Meta Description, Canonical, hreflang, Open-Graph- und X-Card-Tags einer Seite prüfen, mit Vorschau für Google und soziale Netzwerke
HTTP-Antwort-Header und Sicherheits-Header-Bewertung analysieren
Browser, Betriebssystem, Gerätetyp, Rendering-Engine und CPU-Architektur aus Ihrem User Agent String erkennen