











XML Sitemap Generator
Ein kostenloser Sitemap Generator, der Ihre Website wie eine Suchmaschine crawlt: Er nimmt nur die Seiten auf, die in die Suchergebnisse gehören, und sagt Ihnen bei jeder anderen URL, warum sie fehlt. So lässt sich eine XML-Sitemap erstellen, die stimmt.
Eine Domain genügt auch: example.org startet auf der Startseite.
- robots.txtZuerst gelesen, befolgt
- Ihre SitemapGefunden und verglichen
- GecrawltBis zu 500 Seiten, 3 gleichzeitig
- Entschiedennoindex, canonical, Weiterleitungen
XML-Sitemap erstellen: Schritt für Schritt
Geben Sie oben Ihre Startseite ein und wählen Sie „Sitemap erstellen“. Der Sitemap-Crawler liest die robots.txt, folgt Ihren Links wie eine Suchmaschine, behält nur die Seiten, die hineingehören, und gibt Ihnen eine sitemap.xml für das Wurzelverzeichnis Ihrer Website.
Eine Seite gehört hinein, wenn sie mit 200 antwortet, HTML ist, kein noindex trägt, sich selbst als canonical nennt und nicht durch die robots.txt gesperrt ist. Jede andere URL landet unter Ausgelassen samt Grund – so unterscheiden Sie ein Versehen von einer Absicht.
Laden Sie die Datei ins Wurzelverzeichnis, https://www.example.org/sitemap.xml: Eine Sitemap darf nur URLs aus ihrem eigenen Ordner und darunter auflisten, deshalb deckt das Wurzelverzeichnis die ganze Website ab (Google). Nehmen Sie dann eine Sitemap:-Zeile in die robots.txt auf und reichen Sie die Datei in der Google Search Console und den Bing Webmaster Tools ein.
1Startseite eingeben
example.orgoder eine Liste von URLs einfügen2Wir crawlen und entscheiden
robots.txt 200499/500412 in der Sitemap · 87 ausgelassen3Datei herunterladen
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML oder CSV4Hochladen und einreichen
/sitemap.xmlSitemap: https://www.example.org/…Wurzelverzeichnis · robots.txt · Search Console



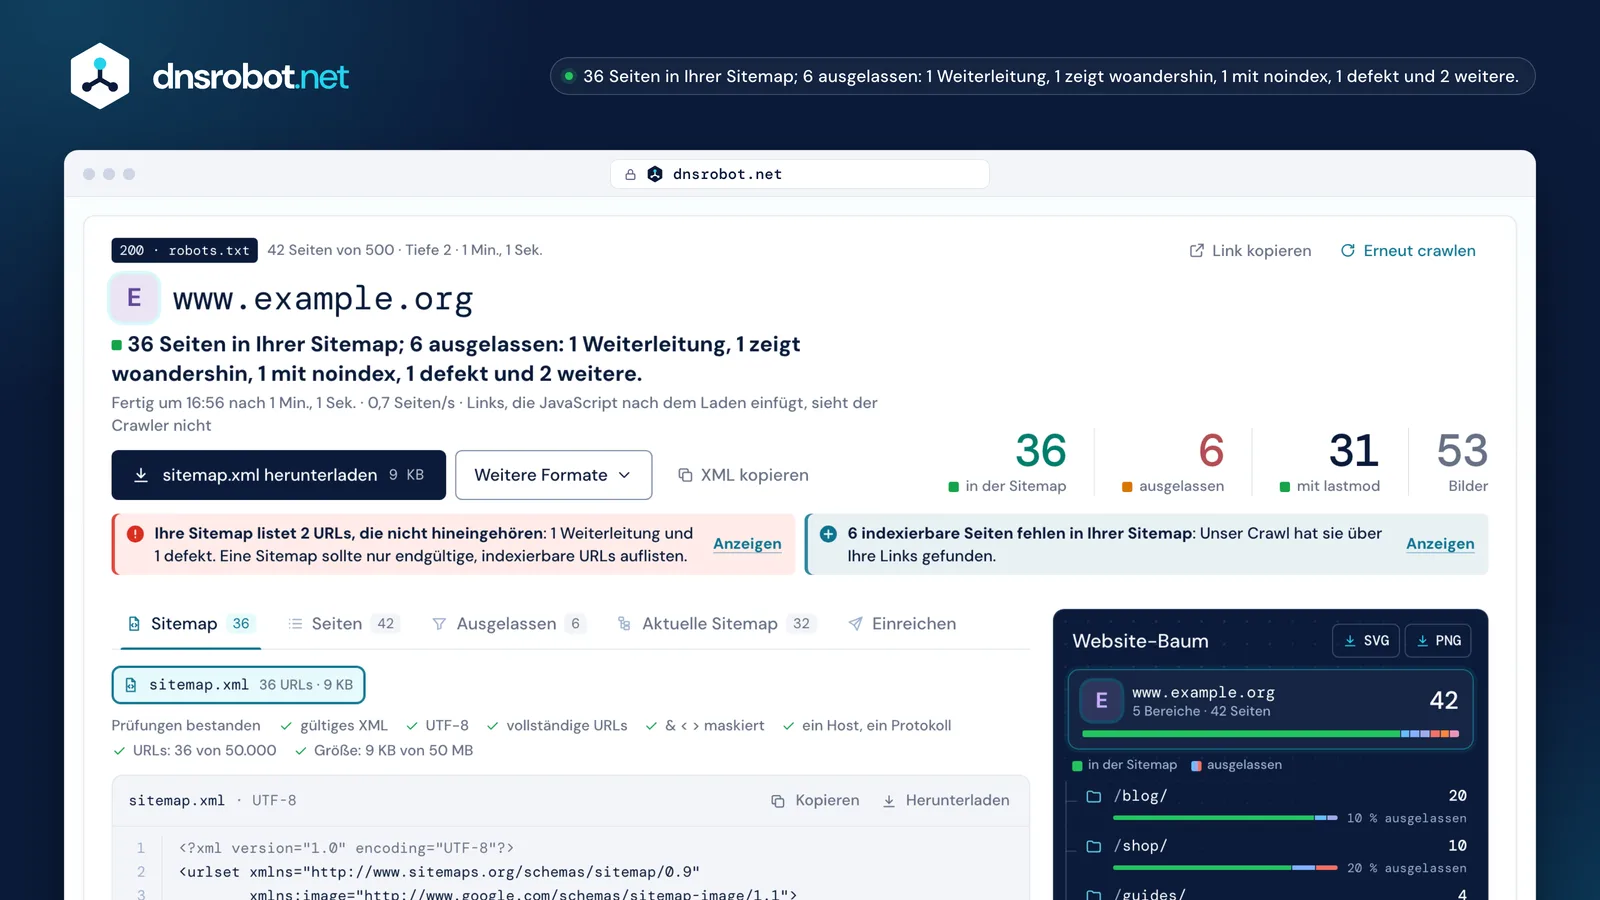
 Das UrteilWie viele Seiten hineinkommen, wie viele ausgelassen werden und warum – in einem Satz. Die großen Zahlen wiederholen es.Downloadsitemap.xml, oder ein ZIP mit allen Dateien und dem Index, wenn geteilt wird; dazu .xml.gz, TXT, eine HTML-Sitemap und eine CSV aller gecrawlten Seiten.HinweiseDie veralteten Einträge Ihrer aktuellen Sitemap, die Seiten, die ihr fehlen, und woher jedes lastmod-Datum stammt.Der Website-BaumJeder Bereich mit seiner Seitenzahl und dem ausgelassenen Anteil. Wählen Sie einen Ast, um die Seiten zu filtern; herunterladen als SVG oder PNG.
Wie sieht eine XML-Sitemap aus? Ein Sitemap-Beispiel
Eine XML-Sitemap ist eine UTF-8-Datei mit einem <url>-Eintrag pro Seite. Pflicht sind nur <urlset>, <url> und <loc>, alles andere ist freiwillig. Hier ein Sitemap-Beispiel, Zeile für Zeile erklärt.
Jedes <loc> ist eine vollständige, absolute URL, die mit dem Protokoll beginnt und unter 2.048 Zeichen bleibt, wobei & als & geschrieben wird (sitemaps.org). <lastmod> ist das Datum der letzten Änderung, im W3C-Format wie 2026-09-14; eine Uhrzeit ist freiwillig, braucht dann aber eine Zeitzone.
Der Namensraum bleibt auf http://, auch auf einer https-Website: Er ist ein Name für Parser, keine Adresse, die jemand abruft. <changefreq> und <priority> sind erlaubt, aber Google und Bing ignorieren sie.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, in der ersten Zeile angegeben
- 2Der Namensraum: http://, nicht https://
- 3Eine absolute URL, & maskiert als &
- 4Das echte Änderungsdatum – oder gar kein lastmod
- 5Von Google und Bing ignoriert
- 6Kein lastmod: Eine Startseite versammelt nur andere Seiten
Welche Seiten gehören in eine Sitemap – und warum fehlen manche?
Die kanonischen URLs, die Sie in den Suchergebnissen haben wollen, eine pro Seite: endgültige URLs, die mit 200 antworten, indexierbar sind und nicht durch die robots.txt gesperrt werden. Alles andere bleibt draußen, mit dem Grund daneben.
Eine Weiterleitung, eine noindex-Seite oder eine URL, deren canonical woandershin zeigt, schickt Suchmaschinen eine widersprüchliche Nachricht: Die Sitemap sagt „nimm das auf“, während die Seite etwas anderes sagt. Nennen Sie nicht eine URL in der Sitemap und eine andere in rel=canonical (Google); die Search Console meldet außerdem Sitemaps, die durch robots.txt gesperrte URLs auflisten.
Jede URL in einer Sitemap ist nur ein Vorschlag; welche Seiten Duplikate sind, entscheidet weiterhin Google. Deshalb zeigt dieser Generator zu jeder ausgelassenen Seite den Grund: Ein gewolltes noindex ist in Ordnung, ein noindex auf Ihrem besten Produkt nicht.
lastmod, changefreq und priority: Was lesen Suchmaschinen?
Google und Bing ignorieren changefreq und priority. Beide nutzen lastmod, aber nur, solange es stimmt: Ein Datum, das sich bei jedem Crawl ändert, bringt ihnen bei, ihm nicht mehr zu glauben.
Google nutzt lastmod, „wenn es durchgängig und nachweislich korrekt ist“, und es soll die letzte wesentliche Änderung markieren – am Hauptinhalt, an den strukturierten Daten oder an den Links –, nicht eine neue Jahreszahl im Copyright (Google). Ein lastmod, das alten Seiten immer wieder frische Änderungen andichtet, verliert sein Vertrauen. Bing plant Crawls mit lastmod und darf Daten übergehen, die immer heute sind. Yandex liest weiterhin alle drei Angaben.
Dieser Generator schreibt deshalb nie das heutige Datum. Er holt lastmod aus den Daten der Seite selbst, in der Reihenfolge unten, und lässt es weg, wenn es keines gibt: Weglassen ist völlig in Ordnung, etwa bei einer Startseite oder einer Kategorieseite, die nur andere Seiten versammelt.
| XML-Tag | Bing | Yandex | |
|---|---|---|---|
| lastmod | nutzt sie, wenn sie stimmt | nutzt sie, wenn sie stimmt | liest sie |
| changefreq | ignoriert sie | ignoriert sie | liest sie |
| priority | ignoriert sie | ignoriert sie | liest sie |
Wie „heute“ für jede Seite aussieht
412 Einträge, ein Datum: ein Erstellungsdatum, kein Änderungsdatum.
50.000 URLs, 50 MB und der Sitemap-Index
Eine Sitemap fasst höchstens 50.000 URLs und 50 MB unkomprimiert. Sobald Sie die erste der beiden Grenzen überschreiten, teilen Sie die URLs auf mehrere Dateien auf und listen diese in einem Sitemap-Index; eingereicht wird dann der Index.
Gezählt wird die unkomprimierte Datei, auch wenn Sie sie als .xml.gz ausliefern – gzip, nicht ZIP (sitemaps.org). Ein Index darf bis zu 50.000 Sitemaps auflisten, nur Dateien derselben Website, in seinem Ordner oder darunter, und niemals einen weiteren Index. Naver Search Advisor lehnt Dateien über 10 MB ab: Wählen Sie für eine koreanische Website unter Mehr Optionen das Limit von 10 MB.
Sprachversionen (xhtml:link) zählen nicht zu den 50.000. Dieser Generator teilt automatisch und auf Wunsch nach Bereichen: eine Datei für den Blog, eine für die Produkte.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Bild- und hreflang-Einträge
Eine Sitemap kann zu jeder Seite auch deren Bilder und deren Versionen in anderen Sprachen nennen, jeweils im <url>-Eintrag dieser Seite.
Bilder nutzen Googles Bild-Namensraum, bis zu 1.000 pro Seite; es zählen nur noch <image:image> und <image:loc>, denn caption, title, license und geo_location wurden 2022 abgeschafft.
Für Sprachen nennt jeder Eintrag jede Version der Seite, sich selbst eingeschlossen, mit xhtml:link und einem hreflang-Code: eine Sprache nach ISO 639-1 mit optionaler Region nach ISO 3166-1, nie eine Region allein. Die Verweise müssen in beide Richtungen gehen, sonst ignoriert Google sie; dieser Generator schreibt ein Cluster deshalb nur, wenn jede Version zurückverlinkt, und zeigt die übrigen mit ihrem Fehler. x-default ist freiwillig, für Besucher, deren Sprache Sie nicht haben.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja verlinkt auf de, de verlinkt nicht zurück: Das Cluster wird nicht geschriebenBild-Eintrag bis zu 1.000 pro Seite
Wie reiche ich eine Sitemap bei Google und Bing ein?
Nehmen Sie eine Sitemap:-Zeile in die robots.txt auf, die jeder Crawler liest, und reichen Sie die Datei in der Google Search Console und den Bing Webmaster Tools ein. Für neue und geänderte Seiten meldet IndexNow sie Bing, Yandex, Naver und anderen auf einen Schlag.
In der Search Console dürfen nur bestätigte Inhaber einer Website einreichen; die Zeile in der robots.txt wirkt für jeden. Die Search Console folgt bei einer eingereichten Sitemap keinen Weiterleitungen, reichen Sie also die endgültige Adresse ein. Bing liest eine Sitemap, sobald es sie findet, und danach etwa einmal täglich.
Die alten anonymen Pings gibt es nicht mehr: Bing hat bing.com/ping am 13. Mai 2022 abgeschaltet, und Google hat am 26. Juni 2023 angekündigt, dass sein Ping aufhört zu funktionieren; heute antwortet er mit 404. Ein Tool, das noch immer „Google anpingt“, tut nichts.


XML- oder HTML-Sitemap (und visuelle Sitemaps)
Die XML-Sitemap ist für Crawler, die HTML-Sitemap ist eine Seitenübersicht für Besucher, und eine visuelle Sitemap ist ein Bild der Struktur für die Planung. Nur die XML-Datei oder eine TXT-Liste lässt sich bei Suchmaschinen einreichen.
Eine HTML-Sitemap hilft Besuchern weiterhin und verteilt Links auf tiefe Seiten, ersetzt die XML-Datei aber nicht. Eine Text-Sitemap besteht nur aus URLs, eine pro Zeile, in einer Datei mit der Endung .txt.
Dieser Generator macht alle drei aus einem Crawl: die sitemap.xml, eine HTML-Sitemap zum Einsetzen in eine Seite und den Website-Baum. Als visueller Sitemap-Generator kostet er nichts: Den Baum laden Sie als SVG oder PNG herunter – genau das, wofür visuelle Sitemap-Dienste sonst meist Geld verlangen.
XML-Sitemapfür Suchmaschinen
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
HTML-Sitemapfür Besucher
Beispiel Garten GmbH
GartenjournalHochbeete pflegenPaprika-PflanzplanShopTropfbewässerungs-SetAnbauratgeberVisuelle Sitemapfür die Planung
Brauchen Sie überhaupt eine Sitemap?
Eine kleine Website, deren Seiten alle untereinander verlinkt sind, braucht womöglich keine: Google beziffert das auf etwa 500 Seiten oder weniger. Am meisten bringt sie großen Websites, neuen Websites mit wenigen Links von außen und Websites mit vielen Bildern oder Videos.
Googles eigener Einsteigerleitfaden nennt eine Sitemap freiwillig, und das Einreichen ist ein Hinweis, kein Befehl. Sie kostet aber kaum etwas, und der Crawl, der sie baut, bringt Wissenswertes ans Licht: Seiten, die kein Link erreicht, Weiterleitungen, auf die Ihre Menüs noch zeigen, und Bereiche, die größtenteils noindex sind.
braucht womöglich keine
etwa 500 Seiten oder weniger, gut verlinkt
profitiert am meisten
- große Websites
- neue Websites, wenige Links von außen
- viele Bilder oder Videos
- 5 Seiten, die nur über die Sitemap gefunden werden
Sitemap-Fehler in der Search Console und wie Sie sie beheben
Die meisten Sitemap-Fehler in der Search Console laufen auf dasselbe hinaus: eine URL, die die Sitemap nicht auflisten darf, ein nicht maskiertes Zeichen, ein Datum ohne Zeitzone oder eine Datei über den Limits. Jeder Fall unten zeigt die Zeile, die ihn auslöst.
URL nicht zulässig
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Fehlerhafter Aufbau
<loc>https://www.example.org/search?q=soil&page=2</loc>
Ungültiges Datum
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Nicht unterstütztes Format
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
Zu viele URLs
<url> × 50.001
Sitemap enthält URLs, die von der robots.txt-Datei blockiert werden
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
Außerdem: Konnte nicht abgerufen werden (gesperrt, 404, ein Serverfehler, eine manuelle Maßnahme oder zu geringe Crawl-Nachfrage), Komprimierungsfehler (neu gzippen) und unvollständige URL (jede Datei in einem Index braucht ihre vollständige URL).
Kann KI eine Sitemap erstellen?
KI kann die Struktur einer Website für die Planung skizzieren, aber eine Sitemap ist eine Liste von Tatsachen über echte URLs: welche mit 200 antworten, welche noindex sind, welche weiterleiten. Das sagt Ihnen nur der Abruf jeder einzelnen URL.
Ein Modell, das die Sitemap einer bestehenden Website liefern soll, rät die URLs aus Mustern zusammen. Es kann nicht sehen, dass eine Produktseite inzwischen 404 antwortet, dass ein Tag-Archiv noindex ist oder dass ein alter Beitrag weiterleitet – und jede solche URL in der Datei ist eine, die die Search Console melden kann. Nehmen Sie KI für die Planung und einen Crawl für die Datei.
Quellen
- sitemaps.org-Protokoll und die FAQ: das Format, die Limits von 50.000 URLs und 50 MB, der Index, Text-Sitemaps
- Google Search Central: Sitemap erstellen, große Sitemaps, lokalisierte Versionen, Bild-Sitemaps, lastmod und der abgeschaltete Ping sowie die Fehler im Sitemaps-Bericht
- Bing: Sitemaps in der KI-gestützten Suche (2025), das lastmod-Tag (2023) und der entfernte Ping (2022)
- Yandex: Sitemap, Naver Search Advisor: Feeds und IndexNow
- RFC 9309, der robots.txt-Standard, dem dieser Crawler folgt
| URL | Geraten | Gecrawlt |
|---|---|---|
| /blog/raised-care/ | aufnehmen | In der Sitemap200 |
| /product/fern-varieties/ | aufnehmen | 4xx404 |
| /tag/native-bed/ | aufnehmen | noindexmeta |
| /2019/07/raised-care/ | aufnehmen | Weiterleitung301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | aufnehmen | Canonical woandershin→ /blog/pollinator-kit/ |
FAQ zum Sitemap Generator
Ist dieser XML Sitemap Generator kostenlos?
Warum fehlen einige meiner Seiten in der Sitemap?
Wohin kommt die Datei sitemap.xml?
Wie viele URLs darf eine Sitemap enthalten?
Nutzt Google priority und changefreq?
Warum bekommen manche Seiten kein lastmod-Datum?
Gehören Weiterleitungen oder noindex-Seiten in eine Sitemap?
Wie reiche ich meine Sitemap bei Google ein?
Mein CMS erstellt schon eine Sitemap. Brauche ich diese hier?
Befolgt dieser Sitemap-Crawler die robots.txt?
Kann es eine Website crawlen, die mit JavaScript gebaut ist?
Was ist IndexNow, und brauche ich damit noch eine Sitemap?
Fehlt Ihnen etwas?Funktion oder neues Tool vorschlagen
Weitere Tools zum Crawlen und für SEO
Link-Analyse
Alle Links einer Webseite mit Dofollow/Nofollow-Erkennung und HTTP-Statusprüfung analysieren
Redirect Checker
URL-Weiterleitungen, Weiterleitungsketten und HTTP-Statuscodes für SEO prüfen
HTTP-Header-Checker
HTTP-Antwort-Header und Sicherheits-Header-Bewertung analysieren
Website-Down-Checker
Ist die Seite für alle down oder nur für Sie? Prüfen Sie jede Website von 11 Orten und Ihrer eigenen Verbindung aus, mit Live-Screenshot
Subdomain-Finder
Alle Subdomains einer Domain entdecken
CMS Detector
Welches CMS, Theme, welche Plugins und Technologien eine Website nutzt, mit Nachweis für jedes