











Gerador de Sitemap
Um gerador de sitemap grátis para criar sitemap XML: ele rastreia seu site como um buscador faz, guarda só as páginas que merecem aparecer nos resultados e diz por que deixou de fora cada uma das outras URLs.
Um domínio também serve: example.org começa pela página inicial dele.
- robots.txtLido primeiro e obedecido
- Seu sitemapEncontrado e comparado
- RastreadasAté 500 páginas, 3 por vez
- Decididasnoindex, canonical, redirecionamentos
Como criar um sitemap XML, passo a passo
Digite sua página inicial acima e selecione Gerar sitemap. O rastreador lê o robots.txt, segue seus links como um buscador faz, guarda só as páginas que merecem entrar e entrega um sitemap.xml para você subir na raiz do seu site.
Uma página merece entrar quando responde 200, é HTML, não tem noindex, aponta a si mesma como canonical e não está bloqueada pelo robots.txt. Todas as outras URLs caem em Fora com o motivo delas, para você distinguir um erro de uma escolha.
Suba o arquivo na raiz, https://www.example.org/sitemap.xml: um sitemap só pode listar URLs da própria pasta e das que ficam abaixo dela, então a raiz cobre o site inteiro (Google). Depois acrescente uma linha Sitemap: ao robots.txt e envie o arquivo no Google Search Console e no Bing Webmaster Tools.
1Digite sua página inicial
example.orgou cole uma lista de URLs2Nós rastreamos e decidimos
robots.txt 200499/500412 no sitemap · 87 fora3Baixe o arquivo
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML ou CSV4Suba e envie
/sitemap.xmlSitemap: https://www.example.org/…a raiz · robots.txt · Search Console



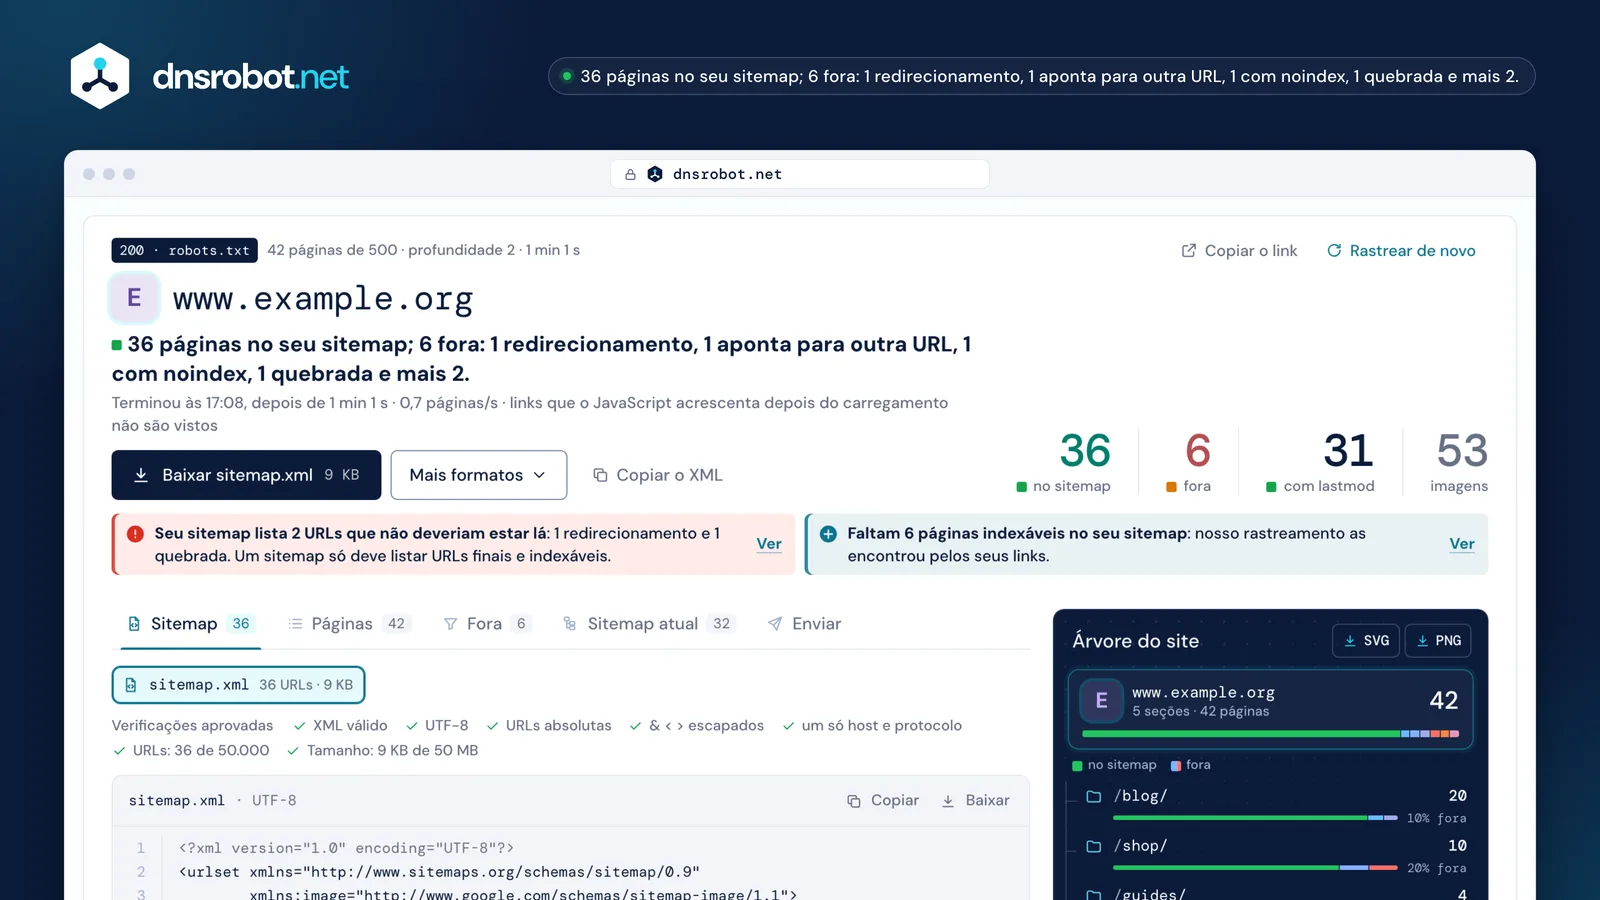
 O vereditoQuantas páginas entram, quantas ficam de fora e por quê, numa frase só. Os números grandes repetem isso.Downloadsitemap.xml, ou um ZIP com todos os arquivos e o índice quando ele é dividido; também .xml.gz, TXT, um mapa do site HTML e um CSV com cada página rastreada.AvisosAs entradas desatualizadas do seu sitemap atual, as páginas que faltam nele e de onde veio cada data lastmod.A árvore do siteCada seção com o número de páginas e a fatia que ficou de fora. Selecione um galho para filtrar as páginas; baixe em SVG ou PNG.
Como é um sitemap XML? Um exemplo de sitemap
Um sitemap XML é um arquivo UTF-8 com uma entrada <url> por página. Só <urlset>, <url> e <loc> são obrigatórios; todo o resto é opcional. Veja um exemplo de sitemap, anotado linha por linha.
Cada <loc> é uma URL completa e absoluta, que começa pelo protocolo e não passa de 2.048 caracteres, com & escrito como & (sitemaps.org). <lastmod> é a data da última alteração da página, no formato W3C, como 2026-09-14; a hora é opcional, mas precisa de fuso horário.
O namespace continua em http://, mesmo num site https: ele é um nome para os analisadores, não um endereço que alguém vá buscar. <changefreq> e <priority> são permitidos, mas o Google e o Bing ignoram os dois.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, declarado na primeira linha
- 2O namespace: http://, não https://
- 3Uma URL absoluta, com & escrito como &
- 4A data de alteração real, ou nenhum lastmod
- 5Ignorados pelo Google e pelo Bing
- 6Sem lastmod: uma página inicial só reúne outras páginas
Quais páginas entram num sitemap, e por que algumas ficam de fora?
As URLs canônicas que você quer ver nos resultados de busca, uma por página: URLs finais que respondem 200, são indexáveis e não estão bloqueadas pelo robots.txt. Todo o resto fica de fora, com o motivo escrito ao lado.
Um redirecionamento, uma página com noindex ou uma URL cuja canonical aponta para outro lugar mandam um recado contraditório aos buscadores: o sitemap diz “indexe isto” enquanto a página diz o contrário. Não cite uma URL no sitemap e outra no rel=canonical (Google), e lembre que o Search Console avisa quando um sitemap lista URLs que o robots.txt bloqueia.
Cada URL de um sitemap é só uma sugestão; quem decide quais páginas são duplicadas continua sendo o Google. É por isso que este gerador mostra o motivo de cada página que deixa de fora: um noindex que você quis está certo, um noindex no seu melhor produto não.
lastmod, changefreq e priority: o que os buscadores leem?
O Google e o Bing ignoram changefreq e priority. Os dois usam lastmod, mas só quando ele é exato: uma data que muda a cada rastreamento ensina os buscadores a não confiar mais nela.
O Google usa lastmod “se ele for consistente e verificavelmente exato”, e ele deve marcar a última alteração significativa — o conteúdo principal, os dados estruturados ou os links —, não um ano de copyright novo (Google). Um lastmod que continua anunciando alterações recentes em páginas antigas deixa de merecer confiança. O Bing programa os rastreamentos pelo lastmod e pode desconsiderar datas que são sempre hoje. O Yandex ainda lê as três tags.
Por isso este gerador nunca escreve a data de hoje. Ele tira o lastmod dos dados da própria página, na ordem abaixo, e o deixa de fora quando não há nenhuma: ficar sem lastmod está certo numa página inicial ou numa categoria que só reúne outras páginas.
| Tag | Bing | Yandex | |
|---|---|---|---|
| lastmod | usa quando é exata | usa quando é exata | lê |
| changefreq | ignora | ignora | lê |
| priority | ignora | ignora | lê |
Com que cara fica um “hoje” em todas as páginas
412 entradas, uma data só: data de geração, não de alteração.
50.000 URLs, 50 MB e o índice de sitemaps
Um sitemap comporta no máximo 50.000 URLs e 50 MB sem compactar. Passando do primeiro dos dois limites que você atingir, divida as URLs em vários arquivos e liste-os num índice de sitemaps; depois envie o índice.
O limite conta o arquivo sem compactar, mesmo quando você o serve como .xml.gz — gzip, não ZIP (sitemaps.org). Um índice pode listar até 50.000 sitemaps, só arquivos do próprio site, na pasta dele ou abaixo dela, e nunca outro índice. O Naver Search Advisor recusa arquivos com mais de 10 MB, então escolha o limite de 10 MB em Mais opções para um site coreano.
As alternativas de idioma (xhtml:link) não contam para as 50.000. Este gerador divide sozinho e, se você pedir, por seção: um arquivo para o blog, outro para os produtos.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Entradas de imagem e de hreflang
Um sitemap também pode listar as imagens de cada página e as versões dela em outros idiomas, dentro da entrada <url> dessa mesma página.
As imagens usam o namespace de imagens do Google, até 1.000 por página; só <image:image> e <image:loc> ainda contam, e caption, title, license e geo_location foram aposentados em 2022.
Para os idiomas, cada entrada lista todas as versões da página, ela mesma incluída, com xhtml:link e um código hreflang: um idioma ISO 639-1 com uma região ISO 3166-1 opcional, nunca só a região. Os links precisam ir nos dois sentidos, senão o Google os ignora, então este gerador escreve um grupo só quando todas as versões apontam de volta, e mostra as outras com a falha. O x-default é opcional, para os visitantes cujo idioma você não tem.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja aponta para de, e de não aponta de volta: o grupo não é escritoentrada de imagem até 1.000 por página
Como enviar um sitemap para o Google e o Bing?
Acrescente uma linha Sitemap: ao robots.txt, que todo rastreador lê, e envie o arquivo no Google Search Console e no Bing Webmaster Tools. Para as páginas novas e as que mudaram, o IndexNow avisa Bing, Yandex, Naver e outros de uma vez.
Só os proprietários verificados de um site podem enviá-lo pelo Search Console; a linha no robots.txt funciona para qualquer um. O Search Console não segue redirecionamentos de um sitemap enviado, então envie o endereço final dele. O Bing lê um sitemap assim que o encontra e, depois disso, mais ou menos uma vez por dia.
Os antigos pings anônimos acabaram: o Bing desligou o bing.com/ping em 13 de maio de 2022 e o Google anunciou em 26 de junho de 2023 que o ping dele ia parar de funcionar; hoje ele responde 404. Uma ferramenta que ainda “faz ping no Google” não faz nada.


Sitemap XML x mapa do site HTML (e mapas visuais)
Um sitemap XML é para os rastreadores, um mapa do site HTML é uma página de links para os visitantes e um mapa visual é um desenho da estrutura do site, para planejar. Só o XML, ou uma lista TXT, pode ser enviado aos buscadores.
Um mapa do site HTML continua ajudando os visitantes e espalha links para as páginas profundas, mas não substitui o arquivo XML. Um sitemap em texto puro é só URLs, uma por linha, num arquivo terminado em .txt.
Este gerador faz os três com um rastreamento só: sitemap.xml, um mapa do site HTML para colar numa página e a árvore do site. Como gerador de mapa visual ele não custa nada: a árvore baixa em SVG ou PNG, algo que os serviços de mapa visual costumam cobrar.
Sitemap XMLpara os buscadores
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
Mapa do site HTMLpara os visitantes
Example Garden Co.
Diário da hortaCuidados com os canteirosPlantio de pimentasLojaKit inicial de gotejamentoGuias de cultivoMapa visualpara planejar
Você precisa mesmo de um sitemap?
Um site pequeno cujas páginas se linkam todas entre si pode não precisar: o Google situa o número em cerca de 500 páginas ou menos. Sites grandes, sites novos com poucos links de fora e sites com muitas imagens ou vídeos são os que mais ganham.
O próprio guia inicial de SEO do Google chama o sitemap de opcional, e enviá-lo é uma sugestão, não uma ordem. Mesmo assim custa pouco, e o rastreamento que o monta mostra coisas que vale a pena saber: páginas que nenhum link alcança, redirecionamentos para os quais seus menus ainda apontam e seções que são quase todas noindex.
talvez não precise
cerca de 500 páginas ou menos, bem linkadas
ganham mais
- sites grandes
- sites novos, com poucos links de fora
- muitas imagens ou vídeos
- 5 páginas que só o sitemap alcança
Erros de sitemap no Search Console e como corrigi-los
Quase todo erro de sitemap no Search Console se resume a uma URL que o sitemap não pode listar, um caractere sem escapar, uma data sem fuso horário ou um arquivo acima dos limites. Cada caso abaixo mostra a linha que o provoca.
URL não permitido
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Erro na análise
<loc>https://www.example.org/search?q=soil&page=2</loc>
Data inválida
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Formato não compatível
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
URLs em excesso
<url> × 50.001
O sitemap contém URLs bloqueados pelo arquivo robots.txt
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
Também: Não foi possível buscar o sitemap (bloqueado, 404, um erro de servidor, uma ação manual ou pouca demanda de rastreamento), Erro de compactação (compacte de novo com gzip) e URL incompleto (cada arquivo de um índice precisa da URL completa).
A IA consegue criar um sitemap?
A IA consegue esboçar a estrutura de um site para planejar, mas um sitemap é uma lista de fatos sobre URLs ao vivo: quais respondem 200, quais têm noindex, quais redirecionam. Só buscando cada URL dá para saber isso.
Um modelo a quem se pede o sitemap de um site que já existe adivinha as URLs a partir de padrões. Ele não consegue ver que uma página de produto agora responde 404, que um arquivo de tags tem noindex ou que um post antigo redireciona, e cada URL assim no arquivo é uma que o Search Console pode apontar. Use a IA para o plano e o rastreamento para o arquivo.
Fontes
- Protocolo do sitemaps.org e as perguntas frequentes dele: o formato, os limites de 50.000 / 50 MB, o índice e os sitemaps de texto
- Google Search Central: criar um sitemap, sitemaps grandes, versões localizadas, sitemaps de imagem, o lastmod e o ping aposentado e os erros do relatório Sitemaps
- Bing: sitemaps na busca com IA (2025), a tag lastmod (2023) e o ping removido (2022)
- Yandex: sitemap, Naver Search Advisor: feeds e IndexNow
- RFC 9309, o padrão do robots.txt que este rastreador segue
| URL | Adivinhada | Rastreada |
|---|---|---|
| /blog/raised-care/ | incluir | No sitemap200 |
| /product/fern-varieties/ | incluir | 4xx404 |
| /tag/native-bed/ | incluir | noindexmeta |
| /2019/07/raised-care/ | incluir | Redirecionamento301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | incluir | Canonical em outra URL→ /blog/pollinator-kit/ |
Perguntas frequentes sobre o gerador de sitemap
Criar um sitemap XML com este gerador é grátis?
Por que algumas das minhas páginas não entraram no sitemap?
Onde eu coloco o arquivo sitemap.xml?
Quantas URLs um sitemap pode ter?
O Google usa priority e changefreq?
Por que algumas páginas ficam sem data lastmod?
Um sitemap deve incluir redirecionamentos ou páginas com noindex?
Como eu envio meu sitemap para o Google?
Meu CMS já faz um sitemap. Preciso deste aqui?
Este rastreador de sitemap obedece ao robots.txt?
Dá para rastrear um site feito com JavaScript?
O que é o IndexNow, e ainda preciso de um sitemap com ele?
Mais ferramentas de rastreamento e SEO
Analisador de Links
Analise todos os links de uma página com detecção dofollow/nofollow e verificação de status HTTP
Verificador de Redirecionamento
Verifique redirecionamentos de URL, cadeias de redirecionamento e códigos de status HTTP para SEO
Verificador de headers HTTP
Analise cabeçalhos de resposta HTTP e classificação de cabeçalhos de segurança
Verificador de Site Fora do Ar
Está fora do ar para todos ou só para você? Verifique qualquer site de 11 lugares e da sua conexão, com uma captura de tela ao vivo
Localizador de Subdomínios
Descubra todos os subdomínios de qualquer domínio
Detector de CMS
Qual CMS, tema, plugins e tecnologias um site usa, com a prova de cada um