Todos os outros rastreadores
User-agent: *
Lido por todo rastreador que não tem grupo próprio.
- Permite o site inteiro.
O Google o ignora; o Bing o lê.
Tema
Crie um robots.txt em que você pode confiar: cada regra explicada enquanto você digita, o arquivo relido pelo nosso verificador de robots.txt segundo a RFC 9309 e a leitura do próprio Google, e um veredito ao vivo para qualquer rastreador e qualquer caminho antes de publicar.
Um arquivo por host e protocolo: www.example.com e example.com precisam de um cada.
Fonte: RFC 9309, consultada em 26 de outubro de 2026.
Lido por todo rastreador que não tem grupo próprio.
Escolha o que cada rastreador conhecido recebe. Um rastreador com grupo próprio lê só esse grupo.
Rastreiam para montar um índice de busca. Páginas bloqueadas ainda podem ser listadas por links de outros lugares, mas sem nada lido delas.
Coletam páginas para treinar modelos. Um token separado permite recusar o treinamento e continuar aparecendo nos resultados de busca.
Buscam páginas para responder a perguntas com um link de volta para você.
Buscam uma página porque uma pessoa pediu, por isso alguns operadores dizem que eles podem ignorar o robots.txt.
Recusar estes é recusar uma pessoa, não um rastreamento: quando alguém pede a um assistente de IA que abra uma das suas páginas, um assistente que obedece ao arquivo não vai lê-la para essa pessoa. Se o que você quer barrar é o treinamento, recuse os rastreadores de treinamento acima.
Prévias de links, ferramentas do dono do site, verificações de anúncios, arquivos da web e rastreadores cujos operadores declaram outra função, ou nenhuma.
Seu robots.txt/robots.txt
User-agent: *Allow: /ErroAvisoNota23 B de 500 KiB
1 aviso
O que fazer É a linha mais barata do arquivo, e todo rastreador a lê. Acrescente Sitemap: com o endereço completo do seu sitemap.
Escolha um rastreador e um caminho: o veredito, a regra que o decide e o grupo que o rastreador lê vêm do próprio algoritmo de correspondência do Verificador de Robots.txt.
Este rastreador pode pedir esta URL.
User-agent: *começa na linha 1
Nenhum grupo cita este rastreador, então vale o grupo *.
Allow: /linha 2
/any-page
/
Só o caminho e a consulta são comparados, byte a byte, depois da codificação percentual. O host, o protocolo e o fragmento nunca fazem parte de uma regra.
Escreva as regras, salve-as num arquivo de texto simples chamado robots.txt, codificado em UTF-8, e suba-o para o nível mais alto do seu site, para que ele responda em https://example.com/robots.txt. Não há nada para enviar: os rastreadores pedem esse endereço por conta própria.
O Google resume em três frases: “O arquivo precisa ter o nome robots.txt. O site pode ter somente um arquivo robots.txt. O arquivo robots.txt precisa estar localizado na raiz do host do site a que se refere.” Ele precisa ser “um arquivo de texto codificado em UTF-8”, e “os rastreadores do Google vão encontrar e começar a usar seu arquivo robots.txt automaticamente.”
O gerador acima parte de uma predefinição, explica cada regra enquanto você digita e relê o resultado com o analisador e o algoritmo de correspondência do nosso verificador de robots.txt antes de você copiá-lo. O download se chama robots.txt: UTF-8 sem marca de ordem de bytes, só quebras de linha LF e nenhuma data ou comentário que você não tenha pedido.
https://example.com/robots.txtNão há etapa de envio: os rastreadores do Google encontram o arquivo sozinhos.
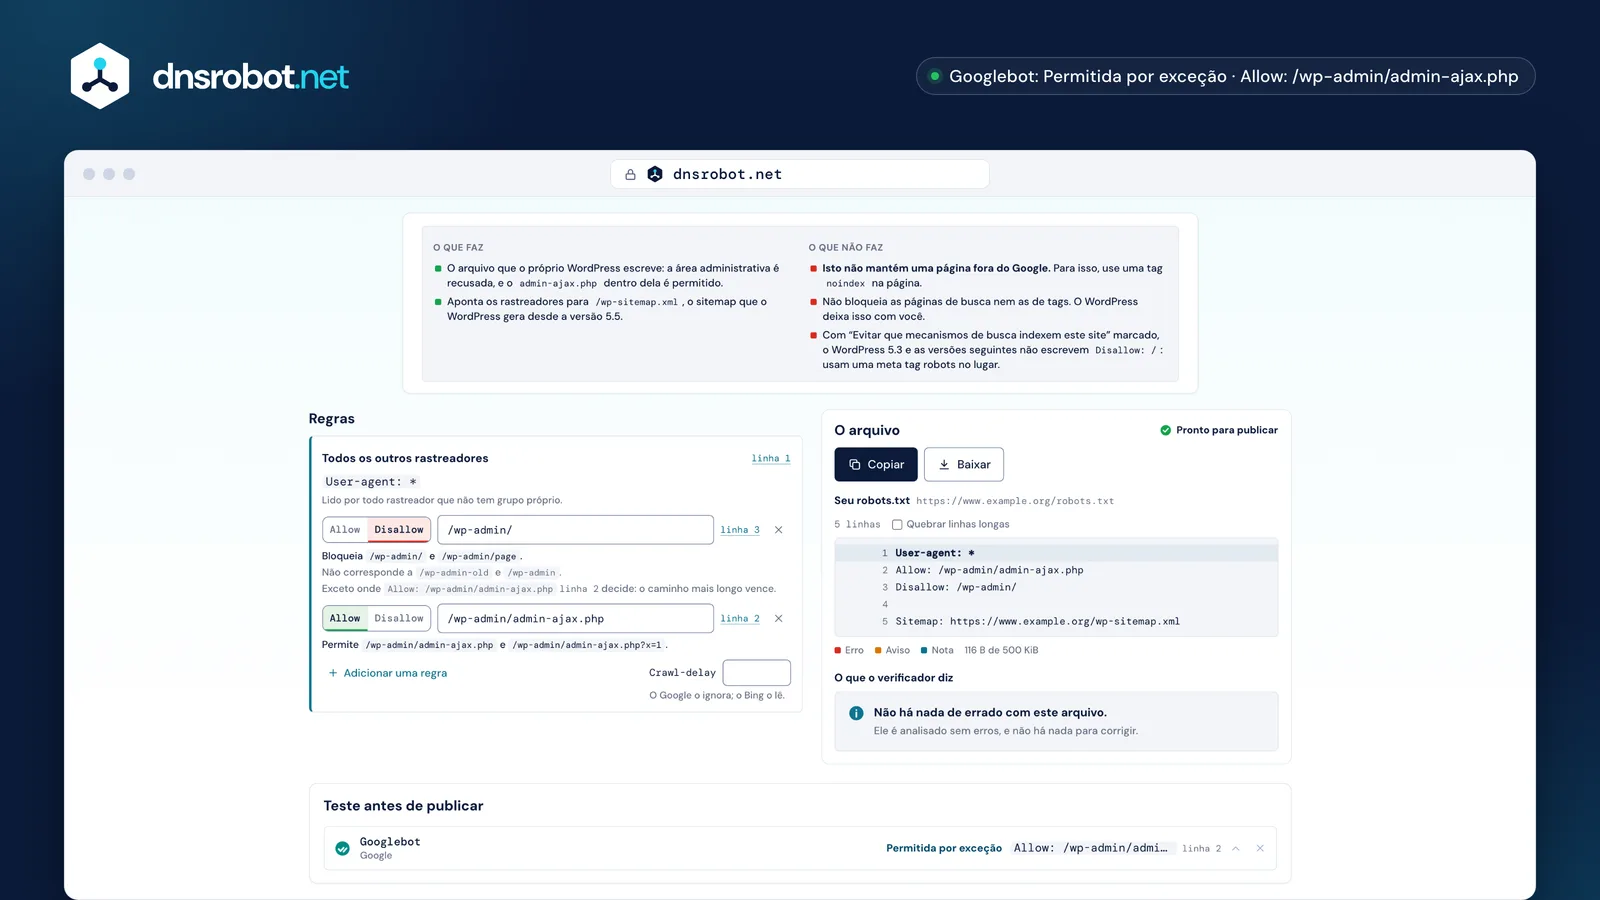
 O que a predefinição fazE o que ela não faz: nenhuma destas predefinições mantém uma página fora do Google, e cada uma diz isso.Cada regra explicadaOs caminhos que uma regra bloqueia e os que ela deixa passar, pelo mesmo algoritmo de correspondência que decide cada veredito, e a regra mais longa que abre uma exceção.O arquivo e os problemasO arquivo com os números de linha, relido pela própria auditoria do Verificador de Robots.txt antes de você copiá-lo.O vereditoEscolha um rastreador e um caminho: permitido ou bloqueado, a regra que decidiu com a linha dela e o grupo que o rastreador lê.
Grupos e linhas Sitemap. Um grupo começa com uma ou mais linhas User-agent que citam rastreadores, seguidas das regras Allow e Disallow que esses rastreadores obedecem; uma linha Sitemap fica sozinha, fora de todos os grupos.
A RFC 9309 define um grupo como “uma ou mais linhas user-agent seguidas de uma ou mais regras”, e um rastreador obedece a exatamente um grupo: o que cita o próprio token de produto dele, ou o grupo * quando nenhum cita. O Google lê quatro campos e nenhum outro: user-agent, allow, disallow e sitemap.
Os nomes dos campos não diferenciam maiúsculas de minúsculas; os caminhos, sim: no próprio exemplo do Google, disallow: /file.asp é aplicado em /file.asp, “mas não em” /FILE.asp. Uma linha Sitemap: precisa ser um endereço completo, com o protocolo e o host; este gerador recusa qualquer outro formato e diz por quê.
User-agent: *Começa um grupo para todo rastreador sem grupo próprioDisallow: /cart/Um caminho que estes rastreadores não podem buscarAllow: /cart/helpUma exceção: mais longa que o Disallow, então vence User-agent: GPTBotComeça um grupo que cita dois rastreadoresUser-agent: ClaudeBotDisallow: /Os dois são recusados no site inteiro Sitemap: https://www.example.org/sitemap.xmlFora de todos os grupos: um endereço completo* e $: como uma regra corresponde a uma URLQuando várias regras correspondem a uma URL, vence a que tem o caminho mais longo, seja de que tipo for, e um Allow vence o empate. * vale por qualquer sequência de caracteres e $ marca o fim da URL; nada mais num caminho é especial.
RFC 9309: “A correspondência mais específica encontrada DEVE ser usada. A correspondência mais específica é a que tem mais octetos”, e “se uma regra allow e uma regra disallow forem equivalentes, a regra allow DEVERIA ser usada.” O próprio arquivo do WordPress funciona assim: Disallow: /wp-admin/ fecha a pasta, e o Allow: /wp-admin/admin-ajax.php, mais longo, abre um arquivo dentro dela.
Uma regra sem $ é um prefixo, então Disallow: /admin também bloqueia /administrator; acrescente a barra (/admin/) quando quiser dizer a pasta. Embaixo de cada regra, o editor acima mostra os caminhos que ela pega e alguns que ela não pega, pelo mesmo algoritmo de correspondência que decide cada veredito, e aponta uma regra que outra sempre vence.
* e $, e o que cada padrão pega de verdade/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ e + são caracteres comuns. Não existem expressões regulares no robots.txt.
/admin/report.pdfO Allow vence: ele corresponde a uma parte maior do caminho.
Disallow: /files/7 caracteresAllow: /files/7 caracteresComprimento igual, então o Allow vence. “A regra menos restritiva”, como diz o Google.
Os três já servem um, e as predefinições acima escrevem o que a documentação de cada plataforma descreve: o WordPress recusa a área administrativa mas permite o admin-ajax.php, o Shopify recusa carrinhos, checkouts e coleções filtradas ou ordenadas, e o Next.js serve o arquivo que você coloca em app/robots.txt.
O WordPress escreve o arquivo dele em código, em do_robots(): User-agent: *, um Disallow para o caminho da administração e um Allow para o admin-ajax.php e, num site público, desde o WordPress 5.5, uma linha Sitemap: para /wp-sitemap.xml. Com “Evitar que mecanismos de busca indexem este site” marcado, o WordPress 5.3 e as versões seguintes não escrevem mais Disallow: /; usam uma meta tag robots no lugar.
O Shopify diz que o arquivo padrão dele “funciona para a maioria das lojas”. Não há arquivo para subir: mudá-lo significa editar o modelo robots.txt.liquid do tema, o que o Shopify chama de “uma personalização sem suporte”. O Next.js serve o app/robots.txt como foi escrito, ou monta o arquivo a partir do app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlEscrito pelo próprio WordPress. Mude com um plugin ou com o filtro robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlO padrão do Shopify. Mude no modelo robots.txt.liquid do tema.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlSeu próprio arquivo em app/robots.txt, ou app/robots.ts, servido em /robots.txt.
Um grupo que cita o rastreador, com Disallow: / embaixo, funciona para todo rastreador cujo operador diz que ele obedece ao robots.txt, e só para esses. É um pedido que o rastreador atende, não uma tranca: um rastreador que ignora o arquivo ainda pode buscar todas as páginas.
A maioria das empresas de IA tem mais de um rastreador, então decida função por função. Recusar um rastreador de treinamento como o GPTBot ou o ClaudeBot recusa o que coleta páginas para modelos; recusar um rastreador de respostas como o OAI-SearchBot ou o PerplexityBot também tira você dos links que esses assistentes mostram. O token de treinamento do Google não é o Googlebot: “O Google-Extended não afeta a inclusão de um site na Pesquisa Google nem é usado como um indicador de classificação na Pesquisa Google.”
O terceiro tipo é diferente. O ChatGPT-User, o Claude-User, o Perplexity-User e o Amzn-User buscam uma página porque uma pessoa pediu a um assistente que a abrisse, então recusá-los é recusar essa pessoa, e alguns dos operadores dizem que esses rastreadores podem ignorar o robots.txt de qualquer forma. A lista de rastreadores acima os mantém numa seção própria por esse motivo.
GPTBotObedeceOAI-SearchBotObedeceChatGPT-UserPode ignorarClaudeBotObedeceClaude-SearchBotObedeceClaude-UserObedecePerplexityBotObedecePerplexity-UserPode ignorarGoogle-ExtendedSó tokenNão existe esse rastreadorNão existe esse rastreadorApplebot-ExtendedSó tokenNão existe esse rastreadorNão existe esse rastreadormeta-externalagentObedecemeta-webindexerObedecemeta-externalfetcherPode ignorarAmazonbotObedeceNão existe esse rastreadorAmzn-UserPode ignorarEle pede aos rastreadores que não busquem uma página; não pede a um buscador que não a liste. O Google “ainda pode indexar a URL e mostrá-la nos resultados de pesquisa sem um snippet” quando outras páginas apontam para ela. Para manter uma página fora, use noindex e deixe a página rastreável, para que a tag possa ser lida.
O Search Console chama isso de “Página indexada, mas bloqueada pelo robots.txt”. E o Google é explícito: “para que a regra noindex funcione, a página ou recurso não pode ser bloqueado por um arquivo robots.txt”. O noindex de uma página bloqueada nunca é visto, porque o rastreador nunca busca a página.
É por isso que toda predefinição acima diz o que não faz. O Disallow: / da predefinição de homologação mantém os rastreadores bem-comportados do lado de fora, mas uma URL de homologação que recebe um link de qualquer lugar ainda pode ser listada: coloque a homologação atrás de uma senha e nunca leve essa linha para o site no ar.
<meta name="robots" content="noindex">Nunca lidaPara manter uma página fora: deixe o rastreador entrar e use noindex, ou exija login.
Na raiz do host a que se aplica, como /robots.txt, um arquivo por host e protocolo. https://example.com/robots.txt não diz nada sobre https://www.example.com nem sobre https://shop.example.com: cada um precisa de um arquivo próprio, e um robots.txt dentro de uma pasta nunca é lido.
Google: “Você precisa colocar o arquivo robots.txt no diretório de nível superior do site, em um protocolo compatível.” O relatório robots.txt do Search Console lista separadamente os arquivos dos 20 principais hosts de uma propriedade, com HTTP e HTTPS contados à parte.
Digite seu site no topo do gerador e ele mostra o endereço exato em que o arquivo precisa responder, preenche a linha Sitemap: para esse host e traz um link para o Verificador de Robots.txt, que lê o arquivo no ar assim que ele estiver publicado.
https://example.com/robots.txtTodas as URLs de https://example.comhttps://www.example.com/robots.txtSó www.example.com: outro hosthttp://example.com/robots.txtSó o site http://: outro protocolohttps://shop.example.com/robots.txtSó shop.example.comhttps://example.com/blog/robots.txtNada: um robots.txt numa pasta nunca é lidoO Google não lê nenhuma delas. O Crawl-delay é lido pelo Bing, o Clean-param pelo Yandex, o Host não está nem no padrão nem na lista do Google, e o Content-Signal da Cloudflare declara para que o seu conteúdo pode ser usado, e não o que pode ser rastreado.
O Google lista os quatro campos dele e acrescenta que “outros campos, como crawl-delay, não são compatíveis”. O blog do próprio Bing diz que “a diretiva crawl-delay aceita como valores apenas números inteiros positivos”, então o editor recusa uma fração em vez de escrevê-la. Não foi possível ler a página de ajuda atual do Bing para confirmar um intervalo ou uma unidade, então esta página não afirma nenhum dos dois.
Nenhuma delas quebra um arquivo: a RFC 9309 exige que a análise de outros registros “NÃO DEVE interferir na análise dos registros definidos explicitamente”. Das quatro, o gerador só escreve o Crawl-delay, identificado com quem o lê.
User-agentLêLêLêAllowLêLêLêDisallowLêLêLêSitemapLêLêLêCrawl-delayIgnoraLêNão confirmadoClean-paramIgnoraIgnoraLêHostIgnoraIgnoraNão confirmadonoindexIgnoraNão confirmadoNão confirmadoContent-SignalIgnoraNão confirmadoNão confirmadoDuas vezes. Antes de publicar, com Teste antes de publicar acima: escolha um rastreador e um caminho e veja a regra que decide. Depois de subir o arquivo, rode o Verificador de Robots.txt no arquivo no ar, porque o que o servidor responde importa tanto quanto o que o arquivo diz.
Um arquivo que responde 404 é lido como se não houvesse arquivo, então todo rastreador pode rastrear tudo; um arquivo que responde 500 ou 503 significa que um rastreador que segue o padrão não pode rastrear nada. RFC 9309 §2.3.1.4: o rastreador “DEVE presumir bloqueio total”. O Google ameniza isso com uma escada própria, mostrada na figura.
O testador de robots.txt do próprio Google não existe mais: o Search Central anunciou a aposentadoria dele em 15 de novembro de 2023, e o relatório robots.txt que entrou no lugar mostra o arquivo que o Google buscou, sem testar uma URL contra uma regra. O Teste antes de publicar, no gerador acima, e o verificador de robots.txt fazem esse teste.
200Segue as regras do arquivo.301, 302Segue pelo menos cinco saltos e depois para. Aí o Google lê o arquivo como um 404.403, 404Rastreia tudo, como se não houvesse arquivo.429Não rastreia nada. O Google conta esta resposta com as 5xx, não com as 4xx.500, 503Não rastreia absolutamente nada, pelo padrão.Nome inexistenteNão há site para ler, então não há veredito.Os erros caros cabem, cada um, numa linha curta: um Disallow: / que sobrou da homologação, um prefixo que vai mais longe do que você queria, uma linha Sitemap: escrita como caminho, um caminho sem a barra inicial e uma linha noindex que o Google parou de ler em 2019.
Cada um é pego aqui antes de você copiar o arquivo. A própria auditoria do verificador roda enquanto você digita, e os problemas que ela encontra ficam embaixo do arquivo; uma linha que um rastreador rejeitaria nunca é escrita, e o editor diz, na linha da própria regra, por que ela ficou de fora.
Um dos erros é um par, não uma linha: uma URL bloqueada aqui que também traz noindex na página. O rastreador nunca busca a página, então nunca vê o noindex, e a URL pode continuar nos resultados de busca. Escolha um dos dois: bloqueie o rastreamento, ou deixe o rastreador entrar e diga a ele que não indexe.
Disallow: /Sobra da homologação: o site inteiro, já no ar, fica fechado para todos os rastreadores.Disallow: /adminTambém bloqueia /administrator e /admin-tools. Acrescente a barra no final.Allow: / sob User-agent: *Nunca é lido por um rastreador que tem um grupo próprio em qualquer parte do arquivo.Sitemap: /sitemap.xmlUma linha Sitemap precisa ser um endereço completo, com o host.Disallow: adminUm caminho começa em /. Esta regra não corresponde a nada.noindex: /private/Morto desde 2019. A página continua rastreável e indexável.* em que o seu Allow está. O editor acima aponta uma regra que outra sempre vence, e o Teste antes de publicar cita a regra decisiva e o grupo que o rastreador leu.Busque o robots.txt de qualquer site, teste se uma URL está bloqueada para o Googlebot ou crawlers de IA e encontre erros de sintaxe
Rastreie seu site e receba um sitemap XML, um mapa do site HTML e uma árvore visual do site
Encontre e valide o sitemap XML de um site: sintaxe, limites de URLs, datas lastmod, conflitos com o robots.txt e URLs quebradas ou com redirecionamento
Verifique o título, a meta description, a canonical, o hreflang e as tags Open Graph e de card do X de uma página, com prévias do Google e das redes sociais
Analise cabeçalhos de resposta HTTP e classificação de cabeçalhos de segurança
Detecte seu navegador, SO, tipo de dispositivo, motor de renderização e arquitetura da CPU pelo seu user agent