











Analisador de links
Este buscador de links mostra todos os links de uma página como o Google os lê: internos ou externos, seguidos ou nofollow, sponsored ou ugc, onde cada um realmente chega e quais estão quebrados.
Um domínio também serve: example.org lê a página inicial dele.
- LeituraLê o HTML uma vez
- RedirecionamentosAté 10, cada um verificado
- Robotsmeta + X-Robots-Tag
- Links encontrados<a> e <area>
O que um analisador de links verifica?
Um analisador de links lê uma página e lista todos os links dela: para onde cada um vai, como está marcado para os buscadores, o que diz o texto âncora e onde ele realmente chega quando você o segue.
Ele lê o HTML da página como o Googlebot o vê primeiro. O Google segue elementos <a> que têm href (Google); os links relativos são resolvidos com o <base href> da página ou, se não houver, com o endereço dela depois dos redirecionamentos (HTML).
Depois, cada URL única é requisitada uma vez, com um GET e os redirecionamentos seguidos um salto por vez. Uma requisição HEAD é mais rápida, mas os servidores costumam responder a ela de modo diferente de uma visita real, então um link que termina em 404 atrás de um redirecionamento ainda conta como quebrado aqui.
- 1Para onde vaiexternowww.rfc-editor.org
- 2Como está marcadonofollowmw:extlinkmantido, sem significado para SEO
- 3O que diz“1035”
- 4Onde chega↳ 301 /info/rfc1035/OK 200185 ms
- 5Onde ficalink 187 de 1.117, em “Contents”
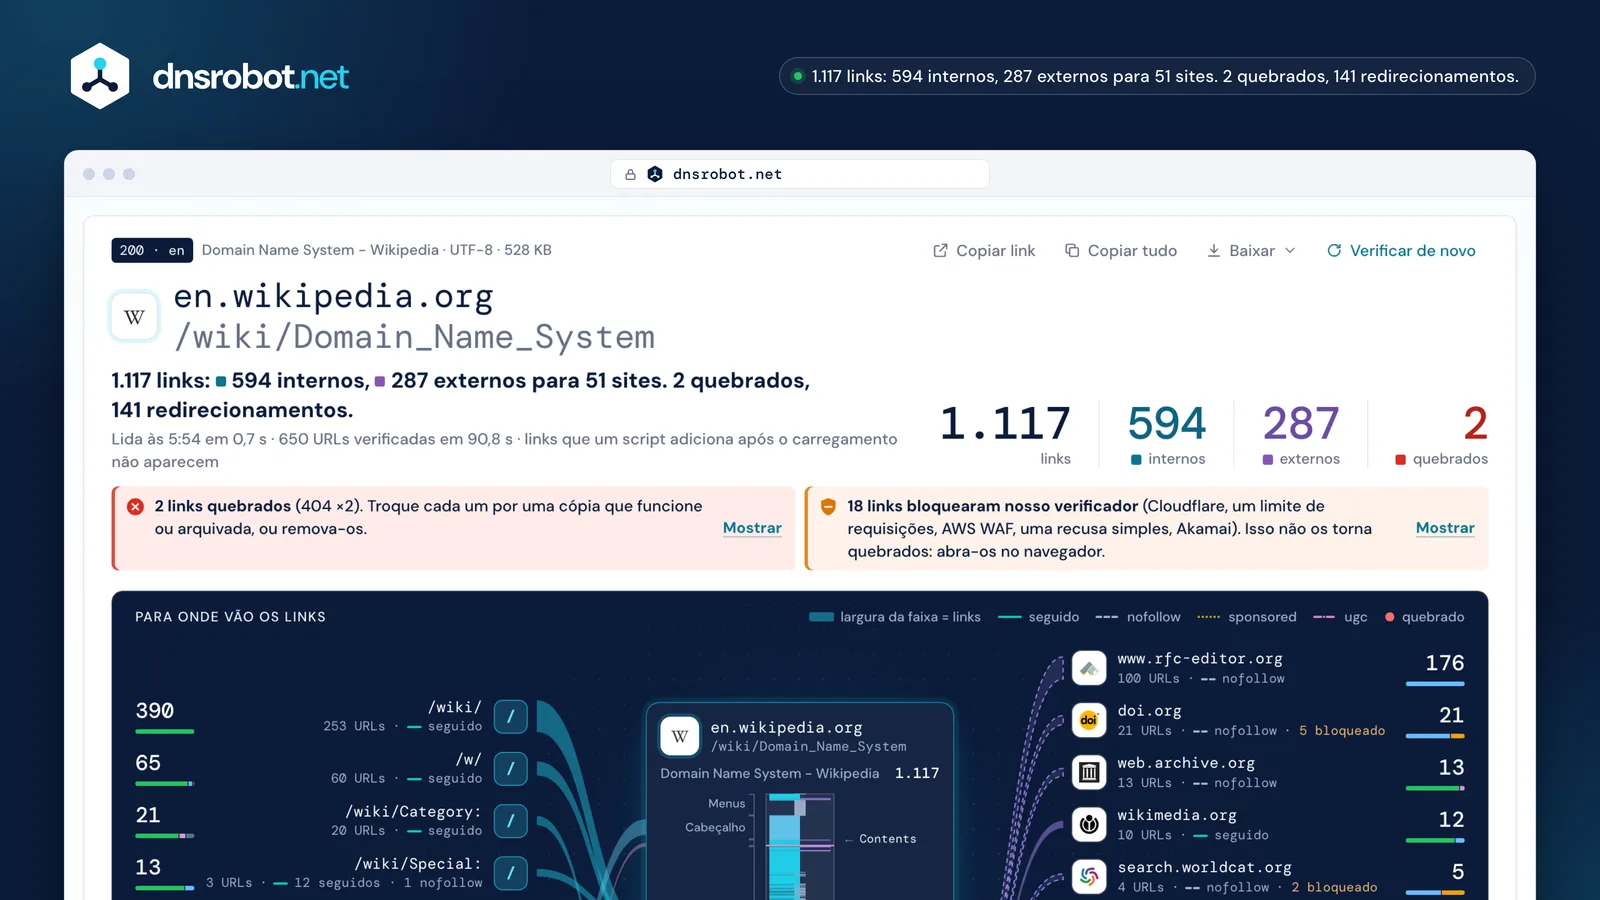
 A resposta primeiroQuantos links a página tem, quantos ficam no site, quantos saem dele e quantos estão quebrados.Observações com a correçãoLinks quebrados, links que só a proteção contra bots barrou, redirecionamentos que valem a atualização, âncoras vazias: cada um com a contagem e o que fazer.A página, de cima a baixoUm traço por link, no lugar onde ele está na página: menus, o artigo, as referências, o rodapé.Para onde vão os linksUma faixa por seção e por site, tão larga quanto o número de links, tracejada quando os links são nofollow.
Links internos x externos: o que conta como quê?
Um link interno aponta para o mesmo host da página; um link externo aponta para outro site. Links para outro host do mesmo site, como de.wikipedia.org a partir de en.wikipedia.org, são contados à parte.
Os links internos ajudam leitores e rastreadores a encontrar as outras páginas de um site; toda página importante deve ter link vindo de pelo menos outra (Google). Links externos não são um risco em si: citar boas fontes ajuda o leitor a confiar na página.
O Google sugere nofollow só para links pelos quais você não responde, não para todo link externo. Um link para #section fica na mesma página, e o Google não trata fragmentos como páginas separadas (Google).
- mesmo host 514
- mesmo site, outro host 80
- outro site 287
- mesma página 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_nameinternoMesmo host da página: interno.
- de.wikipedia.org/wiki/Domain_Name_Systemmesmo siteMesmo site (wikipedia.org), outro host: contado à parte.
- www.wikidata.org/wiki/Q8767externoOutro domínio, mesmo que a Wikimedia o administre: externo.
- www.rfc-editor.org/rfc/rfc1035externoOutro domínio: externo.
nofollow, sponsored e ugc (e por que “dofollow” não é um atributo)
rel="nofollow" pede aos buscadores que não contem um link como aval seu, rel="sponsored" marca um link pago ou um anúncio, e rel="ugc" marca um link escrito pelos seus usuários. Um link sem nenhum deles é seguido: não existe o valor dofollow.
Desde 10 de setembro de 2019, os três são dicas, não comandos, e desde 1º de março de 2020 também para rastreamento e indexação (Google). Os valores podem ser combinados, como ugc nofollow, separados por espaços ou vírgulas.
O que mais importa: um link pago sem sponsored ou nofollow viola as políticas de spam do Google (Google). No artigo da Wikipedia que lemos, 267 dos 287 links externos têm nofollow, que o MediaWiki adiciona a toda citação.
<a href>Seguido por padrão: nada a adicionarrel="nofollow"Não dê aval: quando nenhum outro valor se aplicarel="sponsored"Pago ou anúncio: necessário em links pagos (ou nofollow)rel="ugc"Escrito por usuários: comentários, posts de fórumrel="ugc nofollow"Os dois: permitido, para rastreadores mais antigosrel="dofollow"Não é um valor: navegadores e Google o ignoram
- 2005O Google apresenta o nofollow
- 2019-09-10sponsored e ugc chegam; os três viram dicas
- 2020-03-01dicas também para rastreamento e indexação
E se a própria página diz nofollow?
Então o Google não segue nenhum link dela, seja qual for o rel de cada um. Uma meta tag robots ou um cabeçalho X-Robots-Tag com nofollow vale para a página inteira; esta ferramenta marca cada link como “nofollow (página)”.
O Google lê os nomes robots e googlebot em qualquer caso, até no corpo da página, e none significa noindex mais nofollow (Google). As mesmas regras podem vir como cabeçalho, como X-Robots-Tag: nofollow.
As páginas de histórico de revisões da Wikipedia trazem noindex,nofollow de propósito. A versão anterior desta ferramenta nunca lia a tag e contava 194 dos primeiros 200 links de uma página de histórico como seguidos.
dos primeiros 200 links: a meta tag nunca era lida
links, todos nofollow (página): o Google não segue nenhum
543 nofollow (página)6 nofollowX-Robots-Tag: none
Links quebrados: como encontrar um link quebrado e corrigir
Um link está quebrado quando a URL responde com um erro como 404 Not Found ou 410 Gone, ou redireciona para um deles, ou quando o nome não existe. Analise a página e abra a aba Quebrados.
Corrija cada um linkando o novo endereço da página, uma cópia arquivada ou nada. O Google tira páginas 4xx do índice (Google), e o leitor que segue o link não chega a lugar nenhum.
Nem todo erro significa quebrado: 401 pede login, então a página existe (RFC 9110), e 5xx ou tempo esgotado muitas vezes passam, então verifique de novo mais tarde. No artigo que lemos, 2 de 656 URLs estavam quebradas, ambas nas referências; uma terceira respondeu um 403 simples, que listamos como bloqueada.
- umbrella.cisco.com404
A página sumiu
A Cisco aposentou o post do blog; o servidor diz isso claramente.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeLinke a cópia arquivada em web.archive.org ou remova o link.- http://www.apwg.org301
- https://…/1H2010.pdf404
Um redirecionamento que termina em 404
http:// vai para https://, e o PDF não está lá. Contado como quebrado, não como redirecionamento.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfDescubra onde o relatório está agora ou cite um arquivo.- www.akamai.com403
Um 403 simples: bloqueado, não quebrado
O servidor recusou nosso verificador sem sinal de proteção contra bots. O arquivo pode ter sumido, ou o servidor pode barrar bots.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfAbra no navegador; se abrir, mantenha.

Redirecionamentos em links: vale corrigir?
Um link que redireciona continua funcionando, mas cada salto custa uma requisição e tempo. Aponte os links para o endereço final, principalmente os links dentro do seu próprio site, onde você controla as duas pontas.
Um 301 ou 308 diz que a mudança é permanente; um 302, 303 ou 307 é temporário, e o Google continua mostrando o endereço antigo (Google). O Googlebot segue até 10 saltos, os navegadores até 20 (Google).
O rfc-editor.org agora envia suas páginas /rfc/ para /info/, então 175 links no artigo que lemos dão um salto extra. Um redirecionamento que termina em 404 conta aqui como quebrado, não como redirecionamento.
- doi.org/10.17487/RFC1035302302: temporário, a URL antiga continua sendo a que se usa
- www.rfc-editor.org/info/rfc1035301301: mudou para sempre, linke a nova URL
- www.rfc-editor.org/info/rfc1035/200
links apontam para rfc-editor.org/rfc/…, que agora vai para /info/…
das 656 URLs da página redirecionam
saltos que o Googlebot segue no máximo; os navegadores desistem após 20
“Bloqueado aqui, mas funciona no meu navegador”
Muitos sites põem proteção contra bots na frente das páginas. Ela barra visitantes que não executam JavaScript ou parecem automatizados, então nosso verificador recebe um 403 ou 429 enquanto o seu navegador passa. Esses links aparecem como Bloqueados, não como quebrados.
A Cloudflare marca seus desafios com um cabeçalho cf-mitigated: challenge (Cloudflare) e, por padrão, desafia clientes com user agents incomuns; 429 significa requisições demais (RFC 6585).
Enviamos um user agent honesto e nunca tentamos contornar um muro. No artigo que lemos, 18 URLs foram bloqueadas: 17 pela Cloudflare, AWS WAF, Akamai e limites de requisições, uma por um 403 simples. Abra-as você mesmo antes de mudar qualquer coisa.
- Desafio da Cloudflare7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Limite de requisições (429)3search.worldcat.org · api.semanticscholar.org · 429
- Proteção contra bots da Akamai1dyn.com → www.oracle.com · 403
Quantos links uma página pode ter?
Não há limite. A orientação do Google não define número e diz que não existe quantidade ideal; o velho conselho de manter menos de 100 links vem do tempo em que o Google lia só parte de uma página.
O que importa é que cada link ajude o leitor, que os importantes sejam links <a href> de verdade no HTML e que fiquem dentro dos primeiros 2 MB de HTML, que é tudo o que o Googlebot lê para a Busca (Google).
O artigo da Wikipedia que lemos tem 1.117 links em 528 KB de HTML. O example.com não tem nenhum no HTML: o único link dele é adicionado por um script depois que a página carrega.
- wikipedia.org/wiki/Domain_Name_System1.117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0o único link dele é adicionado por um script
Texto âncora e links em imagens
O texto âncora é o texto clicável de um link; ele diz aos leitores e ao Google do que trata o destino. Para um link em imagem, o Google lê o texto alt da imagem como âncora, então um link em imagem com alt vazio não diz nada.
Boas âncoras são curtas, específicas e descrevem o destino; “clique aqui” e “saiba mais” não dizem nada a ninguém (Google). O Google recorre ao atributo title quando um link não tem texto.
Esta ferramenta mostra o texto alt de todo link em imagem, marca os vazios e lista as âncoras repetidas. No artigo que lemos, “edit” é a âncora de 49 links: links de edição de seção, normais na Wikipedia, fracos em qualquer outro lugar.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>âncoraDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>âncoraImagemWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>âncoraVazianada: um link vazio
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank e noopener: ainda são necessários?
Não nos navegadores atuais. Um link com target="_blank" abre uma nova aba, e todos os principais navegadores hoje o tratam como rel="noopener": a nova página não consegue voltar e alterar a sua. Noopener ausente aparece como observação, não como risco.
O padrão HTML fez _blank implicar noopener em 2019 (HTML); Safari 12.1, Firefox 79 e Chrome 88 o adotaram. noreferrer também esconde de onde o visitante veio: uma escolha de privacidade e de análise, não uma correção de segurança.
<a target="_blank">sem rel nenhumwindow.opener→ null- 2019-02HTML: _blank implica noopenerwhatwg/html #4330
- 2019Safari 12.1noopener implícito
- 2020Firefox 79noopener implícito
- 2021Chrome 88noopener implícito
- dnsrobot.net/blog/hosting-com-coupon23 de 23 têm noopener ou noreferrer
- github.com10 de 10 têm noopener ou noreferrer
- developer.mozilla.org/en-US/10 de 10 têm noopener ou noreferrer
Mitos sobre links, conferidos nas páginas do próprio Google
A maioria dos conselhos sobre links repete algumas regras antigas. Veja o que a documentação do Google diz hoje sobre cada uma.
| O mito | O que o Google diz | Fonte |
|---|---|---|
| Falso“dofollow” é um atributo que você adiciona | Os links são seguidos por padrão; só nofollow, sponsored e ugc significam alguma coisa. | developers.google.com |
| FalsoNofollow em links externos faz um site ser penalizado | O Google pede nofollow ou sponsored só em links pagos e em links pelos quais você não responde. | developers.google.com |
| DesatualizadoMantenha uma página com menos de 100 links | Não há limite nem número ideal de links por página. | developers.google.com |
| FalsoNofollow mantém uma página fora do índice | Para manter uma página fora do Google, permita o rastreamento e use noindex. | developers.google.com |
| DesatualizadoLinks nofollow não passam nada | Desde 2019 são dicas: o Google pode usá-los, embora em geral ainda não os conte para o ranqueamento. | developers.google.com |
| Desatualizadotarget=_blank sem noopener é uma brecha de segurança | Os navegadores atuais implicam noopener para links _blank, a menos que rel=opener peça o opener. | html.spec.whatwg.org |
Fontes
- Google Search Central: links rastreáveis, qualificar links de saída, meta tag robots, códigos de status HTTP
- HTML Living Standard (links, valores de rel, URL base) e RFC 9110 (códigos de status)
- Cloudflare: detectando um desafio
- Os números: nossa própria execução em en.wikipedia.org/wiki/Domain_Name_System, em 23 de outubro de 2026
Perguntas frequentes sobre o analisador de links
Este link é seguro para clicar?
Como encontrar todos os links de uma página da web?
Qual é a diferença entre links internos e externos?
O que significa nofollow, e dofollow é um atributo de verdade?
Quando devo usar rel="sponsored" ou rel="ugc"?
Por que um link aparece como “Bloqueado” e não como quebrado?
Por que um link redireciona, e devo corrigi-lo?
Este leitor de links encontra links adicionados por JavaScript?
A página bloqueia leitores automáticos. Dá para analisá-la mesmo assim?
Quantos links ele verifica?
Quantos links uma página deve ter?
O analisador de links é grátis, e vocês guardam as páginas?
Sentiu falta de algo?Sugira um recurso ou uma nova ferramenta
Mais ferramentas de site e SEO
Localizador de Subdomínios
Descubra todos os subdomínios de qualquer domínio
Verificador de Site Fora do Ar
Está fora do ar para todos ou só para você? Verifique qualquer site de 11 lugares e da sua conexão, com uma captura de tela ao vivo
Verificador de Certificado SSL
Verifique a validade e detalhes de segurança do certificado SSL
Verificador de Hospedagem
Descubra quem hospeda qualquer site: hospedagem, CDN, CMS, provedor de e-mail, registrador e emissor do SSL
Consulta WHOIS
Consulte registro de domínio, registrar e detalhes do proprietário via RDAP
Verificador de Lista Negra de IP
Verifique se um endereço IP está em listas negras de spam ou malware