











Analizador de enlaces
Analice los enlaces de una página tal como los lee Google: internos o externos, seguidos o nofollow, sponsored o ugc, adónde lleva realmente cada uno y cuáles están rotos.
También sirve un dominio: example.org lee su página de inicio.
- LecturaLee el HTML una vez
- RedireccionesHasta 10, cada una verificada
- Robotsmeta + X-Robots-Tag
- Enlaces encontrados<a> y <area>
¿Qué revisa un analizador de enlaces?
Un analizador de enlaces (o analizador de links) lee una página y enumera todos sus enlaces: adónde va cada uno, cómo está marcado para los buscadores, qué dice su texto ancla y adónde lleva realmente al seguirlo.
Lee el HTML de la página como lo ve primero Googlebot. Google sigue los elementos <a> que tienen un href (Google); los enlaces relativos se resuelven con el <base href> de la página o, si no lo hay, con su dirección tras las redirecciones (HTML).
Después, cada URL única se solicita una vez, con un GET y sus redirecciones seguidas de salto en salto. Una solicitud HEAD es más rápida, pero los servidores suelen responderla distinto que una visita real, así que aquí un enlace que termina en un 404 tras una redirección cuenta como roto.
- 1Adónde vaexternowww.rfc-editor.org
- 2Cómo está marcadonofollowmw:extlinkse conserva, sin significado SEO
- 3Qué dice“1035”
- 4Adónde llega↳ 301 /info/rfc1035/OK 200185 ms
- 5Dónde estáenlace 187 de 1117, bajo “Contents”
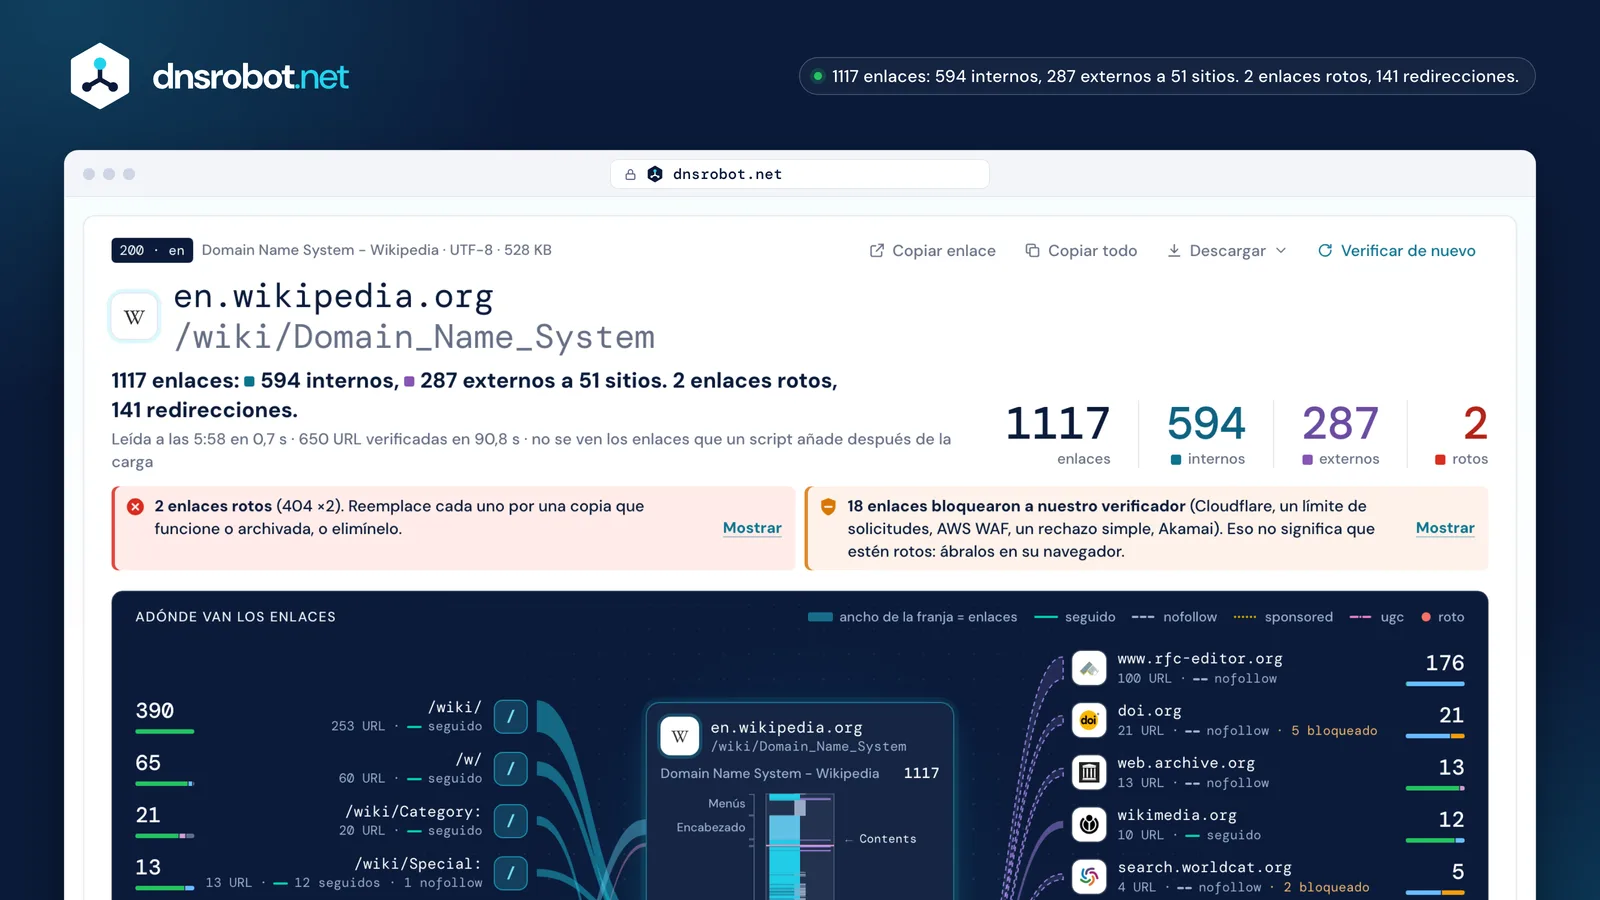
 Primero, la respuestaCuántos enlaces tiene la página, cuántos se quedan en el sitio, cuántos salen de él y cuántos están rotos.Notas con soluciónEnlaces rotos, enlaces que solo la protección antibots detuvo, redirecciones que conviene actualizar, anclas vacías: cada una con su cantidad y qué hacer.La página, de arriba abajoUna marca por enlace en el lugar donde está en la página: menús, el artículo, las referencias, el pie de página.Adónde van los enlacesUna franja por sección y por sitio, tan ancha como su número de enlaces, con línea discontinua si los enlaces son nofollow.
Enlaces internos y externos: ¿cuál es cuál?
Un enlace interno apunta al mismo host que la página; un enlace externo apunta a otro sitio web. Los enlaces a otro host del mismo sitio, como de.wikipedia.org desde en.wikipedia.org, se cuentan aparte.
Los enlaces internos ayudan a los lectores y a los rastreadores a encontrar las demás páginas de un sitio; toda página importante debería recibir un enlace de al menos otra (Google). Los enlaces externos no son un riesgo en sí mismos: citar buenas fuentes ayuda a los lectores a confiar en una página.
Google sugiere nofollow solo para los enlaces que usted no avala, no para todos los externos. Un enlace a #section se queda en la misma página, y Google no trata los fragmentos como páginas distintas (Google).
- mismo host 514
- mismo sitio, otro host 80
- otro sitio 287
- misma página 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_nameinternoMismo host que la página: interno.
- de.wikipedia.org/wiki/Domain_Name_Systemmismo sitioMismo sitio (wikipedia.org), otro host: se cuenta aparte.
- www.wikidata.org/wiki/Q8767externoOtro dominio, aunque lo administre Wikimedia: externo.
- www.rfc-editor.org/rfc/rfc1035externoOtro dominio: externo.
nofollow, sponsored y ugc (y por qué “dofollow” no es un atributo)
rel="nofollow" pide a los buscadores que no cuenten un enlace como su aval, rel="sponsored" marca un enlace de pago o un anuncio, y rel="ugc" marca un enlace escrito por sus usuarios. Un enlace sin ninguno de ellos se sigue: no existe el valor dofollow.
Desde el 10 de septiembre de 2019 los tres son indicaciones, no órdenes, y desde el 1 de marzo de 2020 también para el rastreo y la indexación (Google). Los valores se pueden combinar, como ugc nofollow, separados por espacios o comas.
El que más importa: un enlace de pago sin sponsored ni nofollow infringe las políticas contra el spam de Google (Google). En el artículo de Wikipedia que leímos, 267 de los 287 enlaces externos llevan nofollow, que MediaWiki añade a cada cita.
<a href>Seguido por defecto: no hay que añadir nadarel="nofollow"No lo avalo: cuando no encaja otro valorrel="sponsored"De pago o un anuncio: necesario en enlaces de pago (o nofollow)rel="ugc"Escrito por usuarios: comentarios, mensajes de forosrel="ugc nofollow"Ambos: permitido, para rastreadores más antiguosrel="dofollow"No es un valor: los navegadores y Google lo ignoran
- 2005Google presenta nofollow
- 2019-09-10llegan sponsored y ugc; los tres pasan a ser indicaciones
- 2020-03-01indicaciones también para rastreo e indexación
¿Y si la propia página indica nofollow?
Entonces Google no sigue ninguno de sus enlaces, diga lo que diga el rel de cada uno. Una etiqueta meta robots o una cabecera X-Robots-Tag con nofollow se aplica a toda la página; esta herramienta marca cada enlace como “nofollow (página)”.
Google lee los nombres robots y googlebot con cualquier combinación de mayúsculas, incluso en el cuerpo, y none equivale a noindex más nofollow (Google). Las mismas reglas pueden llegar como cabecera, por ejemplo X-Robots-Tag: nofollow.
Las páginas de historial de revisiones de Wikipedia llevan noindex,nofollow a propósito. La versión anterior de esta herramienta nunca leía la etiqueta y contaba 194 de los primeros 200 enlaces de una página de historial como seguidos.
de los primeros 200 enlaces: la etiqueta meta nunca se leía
enlaces, todos nofollow (página): Google no sigue ninguno
543 nofollow (página)6 nofollowX-Robots-Tag: none
Enlaces rotos: cómo analizar los enlaces de una página y corregirlos
Un enlace está roto cuando su URL responde con un error como 404 Not Found o 410 Gone, o redirige a uno, o cuando su nombre no existe. Analice la página y abra la pestaña Rotos.
Corrija cada uno enlazando la nueva dirección de la página, una copia archivada o nada. Google elimina de su índice las páginas 4xx (Google), y el lector que sigue el enlace no llega a ninguna parte.
No todo error significa roto: 401 pide iniciar sesión, así que la página existe (RFC 9110), y un 5xx o un tiempo agotado suele pasar, así que verifíquelos de nuevo más tarde. En el artículo que leímos, 2 de 656 URL estaban rotas, ambas en sus referencias; una tercera respondió un simple 403, que listamos como bloqueada.
- umbrella.cisco.com404
La página ya no existe
Cisco retiró la entrada del blog; el servidor lo dice claramente.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeEnlace la copia archivada en web.archive.org o elimine el enlace.- http://www.apwg.org301
- https://…/1H2010.pdf404
Una redirección que termina en un 404
http:// pasa a https:// y el PDF no está. Se cuenta como roto, no como redirección.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfBusque dónde está ahora el informe o cite un archivo.- www.akamai.com403
Un simple 403: bloqueado, no roto
El servidor rechazó a nuestro verificador sin señal de protección antibots. Puede que el archivo ya no exista o que el servidor rechace a los bots.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfÁbralo en su navegador; si abre, consérvelo.

Redirecciones en los enlaces: ¿conviene corregirlas?
Un enlace que redirige sigue funcionando, pero cada salto cuesta una solicitud y tiempo. Apunte los enlaces a la dirección final, sobre todo los de su propio sitio, donde usted controla ambos extremos.
Un 301 o 308 indica que el cambio es permanente; un 302, 303 o 307 es temporal, y Google sigue mostrando la dirección antigua (Google). Googlebot sigue hasta 10 saltos, los navegadores hasta 20 (Google).
rfc-editor.org ahora envía sus páginas /rfc/ a /info/, así que 175 enlaces del artículo que leímos dan un salto más. Una redirección que termina en un 404 se cuenta aquí como rota, no como redirección.
- doi.org/10.17487/RFC1035302302: temporal, la URL antigua sigue siendo la que se usa
- www.rfc-editor.org/info/rfc1035301301: cambió para siempre, enlace la URL nueva
- www.rfc-editor.org/info/rfc1035/200
enlaces apuntan a rfc-editor.org/rfc/…, que ahora pasa a /info/…
de las 656 URL de la página redirigen
saltos que Googlebot sigue como máximo; los navegadores se rinden a los 20
“Aquí aparece bloqueado, pero en mi navegador funciona”
Muchos sitios ponen protección antibots delante de sus páginas. Detiene a los visitantes que no ejecutan JavaScript o parecen automatizados, así que nuestro verificador recibe un 403 o un 429 mientras su navegador pasa. Estos enlaces se listan como Bloqueados, no como rotos.
Cloudflare marca sus desafíos con la cabecera cf-mitigated: challenge (Cloudflare) y, por defecto, desafía a los clientes con agentes de usuario inusuales; 429 significa demasiadas solicitudes (RFC 6585).
Enviamos un agente de usuario honesto y nunca intentamos eludir un bloqueo. En el artículo que leímos, 18 URL estaban bloqueadas: 17 por Cloudflare, AWS WAF, Akamai y límites de solicitudes, una por un simple 403. Ábralas usted mismo antes de cambiar nada.
- Desafío de Cloudflare7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Límite de solicitudes (429)3search.worldcat.org · api.semanticscholar.org · 429
- Protección antibots de Akamai1dyn.com → www.oracle.com · 403
¿Cuántos enlaces puede tener una página?
No hay un límite. La guía de Google no fija ningún número y dice que no existe una cantidad ideal; el viejo consejo de no pasar de 100 enlaces viene de cuando Google leía solo una parte de la página.
Lo que importa es que cada enlace ayude al lector, que los importantes sean enlaces <a href> reales en el HTML y que estén dentro de los primeros 2 MB de HTML, que es todo lo que Googlebot lee para la Búsqueda (Google).
El artículo de Wikipedia que leímos tiene 1117 enlaces en 528 KB de HTML. example.com no tiene ninguno en su HTML: su único enlace lo añade un script después de cargar la página.
- wikipedia.org/wiki/Domain_Name_System1117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0su único enlace lo añade un script
Texto ancla y enlaces de imagen
El texto ancla es el texto en el que se hace clic en un enlace; dice a los lectores y a Google de qué trata el destino. En un enlace de imagen, Google lee el texto alt de la imagen como ancla, así que un enlace de imagen con alt vacío no dice nada.
Un buen texto ancla es breve, específico y describe el destino; “haga clic aquí” y “leer más” no dicen nada a nadie (Google). Google recurre al atributo title cuando un enlace no tiene texto.
Esta herramienta muestra el texto alt de cada enlace de imagen, marca los vacíos y lista las anclas repetidas. En el artículo que leímos, “edit” es el ancla de 49 enlaces: enlaces de edición de secciones, aceptables en Wikipedia, pobres en cualquier otro sitio.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>anclaDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>anclaImagenWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>anclaVacíanada: un enlace vacío
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank y noopener: ¿siguen haciendo falta?
No en los navegadores actuales. Un enlace con target="_blank" abre una pestaña nueva, y todos los navegadores principales ya lo tratan como rel="noopener": la página nueva no puede acceder a la suya para modificarla. Que falte noopener se lista como una nota, no como un riesgo.
El estándar HTML hizo que _blank implique noopener en 2019 (HTML); Safari 12.1, Firefox 79 y Chrome 88 lo incorporaron. noreferrer además oculta de dónde vino el visitante: una decisión de privacidad y analítica, no una corrección de seguridad.
<a target="_blank">sin ningún relwindow.opener→ null- 2019-02HTML: _blank implica noopenerwhatwg/html #4330
- 2019Safari 12.1noopener implícito
- 2020Firefox 79noopener implícito
- 2021Chrome 88noopener implícito
- dnsrobot.net/blog/hosting-com-coupon23 de 23 tienen noopener o noreferrer
- github.com10 de 10 tienen noopener o noreferrer
- developer.mozilla.org/en-US/10 de 10 tienen noopener o noreferrer
Mitos sobre enlaces, contrastados con las páginas de Google
La mayoría de los consejos sobre enlaces repiten unas pocas reglas antiguas. Esto es lo que dice hoy la documentación de Google sobre cada una.
| El mito | Lo que dice Google | Fuente |
|---|---|---|
| Falso“dofollow” es un atributo que se añade | Los enlaces se siguen por defecto; solo nofollow, sponsored y ugc significan algo. | developers.google.com |
| FalsoUsar nofollow en enlaces externos penaliza a un sitio | Google pide nofollow o sponsored solo en los enlaces de pago y en los que usted no avala. | developers.google.com |
| ObsoletoUna página debe tener menos de 100 enlaces | No hay límite ni un número ideal de enlaces por página. | developers.google.com |
| FalsoNofollow mantiene una página fuera del índice | Para mantener una página fuera de Google, permita el rastreo y use noindex. | developers.google.com |
| ObsoletoLos enlaces nofollow no transmiten nada | Desde 2019 son indicaciones: Google puede usarlos, aunque por lo general sigue sin contarlos para el posicionamiento. | developers.google.com |
| Obsoletotarget=_blank sin noopener es una brecha de seguridad | Los navegadores actuales implican noopener en los enlaces _blank, salvo que rel=opener pida el opener. | html.spec.whatwg.org |
Fuentes
- Google Search Central: enlaces rastreables, calificar enlaces salientes, etiqueta meta robots, códigos de estado HTTP
- HTML Living Standard (enlaces, valores rel, URL base) y RFC 9110 (códigos de estado)
- Cloudflare: detectar un desafío
- Las cifras: nuestro propio análisis de en.wikipedia.org/wiki/Domain_Name_System, 23 de octubre de 2026
Preguntas frecuentes sobre el analizador de enlaces
¿Es seguro hacer clic en este enlace?
¿Cómo puedo analizar enlaces y encontrar todos los de una página web?
¿Qué diferencia hay entre enlaces internos y externos?
¿Qué significa nofollow y es dofollow un atributo real?
¿Cuándo debo usar rel="sponsored" o rel="ugc"?
¿Por qué un enlace aparece como “Bloqueado” y no como roto?
¿Por qué redirige un enlace y debo corregirlo?
¿Encuentra los enlaces añadidos con JavaScript?
¿Puedo analizar el link de una página que bloquea a los lectores automáticos?
¿Cuántos enlaces revisa este buscador de enlaces?
¿Cuántos enlaces debe tener una página?
¿Es gratis este analizador de links y guardan las páginas?
¿Le falta algo?Sugiera una función o una herramienta nueva
Más herramientas web y de SEO
Buscador de Subdominios
Descubre todos los subdominios de cualquier dominio
Comprobador de Páginas Caídas
¿La página está caída para todos o solo para usted? Compruebe cualquier web desde 11 lugares y desde su conexión, con una captura en vivo
Verificador de Certificado SSL
Verifica la validez y detalles de seguridad del certificado SSL
Comprobador de Hosting
Descubra quién aloja cualquier web: hosting, CDN, CMS, proveedor de correo, registrador y emisor SSL
Consulta WHOIS
Consulta registro de dominio, registrar y detalles del propietario vía RDAP
Verificador de Lista Negra IP
Verifica si una dirección IP está en listas negras de spam o malware