











Comprobador de Robots.txt
Compruebe el robots.txt de cualquier sitio con un test de robots.txt que muestra su razonamiento: la regla que decidió su URL con su número de línea, el grupo que un rastreador leyó de verdad y por qué ignoró los demás, y lo que el código de estado de su archivo significa para todo el sitio.
Escriba un dominio para leer su archivo, o una URL completa como example.com/admin/ para probar también esa ruta.
- SolicitudGET /robots.txt
- Lecturagrupos, reglas, sitemaps
- Grupoqué reglas obedece un rastreador
- Veredictoqué puede rastrear cada rastreador
Cómo comprobar su robots.txt ahora que el probador de Google ya no existe
Escriba un dominio arriba y seleccione Comprobar robots.txt. Obtenemos el archivo una vez desde nuestro servidor y después probamos contra él, en su navegador, cualquier URL que escriba, para el rastreador que elija: justo lo que hacía el propio probador de robots.txt de Google antes de que lo retiraran.
Google anunció el cambio el 15 de noviembre de 2023: “Como parte de esta actualización, vamos a retirar el probador de robots.txt”. El probador antiguo desapareció en diciembre de 2023, y el informe de robots.txt de Search Console que lo sustituyó es otra cosa.
Ese informe lista los archivos que Google ya obtuvo para los 20 hosts principales de una propiedad que usted posee y verificó, con la fecha en que se comprobaron, el tamaño en bytes y un recuento de problemas. No puede probar una URL contra una regla, probar un rastreador que no sea de Google ni revisar un sitio que no sea suyo. Esta página hace las tres cosas.
- El archivo que Google obtuvo por última vez
- Su tamaño y la fecha en que se comprobó
- Un recuento de problemas de análisis
- ¿Esta URL está permitida para este rastreador?
- Qué regla lo decidió, y en qué línea
- Un rastreador que no es de Google
- Un sitio que no es suyo
Google anunció el cambio el 15 de noviembre de 2023 y retiró el probador en diciembre de 2023.
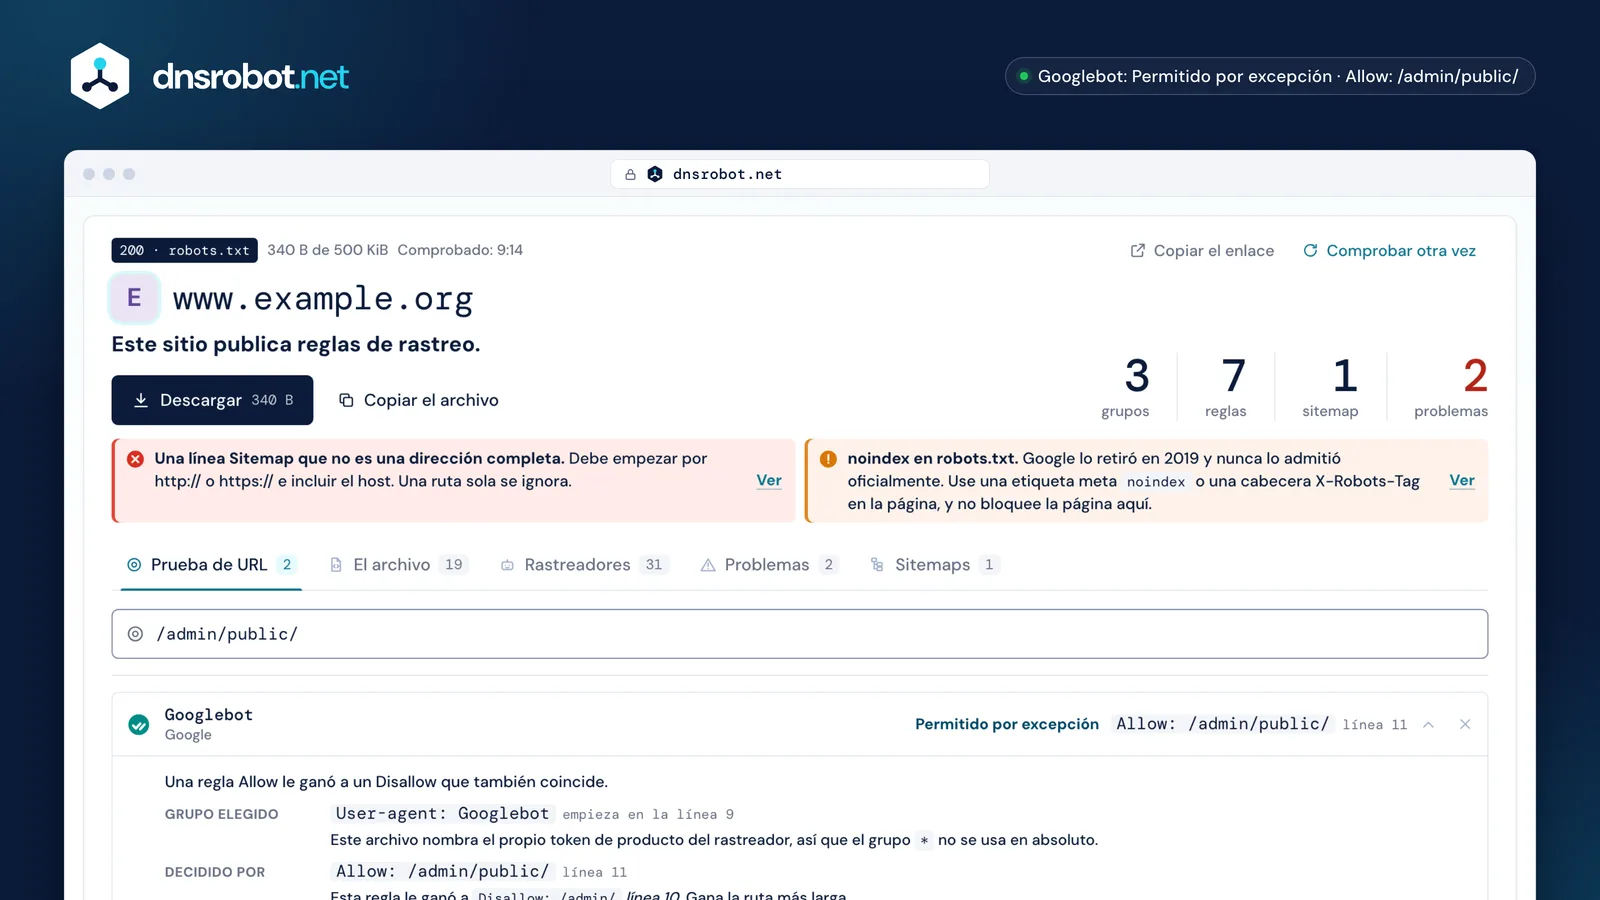
 La consecuenciaNo el código de estado por sí solo, sino lo que significa para todo el sitio. Un 404 aquí deja que cualquier rastreador lo rastree todo; un 503 significa que un rastreador que sigue el estándar no rastrea nada.La regla decisivaLa regla que decidió esta URL para este rastreador, con su número de línea y la regla a la que le ganó. Gana la coincidencia más larga, y en un empate gana Allow.El grupo elegidoQué grupo leyó de verdad el rastreador y por qué ignoró los demás. Es el paso que el resto de las herramientas omite.Los hallazgosCada problema en su propia línea del archivo, con lo que hay que hacer.
¿Cómo elige Google qué grupo se aplica a un rastreador?
Un rastreador obedece exactamente un conjunto de reglas. Busca un grupo cuya línea User-agent nombre su propio token de producto; solo si no hay ninguno recurre al grupo llamado *. El grupo * es un respaldo, nunca un añadido.
RFC 9309 lo dice claramente: “Los rastreadores DEBEN usar una coincidencia que no distinga mayúsculas de minúsculas para encontrar el grupo que coincide con el token de producto”, y “[si] no existe ningún grupo que coincida, los rastreadores DEBEN obedecer el grupo con una línea user-agent con el valor *, si existe”. Google dice lo mismo con sus palabras: “Solo un grupo es válido para un rastreador concreto”.
De ahí salen dos consecuencias que, juntas, causan casi toda la confusión. Varios grupos que nombran el mismo token se fusionan en uno, así que dos bloques User-agent: Googlebot cuentan los dos. Pero un grupo con nombre y el grupo * nunca se fusionan: un Allow: / bajo * no hace nada por Googlebot en cuanto existe un grupo Googlebot. Googlebot-Image y los demás rastreadores Googlebot-* recurren al grupo googlebot, un comportamiento que el rastreador añade por encima del comparador de reglas: el comparador de código abierto de Google no lo implementa.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1¿Un grupo nombra el propio token de este rastreador?Leer ese grupo. El grupo
*no se usa. - 2¿Lo nombran varios?Leerlos como un solo grupo.
- 3¿Existe un grupo
*?Leer el grupo*. - —No se aplica ninguna regla. Se puede rastrear todo.
Allow: / bajo * nunca se lee.
*.Allow frente a Disallow: gana la coincidencia más larga
Cuando más de una regla coincide con una URL, gana la de la ruta más larga, sea del tipo que sea. Si un Allow y un Disallow tienen la misma longitud, gana el Allow.
RFC 9309: “Se DEBE usar la coincidencia más específica que se encuentre. La coincidencia más específica es la que tiene más octetos”, y “si una regla allow y una regla disallow son equivalentes, DEBERÍA usarse la regla allow”. Google describe el mismo comportamiento: usa “la regla menos restrictiva” cuando las reglas entran en conflicto.
Octetos, no caracteres: una ruta con letras acentuadas o con un %2F se compara después de la codificación porcentual, y ahí es donde fallan las herramientas ingenuas. Solo se comparan la ruta y la consulta, desde el primer carácter, y distinguen mayúsculas de minúsculas aunque los nombres de las directivas no lo hagan: Disallow: /File.pdf no afecta a /file.pdf.
/admin/report.pdfGana el Allow: coincide con una parte mayor de la ruta.
Disallow: /files/7 caracteresAllow: /files/7 caracteresMisma longitud, así que gana el Allow. “La regla menos restrictiva”, como dice Google.
Los únicos dos comodines: `*` y `$`
* representa cualquier secuencia de caracteres, y $ marca el final de la URL. No hay nada más: ni expresiones regulares ni ningún significado especial para ?, ., [ o +, que son caracteres normales.
Una regla sin $ es un prefijo, así que Disallow: /admin también bloquea /administrator y /admin-tools. Añada una barra final (/admin/) cuando se refiera a la carpeta, y un $ cuando se refiera exactamente a esa URL. Disallow: /*.pdf$ bloquea todos los PDF; Disallow: /*? bloquea todas las URL con una cadena de consulta.
La prueba de URL de arriba muestra las rutas con las que una regla también coincide, desde el mismo comparador que produjo el veredicto, así que una regla que llega más lejos de lo que quería se ve antes de publicarla.
* y $, y lo que atrapa de verdad cada patrón/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ y + son caracteres normales. En robots.txt no hay expresiones regulares.
¿Qué significa el código de estado de su robots.txt?
Un 4xx y un 5xx en el mismo archivo roto tienen resultados opuestos. Un 4xx se interpreta como si no hubiera archivo, así que un rastreador puede rastrearlo todo. Un 5xx significa que el archivo queda indefinido, así que un rastreador que cumple el estándar no debe rastrear nada.
RFC 9309 §2.3.1.3: si el estado indica que el archivo “no está disponible para el rastreador, entonces el rastreador PUEDE acceder a cualquier recurso del servidor”. §2.3.1.4: si “es inaccesible por errores del servidor o de la red… el rastreador DEBE asumir una prohibición total”. Google trata “todos los errores 4xx, excepto 429, como si no existiera un archivo robots.txt válido”, lo que pone el 429 del lado de los 5xx.
Después Google suaviza el caso 5xx con una escala propia: deja de rastrear durante las primeras 12 horas, usa su última copia válida durante los 30 días siguientes y, después, si el resto del sitio funciona, actúa como si no hubiera ningún robots.txt. Google sigue al menos cinco saltos de redirección; después se detiene y “lo trata como un 404 para el archivo robots.txt”, lo que significa rastrear libremente. Y un nombre que no resuelve no es un sitio que bloquea a nadie: no hay archivo ni veredicto.
200Sigue las reglas del archivo.301, 302Sigue al menos cinco saltos y después se detiene. Entonces Google lee el archivo como un 404.403, 404Rastrea todo, como si no hubiera archivo.429No rastrea nada. Google lo cuenta con las respuestas 5xx, no con las 4xx.500, 503No rastrea nada en absoluto, según el estándar.El nombre no existeNo hay ningún sitio que leer, así que no hay veredicto.- 1Primeras 12 horasDeja de rastrear el sitio y sigue reintentando con el archivo
- 2Hasta 30 díasUsa su última copia válida de robots.txt
- 3Después de 30 díasSi el sitio funciona, actúa como si no hubiera robots.txt
¿robots.txt evita que una página aparezca en Google?
No. Le pide a un rastreador que no obtenga la página; no le pide a un buscador que no la liste. Google no puede leer una página bloqueada, pero “aun así puede indexar la URL y mostrarla en los resultados de búsqueda sin fragmento” cuando otras páginas enlazan a ella.
Es el estado de Search Console “Se ha indexado aunque un archivo robots.txt la tenía bloqueada”: “Google no solicitará ni rastreará la página, pero puede indexarla utilizando la información de la página que tenga un enlace a tu página bloqueada”. La solución de Google, en sus propias palabras, es “quitar el bloqueo de robots.txt y usar una directiva noindex”.
Por eso el error más común en robots.txt es una pareja, no una línea: una URL que está a la vez bloqueada aquí y lleva noindex. Google es explícito: “si la página está bloqueada por un archivo robots.txt… el rastreador nunca verá la regla noindex, y la página puede seguir apareciendo en los resultados de búsqueda”. Elija una opción: bloquear el rastreo, o dejarlo entrar y decirle que no indexe.
- Rastreador
- Lee robots.txt
- La URL está bloqueada
- No obtiene la página
<meta name="robots" content="noindex">Nunca se leePara dejar una página fuera: deje entrar al rastreador y use noindex, o exija iniciar sesión.
¿Cómo bloqueo ChatGPT, Claude y los demás rastreadores de IA?
Con un grupo normal para cada uno. Las empresas de IA publican tokens de producto igual que los buscadores, y la mayoría usa varios: uno para el entrenamiento, uno para responder una pregunta con un enlace a su sitio y uno que obtiene una página porque una persona la pidió.
Conviene distinguir esos tres. Bloquear un rastreador de entrenamiento mantiene sus páginas fuera de un modelo; bloquear un rastreador de respuestas también lo saca de las citas que muestran esos productos. La vista Rastreadores de arriba indica el propósito de cada uno, su token y lo que la propia documentación de su operador dice que obedece, para que pueda rechazar el entrenamiento sin desaparecer de las respuestas de IA.
Algunos operadores dicen abiertamente que el rastreador que obtiene una página por encargo de una persona puede ignorar robots.txt, porque actúa en nombre de un usuario en lugar de rastrear. La tabla los marca. Y las líneas Content-Signal de Cloudflare, que cada vez más sitios publican, son una declaración de para qué se puede usar su contenido, no una regla de rastreo: esta página las conserva y las explica en lugar de tratarlas como un error.
GPTBotObedeceOAI-SearchBotObedeceChatGPT-UserPuede ignorarlo
ClaudeBotObedeceClaude-SearchBotObedeceClaude-UserObedece
PerplexityBotObedecePerplexity-UserPuede ignorarloGoogle-ExtendedSolo tokenSin rastreadorSin rastreador
Applebot-ExtendedSolo tokenSin rastreadorSin rastreador
meta-externalagentObedecemeta-webindexerObedecemeta-externalfetcherPuede ignorarlo
AmazonbotObedeceSin rastreadorAmzn-UserPuede ignorarlo- EntrenamientoRecopila páginas para entrenar un modelo.
- Respuestas de IAObtiene páginas para responder una pregunta, normalmente con un enlace a su sitio.
- Petición de una personaObtiene una página porque alguien la pidió. Algunos operadores dicen que este puede ignorar robots.txt.
Crawl-delay, Clean-param, Host y Content-Signal: ¿quién lee qué?
Google lee cuatro campos y ninguno más: user-agent, allow, disallow y sitemap. Todo lo demás en un robots.txt lo lee otro, o nadie, y una línea desconocida nunca es un error.
Google lista sus cuatro campos y añade que “otros campos, como crawl-delay, no son compatibles”. Bing sí admite Crawl-delay, según el propio blog de Bing: “la directiva crawl-delay solo acepta números enteros positivos como valores”. Clean-param es de Yandex y de nadie más. Host no está ni en el estándar ni en la lista de Google.
Ninguna de ellas rompe un archivo. RFC 9309 establece que el análisis de otros registros “NO DEBE interferir con el análisis de los registros definidos explícitamente”, así que un rastreador que no conoce una línea se la salta. Las dos directivas que de verdad están muertas son noindex y nofollow dentro de robots.txt: Google retiró en 2019 el código que las manejaba, y hoy no hacen nada en Google.

User-agentLa leeLa leeLa leeAllowLa leeLa leeLa leeDisallowLa leeLa leeLa leeSitemapLa leeLa leeLa leeCrawl-delayLa ignoraLa leeSin confirmarClean-paramLa ignoraLa ignoraLa leeHostLa ignoraLa ignoraSin confirmarnoindexLa ignoraSin confirmarSin confirmarContent-SignalLa ignoraSin confirmarSin confirmar- Google admite cuatro campos y lo dice: user-agent, allow, disallow y sitemap.
- El propio blog de Bing confirma Crawl-delay. No publicamos un rango ni una unidad: la página de ayuda actual de Bing no se pudo leer para comprobarlos.
- Google lo retiró en 2019, y nunca formó parte del estándar.
- La política Content Signals de Cloudflare: una declaración sobre cómo se puede usar el contenido, no una regla de rastreo.
El límite de 500 KiB, y lo que queda por encima
Google lee los primeros 500 kibibytes de un robots.txt e ignora todo lo que viene después, sin un error en ninguna parte. RFC 9309 fija 500 KiB como el mínimo del límite de análisis de un rastreador; Google lo presenta como el máximo.
Google: “Google aplica un límite de tamaño de 500 kibibytes (KiB) a los archivos robots.txt. El contenido que supera el tamaño máximo se ignora”. Nada le avisa. Un archivo de 600 KiB no es inválido: sus últimos 100 KiB simplemente no existen para Googlebot, y un Disallow ahí abajo no protege nada.
Los sitios llegan a ese límite más a menudo de lo que parece: una regla por parámetro de campaña, por filtro facetado, por carpeta antigua de pruebas. La comprobación de arriba mide el archivo frente al límite y le dice cuánto queda por encima. Sustituya las listas largas por patrones (Disallow: /*?filter=) y ponga arriba las reglas que importan.
Disallow: /cart/ · Línea 12Se obedeceDisallow: /private/ · Línea 9412Nunca se leeEl archivo sigue respondiendo 200 y se sigue analizando. Nada le avisa en ninguna parte de que el resto se descartó.
Errores comunes en robots.txt y cómo encontrarlos
La mayoría de los robots.txt rotos fallan de una de seis maneras, y ninguna se nota hasta que algo la pone a prueba: el archivo sigue respondiendo 200, se sigue analizando y sigue pareciendo correcto.
El que todo el mundo conoce es un Disallow: / olvidado cuando un sitio pasa de pruebas a producción. Los otros cinco: una regla que llega más lejos de lo que quería, como Disallow: /admin, que también atrapa /administrator; un Allow: / bajo * que un grupo con nombre ignora sin decir nada; una línea Sitemap: escrita como ruta en lugar de dirección completa; una ruta sin barra inicial, que no coincide con nada; y una línea noindex, que Google dejó de leer en 2019.
Haga la comprobación de arriba y después lea la vista Problemas: cada hallazgo está en su propia línea del archivo, con lo que hay que hacer. Si está editando el archivo en lugar de auditarlo, el generador de robots.txt escribe un archivo que este mismo comprobador ya ha leído.
Fuentes
- RFC 9309, el Protocolo de Exclusión de Robots: grupos, precedencia, coincidencia con codificación porcentual, códigos de estado y el mínimo de 500 KiB
- Google Search Central: cómo interpreta Google robots.txt, crear y enviar un archivo robots.txt y bloquear la indexación con noindex
- Ayuda de Google Search Console: el informe de robots.txt y el informe de indexación de páginas
- Bing: Crawl-delay y el rastreador de Bing y Yandex: Clean-param
- El analizador de robots.txt de código abierto de Google, el comparador que usa el propio Googlebot
- El token, el propósito y el comportamiento ante robots.txt de cada rastreador salen de la documentación de su propio operador, enlazada junto a él en la vista Rastreadores
Disallow: /Restos de un entorno de pruebas: todo el sitio publicado queda cerrado a todos los rastreadores.Disallow: /adminTambién bloquea /administrator y /admin-tools. Añada la barra final.Allow: / bajo User-agent: *Nunca lo lee un rastreador que tenga su propio grupo en cualquier parte del archivo.Sitemap: /sitemap.xmlUna línea Sitemap debe ser una dirección completa con el host.Disallow: adminUna ruta empieza en /. Esta regla no coincide con nada.noindex: /private/Muerto desde 2019. La página sigue siendo rastreable e indexable.Preguntas frecuentes sobre el test de robots.txt
¿Qué pasó con el probador de robots.txt de Google?
¿Por qué se ignora mi Allow: / bajo User-agent: *?
* se omite por completo: es un respaldo, no un añadido. Los grupos solo se fusionan cuando varios nombran el mismo token. La prueba de URL de arriba muestra qué grupo se eligió para cada rastreador y por qué no los demás.¿robots.txt impide que una página se indexe?
noindex o una cabecera X-Robots-Tag, o ponga la página tras un inicio de sesión.¿Por qué no funciona mi noindex?
noindex incluido, así que la página puede seguir apareciendo en los resultados de búsqueda por enlaces desde otros sitios. Google lo dice directamente: la página “no debe estar bloqueada por un archivo robots.txt” para que noindex surta efecto. Quite la línea Disallow y conserve el noindex.¿Qué significa un 404 en robots.txt? ¿Y un 500?
Si un Allow y un Disallow coinciden, ¿cuál gana?
¿Qué comodines funcionan en robots.txt?
* representa cualquier secuencia de caracteres y $ marca el final de la URL. Todo lo demás es literal: ?, ., [, ] y + coinciden consigo mismos, y no hay expresiones regulares. Una regla sin $ es un prefijo, así que Disallow: /admin también atrapa /administrator. Las rutas distinguen mayúsculas de minúsculas, pero los nombres de directiva como Disallow no.¿Google admite Crawl-delay?
¿Qué tamaño puede tener un archivo robots.txt?
¿Cómo bloqueo rastreadores de IA como GPTBot y ClaudeBot?
Disallow: /, como a un buscador. Casi todas las empresas de IA usan varios rastreadores: uno para el entrenamiento, uno para responder preguntas con un enlace a su sitio y uno que obtiene una página a petición de una persona. La vista Rastreadores de arriba nombra cada token, su propósito y lo que su operador dice que obedece, para rechazar el entrenamiento sin perder las citas en respuestas de IA.¿Comprobar un robots.txt es lo mismo que validarlo?
¿robots.txt es un riesgo de seguridad?
Disallow: /admin-backup/ es un letrero que apunta justo a lo que quería esconder. Nada en él impide el acceso; un rastreador lo obedece solo porque su operador así lo decidió. Proteja las rutas privadas con autenticación o con una regla de firewall, y este comprobador le señalará las rutas de su archivo que parecen una invitación.¿Le falta algo?Sugiera una función o una herramienta nueva
Más herramientas de rastreo e indexación
Comprobador de Sitemap
Encuentre y valide el sitemap XML de un sitio web: sintaxis, límites de URL, fechas lastmod, conflictos con robots.txt y URL rotas o redirigidas
Generador de Sitemap
Rastrea tu sitio web y obtén un sitemap XML, un mapa del sitio HTML y un árbol visual del sitio
Verificador de encabezados HTTP
Analiza cabeceras de respuesta HTTP y clasificación de cabeceras de seguridad
Verificador de Redirecciones
Verifica redirecciones de URL, cadenas de redirección y códigos de estado HTTP para SEO
Cuál Es Mi User Agent
Detecta tu navegador, SO, tipo de dispositivo, motor de renderizado y arquitectura de CPU desde tu user agent
Analizador de Enlaces
Analiza todos los enlaces de una página con detección dofollow/nofollow y verificación de estado HTTP