











Cek Robots.txt
Alat cek robots.txt yang menunjukkan cara kerjanya: aturan yang memutuskan URL Anda beserta nomor barisnya, grup yang benar-benar dibaca crawler dan alasan grup lain diabaikan, serta arti kode status file Anda bagi seluruh situs. Untuk cek robot txt situs mana pun, cukup masukkan domainnya.
Masukkan domain untuk membaca file-nya, atau URL lengkap seperti example.com/admin/ untuk sekaligus mengetes path itu.
- AmbilGET /robots.txt
- Bacagrup, aturan, sitemap
- Grupaturan mana yang dipatuhi crawler
- Putusanapa yang boleh dirayapi tiap crawler
Cara cek robots.txt setelah penguji robots.txt Google dihentikan
Masukkan domain di atas lalu pilih Cek robots.txt. Kami mengambil file-nya sekali dari server kami, lalu mengetes setiap URL yang Anda ketik terhadap file itu di browser Anda, untuk crawler apa pun yang Anda pilih — persis yang dulu dilakukan penguji robots.txt milik Google sebelum dihentikan.
Google mengumumkan perubahan ini pada 15 November 2023: “Sebagai bagian dari pembaruan ini, kami menghentikan penguji robots.txt.” Penguji lama itu hilang pada Desember 2023, dan laporan robots.txt di Search Console yang menggantikannya adalah alat yang sama sekali berbeda.
Laporan itu mendaftar file yang sudah diambil Google untuk 20 host teratas di properti yang Anda miliki dan sudah Anda verifikasi, beserta tanggal pengecekannya, ukurannya dalam byte, dan jumlah masalahnya. Laporan itu tidak bisa mengetes URL terhadap sebuah aturan, mengetes crawler yang bukan milik Google, atau melihat situs yang bukan milik Anda. Halaman ini bisa melakukan ketiganya.
- File yang terakhir diambil Google
- Ukurannya dan tanggal pengecekannya
- Jumlah masalah penguraian
- Apakah URL ini diizinkan untuk crawler ini?
- Aturan mana yang memutuskan, dan di baris berapa
- Crawler yang bukan milik Google
- Situs yang bukan milik Anda
Google mengumumkan perubahan ini pada 15 November 2023 dan menghapus penguji itu pada Desember 2023.
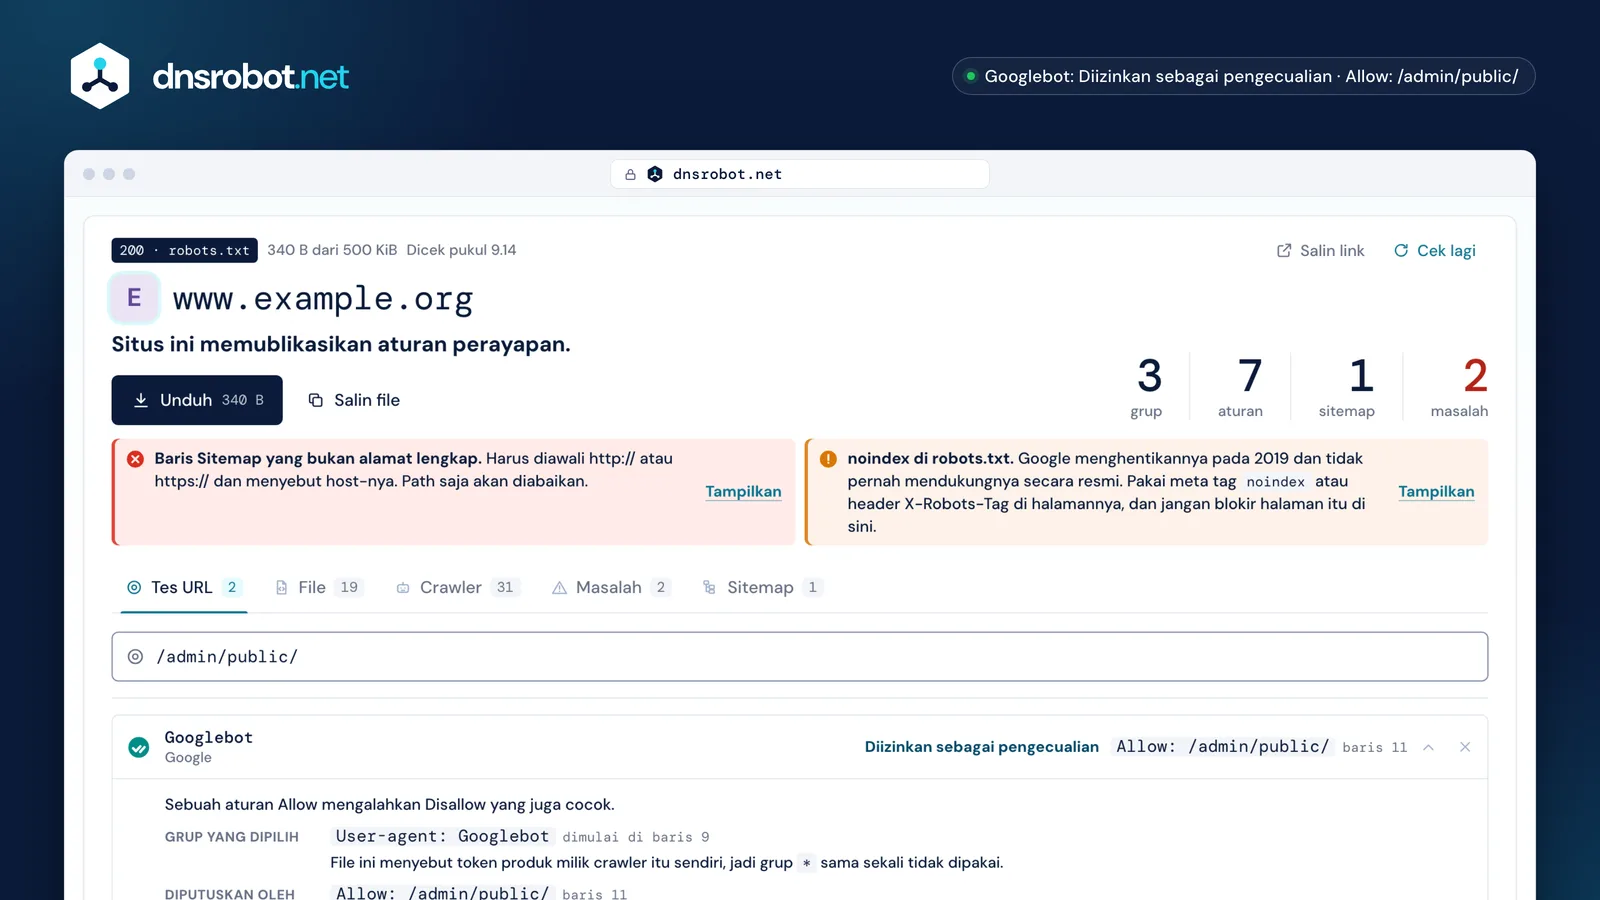
 KonsekuensinyaBukan sekadar kode statusnya, melainkan artinya bagi seluruh situs. 404 di sini membuat setiap crawler boleh mengambil semuanya; 503 berarti crawler yang mengikuti standar tidak mengambil apa pun.Aturan penentuAturan yang memutuskan URL ini untuk crawler ini, beserta nomor barisnya dan aturan yang dikalahkannya. Kecocokan terpanjang menang, dan Allow menang jika seri.Grup yang dipilihGrup mana yang benar-benar dibaca crawler, dan kenapa grup lain diabaikan. Langkah inilah yang dilewatkan alat-alat lain.TemuanSetiap masalah di barisnya sendiri dalam file, beserta apa yang perlu dilakukan.
Bagaimana Google memilih grup yang berlaku untuk sebuah crawler?
Crawler mematuhi tepat satu kumpulan aturan. Crawler mencari grup yang baris User-agent-nya menyebut token produknya sendiri; hanya jika tidak ada, crawler beralih ke grup bernama *. Grup * adalah cadangan, bukan tambahan.
RFC 9309 menyatakannya dengan jelas: “Crawler HARUS memakai pencocokan yang tidak peka huruf besar/kecil untuk menemukan grup yang cocok dengan token produk”, dan “[jika] tidak ada grup yang cocok, crawler HARUS mematuhi grup dengan baris user-agent bernilai *, jika ada.” Google mengatakan hal yang sama dengan kata-katanya sendiri: “Hanya satu grup yang valid untuk crawler tertentu.”
Ada dua akibatnya, dan bersama-sama keduanya menimbulkan sebagian besar kebingungan. Beberapa grup yang menyebut token yang sama digabung menjadi satu, jadi dua blok User-agent: Googlebot sama-sama berlaku. Tetapi grup bernama dan grup * tidak pernah digabung: Allow: / di bawah * tidak berpengaruh apa pun bagi Googlebot begitu ada grup Googlebot. Googlebot-Image dan crawler Googlebot-* lainnya beralih ke grup googlebot, yaitu perilaku yang ditambahkan crawler di atas mesin pencocokan — mesin pencocokan open source milik Google sendiri tidak menerapkannya.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Ada grup yang menyebut token crawler ini sendiri?Baca grup itu. Grup
*tidak dipakai. - 2Lebih dari satu grup menyebutnya?Baca semuanya sebagai satu grup.
- 3Ada grup
*?Baca grup*. - —Tidak ada aturan yang berlaku. Semuanya boleh dirayapi.
Allow: / di bawah * tidak pernah dibaca.
*.Allow vs Disallow: kecocokan terpanjang yang menang
Jika lebih dari satu aturan cocok dengan sebuah URL, aturan dengan path terpanjang yang menang, apa pun jenisnya. Jika Allow dan Disallow sama panjang, Allow yang menang.
RFC 9309: “Kecocokan paling spesifik yang ditemukan HARUS dipakai. Kecocokan paling spesifik adalah kecocokan dengan oktet terbanyak”, dan “jika aturan allow dan aturan disallow setara, aturan allow SEBAIKNYA dipakai.” Google menjelaskan perilaku yang sama: jika terdapat aturan yang bertentangan, Google menggunakan “aturan yang paling longgar”.
Oktet, bukan karakter: path yang memuat huruf beraksen atau %2F dibandingkan setelah percent-encoding, dan di situlah alat-alat yang naif keliru. Hanya path dan query yang dibandingkan, mulai dari karakter pertama, dan keduanya peka huruf besar/kecil meskipun nama direktif tidak — Disallow: /File.pdf tidak berpengaruh apa pun pada /file.pdf.
/admin/report.pdfAllow menang: aturan ini cocok dengan bagian path yang lebih panjang.
Disallow: /files/7 karakterAllow: /files/7 karakterPanjangnya sama, jadi Allow menang. “Aturan yang paling longgar”, menurut Google.
Hanya dua wildcard: `*` dan `$`
* mewakili rangkaian karakter apa pun, dan $ menandai akhir URL. Tidak ada yang lain: tidak ada regular expression, dan tidak ada makna khusus untuk ?, ., [, atau +, yang semuanya karakter biasa.
Aturan tanpa $ adalah awalan (prefix), jadi Disallow: /admin juga memblokir /administrator dan /admin-tools. Tambahkan garis miring di akhir (/admin/) jika yang Anda maksud foldernya, dan $ jika yang Anda maksud persis URL itu. Disallow: /*.pdf$ memblokir setiap PDF; Disallow: /*? memblokir setiap URL yang memiliki query string.
Tes URL di atas menunjukkan path lain yang juga terjaring sebuah aturan, dari mesin pencocokan yang sama yang menghasilkan putusannya, sehingga aturan yang menjangkau lebih jauh dari maksud Anda sudah terlihat sebelum Anda memublikasikannya.
* dan $, dan apa yang benar-benar dijaring tiap pola/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [, dan + adalah karakter biasa. Tidak ada regular expression di robots.txt.
Apa arti kode status robots.txt Anda?
4xx dan 5xx pada file rusak yang sama memberi hasil yang berlawanan. 4xx dibaca seolah-olah tidak ada file, jadi crawler boleh mengambil semuanya. 5xx berarti file-nya tidak terdefinisi, jadi crawler yang patuh tidak boleh mengambil apa pun.
RFC 9309 §2.3.1.3: jika status menunjukkan file “tidak tersedia bagi crawler, crawler BOLEH mengakses sumber daya apa pun di server”. §2.3.1.4: jika file “tidak dapat dijangkau karena error server atau jaringan… crawler HARUS menganggap disallow total.” Crawler Google memperlakukan “semua error 4xx, kecuali 429, seolah-olah file robots.txt yang valid tidak ada”, sehingga 429 berada di sisi 5xx.
Google lalu melunakkan kasus 5xx dengan tahapannya sendiri: berhenti merayapi selama 12 jam pertama, memakai salinan valid terakhirnya selama 30 hari berikutnya, dan setelah itu, jika bagian situs lainnya aktif, bersikap seolah-olah tidak ada robots.txt sama sekali. Google mengikuti setidaknya lima kali redirect, lalu berhenti dan “memperlakukannya sebagai 404 untuk file robots.txt”, yang berarti bebas dirayapi. Dan nama yang tidak bisa di-resolve bukanlah situs yang memblokir siapa pun — tidak ada file, dan tidak ada putusan.
200Mengikuti aturan di file.301, 302Mengikuti setidaknya lima kali redirect, lalu berhenti. Setelah itu Google menganggap file-nya 404.403, 404Merayapi semuanya, seolah-olah tidak ada file.429Tidak merayapi apa pun. Google menggolongkannya bersama jawaban 5xx, bukan 4xx.500, 503Tidak merayapi apa pun sama sekali, menurut standar.Nama tidak adaTidak ada situs untuk dibaca, jadi tidak ada putusan.- 112 jam pertamaBerhenti merayapi situs dan terus mencoba mengambil file-nya
- 2Hingga 30 hariMemakai salinan valid terakhir robots.txt
- 3Setelah 30 hariJika situs aktif, bersikap seolah-olah tidak ada robots.txt
Apakah robots.txt mencegah halaman muncul di Google?
Tidak. robots.txt meminta crawler untuk tidak mengambil halaman, bukan meminta mesin pencari untuk tidak mencantumkannya. Google tidak dapat membaca halaman yang diblokir, tetapi “masih dapat mengindeks URL dan menampilkannya di hasil penelusuran tanpa cuplikan” jika halaman lain menautkan ke sana.
Itulah status Search Console “Diindeks, meskipun diblokir oleh robots.txt”: “Google tidak akan meminta dan meng-crawl halaman, tetapi kami masih dapat mengindeksnya dengan menggunakan informasi dari halaman yang tertaut ke halaman yang diblokir.” Solusi Google sendiri, dengan kata-katanya: “hapus pemblokiran robots.txt dan gunakan perintah noindex”.
Karena itu, kesalahan paling umum di robots.txt adalah sepasang, bukan satu baris: URL yang sekaligus diblokir di sini dan memuat noindex. Google menyatakannya dengan tegas: “Jika halaman diblokir oleh file robots.txt… crawler tidak akan dapat melihat aturan noindex dan halaman tetap dapat muncul di hasil penelusuran”. Pilih salah satu: blokir perayapannya, atau izinkan crawler masuk dan minta agar tidak mengindeks.
- Crawler
- Membaca robots.txt
- URL-nya diblokir
- Tidak mengambil halamannya
<meta name="robots" content="noindex">Tidak pernah terbacaAgar halaman tidak muncul: izinkan crawler masuk dan pakai noindex, atau wajibkan login.
Bagaimana cara memblokir ChatGPT, Claude, dan crawler AI lainnya?
Dengan satu grup biasa untuk masing-masing. Perusahaan AI memublikasikan token produk persis seperti mesin pencari, dan sebagian besar menjalankan beberapa crawler: satu untuk pelatihan, satu untuk menjawab pertanyaan dengan link kembali ke situs Anda, dan satu yang mengambil halaman karena seseorang memintanya.
Ketiganya perlu dibedakan. Memblokir crawler pelatihan menjauhkan halaman Anda dari sebuah model; memblokir crawler jawaban juga menghilangkan Anda dari kutipan sumber yang ditampilkan produk-produk itu. Tampilan Crawler di atas menyebut tujuan, token, dan apa yang menurut dokumentasi operatornya sendiri dipatuhi tiap crawler, sehingga Anda bisa menolak pelatihan tanpa menghilang dari jawaban AI.
Sebagian operator terang-terangan menyatakan bahwa crawler yang mengambil halaman atas nama satu orang bisa mengabaikan robots.txt, karena crawler itu bertindak untuk pengguna, bukan merayapi. Tabelnya menandai crawler semacam itu. Dan baris Content-Signal dari Cloudflare, yang kini dipublikasikan makin banyak situs, adalah pernyataan tentang untuk apa konten Anda boleh dipakai, bukan aturan perayapan: halaman ini menyimpannya dan menjelaskannya alih-alih menyebutnya error.
GPTBotMematuhiOAI-SearchBotMematuhiChatGPT-UserBisa mengabaikan
ClaudeBotMematuhiClaude-SearchBotMematuhiClaude-UserMematuhi
PerplexityBotMematuhiPerplexity-UserBisa mengabaikanGoogle-ExtendedHanya tokenTidak ada crawler seperti ituTidak ada crawler seperti itu
Applebot-ExtendedHanya tokenTidak ada crawler seperti ituTidak ada crawler seperti itu
meta-externalagentMematuhimeta-webindexerMematuhimeta-externalfetcherBisa mengabaikan
AmazonbotMematuhiTidak ada crawler seperti ituAmzn-UserBisa mengabaikan- PelatihanMengumpulkan halaman untuk melatih model.
- Jawaban AIMengambil halaman untuk menjawab pertanyaan, biasanya dengan link kembali ke situs Anda.
- Permintaan satu orangMengambil satu halaman karena seseorang memintanya. Sebagian operator menyatakan crawler ini bisa mengabaikan robots.txt.
Crawl-delay, Clean-param, Host, dan Content-Signal: siapa membaca apa?
Google membaca empat kolom dan tidak ada yang lain: user-agent, allow, disallow, dan sitemap. Semua hal lain di robots.txt dibaca oleh pihak lain, atau tidak dibaca siapa pun — dan baris yang tidak dikenal tidak pernah menjadi error.
Google mendaftar keempat kolomnya dan menambahkan bahwa “kolom lain seperti crawl-delay tidak didukung”. Bing memang mendukung Crawl-delay, menurut blog Bing sendiri: “direktif crawl-delay hanya menerima bilangan bulat positif sebagai nilai”. Clean-param adalah milik Yandex dan tidak dibaca siapa pun selain Yandex. Host tidak ada di standar maupun di daftar Google.
Tidak satu pun dari direktif itu merusak file. RFC 9309 mensyaratkan bahwa penguraian record lain “TIDAK BOLEH mengganggu penguraian record yang didefinisikan secara eksplisit”, jadi crawler yang tidak mengenal sebuah baris akan melewatinya. Dua direktif yang benar-benar sudah mati adalah noindex dan nofollow di dalam robots.txt: Google menghapus kode yang menanganinya pada 2019, dan keduanya tidak berpengaruh apa pun di Google saat ini.

User-agentMembacanyaMembacanyaMembacanyaAllowMembacanyaMembacanyaMembacanyaDisallowMembacanyaMembacanyaMembacanyaSitemapMembacanyaMembacanyaMembacanyaCrawl-delayMengabaikannyaMembacanyaBelum terkonfirmasiClean-paramMengabaikannyaMengabaikannyaMembacanyaHostMengabaikannyaMengabaikannyaBelum terkonfirmasinoindexMengabaikannyaBelum terkonfirmasiBelum terkonfirmasiContent-SignalMengabaikannyaBelum terkonfirmasiBelum terkonfirmasi- Google mendukung empat kolom dan menyatakannya: user-agent, allow, disallow, dan sitemap.
- Blog Bing sendiri mengonfirmasi Crawl-delay. Kami tidak mencantumkan rentang atau satuan nilainya: halaman bantuan Bing saat ini tidak bisa dibaca untuk memeriksanya.
- Dihentikan Google pada 2019, dan tidak pernah menjadi bagian dari standar.
- Content Signals Policy dari Cloudflare: pernyataan tentang bagaimana konten boleh dipakai, bukan aturan perayapan.
Batas 500 KiB, dan apa yang melewatinya
Google membaca 500 kibibyte pertama sebuah robots.txt dan mengabaikan semua setelahnya, tanpa error di mana pun. RFC 9309 menetapkan 500 KiB sebagai nilai minimum untuk batas penguraian sebuah crawler; Google menyatakannya sebagai nilai maksimum.
Google: “Google menerapkan batas maksimal ukuran file robots.txt sebesar 500 kibibyte (KiB). Konten yang melampaui ukuran file maksimum akan diabaikan.” Tidak ada yang memperingatkan Anda. File 600 KiB tidak invalid — 100 KiB terakhirnya hanya tidak ada bagi Googlebot, dan Disallow di bagian bawah itu tidak melindungi apa pun.
Situs mencapai batas ini lebih sering dari yang Anda kira: satu aturan per parameter kampanye, per filter faset, per folder staging lama. Pengecekan di atas mengukur file terhadap batas itu dan memberi tahu berapa banyak isinya yang melewatinya. Ganti daftar panjang dengan pola (Disallow: /*?filter=), dan letakkan aturan yang penting di bagian atas.
Disallow: /cart/ · Baris 12DipatuhiDisallow: /private/ · Baris 9.412Tidak pernah terbacaFile-nya tetap menjawab 200 dan tetap bisa diurai. Tidak ada yang memberi tahu Anda bahwa sisanya dibuang.
Kesalahan robots.txt yang umum, dan cara menemukannya
Kebanyakan file robots.txt yang rusak mengalami salah satu dari enam kesalahan, dan tidak satu pun terlihat sebelum ada yang mengetesnya: file-nya tetap menjawab 200, tetap bisa diurai, dan tetap terlihat benar.
Yang semua orang tahu adalah Disallow: / yang tertinggal ketika situs pindah dari staging ke live. Lima lainnya: aturan yang menjangkau lebih jauh dari maksud Anda, seperti Disallow: /admin, yang juga menjaring /administrator; Allow: / di bawah * yang diam-diam diabaikan oleh grup bernama; baris Sitemap: yang ditulis sebagai path, bukan alamat lengkap; path tanpa garis miring di depan, yang tidak cocok dengan apa pun; dan baris noindex, yang tidak lagi dibaca Google sejak 2019.
Jalankan pengecekan di atas, lalu baca tampilan Masalah: setiap temuan ada di barisnya sendiri dalam file, beserta apa yang perlu dilakukan. Jika Anda sedang menyunting file-nya alih-alih mengauditnya, Pembuat Robots.txt menulis file yang sudah dibaca oleh pemeriksa yang sama ini.
Sumber
- RFC 9309, Robots Exclusion Protocol: grup, urutan prioritas, pencocokan setelah percent-encoding, kode status, dan batas minimum 500 KiB
- Google Search Central: cara Google menafsirkan robots.txt, membuat dan mengirimkan file robots.txt, dan memblokir pengindeksan dengan noindex
- Bantuan Google Search Console: laporan robots.txt dan laporan Pengindeksan halaman
- Bing: Crawl-delay dan crawler Bing dan Yandex: Clean-param
- Parser robots.txt open source milik Google, mesin pencocokan yang dipakai Googlebot sendiri
- Token, tujuan, dan perilaku robots.txt setiap crawler berasal dari dokumentasi operatornya sendiri, yang ditautkan di sebelahnya dalam tampilan Crawler
Disallow: /Sisa dari staging: seluruh situs yang sudah live tertutup untuk setiap crawler.Disallow: /adminJuga memblokir /administrator dan /admin-tools. Tambahkan garis miring di akhir.Allow: / di bawah User-agent: *Tidak pernah dibaca oleh crawler yang punya grup sendiri di bagian mana pun dalam file.Sitemap: /sitemap.xmlBaris Sitemap harus berupa alamat lengkap beserta host-nya.Disallow: adminPath dimulai dari /. Aturan ini tidak cocok dengan apa pun.noindex: /private/Mati sejak 2019. Halamannya tetap bisa dirayapi dan diindeks.Cek robots.txt: pertanyaan umum
Apa yang terjadi dengan penguji robots.txt milik Google?
Kenapa Allow: / saya di bawah User-agent: * diabaikan?
* dilewati sepenuhnya — grup itu cadangan, bukan tambahan. Grup hanya digabung jika beberapa di antaranya menyebut token yang sama. Tes URL di atas menunjukkan grup mana yang dipilih untuk tiap crawler dan kenapa grup lain tidak.Apakah robots.txt mencegah halaman diindeks?
noindex atau header X-Robots-Tag, atau letakkan halaman di balik login.Kenapa noindex saya tidak berfungsi?
noindex, sehingga halaman bisa terus muncul di hasil penelusuran lewat link dari tempat lain. Google menyatakannya langsung: agar noindex efektif, halaman “tidak boleh diblokir oleh file robots.txt”. Hapus baris Disallow-nya dan pertahankan noindex.Apa arti 404 pada robots.txt? Dan 500?
Jika Allow dan Disallow sama-sama cocok, mana yang menang?
Wildcard apa saja yang berfungsi di robots.txt?
* mewakili rangkaian karakter apa pun dan $ menandai akhir URL. Selebihnya literal: ?, ., [, ], dan + hanya cocok dengan dirinya sendiri, dan tidak ada regular expression. Aturan tanpa $ adalah awalan, jadi Disallow: /admin juga menjaring /administrator. Path peka huruf besar/kecil, sedangkan nama direktif seperti Disallow tidak.Apakah Google mendukung Crawl-delay?
Seberapa besar ukuran file robots.txt yang diperbolehkan?
Bagaimana cara memblokir crawler AI seperti GPTBot dan ClaudeBot?
Disallow: /, persis seperti untuk mesin pencari. Sebagian besar perusahaan AI menjalankan beberapa crawler dengan tugas berbeda: satu untuk pelatihan, satu untuk menjawab pertanyaan dengan link kembali ke situs Anda, dan satu yang mengambil satu halaman atas nama seseorang. Tampilan Crawler di atas menyebut tiap token, tujuannya, dan apa yang menurut operatornya dipatuhi, sehingga Anda bisa menolak pelatihan tanpa kehilangan kutipan di jawaban AI.Apakah cek robots.txt sama dengan validasi robots.txt?
Apakah robots.txt berisiko bagi keamanan?
Disallow: /admin-backup/ justru menjadi papan penunjuk ke hal yang ingin Anda sembunyikan. Tidak ada isinya yang mencegah akses; crawler mematuhinya hanya karena operatornya memilih begitu. Lindungi path privat dengan autentikasi atau aturan firewall, dan pemeriksa ini akan menunjukkan path di file Anda yang terbaca seperti undangan.Ada yang kurang?Usulkan fitur atau alat baru
Alat perayapan dan pengindeksan lainnya
Pemeriksa Sitemap
Temukan dan validasi sitemap XML sebuah website: sintaks, batas URL, tanggal lastmod, konflik robots.txt, serta URL rusak atau redirect
Pembuat Sitemap
Jelajahi website Anda dan dapatkan sitemap XML, sitemap HTML, dan pohon situs
Cek HTTP Header
Analisis header respons HTTP dan penilaian header keamanan
Cek Redirect
Periksa pengalihan URL, rantai pengalihan, dan kode status HTTP untuk SEO
User Agent Saya Apa
Deteksi browser, OS, jenis perangkat, mesin rendering, dan arsitektur CPU dari string user agent Anda
Analisis Tautan
Analisis semua tautan di halaman web dengan deteksi dofollow/nofollow dan pemeriksaan status HTTP