











Cek Meta Tag
Cek meta tag yang mengukur, bukan menghitung: judul dan meta description sebuah halaman dalam piksel, di titik hasil Google memotongnya, lalu apakah halaman itu bisa diindeks dan seperti apa link-nya saat dibagikan.
Kami membaca halaman dari server kami seperti cara Google membaca head-nya, lalu mengukur judul dan deskripsi dalam piksel.
Berapa panjang meta description yang ideal?
Sepanjang yang dibutuhkan untuk menggambarkan halaman: Google tidak menetapkan batas maksimum dan memotong cuplikan agar muat di lebar layar, bukan pada jumlah karakter tertentu. Pihak ketiga mengamati ruang itu sekitar 920 piksel di desktop dan 680 di ponsel; menurut pengukuran kami dalam Arial, teks bahasa Indonesia yang umum mengisinya pada sekitar 140 dan 105 karakter.
Menurut Google: “Tidak ada batas karakter untuk panjang deskripsi meta, tetapi cuplikan dapat dipotong di hasil Google Penelusuran sesuai kebutuhan, biasanya agar pas dengan lebar layar perangkat” (Google). Satuannya adalah lebar, jadi hurufnya yang menentukan. Diukur dalam Arial pada 14 px, iiiiii selebar 19 px dan WWWWWW 79 px; karakter Jepang berlebar penuh, jadi ruang yang sama hanya memuat sekitar separuhnya; bahasa Korea, yang ditulis dengan spasi, sekitar dua pertiganya.
Karena itu, angka “155 sampai 160 karakter” yang sering disebut hanyalah patokan kasar, bukan batas, dan pemeriksa meta description yang menghitung karakter bisa salah ke dua arah. Deskripsi 134 karakter dengan huruf biasa muat di hasil desktop dengan ruang tersisa; kata-kata yang sama dalam huruf kapital melewati tepinya sejauh 143 px. Saran seperti “50–60 karakter, yaitu 580 piksel” memperlakukan kedua satuan itu seolah bisa dipertukarkan, padahal tidak.
Panjang tidak berpengaruh pada peringkat: Google menyatakan pada 2009 bahwa deskripsi tidak dipakai untuk peringkat, dan dokumentasinya tidak menyebut penalti apa pun untuk deskripsi yang panjang atau tidak ada. Google juga sering menulis cuplikannya sendiri dari halaman; dua studi pihak ketiga melihatnya mengganti deskripsi di sekitar dua dari tiga hasil. Tulis untuk pembaca: unik untuk halaman itu, ringkasan yang sebenarnya, bukan daftar kata kunci, dengan kata-kata penting di depan.
Satu-satunya tempat Google benar-benar menghitung karakter adalah aturan robots max-snippet: angkanya adalah jumlah karakter, dengan 0 berarti tanpa cuplikan dan -1 membiarkan Google memilih (Google).
Gratis retur untuk semua sepatu hiking. Kulit tahan air, sol anti selip, dan garansi dua tahun. Pesan sebelum pukul 15.00, tiba besok.
GRATIS RETUR UNTUK SEMUA SEPATU HIKING. KULIT TAHAN AIR, SOL ANTI SELIP, DAN GARANSI DUA TAHUN. PESAN SEBELUM PUKUL 15.00, TIBA BESOK.
Ruang ini teramati oleh pihak ketiga; Google tidak memublikasikannya.
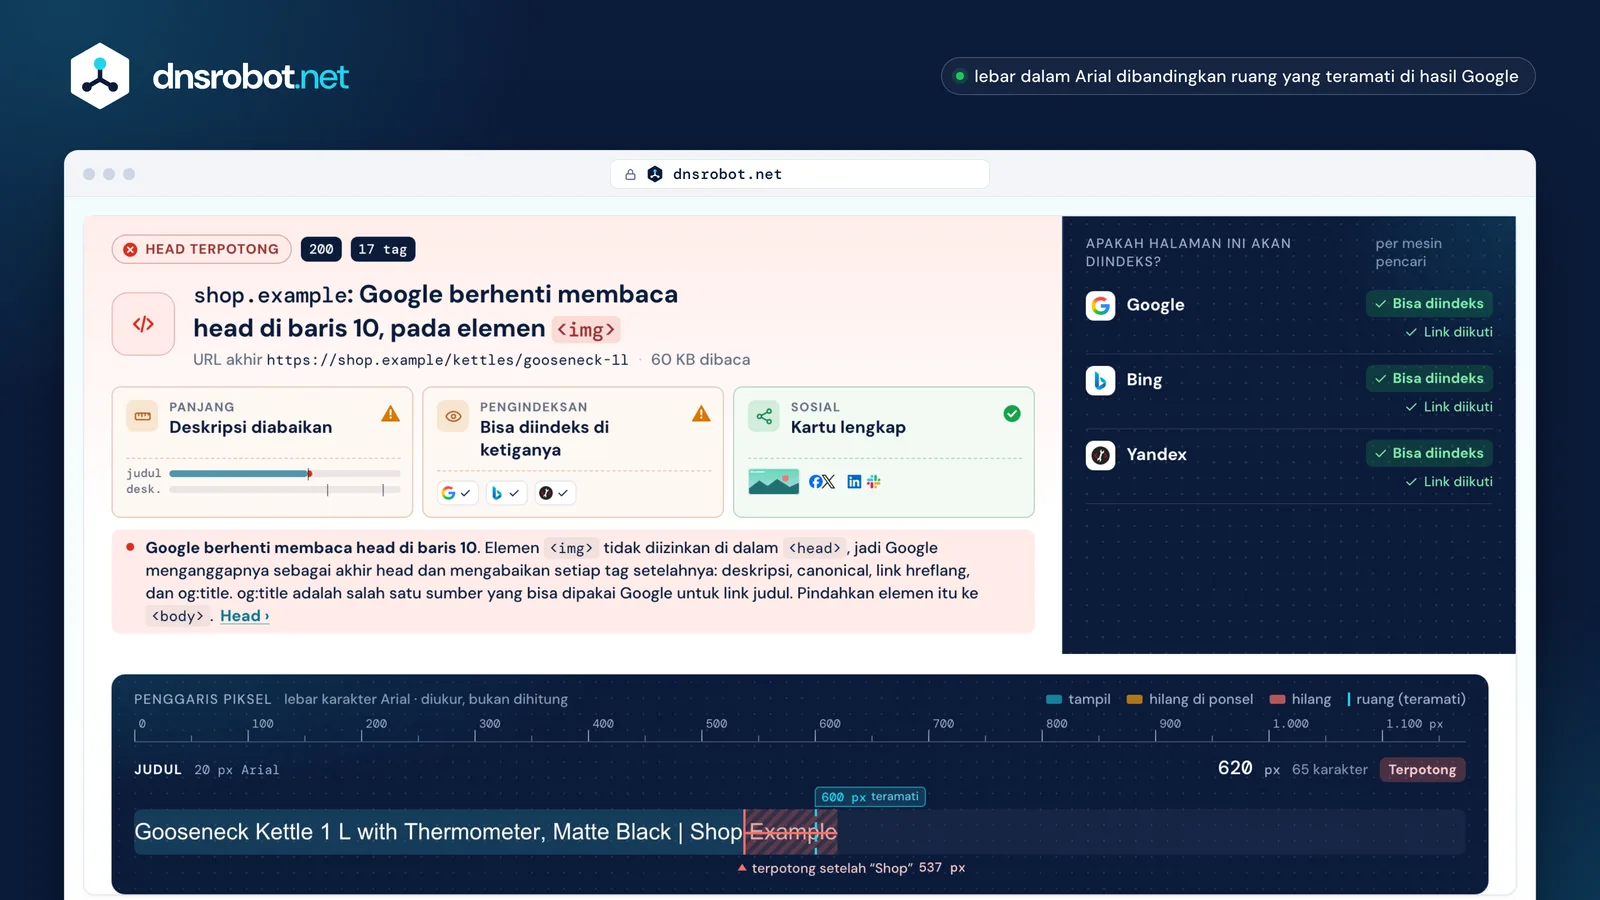
 Diukur, bukan dihitungJudul dan deskripsi dalam ukuran yang digambar halaman hasil penelusuran, dengan penggaris yang menunjukkan di mana masing-masing terpotong di desktop dan di ponsel.Pengindeksan, per mesin pencariMeta tag robots dan header X-Robots-Tag, dibaca seperti cara Google, Bing, dan Yandex masing-masing membacanya.Yang tidak pernah dibaca GoogleElemen yang mengakhiri head terlalu dini, barisnya, dan setiap tag yang tersembunyi karenanya.Tampilannya saat dibagikanKartu yang dibuat Facebook dan X dari tag-tagnya, dengan ukuran asli gambar yang dibaca dari file-nya.
Berapa panjang title tag yang ideal?
Cukup panjang untuk menyebut halaman, dan cukup pendek untuk muat di sekitar 600 piksel, ruang yang diamati pihak ketiga untuk link judul di desktop. Mereka menyetarakannya dengan 50 sampai 60 karakter teks bahasa Inggris; menurut pengukuran kami dalam Arial, teks bahasa Indonesia yang umum mengisi ruang yang sama pada sekitar 65 karakter. Google sendiri tidak menetapkan batas dan memotong link judul “agar sesuai dengan lebar perangkat”.
Panduan link judul Google menyatakan “tidak ada batas panjang elemen <title>”, tetapi meminta Anda menghindari “teks panjang atau berlebihan”. Sebuah studi atas 80.959 judul di 2.370 situs menemukan bahwa Google menulis ulang judul yang lebih dari 70 karakter hampir setiap kali, dan judul 51 sampai 55 karakter dalam sekitar 40% kasus.
<title> adalah satu masukan, bukan hasil akhirnya. Google membuat link judul secara otomatis dari elemen title, judul utama yang terlihat di halaman dan heading seperti <h1>, og:title, teks lain yang besar dan menonjol, anchor text, teks link yang mengarah ke halaman itu, dan data terstruktur WebSite. Google mengganti judul yang tidak ada, berupa teks boilerplate, dijejali kata kunci, atau memakai bahasa atau aksara yang berbeda dari halamannya.
Jadi, beri setiap halaman judul deskriptifnya sendiri, cantumkan nama situs satu kali di awal atau di akhir setelah pemisah seperti garis tegak, dan hindari judul yang tidak jelas seperti “Beranda”. Pengecek di atas juga membaca <h1> pertama halaman, karena Google bisa mengambil link judul dari salah satunya.
- 1Elemen title
- 2Judul utama yang tampil di halaman
- 3Heading seperti h1
- 4Tag og:title
- 5Teks lain yang besar dan menonjol
- 6Teks lain di halaman
- 7Anchor text di halaman
- 8Teks link yang mengarah ke halaman
- 9Data terstruktur WebSite
Cek noindex: bagaimana cara mengetahui apakah halaman noindex?
Lihat di dua tempat: meta tag robots di HTML dan header HTTP X-Robots-Tag. Header tidak pernah terlihat di View Source, jadi pengecek noindex yang hanya membaca HTML bisa menyebut halaman bisa diindeks padahal tidak; pengecek ini membaca keduanya, untuk Google, Bing, dan Yandex.
Tag noindex dan header membawa aturan yang sama, dan Google menjumlahkannya: dengan noindex di header dan all di tag, halaman itu noindex, karena “Aturan yang lebih ketat akan diterapkan” (Google). none berarti noindex, nofollow; halaman noindex milik Google sendiri menyebut nofollow sebagai petunjuk. Tanpa tag sama sekali, bawaannya adalah index, follow. Cek HTTP Header menampilkan setiap header yang dikirim sebuah halaman.
Yandex menyelesaikan konflik dengan cara sebaliknya: “Direktif yang mengizinkan diprioritaskan jika digabungkan dengan direktif yang melarang”, jadi all di samping noindex, follow tetap terindeks di sana (Yandex). Itulah sebabnya putusan di atas diberikan per mesin pencari, bukan sekali untuk semuanya.
Jebakannya adalah robots.txt. URL yang diblokir di sana tidak pernah diambil, jadi noindex-nya tidak pernah dibaca, dan URL itu tetap bisa muncul di hasil jika halaman lain menautkannya (Google). Untuk mengeluarkan halaman, biarkan halaman itu di-crawl dan beri noindex; noindex yang ditulis di robots.txt sama sekali tidak didukung. Dan noindex baru hanya berlaku setelah Google meng-crawl ulang halaman, yang bisa memakan waktu berbulan-bulan.
X-Robots-Tag: noindex| Mesin pencari | Cara menyelesaikan konflik | Halaman ini |
|---|---|---|
| Aturan yang paling ketat yang berlaku | Tidak tampil | |
| Bing | Aturan yang paling ketat yang berlakuTidak ada aturan yang dipublikasikan; dibaca seperti Google | Tidak tampil |
| Yandex | Aturan yang mengizinkan yang menang | Bisa diindeks |

Diblokir di robots.txt: halaman tidak pernah diambil, jadi noindex-nya tidak pernah dibaca.
Mengapa Google mengabaikan sebagian meta tag saya?
Sering kali karena ada elemen yang tidak semestinya berada di <head>, seperti <img> atau <iframe>, di atasnya. Google menganggapnya sebagai akhir head dan mengabaikan setiap elemen setelahnya (Google).
Hanya delapan elemen yang valid di head: title, meta, link, script, style, base, noscript, dan template. Piksel pelacakan yang ditempel bersama potongan kode tag, <div> yang nyasar, atau <iframe> yang disematkan mengakhirinya terlalu dini, dan canonical, link hreflang, serta deskripsi di bawahnya hilang tanpa satu pun pesan error. Penganalisis meta tag yang hanya mengumpulkan setiap tag di file tetap melaporkan semuanya ada.
Tidak semuanya hilang. Google juga mematuhi meta tag robots di body, jadi noindex setelah titik potong tetap berlaku. Canonical tidak: Google hanya menerimanya di head (Google). Pengecek di atas menyebut elemennya beserta barisnya, dan mencantumkan tag yang tidak lagi dibaca Google.
Tag yang ditambahkan atau diubah JavaScript adalah titik buta lainnya. Google menyarankan untuk menghindarinya jika memungkinkan dan menetapkan canonical di sumber HTML (Google), jadi pengecek ini membaca HTML yang dikirim server.
<meta charset="utf-8"><title>Sepatu Hiking Tahan Air untuk Pria dan Wanit…</title><link rel="stylesheet" href="/theme.css"><img src="https://px.example/p.gif" alt="">Google berhenti di sini<meta name="description" content="Gratis retur untuk sem…">Diabaikan Google<link rel="canonical" href="https://store.example/boots">Diabaikan Google<link rel="alternate" hreflang="de" href="https://store.example/de/stiefel">Diabaikan Google<meta name="robots" content="max-snippet:160">Tetap berlaku: tag robots juga dihitung di bodyApa fungsi tag canonical?
Tag ini memberi tahu mesin pencari URL mana, dari beberapa URL dengan konten yang sama, yang ingin Anda tampilkan, dan tag ini petunjuk, bukan aturan: “Google dapat memilih halaman kanonis yang berbeda dengan pilihan Anda” (Google).
Google menimbangnya bersama sinyal lain: redirect adalah yang terkuat, rel=canonical sinyal kuat, sitemap sinyal lemah, dan tidak satu pun yang wajib (Google). Pasang canonical yang merujuk ke dirinya sendiri di halaman yang ingin Anda tampilkan, tulis sebagai URL absolut, simpan di <head>, dan jangan tambahkan hreflang, lang, media, atau type padanya, atau Google mengabaikannya saat memilih canonical. Cek Redirect mengikuti setiap hop sebuah redirect.
Dua konflik yang perlu dihindari. Canonical di halaman noindex mengirim sinyal yang saling bertentangan, dan Google menyarankan agar sama sekali tidak memakai noindex untuk memilih canonical. Dan canonical yang mengarah ke situs lain yang tidak dipasang oleh pengelola situs patut diperiksa: Google menyebut canonical lintas domain yang disisipkan sebagai tanda situs yang diretas.
Versi bahasa dipasangkan dengan hreflang: setiap versi mencantumkan dirinya sendiri dan semua versi lainnya dengan URL lengkap, dan dua halaman yang tidak saling menautkan akan diabaikan. Kodenya berupa bahasa ISO 639-1 dengan wilayah ISO 3166-1 opsional: en-GB, tidak pernah en-UK, dan es-419 tidak didukung (Google). Arahkan canonical setiap versi bahasa ke URL dalam bahasa yang sama.
Konten sama, beberapa URL
http://store.example/bootshttps://store.example/boots?utm_source=mailhttps://www.store.example/bootshttps://store.example/boots/https://store.example/bootsPetunjuk: Google bisa memilih yang lainSinyal, dari yang terkuat
rel=canonicalSitemapSepasang hreflang
/en/boots/de/stiefelSaling menautkan: dipakai
/en/boots/fr/bottesHanya satu arah: diabaikan
Meta tag apa saja yang benar-benar dipakai Google?
Daftarnya pendek: description, robots dan googlebot, notranslate, nopagereadaloud, google-site-verification, deklarasi Content-Type dan charset, refresh, viewport, serta rating. Google begitu saja mengabaikan meta tag yang tidak didukungnya (Google).
Tag meta keywords adalah yang paling terkenal di antara yang diabaikan: dokumentasi Google menyatakan tag ini “tidak digunakan oleh Google Penelusuran, dan sama sekali tidak berpengaruh pada pengindeksan maupun penentuan peringkat”, dan pada 2009 Google mengumumkan bahwa tag itu tidak lagi dipakainya. Google juga tidak memakai atribut lang untuk mendeteksi bahasa halaman, dan rel=next serta rel=prev tidak lagi berpengaruh apa pun. Dari tag Open Graph, Google hanya mendokumentasikan og:title, sebagai salah satu sumber link judul.
Beberapa tag tetap penting meski tidak dihitung Google. Pembaca layar dan browser memakai lang. Tanpa tag viewport, ponsel menata halaman selebar sekitar 980 piksel CSS lalu mengecilkannya, sehingga gaya untuk layar sempit tidak pernah berlaku (MDN); Google menyatakan keberadaan tag ini memberi tahu bahwa halaman ramah seluler. Dan <meta charset> harus berada dalam 1.024 byte pertama file, satu-satunya bagian tempat browser mencarinya (HTML).
Dua lagi yang patut diperhatikan. refresh berfungsi sebagai redirect, tetapi Google merekomendasikan redirect 301 sisi server sebagai gantinya. Dan noarchive, yang sudah tidak dipakai Google, masih menentukan di Bing apakah konten boleh muncul di jawaban chat-nya (Bing).
Dipakai Google
<meta name="description">Kadang menjadi cuplikanrobots · googlebotAturan pengindeksan dan cuplikan<title>Salah satu sumber link judulog:titleSumber lain untuk link judulviewportDibaca sebagai tanda halaman ramah selulercharsetHanya dicari di 1.024 byte pertamarefreshBerfungsi, tetapi 301 lebih baikDiabaikan Google
keywordsTidak berpengaruh pada pengindeksan atau peringkatrel=next · rel=prevTidak lagi dipakaiBukan untuk Google, tetap penting
<html lang>Tidak dipakai untuk mendeteksi bahasa; dipakai pembaca layarog:imageDipakai Facebook dan X

noarchiveDihentikan di Google, dipakai BingSumber
- Google Search Central: cuplikan, link judul, meta tag robots dan X-Robots-Tag, noindex, meta tag yang didukung Google, metadata halaman yang valid, URL kanonis, dan versi yang dilokalkan
- HTML Living Standard (title, description, encoding karakter) dan MDN tentang meta tag viewport
- Protokol Open Graph dan Meta for Developers tentang gambar untuk berbagi
- Dokumentasi kartu X versi terakhir yang dipublikasikan, dibaca dari Internet Archive: markup dan summary_large_image
- Yandex tentang direktif meta robots dan Bing Webmaster Blog
- Teramati, bukan dipublikasikan Google: ruang dalam piksel dan tingkat penulisan ulang dari studi pihak ketiga seperti studi judul Zyppy; lebar di halaman ini adalah pengukuran kami sendiri dalam Arial
Cek meta tag: tanya jawab
Berapa batas karakter meta description?
Berapa panjang title tag yang ideal?
Bagaimana cara cek apakah halaman noindex?
Apa arti noindex, nofollow?
Sebaiknya blokir halaman di robots.txt atau pakai noindex?
Apa beda meta tag robots dan X-Robots-Tag?
Mengapa Google menampilkan judul dan deskripsi yang berbeda dari milik saya?
Bagaimana cara cek tag Open Graph untuk Facebook?
Apakah Twitter Card Validator masih tersedia?
Apakah Google masih memakai meta tag keywords?
Apakah saya perlu meta tag viewport?
Apakah cek meta tag ini menjalankan JavaScript?
Ada yang kurang?Usulkan fitur atau alat baru
Alat website dan SEO lainnya
Analisis Tautan
Analisis semua tautan di halaman web dengan deteksi dofollow/nofollow dan pemeriksaan status HTTP
Cek Redirect
Periksa pengalihan URL, rantai pengalihan, dan kode status HTTP untuk SEO
Cek HTTP Header
Analisis header respons HTTP dan penilaian header keamanan
Cek CMS Website
CMS, tema, plugin, dan teknologi yang dipakai website, lengkap dengan buktinya
Apa itu tag Open Graph dan Twitter card?
Keduanya adalah meta tag yang menentukan judul, teks, dan gambar sebuah link saat dibagikan. Open Graph punya empat properti wajib,
og:title,og:type,og:image, danog:url(OGP); X membaca tagtwitter:miliknya sendiri dan memakai tag og ini sebagai cadangan untuk sisanya.Facebook meminta gambar minimal 1200 × 630 px, mendekati 1,91:1 dan tidak lebih dari 8 MB; 600 × 315 px adalah batas minimum untuk postingan link, dan gambar di bawah 200 × 200 px sama sekali tidak diterima (Facebook). Tambahkan
og:image:widthdanog:image:height: tanpa keduanya, crawler harus mengunduh gambar lebih dulu, jadi orang pertama yang membagikan link tidak melihat gambar. Sebagai pemeriksa Open Graph, halaman ini membaca ukuran asli gambar dari file-nya sendiri.Dokumentasi kartu X yang terakhir dipublikasikan, diarsipkan pada Desember 2023, meminta gambar 2:1 minimal 300 × 157 px untuk
summary_large_image, persegi minimal 144 × 144 px untuksummary, di bawah 5 MB dan tidak pernah SVG (X, arsip). Tanpa tagtwitter:, X memakaiog:title,og:description, danog:image, tetapi mungkin hanya menampilkan kartu summary yang kecil sampaitwitter:cardmeminta yang besar.Kedua jaringan menyimpan cache dari apa yang mereka baca: Facebook menyimpan gambar sampai URL-nya berubah. Sharing Debugger miliknya mengambil ulang halaman dan memerlukan login Facebook. X tidak lagi menyediakan Card Validator publik yang berfungsi: pada 26 Oktober 2026 alamatnya hanya mengarah ke halaman login lalu ke error. Cara praktis yang tersisa adalah menempelkan link ke postingan baru tanpa menerbitkannya.
summary_large_imagesummaryTidak ada tag twitter:? X memakai og:title, og:description, dan og:image sebagai cadangan.