Semua crawler lainnya
User-agent: *
Dibaca oleh setiap crawler yang tidak punya grup sendiri.
- Mengizinkan seluruh situs.
Google mengabaikannya; Bing membacanya.
Tema
Buat robots.txt yang bisa Anda percaya: setiap aturan dijelaskan saat Anda mengetiknya, file-nya dibaca ulang oleh pemeriksa robots.txt kami menurut RFC 9309 dan tafsiran Google sendiri, plus putusan langsung untuk crawler dan path apa pun sebelum Anda memublikasikannya.
Satu file per host dan protokol: www.example.com dan example.com masing-masing butuh file sendiri.
Sumber: RFC 9309, dibaca pada 26 Oktober 2026.
Dibaca oleh setiap crawler yang tidak punya grup sendiri.
Pilih apa yang didapat tiap crawler yang dikenal. Crawler yang punya grup sendiri hanya membaca grup itu.
Crawler ini merayapi untuk membangun indeks pencarian. Halaman yang diblokir tetap bisa tercantum lewat link dari tempat lain, tetapi tanpa ada isinya yang dibaca.
Crawler ini mengumpulkan halaman untuk melatih model. Token tersendiri memungkinkan Anda menolak pelatihan dan tetap muncul di hasil penelusuran.
Crawler ini mengambil halaman untuk menjawab pertanyaan dengan link kembali ke situs Anda.
Crawler ini mengambil satu halaman karena seseorang memintanya, jadi sebagian operator menyatakan crawler ini bisa mengabaikan robots.txt.
Menolak crawler ini berarti menolak seseorang, bukan perayapan: ketika seseorang meminta asisten AI membuka salah satu halaman Anda, asisten yang mematuhi file ini tidak akan membacanya untuk orang itu. Tolak crawler pelatihan di atas jika yang Anda maksud adalah pelatihan.
Pratinjau link, alat pemilik situs, pengecekan iklan, arsip, dan crawler yang operatornya menyebut tugas lain atau tidak menyebut apa pun.
robots.txt Anda/robots.txt
User-agent: *Allow: /KesalahanPeringatanCatatan23 B dari 500 KiB
1 peringatan
Yang perlu dilakukan Ini baris paling murah di file ini, dan setiap crawler membacanya. Tambahkan Sitemap: dengan alamat lengkap sitemap Anda.
Pilih crawler dan path: putusannya, aturan yang memutuskannya, dan grup yang dibaca crawler itu berasal dari mesin pencocokan milik Pemeriksa Robots.txt sendiri.
Crawler ini boleh meminta URL tersebut.
User-agent: *dimulai di baris 1
Tidak ada grup yang menyebut crawler ini, jadi grup * yang berlaku.
Allow: /baris 2
/any-page
/
Hanya path dan query yang dibandingkan, byte demi byte setelah percent-encoding. Host, skema, dan fragmen tidak pernah menjadi bagian dari aturan.
Tulis aturannya, simpan sebagai file teks biasa bernama robots.txt dengan encoding UTF-8, lalu unggah ke tingkat teratas situs Anda, sehingga file itu menjawab di https://example.com/robots.txt. Tidak ada yang perlu dikirim: crawler meminta alamat itu dengan sendirinya.
Google merangkumnya dalam tiga kalimat: “File harus diberi nama robots.txt. Situs hanya boleh memiliki satu file robots.txt. File robots.txt harus berada di root host situs tempat file tersebut akan diberlakukan.” File itu harus berupa “file teks berenkode UTF-8”, dan “crawler Google secara otomatis akan menemukan dan mulai menggunakan file robots.txt Anda.”
Generator di atas dimulai dari sebuah preset, menjelaskan setiap aturan saat Anda mengetiknya, dan membaca ulang hasilnya dengan parser dan mesin pencocokan milik pemeriksa robots.txt kami sebelum Anda menyalinnya. File unduhannya bernama robots.txt: UTF-8 tanpa byte-order mark, hanya line feed, dan tanpa tanggal atau komentar yang tidak Anda minta.
https://example.com/robots.txtTidak ada langkah pengiriman: crawler Google menemukan file-nya sendiri.
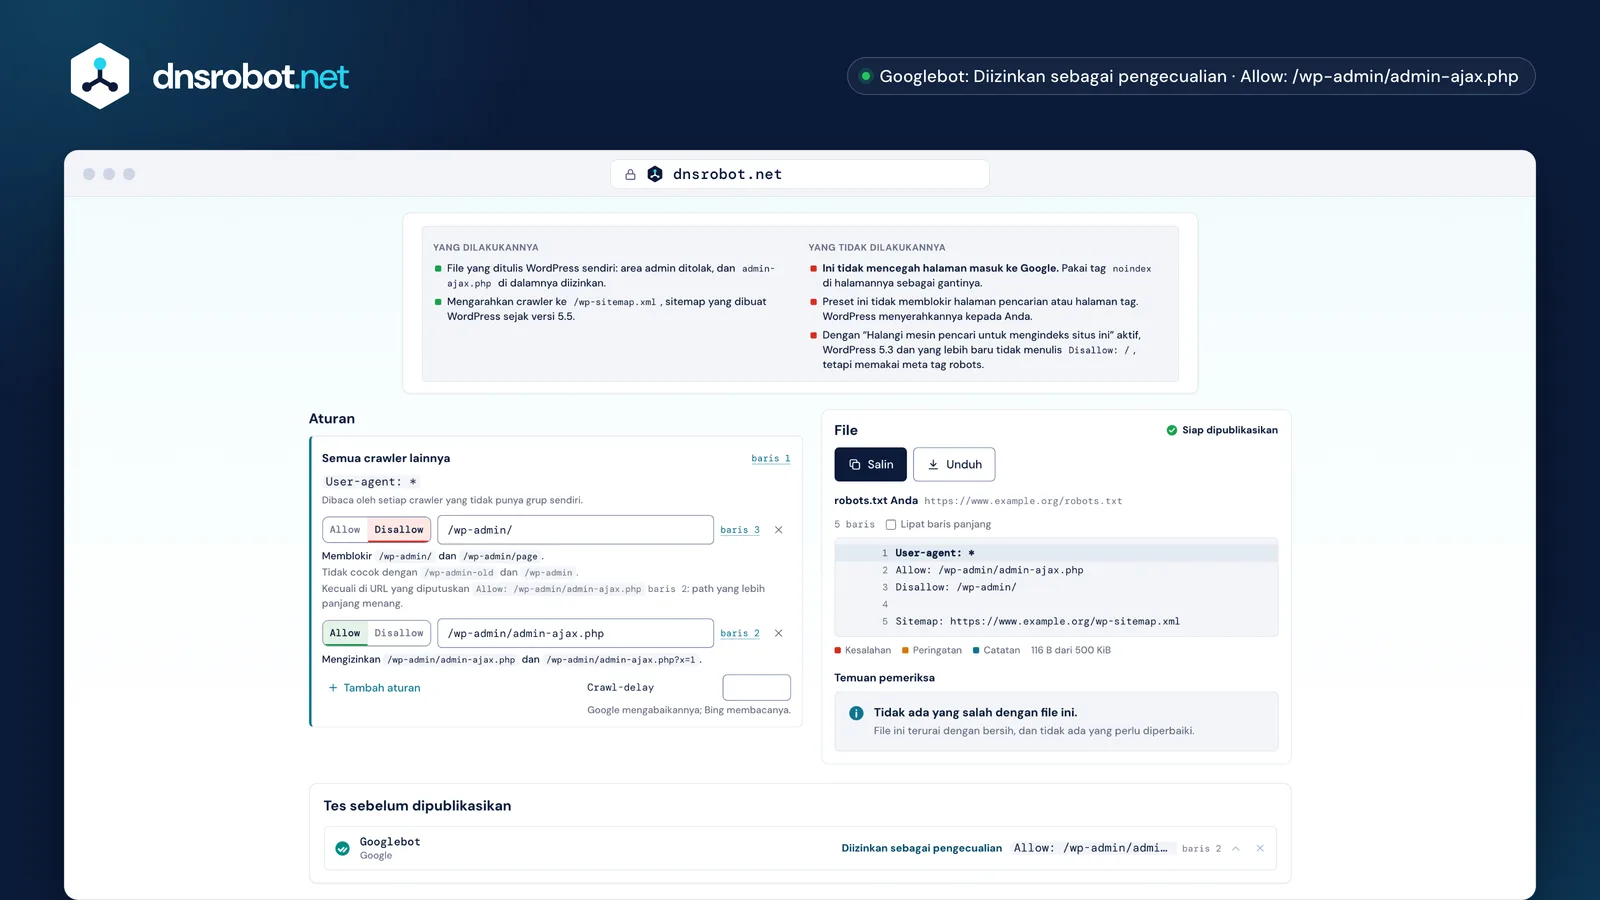
 Yang dilakukan presetDan yang tidak dilakukannya: tak satu pun preset ini mencegah halaman masuk ke Google, dan masing-masing menyatakannya.Penjelasan tiap aturanPath yang diblokir sebuah aturan dan yang terlewat, dari mesin pencocokan yang sama yang menghasilkan setiap putusan, serta aturan lebih panjang yang membuat pengecualian.File dan temuannyaFile beserta nomor barisnya, dibaca ulang oleh audit milik Pemeriksa Robots.txt sendiri sebelum Anda menyalinnya.PutusannyaPilih crawler dan path: diizinkan atau diblokir, aturan yang memutuskannya beserta barisnya, dan grup yang dibaca crawler itu.
Grup dan baris Sitemap. Sebuah grup dimulai dengan satu atau beberapa baris User-agent yang menyebut crawler, diikuti aturan Allow dan Disallow yang dipatuhi crawler itu; baris Sitemap berdiri sendiri, di luar semua grup.
RFC 9309 mendefinisikan grup sebagai “satu atau beberapa baris user-agent yang diikuti oleh satu atau beberapa aturan”, dan sebuah crawler mematuhi tepat satu grup: grup yang menyebut token produknya sendiri, atau grup * jika tidak ada. Google membaca empat kolom dan tidak ada yang lain: user-agent, allow, disallow, dan sitemap.
Nama kolom tidak peka huruf besar/kecil, sedangkan path peka: dalam contoh Google sendiri, disallow: /file.asp berlaku untuk /file.asp “tetapi tidak” untuk /FILE.asp. Baris Sitemap: harus berupa alamat lengkap dengan protokol dan host-nya; generator ini menolak bentuk lain dan menjelaskan alasannya.
User-agent: *Memulai grup untuk setiap crawler yang tidak punya grup sendiriDisallow: /cart/Path yang tidak boleh diambil crawler iniAllow: /cart/helpPengecualian: lebih panjang dari Disallow, jadi aturan ini menang User-agent: GPTBotMemulai grup yang menyebut dua crawlerUser-agent: ClaudeBotDisallow: /Keduanya ditolak dari seluruh situs Sitemap: https://www.example.org/sitemap.xmlDi luar semua grup: alamat lengkap* dan $: cara sebuah aturan dicocokkanJika beberapa aturan cocok dengan sebuah URL, aturan dengan path terpanjang yang menang, apa pun jenisnya, dan Allow menang jika seri. * mewakili rangkaian karakter apa pun dan $ menandai akhir URL; tidak ada karakter lain dalam path yang bermakna khusus.
RFC 9309: “Kecocokan paling spesifik yang ditemukan HARUS dipakai. Kecocokan paling spesifik adalah kecocokan dengan oktet terbanyak”, dan “jika aturan allow dan aturan disallow setara, aturan allow SEBAIKNYA dipakai.” File WordPress sendiri bekerja dengan cara ini: Disallow: /wp-admin/ menutup foldernya, dan Allow: /wp-admin/admin-ajax.php yang lebih panjang membuka satu file di dalamnya.
Aturan tanpa $ adalah awalan (prefix), jadi Disallow: /admin juga memblokir /administrator; tambahkan garis miring (/admin/) jika yang Anda maksud foldernya. Di bawah setiap aturan, editor di atas menunjukkan path yang dijaringnya dan beberapa yang tidak, dari mesin pencocokan yang menghasilkan setiap putusan, dan menandai aturan yang selalu dikalahkan aturan lain.
* dan $, dan apa yang benar-benar dijaring tiap pola/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [, dan + adalah karakter biasa. Tidak ada regular expression di robots.txt.
/admin/report.pdfAllow menang: aturan ini cocok dengan bagian path yang lebih panjang.
Disallow: /files/7 karakterAllow: /files/7 karakterPanjangnya sama, jadi Allow menang. “Aturan yang paling longgar”, menurut Google.
Ketiganya sudah menyajikan robots.txt, dan preset di atas menulis apa yang dijelaskan dokumentasi tiap platform sendiri: WordPress menolak area admin-nya tetapi mengizinkan admin-ajax.php, Shopify menolak keranjang, checkout, serta koleksi yang difilter atau diurutkan, dan Next.js menyajikan file yang Anda letakkan di app/robots.txt.
WordPress menulis file-nya lewat kode, di do_robots(): User-agent: *, sebuah Disallow untuk path admin dan sebuah Allow untuk admin-ajax.php, ditambah, di situs publik sejak WordPress 5.5, baris Sitemap: untuk /wp-sitemap.xml. Dengan “Halangi mesin pencari untuk mengindeks situs ini” aktif, WordPress 5.3 dan yang lebih baru tidak lagi menulis Disallow: /, tetapi memakai meta tag robots.
Shopify menyatakan bahwa file bawaannya “berfungsi untuk sebagian besar toko”. Tidak ada file yang bisa diunggah: mengubahnya berarti menyunting template robots.txt.liquid milik tema, yang oleh Shopify disebut “kustomisasi yang tidak didukung”. Next.js menyajikan app/robots.txt apa adanya, atau membuat file-nya dari app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlDitulis oleh WordPress sendiri. Ubah dengan plugin atau filter robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlBawaan Shopify. Ubah di template robots.txt.liquid milik tema.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlFile Anda sendiri di app/robots.txt, atau app/robots.ts, yang disajikan di /robots.txt.
Grup yang menyebut crawler itu, dengan Disallow: / di bawahnya, berhasil untuk setiap crawler yang operatornya menyatakan mematuhi robots.txt, dan hanya untuk mereka. Ini permintaan yang dihormati crawler, bukan kunci: crawler yang mengabaikan file ini tetap bisa mengambil setiap halaman.
Sebagian besar perusahaan AI menjalankan lebih dari satu crawler, jadi putuskan per tugas. Menolak crawler pelatihan seperti GPTBot atau ClaudeBot berarti menolak crawler yang mengumpulkan halaman untuk model; menolak crawler jawaban seperti OAI-SearchBot atau PerplexityBot juga menghilangkan Anda dari link yang ditampilkan asisten-asisten itu. Token pelatihan Google bukan Googlebot: “Google-Extended tidak memengaruhi penyertaan situs di Google Penelusuran dan tidak juga digunakan sebagai sinyal penentu peringkat di Google Penelusuran.”
Jenis ketiga berbeda. ChatGPT-User, Claude-User, Perplexity-User, dan Amzn-User mengambil satu halaman karena seseorang meminta asisten membukanya, jadi menolak mereka berarti menolak orang itu, dan sebagian operatornya menyatakan crawler ini bisa saja mengabaikan robots.txt. Karena itulah daftar crawler di atas menempatkan mereka di bagian tersendiri.
GPTBotMematuhiOAI-SearchBotMematuhiChatGPT-UserBisa mengabaikanClaudeBotMematuhiClaude-SearchBotMematuhiClaude-UserMematuhiPerplexityBotMematuhiPerplexity-UserBisa mengabaikanGoogle-ExtendedHanya tokenTidak ada crawler seperti ituTidak ada crawler seperti ituApplebot-ExtendedHanya tokenTidak ada crawler seperti ituTidak ada crawler seperti itumeta-externalagentMematuhimeta-webindexerMematuhimeta-externalfetcherBisa mengabaikanAmazonbotMematuhiTidak ada crawler seperti ituAmzn-UserBisa mengabaikanrobots.txt meminta crawler untuk tidak mengambil sebuah halaman, bukan meminta mesin pencari untuk tidak mencantumkannya. Google “masih dapat mengindeks URL dan menampilkannya di hasil penelusuran tanpa cuplikan” jika halaman lain menautkan ke sana. Agar halaman tidak muncul, pakai noindex, dan biarkan halamannya bisa dirayapi agar tag itu terbaca.
Search Console menyebutnya “Diindeks, meskipun diblokir oleh robots.txt”. Dan Google menyatakannya dengan tegas: “Agar aturan noindex efektif, halaman atau resource tidak boleh diblokir oleh file robots.txt”: noindex di halaman yang di-disallow tidak pernah terlihat, karena crawler tidak pernah mengambil halaman itu.
Itulah sebabnya setiap preset di atas menyebut apa yang tidak dilakukannya. Disallow: / milik preset staging menjauhkan crawler yang patuh, tetapi URL staging yang ditautkan dari mana pun tetap bisa tercantum: lindungi staging dengan kata sandi, dan jangan pernah membawa baris itu ke situs live.
<meta name="robots" content="noindex">Tidak pernah terbacaAgar halaman tidak muncul: izinkan crawler masuk dan pakai noindex, atau wajibkan login.
Di root host yang diaturnya, sebagai /robots.txt, satu file per host dan protokol. https://example.com/robots.txt tidak berlaku untuk https://www.example.com atau https://shop.example.com: masing-masing butuh file sendiri, dan robots.txt di dalam folder tidak pernah dibaca.
Google: “Anda harus meletakkan file robots.txt di direktori tingkat atas situs, pada protokol yang didukung.” Laporan robots.txt di Search Console mencantumkan file dari 20 host teratas sebuah properti secara terpisah, dengan HTTP dan HTTPS dihitung sendiri-sendiri.
Ketik situs Anda di bagian atas generator, dan generator akan memberi alamat persis tempat file harus menjawab, mengisi baris Sitemap: untuk host itu, dan menautkan ke Pemeriksa Robots.txt, yang membaca file live begitu file itu sudah diunggah.
https://example.com/robots.txtSetiap URL di https://example.comhttps://www.example.com/robots.txtHanya www.example.com: host terpisahhttp://example.com/robots.txtHanya situs http://: protokol terpisahhttps://shop.example.com/robots.txtHanya shop.example.comhttps://example.com/blog/robots.txtTidak ada: robots.txt di dalam folder tidak pernah dibacaGoogle tidak membaca satu pun. Crawl-delay dibaca Bing, Clean-param dibaca Yandex, Host tidak ada di standar maupun di daftar Google, dan Content-Signal dari Cloudflare menyatakan untuk apa konten Anda boleh dipakai, bukan apa yang boleh dirayapi.
Google mendaftar empat kolomnya dan menambahkan bahwa “kolom lain seperti crawl-delay tidak didukung”. Blog Bing sendiri menyatakan “direktif crawl-delay hanya menerima bilangan bulat positif sebagai nilai”, jadi editor ini menolak pecahan alih-alih menuliskannya. Halaman bantuan Bing saat ini tidak bisa dibaca untuk memastikan rentang atau satuannya, jadi halaman ini tidak menyebut keduanya.
Tidak satu pun dari direktif itu merusak file: RFC 9309 mensyaratkan bahwa penguraian record lain “TIDAK BOLEH mengganggu penguraian record yang didefinisikan secara eksplisit”. Dari keempatnya, generator ini hanya menulis Crawl-delay, dengan label siapa yang membacanya.
User-agentMembacanyaMembacanyaMembacanyaAllowMembacanyaMembacanyaMembacanyaDisallowMembacanyaMembacanyaMembacanyaSitemapMembacanyaMembacanyaMembacanyaCrawl-delayMengabaikannyaMembacanyaBelum terkonfirmasiClean-paramMengabaikannyaMengabaikannyaMembacanyaHostMengabaikannyaMengabaikannyaBelum terkonfirmasinoindexMengabaikannyaBelum terkonfirmasiBelum terkonfirmasiContent-SignalMengabaikannyaBelum terkonfirmasiBelum terkonfirmasiDua kali. Sebelum Anda memublikasikannya, lewat Tes sebelum dipublikasikan di atas: pilih crawler dan path, lalu lihat aturan yang memutuskannya. Setelah file diunggah, jalankan Pemeriksa Robots.txt pada file live, karena jawaban server sama pentingnya dengan isi file.
File yang menjawab 404 dibaca seolah-olah tidak ada file sama sekali, jadi setiap crawler boleh mengambil semuanya; file yang menjawab 500 atau 503 berarti crawler yang mengikuti standar tidak boleh mengambil apa pun. RFC 9309 §2.3.1.4: crawler “HARUS menganggap disallow total”. Google melunakkannya dengan tahapannya sendiri, yang ditunjukkan di gambar.
Penguji robots.txt milik Google sudah tidak ada: Search Central mengumumkan penghentiannya pada 15 November 2023, dan laporan robots.txt yang menggantikannya menampilkan file yang diambil Google, tanpa mengetes URL terhadap sebuah aturan. Tes itu dilakukan oleh Tes sebelum dipublikasikan, di generator di atas, dan oleh pemeriksa robots.txt.
200Mengikuti aturan di file.301, 302Mengikuti setidaknya lima kali redirect, lalu berhenti. Setelah itu Google menganggap file-nya 404.403, 404Merayapi semuanya, seolah-olah tidak ada file.429Tidak merayapi apa pun. Google menggolongkannya bersama jawaban 5xx, bukan 4xx.500, 503Tidak merayapi apa pun sama sekali, menurut standar.Nama tidak adaTidak ada situs untuk dibaca, jadi tidak ada putusan.Kesalahan yang mahal masing-masing hanya satu baris pendek: Disallow: / yang tertinggal dari staging, awalan yang menjangkau lebih jauh dari maksud Anda, baris Sitemap: yang ditulis sebagai path, path tanpa garis miring di depan, dan baris noindex yang tidak lagi dibaca Google sejak 2019.
Semuanya tertangkap di sini sebelum Anda menyalin file-nya. Audit milik pemeriksa berjalan saat Anda mengetik dan temuannya ada di bawah file; baris yang akan ditolak crawler tidak pernah ditulis sama sekali, dan editor menjelaskan di barisnya kenapa baris itu tidak dimasukkan.
Satu kesalahan berupa pasangan, bukan satu baris: URL yang di-disallow di sini dan juga memuat noindex di halamannya. Crawler tidak pernah mengambil halaman itu, jadi tidak pernah melihat noindex-nya, dan URL itu bisa tetap ada di hasil penelusuran. Pilih salah satu: blokir perayapannya, atau izinkan crawler masuk dan minta agar tidak mengindeks.
Disallow: /Sisa dari staging: seluruh situs yang sudah live tertutup untuk setiap crawler.Disallow: /adminJuga memblokir /administrator dan /admin-tools. Tambahkan garis miring di akhir.Allow: / di bawah User-agent: *Tidak pernah dibaca oleh crawler yang punya grup sendiri di bagian mana pun dalam file.Sitemap: /sitemap.xmlBaris Sitemap harus berupa alamat lengkap beserta host-nya.Disallow: adminPath dimulai dari /. Aturan ini tidak cocok dengan apa pun.noindex: /private/Mati sejak 2019. Halamannya tetap bisa dirayapi dan diindeks.* tempat Allow Anda berada. Editor di atas menandai aturan yang selalu dikalahkan aturan lain, dan Tes sebelum dipublikasikan menyebut aturan penentu dan grup yang dibaca crawler itu.Ada yang kurang?Usulkan fitur atau alat baru
Ambil robots.txt situs mana pun, tes apakah URL diblokir untuk Googlebot atau crawler AI, dan temukan error sintaks
Jelajahi website Anda dan dapatkan sitemap XML, sitemap HTML, dan pohon situs
Temukan dan validasi sitemap XML sebuah website: sintaks, batas URL, tanggal lastmod, konflik robots.txt, serta URL rusak atau redirect
Cek title, meta description, canonical, hreflang, serta tag Open Graph dan X card sebuah halaman, lengkap dengan pratinjau Google dan media sosial
Analisis header respons HTTP dan penilaian header keamanan
Deteksi browser, OS, jenis perangkat, mesin rendering, dan arsitektur CPU dari string user agent Anda