











Meta Etiket Kontrol Aracı
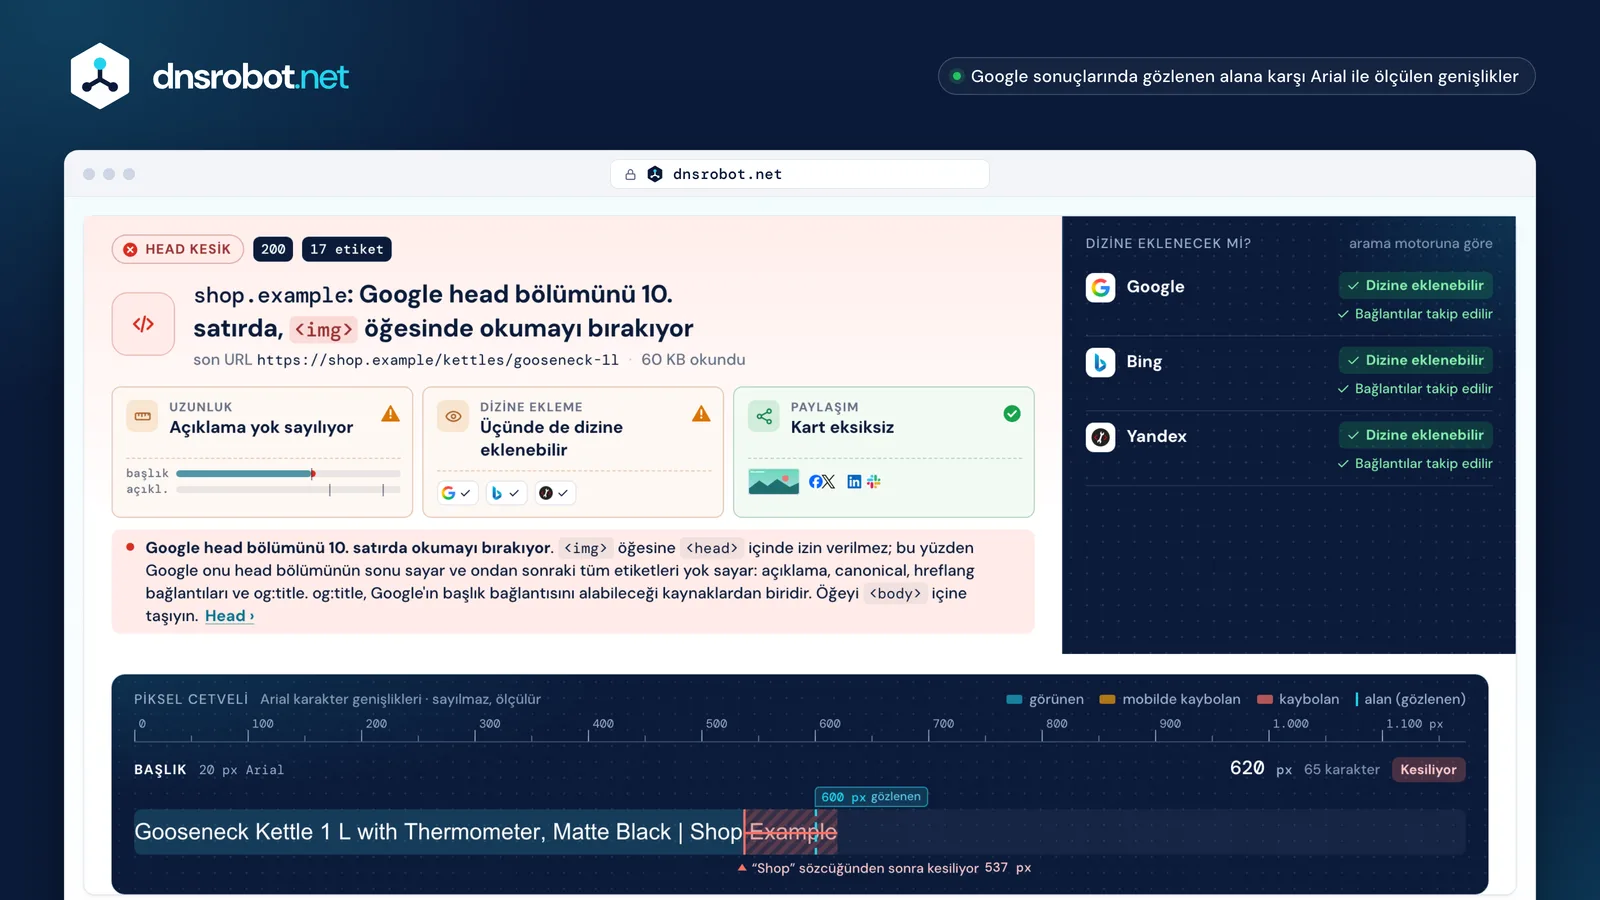
Saymak yerine ölçen bir meta etiket kontrol aracı: bir sayfanın başlığını ve meta açıklamasını piksel olarak ölçer ve Google sonuçlarının onları nerede kestiğini gösterir; ardından sayfanın dizine eklenip eklenemeyeceğini ve paylaşıldığında bağlantısının nasıl göründüğünü söyler.
Sayfayı sunucumuzdan Google'ın head bölümünü okuduğu gibi okur, başlığı ve açıklamayı piksel olarak ölçeriz.
Meta açıklama kaç karakter olmalı?
Sayfayı anlatmaya yetecek kadar: Google bir üst sınır koymaz ve snippet'i bir karakter sayısında değil, ekranın genişliğine sığacak yerde keser. Üçüncü taraflar bu alanı masaüstünde yaklaşık 920 piksel, mobilde 680 piksel olarak ölçüyor; tipik bir Türkçe cümle bunu, bizim ölçümümüze göre, yaklaşık 150 ve 110 karakterle doldurur.
Google'ın kendi sözleriyle: “Meta tanımın uzunluğuyla ilgili sınırlama yoktur ancak gerektiğinde (genellikle cihaz genişliğine sığdırmak için) snippet, Google Arama sonuçlarında kesilir” (Google). Birim genişliktir, yani belirleyici olan harflerdir. 14 px Arial ile ölçüldüğünde iiiiii 19 px, WWWWWW ise 79 px genişliğindedir; Japonca karakterler tam genişliklidir, bu yüzden aynı alana aşağı yukarı yarısı kadar karakter sığar; boşluklarla yazılan Korecede ise yaklaşık üçte ikisi.
Bu yüzden bilinen “155–160 karakter” kuralı bir sınır değil, kaba bir ölçüdür ve karakter sayan bir meta açıklama kontrol aracı iki yönde de yanılabilir. Normal yazılmış 134 karakterlik bir açıklama masaüstü bir sonuca rahatça sığar; aynı sözcükler büyük harfle yazıldığında kenarı 124 px aşar. “50–60 karakter, yani 580 piksel” gibi tavsiyeler iki birimi birbirinin yerine kullanılabilir sayar, oysa öyle değildir.
Uzunluğun sıralamada bir bedeli yoktur: Google 2009'da açıklamayı sıralama için kullanmadığını söyledi ve belgelerinde uzun ya da eksik bir açıklama için hiçbir cezadan söz edilmez. Ayrıca Google çoğu zaman kendi snippet'ini sayfadan yazar; üçüncü tarafların iki çalışması, Google'ın açıklamayı yaklaşık her üç sonuçtan ikisinde değiştirdiğini gördü. Okur için yazın: sayfaya özgü, gerçek bir özet, asla bir anahtar kelime listesi değil ve önemli sözcükler başta.
Google'ın gerçekten karakter saydığı tek yer max-snippet robots kuralıdır: buradaki sayı bir karakter sayısıdır; 0 hiç snippet olmaması, -1 ise seçimin Google'a bırakılması demektir (Google).
Tüm yürüyüş botlarında ücretsiz iade. Su geçirmez deri, kaymaz taban ve iki yıl garanti. 15.00'e kadar sipariş verin, yarın kapınızda.
TÜM YÜRÜYÜŞ BOTLARINDA ÜCRETSİZ İADE. SU GEÇİRMEZ DERİ, KAYMAZ TABAN VE İKİ YIL GARANTİ. 15.00'E KADAR SİPARİŞ VERİN, YARIN KAPINIZDA.
Üçüncü tarafların gözlediği alanlar; Google hiçbirini yayımlamıyor.
 Sayılmaz, ölçülürBaşlık ve açıklama, bir sonuç sayfasının onları çizdiği boyutta; cetvel her birinin masaüstünde ve mobilde nerede kesildiğini gösterir.Dizine ekleme, arama motoruna göreRobots meta etiketleri ve X-Robots-Tag header'ı; Google, Bing ve Yandex her biri nasıl okuyorsa öyle okunur.Google'ın hiç okumadıklarıHead bölümünü erken bitiren öğe, satırı ve gizlediği her etiket.Paylaşıldığında nasıl görünürFacebook ve X'in etiketlerden oluşturduğu kartlar; görselin gerçek boyutu dosyadan okunur.
Title etiketi kaç karakter olmalı?
Sayfayı adlandıracak kadar uzun, yaklaşık 600 piksele sığacak kadar kısa: bu, üçüncü tarafların masaüstündeki bir başlık bağlantısı için ölçtüğü alandır ve tipik bir metnin kabaca 50 ila 60 karakterine denk gelir. Google kendisi bir sınır koymaz; başlık bağlantısı “genellikle cihazın genişliğine göre kısaltılır”.
Google'ın başlık bağlantısı rehberi “<title> öğesinin uzunluğuyla ilgili bir kısıtlama yoktur” der, ama “gereksiz yere uzun veya ayrıntılı” metinden kaçınmanızı ister. 2.370 sitedeki 80.959 başlık üzerinde yapılan bir çalışma, Google'ın 70 karakteri aşan başlıkları neredeyse her seferinde, 51 ila 55 karakterlik başlıkları ise yaklaşık %40 oranında yeniden yazdığını buldu.
<title> bir girdidir, sonuç değil. Google başlık bağlantısını otomatik olarak title öğesinden, sayfanın görünen ana başlığından, <h1> gibi başlık etiketlerinden, og:title etiketinden, diğer belirgin metinlerden, bağlantı metninden, sayfaya işaret eden bağlantıların metninden ve WebSite yapılandırılmış verisinden oluşturur. Eksik, kalıp, anahtar kelimeyle doldurulmuş ya da sayfadan farklı bir dilde veya yazı sisteminde olan bir başlığı değiştirir.
Bu yüzden her sayfaya kendine ait açıklayıcı bir başlık verin, site adını başa ya da sona dikey çizgi gibi bir ayraçla yalnızca bir kez ekleyin ve “Ana Sayfa” gibi belirsiz başlıklardan kaçının. Yukarıdaki araç sayfanın ilk <h1> öğesini de okur, çünkü Google başlık bağlantısını ikisinden birinden alabilir.
- 1Title öğesi
- 2Sayfada gösterilen ana başlık
- 3h1 gibi başlık etiketleri
- 4og:title etiketi
- 5Diğer büyük ve belirgin metinler
- 6Sayfadaki diğer metinler
- 7Sayfadaki bağlantı metinleri
- 8Sayfaya işaret eden bağlantıların metni
- 9WebSite yapılandırılmış verisi
Noindex kontrolü: bir sayfanın noindex olup olmadığı nasıl anlaşılır?
İki yere bakın: HTML'deki robots meta etiketine ve X-Robots-Tag HTTP header'ına. Header sayfa kaynağında hiç görünmez; bu yüzden yalnızca HTML'i okuyan bir noindex kontrol aracı, dizine eklenemeyen bir sayfaya dizine eklenebilir diyebilir. Bu araç ikisini de Google, Bing ve Yandex için okur.
Bir noindex etiketi ile header aynı kuralları taşır ve Google bunları toplar: header'da noindex, etikette all varsa sayfa noindex olur, çünkü kurallar çakıştığında “daha kısıtlayıcı olan kural uygulanır” (Google). none, noindex, nofollow demektir; Google'ın kendi noindex sayfası nofollow için ipucu der. Hiç etiket yoksa varsayılan index, follow olur. HTTP Başlık Kontrolü bir sayfanın gönderdiği her header'ı gösterir.
Yandex çakışmayı tersine çözer: “İzin veren yönergeler, yasaklayan yönergelerle birlikte kullanıldığında önceliklidir”; bu yüzden noindex, follow yanında all taşıyan bir sayfa orada dizinde kalır (Yandex). Yukarıdaki kararın hepsi için bir kez değil, arama motoruna göre ayrı ayrı verilmesinin nedeni budur.
Tuzak robots.txt'tir. Orada engellenen bir URL hiç alınmaz, bu yüzden noindex'i hiç okunmaz; yine de başka sayfalar ona bağlantı verdiğinde sonuçlarda görünebilir (Google). Bir sayfayı dışarıda tutmak için taranmasına izin verin ve ona bir noindex verin; robots.txt'e yazılan noindex hiç desteklenmez. Ayrıca yeni bir noindex ancak Google sayfayı yeniden taradığında işe yarar ve bu aylar sürebilir.
X-Robots-Tag: noindex| Arama motoru | Çakışmayı nasıl çözer | Bu sayfa |
|---|---|---|
| En kısıtlayıcı kural geçerli olur | Dışarıda | |
| Bing | En kısıtlayıcı kural geçerli olurYayımlanmış kural yok; Google gibi okunur | Dışarıda |
| Yandex | İzin veren kural geçerli olur | Dizine eklenebilir |

robots.txt'te engelli: sayfa hiç alınmaz, bu yüzden noindex'i hiç okunmaz.
Google neden bazı meta etiketlerimi yok sayıyor?
Çoğu zaman <head> bölümüne ait olmayan bir öğe, örneğin bir <img> veya <iframe>, onların üstünde durduğu için. Google bu öğeyi head bölümünün sonu sayar ve ondan sonraki tüm öğeleri yok sayar (Google).
Head bölümünde yalnızca sekiz öğe geçerlidir: title, meta, link, script, style, base, noscript ve template. Bir etiket koduyla birlikte yapıştırılan izleme pikseli, unutulmuş bir <div> veya gömülü bir <iframe> head bölümünü erken bitirir; altındaki canonical, hreflang bağlantıları ve açıklama, hiçbir yerde hata vermeden kaybolur. Dosyadaki tüm etiketleri yalnızca toplayan bir meta etiket analiz aracı bunları yine de var olarak gösterir.
Her şey kaybolmaz. Google body bölümündeki robots meta etiketlerine de uyar; bu yüzden kesim noktasından sonraki bir noindex yine geçerlidir. Canonical ise geçerli olmaz: Google onu yalnızca head bölümünde kabul eder (Google). Yukarıdaki araç öğeyi ve satırını belirtir, Google'ın artık okumadığı etiketleri listeler.
JavaScript'in eklediği veya değiştirdiği etiketler diğer kör noktadır. Google mümkün olduğunda bundan kaçınmayı ve canonical'ı HTML kaynağında belirtmeyi önerir (Google); bu yüzden bu araç sunucunun gönderdiği HTML'i okur.
<meta charset="utf-8"><title>Erkek ve Kadın Su Geçirmez Yürüyüş Botları –…</title><link rel="stylesheet" href="/theme.css"><img src="https://px.example/p.gif" alt="">Google burada durur<meta name="description" content="Tüm yürüyüş botlarında…">Google yok sayar<link rel="canonical" href="https://store.example/boots">Google yok sayar<link rel="alternate" hreflang="de" href="https://store.example/de/stiefel">Google yok sayar<meta name="robots" content="max-snippet:160">Yine geçerli: robots etiketleri body bölümünde de sayılırCanonical etiketi ne işe yarar?
Aynı içeriğe sahip birkaç URL'den hangisinin gösterilmesini istediğinizi arama motorlarına söyler ve bir kural değil, ipucudur: “Google çeşitli nedenlerden ötürü, sizin seçtiğinizden farklı bir sayfayı standart olarak seçebilir” (Google).
Google onu diğer sinyallerle birlikte tartar: yönlendirme en güçlüsüdür, rel=canonical güçlü, sitemap ise zayıf bir sinyaldir ve hiçbiri zorunlu değildir (Google). Gösterilmesini istediğiniz sayfaya kendi kendini gösteren bir canonical koyun, mutlak URL olarak yazın, <head> içinde tutun ve ona hreflang, lang, media veya type eklemeyin; yoksa Google canonical'ı seçerken onu yok sayar. Yönlendirme Kontrolü bir yönlendirmenin her adımını izler.
Kaçınılması gereken iki çakışma var. Noindex bir sayfadaki canonical, birbiriyle çelişen sinyaller gönderir ve Google canonical seçmek için noindex kullanmayı hiç önermez. Başka bir siteyi gösteren ve burada kimsenin eklemediği bir canonical ise incelenmeyi hak eder: Google, sonradan eklenmiş alan adları arası bir canonical'ı saldırıya uğramış bir sitenin işareti olarak sayar.
Dil sürümleri ise hreflang ile eşleştirilir: her sürüm kendini ve diğer tüm sürümleri tam URL'lerle listeler; birbirine bağlantı vermeyen iki sayfa yok sayılır. Kodlar, isteğe bağlı bir ISO 3166-1 bölgesiyle birlikte bir ISO 639-1 dilidir: en-GB doğrudur, en-UK asla; es-419 de desteklenmez (Google). Her dil sürümünün canonical'ı aynı dildeki bir URL'yi göstermelidir.
Aynı içerik, birkaç URL
http://store.example/bootshttps://store.example/boots?utm_source=mailhttps://www.store.example/bootshttps://store.example/boots/https://store.example/bootsBir ipucu: Google başkasını seçebilirSinyaller, en güçlüden başlayarak
rel=canonicalSitemapBir hreflang çifti
/en/boots/de/stiefelİkisi de geri bağlantı veriyor: kullanılır
/en/boots/fr/bottesYalnızca tek yönlü: yok sayılır
Google hangi meta etiketleri gerçekten kullanır?
Kısa bir liste: description, robots ve googlebot, notranslate, nopagereadaloud, google-site-verification, Content-Type ve charset bildirimleri, refresh, viewport ve rating. Google desteklemediği meta etiketleri basitçe yok sayar (Google).
Yok saydıklarının en bilineni meta keywords etiketidir. Google'ın belgelerinde şöyle yazar: “Google Arama meta-keyword etiketini kullanmaz. Bu etiket, dizine eklemeyi ve sıralamayı kesinlikle etkilemez.” Google, bu etiketi kullanmayı bıraktığını 2009'da duyurmuştu. Google bir sayfanın dilini algılamak için lang özelliğini de kullanmaz; rel=next ve rel=prev artık hiçbir şey yapmaz. Open Graph etiketlerinden Google yalnızca og:title etiketini, başlık bağlantılarının kaynaklarından biri olarak belgeler.
Bazı etiketler, Google onları saymasa bile önemlidir. Ekran okuyucular ve tarayıcılar lang kullanır. Viewport etiketi olmadan telefon sayfayı yaklaşık 980 CSS pikseli genişliğinde düzenler ve küçültür; bu yüzden dar ekranlar için yazılan stiller hiç uygulanmaz (MDN). Google, etiketin varlığının ona sayfanın mobil uyumlu olduğunu söylediğini belirtir. <meta charset> ise dosyanın ilk 1.024 baytı içinde olmalıdır; tarayıcılar onu yalnızca orada arar (HTML).
İki etiket daha göz atmaya değer. refresh bir yönlendirme gibi çalışır, ama Google bunun yerine sunucu tarafında bir 301 önerir. Google'da kullanımdan kalkan noarchive ise Bing'de içeriğin sohbet yanıtlarında görünüp görünemeyeceğine hâlâ karar verir (Bing).
Google kullanır
<meta name="description">Bazen snippet olurrobots · googlebotDizine ekleme ve snippet kuralları<title>Başlık bağlantısının bir kaynağıog:titleBaşlık bağlantısının bir başka kaynağıviewportMobil uyumlu sayfa işareti olarak okunurcharsetYalnızca ilk 1.024 baytta bulunurrefreshÇalışır, ama 301 daha iyidirGoogle yok sayar
keywordsDizine eklemeye ve sıralamaya etkisi yokrel=next · rel=prevArtık kullanılmıyorGoogle için değil, yine de önemli
<html lang>Dili algılamak için kullanılmaz; ekran okuyucular kullanırog:imageFacebook ve X kullanır

noarchiveGoogle'da kullanımdan kalktı, Bing kullanırKaynaklar
- Google Search Central: snippet'ler, başlık bağlantıları, robots meta etiketi ve X-Robots-Tag, noindex, Google'ın desteklediği meta etiketler, geçerli sayfa meta verileri, canonical URL'ler ve yerelleştirilmiş sürümler
- HTML Living Standard (başlık, açıklama, karakter kodlaması) ve MDN'de viewport meta etiketi
- Open Graph protokolü ve Meta for Developers'ta paylaşım görselleri
- X'in son yayımlanan haliyle kart belgeleri, Internet Archive'dan okundu: işaretleme ve summary_large_image
- Yandex'in robots meta yönergeleri ve Bing Webmaster Blog
- Google'ın yayımladığı değil, gözlenen değerler: piksel alanları ve yeniden yazma oranları, Zyppy'nin başlık çalışması gibi üçüncü taraf çalışmalarından; bu sayfadaki genişlikler Arial ile yaptığımız kendi ölçümlerimiz
Meta etiket kontrol aracı: sorular ve yanıtlar
Meta açıklama karakter sınırı nedir?
Title etiketi kaç karakter olmalı?
Bir sayfanın noindex olup olmadığı nasıl kontrol edilir?
noindex, nofollow ne anlama gelir?
Bir sayfayı robots.txt ile mi engellemeliyim, noindex mi kullanmalıyım?
Robots meta etiketi ile X-Robots-Tag arasındaki fark nedir?
Google neden benimkinden farklı bir meta başlık ve açıklama gösteriyor?
Facebook için Open Graph etiketleri nasıl kontrol edilir?
Twitter Card Validator hâlâ kullanılabilir mi?
Google meta keywords etiketini hâlâ kullanıyor mu?
Viewport meta etiketine ihtiyacım var mı?
Bu meta etiket kontrol aracı JavaScript çalıştırıyor mu?
Eksik bir şey mi var?Bir özellik ya da yeni bir araç önerin
Diğer web sitesi ve SEO araçları
Bağlantı Analizi
dofollow/nofollow algılama ve HTTP durum kontrolü ile sayfa bağlantılarını analiz edin
Yönlendirme Kontrolü
SEO için URL yönlendirmelerini, yönlendirme zincirlerini ve HTTP durum kodlarını kontrol edin
HTTP Başlık Kontrolü
HTTP yanıt başlıklarını ve güvenlik başlıkları derecelendirmesini analiz edin
CMS Tespit Aracı
Bir sitenin kullandığı CMS, tema, eklenti ve teknolojiler, her birinin kanıtıyla
Open Graph etiketleri ve Twitter kartları nedir?
Paylaşılan bir bağlantının gösterdiği başlığı, metni ve görseli belirleyen meta etiketlerdir. Open Graph'ın dört zorunlu özelliği vardır:
og:title,og:type,og:imageveog:url(OGP); X kenditwitter:etiketlerini okur, geri kalanı için bu og etiketlerine başvurur.Facebook en az 1200 × 630 px, 1,91:1'e yakın ve en fazla 8 MB bir görsel ister; bağlantı gönderisi için en küçük boyut 600 × 315 px'tir ve 200 × 200 px'in altındaki hiçbir görsel kabul edilmez (Facebook).
og:image:widthveog:image:heightekleyin: bunlar olmadan bot görseli önce indirmek zorundadır, bu yüzden bağlantıyı ilk paylaşan kişi görsel görmez. Bir Open Graph kontrol aracı olarak bu sayfa, görselin gerçek boyutunu dosyanın kendisinden okur.X'in Aralık 2023'te arşivlenen son yayımlanmış kart belgeleri,
summary_large_imageiçin en az 300 × 157 px boyutunda 2:1 bir görsel,summaryiçin en az 144 × 144 px bir kare istiyordu; ikisi de 5 MB'ın altında olmalı ve asla SVG olmamalıydı (X, arşiv).twitter:etiketleri yoksa Xog:title,og:descriptionveog:imagekullanır, amatwitter:cardbüyük kartı isteyene kadar yalnızca küçük özet kartını gösterebilir.İki ağ da okuduğunu önbelleğe alır: Facebook bir görseli URL'si değişene kadar saklar. Sharing Debugger aracı bir sayfayı yeniden çeker ve Facebook girişi gerektirir. X artık herkese açık, çalışan bir Card Validator sunmuyor: 26 Ekim 2026'da adresi yalnızca bir giriş sayfasına, ardından bir hataya götürüyordu. Geriye kalan pratik yol, bağlantıyı yeni bir gönderiye yapıştırıp yayımlamadan bakmaktır.
summary_large_imagesummarytwitter: etiketi yok mu? X og:title, og:description ve og:image etiketlerine başvurur.