











Robots.txt Test Aracı
Sonuca nasıl vardığını gösteren bir robots.txt test aracı: URL'niz hakkında karar veren kuralı satır numarasıyla, bir tarayıcının gerçekte okuduğu grubu ve diğerlerini neden yok saydığını, dosyanızın durum kodunun tüm site için ne anlama geldiğini gösterir. Böylece robots.txt kontrolünü tahmine bırakmazsınız.
Dosyasını okumak için bir alan adı, yolunu da test etmek için example.com/admin/ gibi tam bir URL girin.
- GetirmeGET /robots.txt
- Okumagruplar, kurallar, sitemap'ler
- Grupbir tarayıcının uyduğu kurallar
- Kararher tarayıcının neyi tarayabileceği
Google'ın test aracı kalktı: robots.txt testi şimdi nasıl yapılır?
Yukarıya bir alan adı girin ve “robots.txt'i kontrol et” düğmesini seçin. Dosyayı sunucumuzdan bir kez getiririz, ardından yazdığınız her URL'yi seçtiğiniz her tarayıcı için web tarayıcınızda bu dosyaya karşı test ederiz; Google'ın kendi robots.txt test aracı kaldırılmadan önce tam olarak bunu yapıyordu.
Google bu değişikliği 15 Kasım 2023'te duyurdu: “Bu güncellemenin bir parçası olarak robots.txt test aracını kullanımdan kaldırıyoruz.” Eski test aracı Aralık 2023'te kalktı ve onun yerini alan Search Console robots.txt raporu bambaşka bir şey.
Bu rapor, sahibi olduğunuz ve doğruladığınız bir mülkteki ilk 20 ana makine için Google'ın daha önce getirdiği dosyaları; kontrol tarihi, bayt cinsinden boyutu ve sorun sayısıyla listeler. Bir URL'yi bir kurala karşı test edemez, Google'a ait olmayan bir tarayıcıyı test edemez ve sahibi olmadığınız bir siteye bakamaz. Bu sayfa üçünü de yapar.
- Google'ın en son getirdiği dosya
- Boyutu ve kontrol edildiği tarih
- Ayrıştırma sorunlarının sayısı
- Bu URL bu tarayıcıya izinli mi?
- Hangi kuralın karar verdiği ve hangi satırda olduğu
- Google'a ait olmayan bir tarayıcı
- Sahibi olmadığınız bir site
Google bu değişikliği 15 Kasım 2023'te duyurdu ve test aracını Aralık 2023'te kaldırdı.
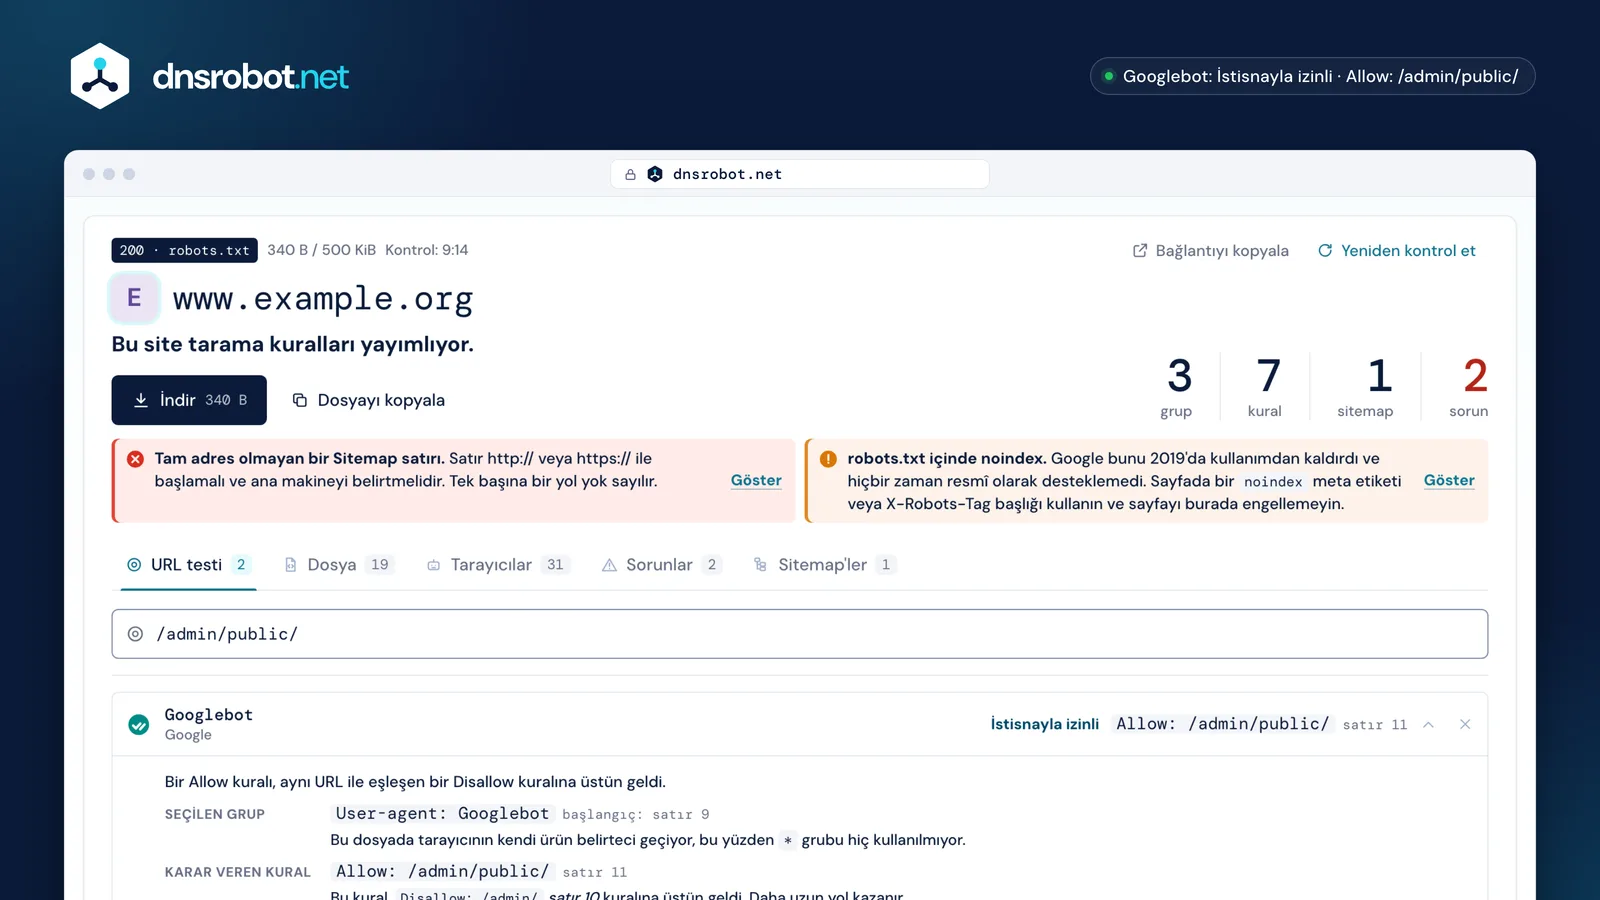
 SonuçTek başına durum kodu değil, bunun tüm site için anlamı. Burada bir 404 her tarayıcının her şeyi almasına izin verir; bir 503 ise standarda uyan bir tarayıcının hiçbir şey almaması demektir.Karar veren kuralBu URL için bu tarayıcıya karar veren kural; satır numarası ve üstün geldiği kuralla birlikte. En uzun eşleşme kazanır, eşitlikte Allow kazanır.Seçilen grupTarayıcının gerçekte okuduğu grup ve diğerlerini neden yok saydığı. Diğer araçların atladığı adım tam olarak budur.BulgularHer sorun dosyadaki kendi satırında, ne yapılması gerektiğiyle birlikte.
Google bir tarayıcı için hangi grubun geçerli olduğunu nasıl seçer?
Bir tarayıcı tam olarak tek bir kural kümesine uyar. User-agent satırında kendi ürün belirteci (product token) geçen bir grup arar; yalnızca böyle bir grup yoksa * adlı gruba geri döner. * grubu bir yedektir, asla bir ek değildir.
RFC 9309 bunu açıkça söyler: “Tarayıcılar, ürün belirteciyle eşleşen grubu bulmak için büyük/küçük harfe duyarsız eşleştirme KULLANMALIDIR” ve “eşleşen bir grup [yoksa], tarayıcılar varsa değeri * olan bir user-agent satırına sahip gruba UYMALIDIR.” Google da aynı şeyi kendi sözleriyle söyler: “Belirli bir tarayıcı için yalnızca bir grup geçerlidir.”
Bundan iki sonuç çıkar ve kafa karışıklığının çoğu bu ikisinden doğar. Aynı belirtecin geçtiği birden fazla grup tek grupta birleştirilir, bu yüzden iki ayrı User-agent: Googlebot bloğunun ikisi de geçerlidir. Ama adı geçen bir grup ile * grubu asla birleştirilmez: bir Googlebot grubu var olduğu anda * altındaki bir Allow: / Googlebot için hiçbir şey yapmaz. Googlebot-Image ve diğer Googlebot-* tarayıcıları googlebot grubuna geri döner; bu, tarayıcının eşleştiricinin üzerine eklediği bir davranıştır ve Google'ın kendi açık kaynaklı eşleştiricisi bunu uygulamaz.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Bir grupta bu tarayıcının kendi belirteci geçiyor mu?O grubu oku.
*grubu kullanılmaz. - 2Birden fazla grupta mı?Hepsini tek grup olarak oku.
- 3Bir
*grubu var mı?*grubunu oku. - —Hiçbir kural uygulanmaz. Her şey taranabilir.
* altındaki Allow: / hiç okunmaz.
* grubunu okur.Allow mu, Disallow mu: en uzun eşleşme kazanır
Bir URL ile birden fazla kural eşleştiğinde, türü ne olursa olsun yolu en uzun olan kazanır. Bir Allow ile bir Disallow aynı uzunluktaysa Allow kazanır.
RFC 9309: “Bulunan en spesifik eşleşme KULLANILMALIDIR. En spesifik eşleşme, en çok oktete sahip eşleşmedir” ve “bir allow kuralı ile bir disallow kuralı eşdeğerse allow kuralının kullanılması ÖNERİLİR.” Google da aynı davranışı anlatır: çakışan kurallar söz konusu olduğunda “en az kısıtlayıcı olan kuralı” kullanır.
Karakter değil, oktet: ğ veya ş gibi harfler ya da %2F içeren bir yol yüzde kodlamasından sonra karşılaştırılır ve basit araçlar tam da burada yanılır. Yalnızca yol ve sorgu, ilk karakterden başlayarak karşılaştırılır ve yönerge adları büyük/küçük harfe duyarlı olmasa da bunlar duyarlıdır: Disallow: /File.pdf, /file.pdf için hiçbir şey yapmaz.
/admin/report.pdfAllow kazanır: yolun daha büyük kısmıyla eşleşir.
Disallow: /files/7 karakterAllow: /files/7 karakterUzunluklar eşit, bu yüzden Allow kazanır. Google'ın deyişiyle “en az kısıtlayıcı olan kural”.
Yalnızca iki joker karakter var: `*` ve `$`
* herhangi bir karakter dizisinin yerini tutar, $ ise URL'nin sonunu belirtir. Başka bir şey yoktur: düzenli ifade (regex) yoktur ve ?, ., [ ya da + karakterlerinin özel bir anlamı yoktur; hepsi sıradan karakterlerdir.
$ içermeyen bir kural bir ön ektir, bu yüzden Disallow: /admin aynı zamanda /administrator ve /admin-tools yollarını da engeller. Klasörü kastediyorsanız sona eğik çizgi ekleyin (/admin/), tam olarak o URL'yi kastediyorsanız bir $ ekleyin. Disallow: /*.pdf$ her PDF'yi engeller; Disallow: /*? sorgu dizesi içeren her URL'yi engeller.
Yukarıdaki URL testi, bir kuralın başka hangi yolları yakaladığını kararı veren eşleştiricinin aynısıyla gösterir; böylece istediğinizden daha fazlasına uzanan bir kural, yayımlanmadan önce görünür olur.
* ile $ ve her kalıbın gerçekte yakaladıkları/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ ve + sıradan karakterlerdir. robots.txt'te düzenli ifade yoktur.
robots.txt durum kodunuz ne anlama geliyor?
Aynı bozuk dosyaya verilen bir 4xx ile bir 5xx tam tersi sonuçlar doğurur. 4xx, dosya yokmuş gibi okunur, yani bir tarayıcı her şeyi alabilir. 5xx ise dosyanın tanımsız olduğu anlamına gelir, yani standarda uyan bir tarayıcı hiçbir şey almamalıdır.
RFC 9309 §2.3.1.3: durum kodu dosyanın “tarayıcı için kullanılamaz olduğunu gösteriyorsa, tarayıcı sunucudaki tüm kaynaklara ERİŞEBİLİR”. §2.3.1.4: dosya “sunucu veya ağ hataları nedeniyle ulaşılamazsa… tarayıcı tam bir engelleme olduğunu VARSAYMALIDIR.” Google tarayıcıları ise “429 hariç tüm 4xx hatalarını, geçerli bir robots.txt dosyası yokmuş gibi işler”; bu da 429'u 5xx tarafına koyar.
Google ardından 5xx durumunu kendi basamaklarıyla yumuşatır: ilk 12 saat taramayı durdurur, sonraki 30 gün boyunca elindeki son iyi kopyayı kullanır ve bundan sonra sitenin geri kalanı erişilebilir durumdaysa hiç robots.txt yokmuş gibi davranır. Google en az beş yönlendirme atlamasını izler, ardından durur ve “bunu robots.txt dosyası için bir 404 olarak işler”; yani her şey serbestçe taranabilir. Ve çözümlenmeyen bir ad, kimseyi engelleyen bir site değildir: ortada ne dosya vardır ne de karar.
200Dosyadaki kurallara uyar.301, 302En az beş yönlendirme atlamasını izler, sonra durur. Google bundan sonra dosyayı 404 olarak okur.403, 404Dosya yokmuş gibi her şeyi tarar.429Hiçbir şey taramaz. Google bunu 4xx yanıtlarıyla değil, 5xx yanıtlarıyla birlikte sayar.500, 503Standarda göre hiçbir şey taramaz.Böyle bir ad yokOkunacak bir site yok, bu yüzden karar da yok.- 1İlk 12 saatSiteyi taramayı durdurur ve dosyayı getirmeyi denemeye devam eder
- 230 güne kadarrobots.txt dosyasının son iyi kopyasını kullanır
- 330 günden sonraSite erişilebilir durumdaysa robots.txt yokmuş gibi davranır
robots.txt bir sayfayı Google'ın dışında tutar mı?
Hayır. robots.txt bir tarayıcıdan sayfayı getirmemesini ister; bir arama motorundan onu listelememesini istemez. Google izin verilmeyen bir sayfayı okuyamaz, ama başka sayfalar ona bağlantı verdiğinde “URL'yi dizine ekleyip arama sonuçlarında snippet olmadan gösterebilir”.
Search Console'daki “robots.txt tarafından engelleniyor olsa da dizine eklendi” durumu tam olarak budur: “Google sayfayı istemez ve taramaz ancak engellenen sayfanıza bağlantı veren sayfadaki bilgileri kullanarak sayfayı dizine eklemeye devam edebiliriz.” Google'ın kendi çözümü, kendi sözleriyle: “robots.txt blokunu kaldırın ve noindex etiketini kullanın”.
Bu yüzden robots.txt'teki en yaygın hata tek bir satır değil, bir çifttir: burada hem izin verilmeyen hem de noindex taşıyan bir URL. Google bunu açıkça söylüyor: “Sayfa robots.txt dosyası tarafından engellenirse veya tarayıcı sayfaya erişemezse noindex kuralını hiçbir zaman görmez ve sayfa, arama sonuçlarında görüntülenmeye devam edebilir”. Birini seçin: taramayı engelleyin ya da tarayıcıyı içeri alıp ona dizine eklememesini söyleyin.
- Tarayıcı
- robots.txt dosyasını okur
- URL'ye izin verilmiyor
- Sayfayı getirmez
<meta name="robots" content="noindex">Hiç okunmazBir sayfayı dışarıda tutmak için: tarayıcıyı içeri alıp noindex kullanın ya da giriş yapmayı zorunlu kılın.
ChatGPT, Claude ve diğer yapay zekâ tarayıcılarını nasıl engellerim?
Her biri için sıradan bir grupla. Yapay zekâ şirketleri tıpkı arama motorları gibi ürün belirteçleri yayımlar ve çoğu birden fazla tarayıcı çalıştırır: biri eğitim için, biri bir soruyu size geri bağlantı vererek yanıtlamak için, biri de bir kişi istediği için bir sayfayı getirmek için.
Bu üçünü birbirinden ayırmaya değer. Bir eğitim tarayıcısını engellemek sayfalarınızı bir modelin dışında tutar; bir yanıt tarayıcısını engellemek ise sizi bu ürünlerin gösterdiği kaynak atıflarından da çıkarır. Yukarıdaki “Tarayıcılar” görünümü her birinin amacını, belirtecini ve işletmecisinin kendi belgelerine göre neye uyduğunu gösterir; böylece yapay zekâ yanıtlarından kaybolmadan eğitimi reddedebilirsiniz.
Bazı işletmeciler, bir kişi adına sayfa getiren tarayıcının robots.txt'i yok sayabileceğini açıkça söyler, çünkü bu tarayıcı tarama yapmıyor, bir kullanıcı adına hareket ediyordur. Tablo bunları işaretler. Giderek daha çok sitenin yayımladığı, Cloudflare'in Content-Signal satırları ise bir tarama kuralı değil, içeriğinizin ne için kullanılabileceğine dair bir beyandır: bu sayfa onları hata saymak yerine korur ve açıklar.
GPTBotUyarOAI-SearchBotUyarChatGPT-UserYok sayabilir
ClaudeBotUyarClaude-SearchBotUyarClaude-UserUyar
PerplexityBotUyarPerplexity-UserYok sayabilirGoogle-ExtendedYalnızca belirteçBöyle bir tarayıcı yokBöyle bir tarayıcı yok
Applebot-ExtendedYalnızca belirteçBöyle bir tarayıcı yokBöyle bir tarayıcı yok
meta-externalagentUyarmeta-webindexerUyarmeta-externalfetcherYok sayabilir
AmazonbotUyarBöyle bir tarayıcı yokAmzn-UserYok sayabilir- EğitimBir modeli eğitmek için sayfa toplar.
- Yapay zekâ yanıtlarıBir soruyu yanıtlamak için sayfa getirir, genellikle size geri bağlantı vererek.
- Bir kişinin isteğiBiri istediği için tek bir sayfa getirir. Bazı işletmeciler bu tarayıcının robots.txt'i yok sayabileceğini söyler.
Crawl-delay, Clean-param, Host ve Content-Signal: hangisini kim okur?
Google dört alanı okur, başkasını okumaz: user-agent, allow, disallow ve sitemap. robots.txt'teki diğer her şeyi ya başka biri okur ya da hiç kimse okumaz; bilinmeyen bir satır ise asla hata değildir.
Google dört alanını sıralar ve “crawl-delay gibi diğer alanlar desteklenmez” diye ekler. Bing ise Crawl-delay yönergesini destekler; Bing'in kendi blogunda yazdığı gibi: “crawl-delay yönergesi değer olarak yalnızca pozitif tam sayıları kabul eder”. Clean-param Yandex'e aittir, başka kimseye değil. Host ne standartta ne de Google'ın listesinde yer alır.
Hiçbiri bir dosyayı bozmaz. RFC 9309'a göre diğer kayıtların ayrıştırılması “açıkça tanımlanmış kayıtların ayrıştırılmasına MÜDAHALE ETMEMELİDİR”; bu yüzden bir satırı tanımayan tarayıcı onu atlar. Gerçekten ölü olan iki yönerge, robots.txt içindeki noindex ve nofollow yönergeleridir: Google bunları işleyen kodu 2019'da kaldırdı ve bugün Google'da hiçbir etkileri yok.

User-agentOkurOkurOkurAllowOkurOkurOkurDisallowOkurOkurOkurSitemapOkurOkurOkurCrawl-delayYok sayarOkurDoğrulanmadıClean-paramYok sayarYok sayarOkurHostYok sayarYok sayarDoğrulanmadınoindexYok sayarDoğrulanmadıDoğrulanmadıContent-SignalYok sayarDoğrulanmadıDoğrulanmadı- Google dört alanı desteklediğini açıkça söyler: user-agent, allow, disallow ve sitemap.
- Bing'in kendi blogu Crawl-delay desteğini doğrular. Bunun için bir aralık veya birim yayımlamıyoruz: Bing'in güncel yardım sayfası birincil kaynak olarak okunamadı.
- Google tarafından 2019'da kaldırıldı ve hiçbir zaman standardın parçası olmadı.
- Cloudflare'in Content Signals Policy belgesi: içeriğin nasıl kullanılabileceğine dair bir beyan, tarama kuralı değil.
500 KiB sınırı ve ötesinde kalanlar
Google bir robots.txt dosyasının ilk 500 kibibaytını okur ve sonrasındaki her şeyi hiçbir yerde hata vermeden yok sayar. RFC 9309, bir tarayıcının ayrıştırma sınırının en az 500 KiB olmasını ister; Google ise aynı değeri üst sınır olarak bildirir.
Google: “Google robots.txt dosyaları için 500 kibibaytlık (KiB) bir boyut sınırlaması uygulamaktadır. Maksimum dosya boyutundan sonraki içerik yok sayılır.” Hiçbir şey sizi uyarmaz. 600 KiB'lık bir dosya geçersiz değildir; yalnızca son 100 KiB'lık kısmı Googlebot için hiç var olmaz ve oradaki bir Disallow hiçbir şeyi korumaz.
Siteler bu sınıra sandığınızdan sık ulaşır: her kampanya parametresi, her filtre ve her eski staging klasörü için bir kural. Yukarıdaki kontrol dosyayı bu sınırla karşılaştırır ve ne kadarının ötesinde kaldığını söyler. Uzun listeleri kalıplarla değiştirin (Disallow: /*?filter=) ve önemli kuralları en üste koyun.
Disallow: /cart/ · Satır 12UyulurDisallow: /private/ · Satır 9.412Hiç okunmazDosya hâlâ 200 yanıtı verir ve hâlâ ayrıştırılır. Hiçbir yer size geri kalanın atıldığını söylemez.
Sık yapılan robots.txt hataları ve bunları nasıl bulursunuz
Bozuk robots.txt dosyalarının çoğu altı yoldan biriyle bozulur ve bir şey onları test edene kadar hiçbiri fark edilmez: dosya hâlâ 200 yanıtı verir, hâlâ ayrıştırılır ve hâlâ doğru görünür.
Herkesin bildiği hata, site staging ortamından canlıya geçerken geride kalan Disallow: / satırıdır. Diğer beşi: /administrator yolunu da yakalayan Disallow: /admin gibi, istediğinizden fazlasına uzanan bir kural; adı geçen bir grubun sessizce yok saydığı, * altındaki bir Allow: /; tam adres yerine yol olarak yazılmış bir Sitemap: satırı; başında eğik çizgi olmayan ve hiçbir şeyle eşleşmeyen bir yol; ve Google'ın 2019'dan beri okumadığı bir noindex satırı.
Yukarıdaki kontrolü çalıştırın, ardından “Sorunlar” görünümünü okuyun: her bulgu dosyadaki kendi satırında, ne yapmanız gerektiğiyle birlikte durur. Dosyayı denetlemek yerine düzenliyorsanız Robots.txt Oluşturucu, bu kontrol aracının zaten okuduğu bir dosya yazar.
Kaynaklar
- RFC 9309, Robots Exclusion Protocol: gruplar, öncelik, yüzde kodlamalı eşleştirme, durum kodları ve 500 KiB alt sınırı
- Google Search Central: Google robots.txt'i nasıl yorumlar, robots.txt dosyası oluşturma ve gönderme ve noindex ile dizine eklemeyi engelleme
- Google Search Console Yardım: robots.txt raporu ve Sayfa dizine ekleme raporu
- Bing: Crawl-delay ve Bing tarayıcısı ve Yandex: Clean-param
- Google'ın açık kaynaklı robots.txt ayrıştırıcısı: Googlebot'un kendisinin kullandığı eşleştirici
- Her tarayıcının belirteci, amacı ve robots.txt davranışı kendi işletmecisinin belgelerinden alınmıştır; bağlantısı “Tarayıcılar” görünümünde tarayıcının yanında verilir
Disallow: /Staging'den kalma: canlı sitenin tamamı her tarayıcıya kapalı.Disallow: /admin/administrator ve /admin-tools yollarını da engeller. Sona eğik çizgi ekleyin.User-agent: * altında Allow: /Dosyanın herhangi bir yerinde kendi grubu olan bir tarayıcı bunu hiç okumaz.Sitemap: /sitemap.xmlBir Sitemap satırı, ana makineyi içeren tam bir adres olmalıdır.Disallow: adminYol / ile başlar. Bu kural hiçbir şeyle eşleşmez.noindex: /private/2019'dan beri ölü. Sayfa taranabilir ve dizine eklenebilir kalır.Robots.txt test aracı: sık sorulan sorular
Google'ın robots.txt test aracına ne oldu?
User-agent: * altındaki Allow: / satırım neden yok sayılıyor?
* grubu tamamen atlanır; o bir yedektir, ek değil. Gruplar yalnızca birden fazlasında aynı belirteç geçtiğinde birleştirilir. Yukarıdaki URL testi her tarayıcı için hangi grubun seçildiğini ve diğerlerinin neden seçilmediğini gösterir.robots.txt bir sayfanın dizine eklenmesini engeller mi?
noindex meta etiketi veya X-Robots-Tag başlığı sunun ya da sayfayı bir girişin arkasına koyun.noindex etiketim neden çalışmıyor?
noindex dahil sayfadaki hiçbir şeyi görmez; bu yüzden sayfa başka yerlerdeki bağlantılar sayesinde arama sonuçlarında görünmeye devam edebilir. Google bunu doğrudan söyler: noindex kuralının etkili olabilmesi için sayfanın “robots.txt dosyası tarafından engellenmemesi” gerekir. Disallow satırını kaldırın ve noindex etiketini koruyun.robots.txt için 404 ne demek? Peki 500?
Bir Allow ve bir Disallow ikisi de eşleşirse hangisi kazanır?
robots.txt'te hangi joker karakterler çalışır?
* herhangi bir karakter dizisinin yerini tutar, $ ise URL'nin sonunu belirtir. Geri kalan her şey olduğu gibi okunur: ?, ., [, ] ve + yalnızca kendileriyle eşleşir ve düzenli ifade yoktur. $ içermeyen bir kural bir ön ektir, bu yüzden Disallow: /admin aynı zamanda /administrator yolunu da yakalar. Yollar büyük/küçük harfe duyarlıdır, Disallow gibi yönerge adları ise değildir.Google Crawl-delay yönergesini destekliyor mu?
Bir robots.txt dosyası en fazla ne kadar büyük olabilir?
GPTBot ve ClaudeBot gibi yapay zekâ tarayıcılarını nasıl engellerim?
Disallow: / içeren kendi grubunu verin. Yapay zekâ şirketlerinin çoğu farklı işler yapan birkaç tarayıcı çalıştırır: biri eğitim için, biri soruları size geri bağlantı vererek yanıtlamak için, biri de bir kişi adına tek bir sayfa getirmek için. Yukarıdaki “Tarayıcılar” görünümü her belirteci, amacını ve işletmecisinin neye uyduğunu söylediğini gösterir; böylece yapay zekâ atıflarını kaybetmeden eğitimi reddedebilirsiniz.Robots.txt kontrolü ile robots.txt doğrulama aynı şey mi?
robots.txt bir güvenlik riski mi?
Disallow: /admin-backup/ satırı, tam da gizlemek istediğiniz şeyi gösteren bir tabeladır. İçindeki hiçbir şey erişimi engellemez; bir tarayıcı ona yalnızca işletmecisi öyle seçtiği için uyar. Özel yolları kimlik doğrulama veya bir güvenlik duvarı kuralıyla koruyun; bu kontrol aracı da dosyanızda davetiye gibi duran yolları size gösterir.Eksik bir şey mi var?Bir özellik ya da yeni bir araç önerin
Daha fazla tarama ve dizine ekleme aracı
Sitemap Kontrolü
Bir web sitesinin XML sitemap dosyasını bulun ve doğrulayın: söz dizimi, URL sınırları, lastmod tarihleri, robots.txt çakışmaları ve bozuk veya yönlendiren URL'ler
Site Haritası Oluşturucu
Web sitenizi tarayın ve bir XML site haritası, bir HTML site haritası ve görsel bir site ağacı edinin
HTTP Başlık Kontrolü
HTTP yanıt başlıklarını ve güvenlik başlıkları derecelendirmesini analiz edin
Yönlendirme Kontrolü
SEO için URL yönlendirmelerini, yönlendirme zincirlerini ve HTTP durum kodlarını kontrol edin
User Agent'ım Nedir
User Agent dizgisinden tarayıcı, işletim sistemi, cihaz türü, oluşturma motoru ve CPU mimarisini algılayın
Bağlantı Analizi
dofollow/nofollow algılama ve HTTP durum kontrolü ile sayfa bağlantılarını analiz edin