











robots.txtテスター
判定の過程まで見せるrobots.txtテスターです。URLを判定したルールとその行番号、クローラーが実際に読んだグループとほかのグループが無視された理由、そしてファイルのステータスコードがサイト全体にとって何を意味するかを表示します。
ドメインならファイルを読み取ります。example.com/admin/ のような完全なURLなら、そのパスもテストします。
- 取得GET /robots.txt
- 読み取りグループ・ルール・サイトマップ
- グループクローラーが従うルール
- 判定各クローラーがクロールできる範囲
Google の robots.txtテスター終了後に robots.txt をテストする方法
上の欄にドメインを入力し、「robots.txtをチェック」を選びます。当サイトのサーバーからファイルを1回取得し、その後は入力したURLを、選んだクローラーごとに、お使いのブラウザ内でテストします。Google 自身の robots.txtテスターが廃止されるまで担っていた役割です。
Google は2023年11月15日にこの変更を告知しました:「このアップデートの一環として、robots.txt テスターを終了します」。旧テスターは2023年12月に姿を消し、その代わりとなった Search Console の robots.txt レポートは、まったく別の種類のものです。
このレポートは、所有権を確認したプロパティの上位20ホストについて、Google がすでに取得したファイルを、確認日時、バイト単位のサイズ、問題の件数とともに一覧表示します。ルールに対してURLをテストすることも、Google 以外のクローラーをテストすることも、自分が所有していないサイトを見ることもできません。このページは、その3つをすべて行います。
- Google が最後に取得したファイル
- そのサイズと確認日時
- 解析の問題の件数
- このURLはこのクローラーに許可されているか?
- 判定を決めたルールと、その行
- Google 以外のクローラー
- 自分が所有していないサイト
Google は2023年11月15日にこの変更を告知し、2023年12月にテスターを廃止しました。
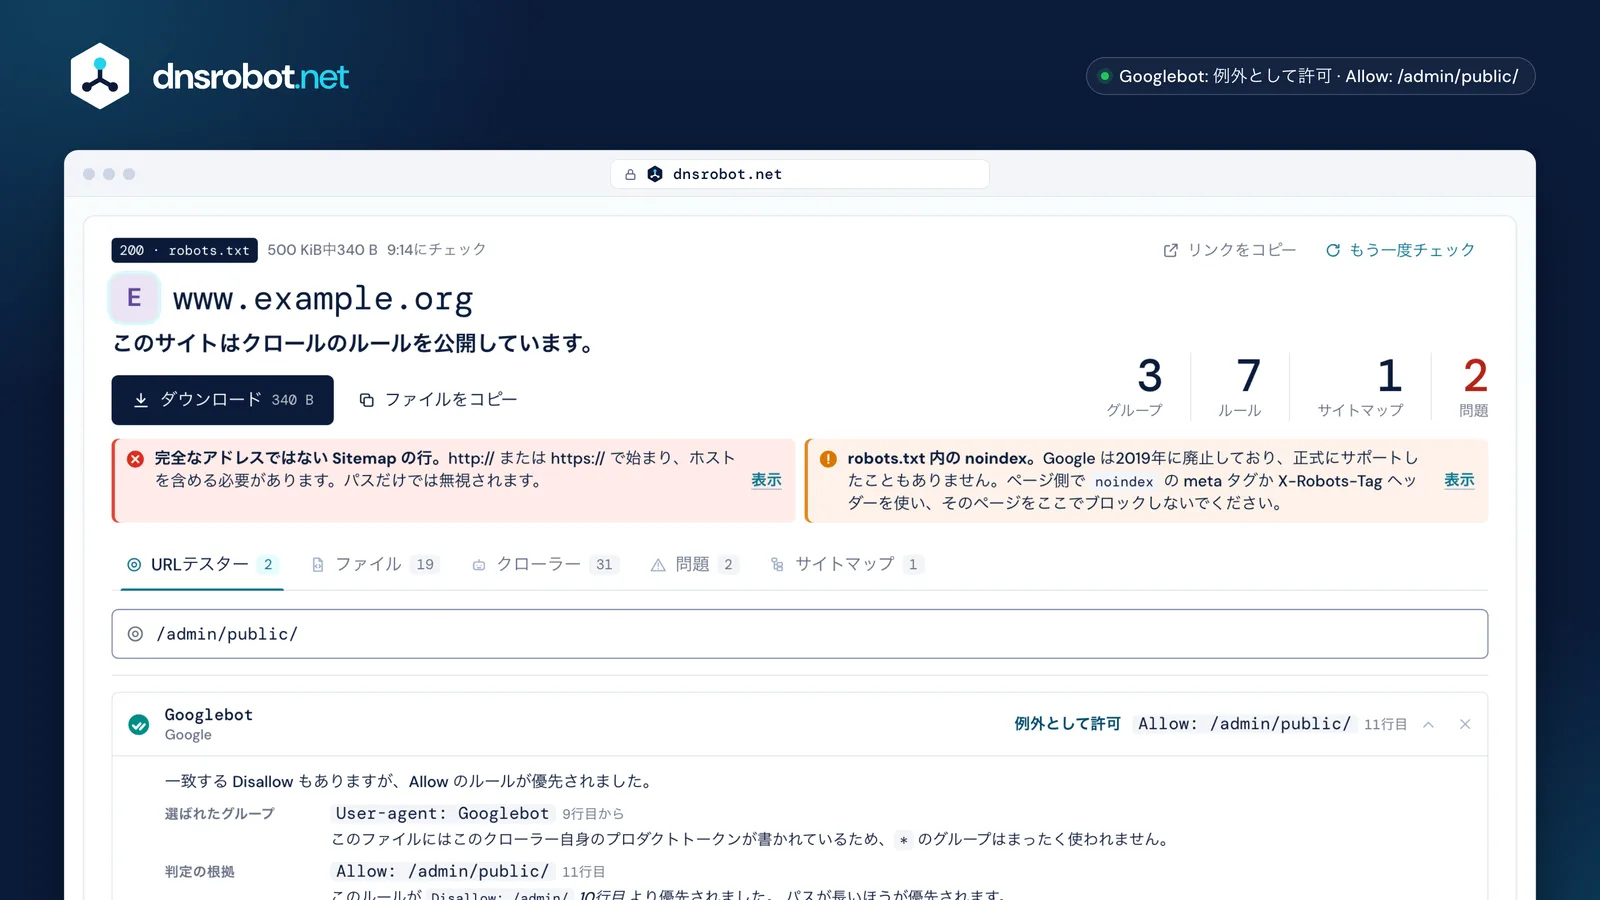
 結果の意味ステータスコードそのものではなく、それがサイト全体にとって何を意味するかを示します。ここで404なら、すべてのクローラーがすべてを取得でき、503なら、標準に従うクローラーは何も取得しません。判定を決めたルールこのクローラーにとってこのURLの判定を決めたルールを、行番号と、競合して負けたルールとともに示します。最も長く一致したルールが優先され、同じ長さなら Allow が優先されます。選ばれたグループクローラーが実際に読んだグループと、ほかのグループが無視された理由です。ほかのツールが省いている手順です。指摘事項すべての問題をファイルの該当行に表示し、対処法も添えています。
Google はクローラーに適用するグループをどう選ぶのか?
クローラーが従うルールのセットはちょうど1つです。まず User-agent の行に自分のプロダクトトークンが書かれたグループを探し、それが無い場合に限って * のグループにフォールバックします。* のグループは代替であって、追加ではありません。
RFC 9309 ははっきりこう定めています。「クローラーは、プロダクトトークンに一致するグループを見つけるために、大文字と小文字を区別しない照合を使わなければならない(MUST)」、そして「一致するグループが存在しない場合、クローラーは値が * の user-agent 行を持つグループが存在すれば、それに従わなければならない(MUST)」。Google も自らの言葉で同じことを述べています。「特定のクローラーに対して有効なグループは1つだけです」。
ここから2つのことが導かれ、この2つが混乱の大半を生んでいます。同じトークンを指定する複数のグループは1つにまとめられるので、User-agent: Googlebot のブロックが2つあれば両方とも有効です。しかし、名前を指定したグループと * のグループがまとめられることは決してありません。Googlebot のグループが存在すれば、* の下の Allow: / は Googlebot に対して何の効果もありません。Googlebot-Image などの Googlebot-* クローラーは googlebot のグループにフォールバックしますが、これは照合ルールの上にクローラーが加えている動作で、Google 自身のオープンソースの照合ライブラリには実装されていません。
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1このクローラー自身のトークンを指定したグループがある?そのグループを読む。
*のグループは使わない。 - 2複数のグループが指定している?それらを1つのグループとして読む。
- 3
*のグループがある?*のグループを読む。 - —適用されるルールなし。すべてクロールできる。
* の下の Allow: / は読まれない。
* を読む。Allow と Disallow:最も長く一致したルールが優先
1つのURLに複数のルールが一致した場合、種類にかかわらず、パスが最も長いルールが優先されます。Allow と Disallow が同じ長さなら、Allow が優先されます。
RFC 9309:「最も具体的な一致を使わなければならない(MUST)。最も具体的な一致とは、最も多くのオクテットを持つ一致である」、そして「allow ルールと disallow ルールが同等であれば、allow ルールを使うべきである(SHOULD)」。Google も同じ動作を、ルールが競合した場合は「制限が最も少ないルール」を使う、と説明しています。
数えるのは文字ではなくオクテット(バイト)です。アクセント付きの文字や %2F を含むパスはパーセントエンコード後に比較され、単純なツールはここで間違えます。比較するのはパスとクエリだけで、先頭の文字から始まり、ディレクティブ名とは違って大文字と小文字を区別します。Disallow: /File.pdf は /file.pdf には何の効果もありません。
/admin/report.pdfAllow が優先:パスのより多くの部分に一致しているため。
Disallow: /files/7文字Allow: /files/7文字長さが同じなので Allow が優先。Google の言う「制限が最も少ないルール」です。
ワイルドカードは `*` と `$` の2つだけ
* は任意の文字列を、$ はURLの末尾を表します。ほかにはありません。正規表現は使えず、?、.、[、+ にも特別な意味は無く、すべてただの文字です。
$ の無いルールは前方一致なので、Disallow: /admin は /administrator や /admin-tools もブロックします。フォルダを指すときは末尾にスラッシュを付け(/admin/)、そのURLだけを指すときは $ を付けます。Disallow: /*.pdf$ はすべてのPDFを、Disallow: /*? はクエリ文字列を持つすべてのURLをブロックします。
上の「URLテスター」は、判定を出したのと同じ照合ロジックで、そのルールがほかに一致するパスも表示します。意図より広く一致するルールを、公開する前に見つけられます。
* と $、それぞれのパターンが実際に一致するもの/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?、.、[、+ はただの文字です。robots.txt に正規表現はありません。
robots.txt のステータスコードは何を意味するのか?
同じ壊れたファイルでも、4xx と 5xx では結果が正反対です。4xx ならファイルは無いものとして扱われ、クローラーはすべてを取得できます。5xx ならファイルの内容は不明とされ、標準に従うクローラーは何も取得してはいけません。
RFC 9309 §2.3.1.3:ステータスがファイルは「クローラーにとって利用できない」ことを示す場合、「クローラーはサーバー上のあらゆるリソースにアクセスしてよい(MAY)」。§2.3.1.4:「サーバーまたはネットワークのエラーにより到達できない……場合、クローラーは完全な禁止を想定しなければならない(MUST)」。Google は「429 を除くすべての 4xx エラーを、有効な robots.txt ファイルが存在しないものとして」扱うため、429は5xxの側に入ります。
Google はさらに、5xx の場合を独自の段階的な対応で和らげています。最初の12時間はクロールを止め、続く30日間は最後に取得できた正常なコピーを使い、その後はサイトのほかの部分が稼働していれば、robots.txt が無いものとして扱います。Google はリダイレクトを少なくとも5ホップたどった後で停止し、「robots.txt ファイルの 404 として処理します」。つまり、自由にクロールしてよいということです。そして、名前解決できないドメインは、誰かをブロックしているサイトではありません。ファイルも無く、判定もありません。
200ファイルのルールに従う。301, 302少なくとも5ホップたどり、そこで止まる。その後 Google はファイルを404として扱う。403, 404ファイルが無いものとして、すべてクロールする。429何もクロールしない。Google はこれを4xxではなく5xxの側に数える。500, 503標準に従い、一切クロールしない。存在しない名前読み取るサイトが無いため、判定も無い。- 1最初の12時間サイトのクロールを止め、ファイルの取得を再試行し続ける
- 230日まで最後に取得できた正常な robots.txt のコピーを使う
- 330日経過後サイトが稼働していれば、robots.txt が無いものとして扱う
robots.txt でページを Google の検索結果から除外できますか?
できません。robots.txt はクローラーにページを取得しないよう求めるもので、検索エンジンに掲載しないよう求めるものではありません。Google は Disallow されたページを読めませんが、ほかのページからリンクされていれば、「URL をインデックスに登録して、スニペットなしで検索結果に表示することはできます」。
これが Search Console のステータス「robots.txt によりブロックされましたが、インデックスに登録しました」です:「Google はそのページをリクエストしてクロールすることはありませんが、ブロックされたページにリンクしているページの情報を使って、インデックスに登録することはできます」。Google 自身の言葉では、対処法は「robots.txt のブロックを解除し、noindex ディレクティブを使用する」ことです。
つまり robots.txt で最もよくある間違いは、1行ではなく組み合わせです。ここでブロックされ、しかも noindex が付いているURLです。Google ははっきり述べています。「ページが robots.txt ファイルでブロックされている場合……クローラーは noindex ルールを認識できず、ページは引き続き検索結果に表示される可能性があります」。どちらか1つを選んでください。クロールをブロックするか、クロールさせたうえでインデックスに登録しないよう伝えるかです。
- クローラー
- robots.txt を読む
- URLは Disallow されている
- ページを取得しない
<meta name="robots" content="noindex">読まれないページを除外するには:クローラーを入れて noindex を使うか、ログインを必須にする。
ChatGPT や Claude などのAIクローラーをブロックするには?
普通のグループを1つずつ書くだけです。AI企業も検索エンジンと同じようにプロダクトトークンを公開しており、ほとんどは複数のクローラーを運用しています。学習用、質問に答えてリンクを返す回答用、そして人に頼まれて1ページを取得するものです。
この3つは分けて考える価値があります。学習用のクローラーをブロックすれば、ページはモデルに取り込まれません。回答用のクローラーをブロックすると、それらのサービスが表示する引用元からも外れます。上の「クローラー」の表示には、それぞれの目的、トークン、運営元のドキュメントが従うと述べている内容を載せているので、AIの回答から消えずに学習だけを拒否できます。
1人のユーザーのためにページを取得するクローラーは、クロールではなくユーザーの代わりに動いているので robots.txt を無視する場合がある、と明言している運営元もあります。表ではそれらに印を付けています。また、採用するサイトが増えている Cloudflare の Content-Signal の行は、クロールのルールではなく、コンテンツの利用目的についての表明です。このページはそれをエラー扱いせず、そのまま残して説明します。
GPTBot従うOAI-SearchBot従うChatGPT-User無視する場合あり
ClaudeBot従うClaude-SearchBot従うClaude-User従う
PerplexityBot従うPerplexity-User無視する場合ありGoogle-Extendedトークンのみ該当クローラーなし該当クローラーなし
Applebot-Extendedトークンのみ該当クローラーなし該当クローラーなし
meta-externalagent従うmeta-webindexer従うmeta-externalfetcher無視する場合あり
Amazonbot従う該当クローラーなしAmzn-User無視する場合あり- 学習モデルの学習用にページを収集する。
- AIの回答質問に答えるためにページを取得し、通常はあなたのサイトへのリンクを添える。
- 個人のリクエスト誰かに頼まれて1ページを取得する。robots.txt を無視する場合があると述べている運営元もある。
Crawl-delay・Clean-param・Host・Content-Signal:どれを誰が読むのか?
Google が読むフィールドは user-agent、allow、disallow、sitemap の4つだけです。robots.txt のそれ以外の行はほかの誰かが読むか、誰も読みません。そして、不明な行がエラーになることはありません。
Google は4つのフィールドを挙げたうえで、「crawl-delay などのその他のフィールドはサポートされていません」と付け加えています。Bing は Crawl-delay をサポートしており、Bing 自身のブログによると「crawl-delay ディレクティブに指定できる値は、正の整数だけ」です。Clean-param は Yandex のもので、ほかは使いません。Host は標準にも Google の一覧にもありません。
どれもファイルを壊しはしません。RFC 9309 は、ほかのレコードの解析が「明示的に定義されたレコードの解析を妨げてはならない(MUST NOT)」と定めているので、知らない行はクローラーが読み飛ばします。本当に役目を終えたディレクティブは、robots.txt 内の noindex と nofollow の2つです。Google は2019年にそれらを処理するコードを廃止しており、現在の Google では何の効果もありません。

User-agent読む読む読むAllow読む読む読むDisallow読む読む読むSitemap読む読む読むCrawl-delay無視する読む未確認Clean-param無視する無視する読むHost無視する無視する未確認noindex無視する未確認未確認Content-Signal無視する未確認未確認- Google は4つのフィールドをサポートすると明言しています:user-agent、allow、disallow、sitemap。
- Crawl-delay は Bing 自身のブログで確認できます。現在の Bing のヘルプページを一次情報として読めなかったため、値の範囲や単位は掲載していません。
- Google が2019年に廃止。標準に含まれたことも一度もありません。
- Cloudflare の Content Signals Policy:コンテンツの利用方法についての表明で、クロールのルールではありません。
500 KiBの上限と、それを超えた部分
Google は robots.txt の最初の500キビバイトを読み、それ以降はどこにもエラーを出さずにすべて無視します。RFC 9309 は500 KiBをクローラーの解析上限の下限として定めていますが、Google はそれを上限として明示しています。
Google:「Google では、robots.txt ファイルのサイズの上限を500キビバイト(KiB)に定めています。最大ファイルサイズを超えたコンテンツは無視されます」。警告は何もありません。600 KiBのファイルが無効になるわけではなく、最後の100 KiBが Googlebot にとって存在しないだけです。そこに書いた Disallow は何も守りません。
この上限に達するサイトは意外と多くあります。キャンペーンのパラメータごと、絞り込みの条件ごと、古いステージング用フォルダごとに1ルールずつ書いていくと届いてしまいます。上のチェックは、ファイルを上限と比較し、どれだけ超えているかを示します。長い一覧はパターン(Disallow: /*?filter=)に置き換え、重要なルールを先頭に置いてください。
Disallow: /cart/ · 12行目適用されるDisallow: /private/ · 9,412行目読まれないファイルは200を返し、解析もできます。残りが切り捨てられたことを知らせるものは、どこにもありません。
robots.txt によくある間違いと、その見つけ方
壊れた robots.txt のほとんどは、6つのパターンのどれかに当てはまります。そしてどれも、何かでテストするまで表に出ません。ファイルは200を返し、解析もでき、見た目も正しいままだからです。
誰もが知っているのは、ステージングから本番公開したときに残された Disallow: / です。残りの5つは、/administrator にも一致してしまう Disallow: /admin のように意図より広く一致するルール、名前を指定したグループがあるために黙って無視される * の下の Allow: /、完全なアドレスではなくパスで書かれた Sitemap: の行、先頭にスラッシュが無く何にも一致しないパス、そして Google が2019年に読まなくなった noindex の行です。
上でチェックを実行してから、「問題」の表示を読んでください。すべての指摘がファイルの該当行に付き、対処法も添えてあります。監査ではなくファイルを編集しているなら、robots.txt作成ツールが、このチェッカーで読み取り済みのファイルを書き出します。
出典
- RFC 9309、Robots Exclusion Protocol:グループ、優先順位、パーセントエンコードでの照合、ステータスコード、500 KiBの下限
- Google 検索セントラル:Google による robots.txt の解釈、robots.txt ファイルの作成と送信、noindex によるインデックス登録のブロック
- Search Console ヘルプ:robots.txt レポート、ページのインデックス登録レポート
- Bing:Crawl-delay と Bing のクローラー、Yandex:Clean-param
- Google のオープンソースの robots.txt パーサー。Googlebot 自身が使っている照合ライブラリです
- 各クローラーのトークン、目的、robots.txt への対応は、それぞれの運営元のドキュメントに基づいています。リンクは「クローラー」の表示の各項目の横にあります
Disallow: /ステージングの名残:公開中のサイト全体が、すべてのクローラーに閉じている。Disallow: /admin/administrator や /admin-tools もブロックする。末尾にスラッシュを付ける。User-agent: * の下の Allow: /ファイル内のどこかに専用のグループがあるクローラーには読まれない。Sitemap: /sitemap.xmlSitemap の行は、ホストを含む完全なアドレスでなければならない。Disallow: adminパスは / から始まる。このルールは何にも一致しない。noindex: /private/2019年以降は無効。ページはクロールもインデックス登録もされたまま。robots.txtテスター:よくある質問
Google の robots.txtテスターはどうなったのですか?
User-agent: * の下の Allow: / が無視されるのはなぜですか?
* のグループはまったく読まれません。これは代替であって、追加ではありません。グループがまとめられるのは、複数のグループが同じトークンを指定している場合だけです。上のURLテスターでは、クローラーごとにどのグループが選ばれ、ほかのグループがなぜ選ばれなかったのかを確認できます。robots.txt でページのインデックス登録を防げますか?
noindex の meta タグか X-Robots-Tag ヘッダーを返すか、ページをログインの内側に置いてください。noindex が効かないのはなぜですか?
noindex を含め、そのページの内容を何も見ることができません。そのため、ほかのサイトからのリンクによってページが検索結果に表示され続けることがあります。Google もはっきりと、noindex が機能するには、ページが「robots.txt ファイルでブロックされていてはならない」と述べています。Disallow の行を削除し、noindex はそのまま残してください。robots.txt の404は何を意味しますか?500の場合は?
Allow と Disallow の両方が一致したら、どちらが優先されますか?
robots.txt で使えるワイルドカードは?
* は任意の文字列を、$ はURLの末尾を表します。それ以外はすべて文字どおりで、?、.、[、]、+ はその文字自体に一致し、正規表現はありません。$ の無いルールは前方一致なので、Disallow: /admin は /administrator にも一致します。パスは大文字と小文字を区別しますが、Disallow などのディレクティブ名は区別しません。Google は Crawl-delay に対応していますか?
robots.txt ファイルのサイズに上限はありますか?
GPTBot や ClaudeBot などのAIクローラーをブロックするには?
Disallow: / を書きます。ほとんどのAI企業は役割の違う複数のクローラーを運用しています。学習用、質問に答えてあなたのサイトへのリンクを返す回答用、そして人の代わりに1ページだけ取得するものです。上の「クローラー」の表示には、各トークン、その目的、運営元が従うと述べている内容を載せているので、AIの引用元から外れることなく学習だけを拒否できます。robots.txtチェッカーとバリデーターは同じものですか?
robots.txt はセキュリティ上のリスクになりますか?
Disallow: /admin-backup/ は、隠したかったものそのものへの道しるべになります。中の記述がアクセスを防ぐことはなく、クローラーが従うのは運営元がそう決めたからにすぎません。非公開のパスは認証やファイアウォールのルールで保護してください。このチェッカーは、ファイル内で誘い文句のように読めるパスを指摘します。足りないものはありますか?機能や新しいツールを提案する
クロールとインデックス登録に関するほかのツール
サイトマップチェッカー
ウェブサイトのXMLサイトマップを見つけて検証:構文、URLの上限、lastmodの日付、robots.txtとの矛盾、リンク切れやリダイレクトするURL
サイトマップ生成
ウェブサイトをクロールし、XMLサイトマップ、HTMLサイトマップ、サイト構造図を取得
HTTPヘッダーチェッカー
HTTPレスポンスヘッダーとセキュリティヘッダーのグレーディング分析
リダイレクトチェッカー
SEO向けにURLリダイレクト、リダイレクトチェーン、HTTPステータスコードを確認
自分のUser Agent確認
User Agent文字列からブラウザ、OS、デバイスタイプ、レンダリングエンジン、CPU情報を検出
リンク解析
dofollow/nofollow検出とHTTPステータスチェック付きでページ内リンクを分析