











Base64 デコード・エンコード:PDF・画像・ファイルに変換
Base64を貼り付けてPDF・画像・テキスト・JWTに戻すか、ファイルをドロップしてBase64に変換。処理はすべてこのタブ内です。
3バイトは24ビットです。Base64はこの24ビットを6ビットずつ4つのグループに分け、各グループが64文字のうち1文字を表します。白い線はバイトの境目で、グループの区切りとは一致しません。これが仕組みのすべてです。
16 + 2 + 1 = 19 T
標準のアルファベットのインデックス19です。
Base64デコード・エンコードツールの使い方
1つの入力欄に何でも(テキスト、Base64、data: URI全体、JWT)貼り付けるか、ファイルを選択を押すか、カードにファイルをドロップします。ツールが変換の向きを判断して上の表示に示し、逆向きの読み方にもワンクリックで切り替えられます。
ファイルをデコードすると、バイトそのものから判定した形式、サイズ、画像ならピクセルサイズ、画像やPDFのプレビュー、正しい拡張子でのダウンロードが得られます。ファイルをエンコードすると、Base64、そのまま使えるdata: URI、エンコードで増えたサイズがわかります。結果の下のアルファベット、パディング、改行のオプションで、出力を変えられます。
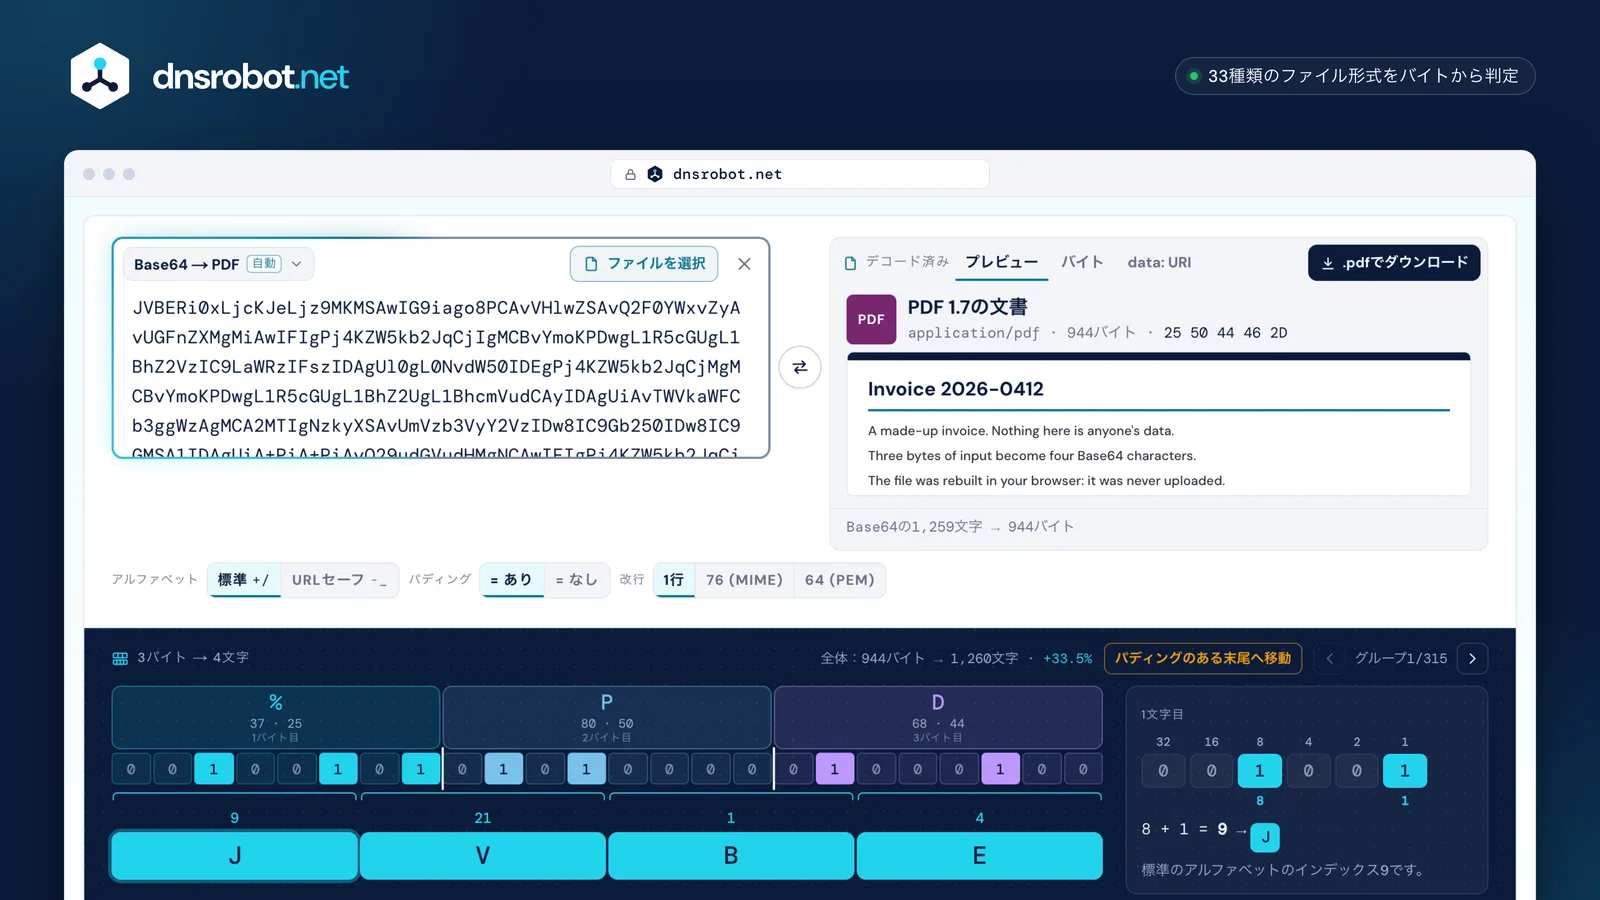
 1つの入力欄で双方向テキスト、Base64、data: URI、JWTを貼り付けます。どう読み取ったかは上の表示でわかり、メニューで変更できます。ファイルを選択選ぶ代わりに、カードのどこにドロップしてもかまいません。タブから出ることなく、Base64とdata: URIになります。バイトの正体デコードすると、結果の先頭にファイルの形式、サイズ、シグネチャが表示され、続いてプレビューとダウンロードがあります。出力オプション標準またはURLセーフのアルファベット、パディングの有無、MIMEまたはPEM用の改行を選べます。3バイト → 4文字自分のバイトを6ビットずつのグループに切り直して表示します。文字にポインターを合わせると、ビットの足し算がわかります。
Base64とは? なぜ必要なのか
Base64は、どこを通っても壊れない64種類の文字(A–Z、a–z、0–9、+、/)で、任意のバイトを書き表す方式です。メール、URL、JSON、XMLはテキストのために作られており、生のバイトは制御コードや引用符、NULになってそれらを壊すことがあるため、Base64が存在します。
3バイトずつ取り出し、その24ビットを1列に並べて、6ビットずつ4つのグループに切ります。6ビットで表せる値は64通りなので、各グループはちょうど1文字を表します。3バイトが入ると必ず4文字が出るため、Base64は元のデータより約3分の1大きくなります。
3バイトは24ビットです。Base64はこれを6ビットずつ4つのグループに切り直し、各グループが64種類の表示可能な文字のうち1文字を表すので、3バイトは必ず4文字になります。33%の増加はここから生じます。
2バイトは16ビットです。Base64は2ビットの0を補って3つ目のグループを完成させ、4文字目の位置には=が1つ入ります。
1バイトは8ビットです。Base64は4ビットの0を補って2つ目のグループを完成させ、3文字目と4文字目の位置には=が2つ入ります。=はビットをまったく持ちません。
Base64をPDFに変換(デコード)するには?
文字列を貼り付けると、ツールがPDFを復元します。バージョンとサイズを表示し、ブラウザー内蔵のPDFビューアーで文書を開き、ダウンロードもできます。PDFだと指定する必要も、先にdata:の接頭辞を取り除く必要もありません。
PDFは先頭の5バイト%PDF-で判別するため、ファイル名、送信者が示した形式、入っていたフィールドが別の形式を示していても、PDFだと判定できます。バイトがPDFでなければ、もともと存在しない文書を開こうとして失敗するのではなく、それが何であるかを表示します。
ファイルはブラウザー内で復元されます。何もアップロードされないので、給与明細、契約書、請求書のようなPDFでは、この点が重要です。
"document": "JVBERi0xLjcKJeLjz9MKMS…"レスポンスの中のフィールドです。引用符はBase64の一部ではありません。Content-Transfer-Encoding: base64MIMEは本文を1行76文字で折り返します。改行ごと貼り付けてください。改行は読み飛ばします。data:application/pdf;base64,JVBERi0x…全体をそのまま貼り付けてください。接頭辞は手で取り除かなくても、ツールが読み取ります。- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
先頭の5バイト%PDF-が、シグネチャのすべてです。6〜8バイト目がバージョンで、1.7です。拡張子は関係ないため、誰かが.txtという名前を付けたPDFでも、PDFとして戻ってきます。
画像をBase64にエンコードするには? 使うべき場面は
画像をドロップすると、そのBase64と、HTMLやCSSにそのまま貼り付けられるdata: URIが得られます。難しいのは、そうすべきかどうかです。Base64は常に約3分の1大きくなり、インライン画像は単独ではキャッシュできません。
逆にBase64を画像に変換すると、形式、サイズ、そして画面上の見た目ではなくファイル自体のヘッダーから読み取った実際のピクセルサイズがわかり、正しい拡張子でダウンロードできます。
- ディスク上のファイル12.9 KB 100%
- Base64にした場合17.3 KB +33.4%
- MIME用に76文字で改行17.5 KB +35.1%
- ファイルをgzip圧縮11.7 KB -9.5%
- Base64をgzip圧縮12.5 KB -3.2%
- ダウンロードは1回だけ
- ブラウザーとCDNがキャッシュ
- ページの中ではなく、ページと並んで取得
- 圧縮前で3分の1大きい
- 埋め込んだファイルの一部としてしかキャッシュされない
- スタイルシートやHTMLの一部として解析される
圧縮でその大半は取り戻せます:gzip圧縮すると、Base64はgzip圧縮したファイルより7%大きいだけです。取り戻せないのは、画像単独のキャッシュです。HTMLページにインライン化すると、その画像を含むページを開くたびに毎回ダウンロードされます。
目安:インライン化するのは数百バイト程度(アイコン、スペーサー、メール内のロゴ)にとどめ、それより大きいものはリンクにします。この12.9 KBのPNG画像は、すでにその線を越えています。
Base64とURLセーフなBase64の違いは?
URLセーフなBase64(RFC 4648 §5)は、2つの文字を入れ替えただけの同じエンコード方式です。+が-に、/が_になります。パディングも省略されることがよくあります。
結果をURL、ファイル名、Cookieに入れる場合は、どこでもこちらを使います。JSON Web Token(JWT)は全体でこの方式を使うため、トークンの各部分が=で終わることはありません。このツールは両方のアルファベットを読み取り、1つの文字列に両方が含まれているときは知らせます。
+/8=-_8=-_8+→-インデックス62。クエリ文字列では、フォームのデコーダーが+をスペースとして読むため、データが正しく戻りません。/→_インデックス63。パスでは/が新しいセグメントの始まりになるため、値が2つに分かれてしまいます。=を省略URLの中では、=は通常%3Dとパーセントエンコードされます(RFC 4648 §5)。JWTではまったく付けません(RFC 7515 §2)。長さだけで、バイトがどこで終わるかがわかるからです。
2つのアルファベットの最初の62文字は同じです。そのため、両方のアルファベットを読めるツールならどちらもデコードでき、このページは1つの文字列に両方が含まれているときにそれを知らせます。
Base64は暗号化? いいえ、違います
Base64は何も隠しません。鍵も秘密もなく、元に戻すのに手間はまったくかかりません。このようなデコーダーなら、入力と同時に戻せます。
これが最も問題になるのはHTTP Basic認証です。ヘッダーはユーザー名とパスワードを1つのBase64文字列として運び、目にした人は誰でも読めます。そのためRFC 7617は、TLSのような暗号化された接続上でのみ安全だとしています。読めない状態を保つ必要があるなら、暗号化が必要です。Base64は、テキスト用に作られた経路にバイトを安全に通すためのものにすぎません。
RFC 7617 §2の手順で作ったAuthorizationヘッダー
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordRFC 7617はヘッダーを手順を追って組み立てますが、その最後の手順が「保護」のすべてです。そこでクライアントは「このオクテット列をBase64でエンコードしてbasic-credentialsを得る」とされています。その意味は§1に書かれています。TLSなどの仕組みで接続が保護されていない限り、「ユーザーIDとパスワードは平文としてネットワーク上で渡される」のです。Base64には鍵がないので、破るものもありません。文字列を手にした人は、パスワードを手にしたのと同じです。
デコードしたテキストが文字化けするのはなぜ?
Base64が運ぶのはバイトで、バイトは何かが文字コードを選んで初めて文字になるからです。UTF-8のテキストをISO-8859-1として読むとéはéになり、ISO-8859-1をUTF-8として読むと置換文字になります。
data: URIは文字コード(charset)を宣言でき、このページはすべてをUTF-8で読むのではなく、その文字コードでテキストを読みます。宣言された文字コードのデコーダーがブラウザーにない場合は、間違った文字を黙って表示せず、そのことを知らせます。
UTF-8ではéは2バイト、ISO-8859-1では1バイトです。Base64が運ぶのは文字ではなくバイトなので、どちらのつもりだったかを、デコーダーが文字列そのものから知ることはできません。
Python・JavaScript・Java・C#・Go・PowerShell・シェルでBase64を扱う
どの言語にもBase64は組み込まれています。落とし穴はどこでも同じで、文字列ではなくバイトをエンコードすること、そしてテキストの文字コードを明示することです。
最も注意が必要なのはJavaScriptのbtoa()です。U+00FFまでの文字しか受け付けないため、Latin-1を超える文字は、先にTextEncoderでUTF-8のバイトにする必要があります。下の例はどれも「Man」をエンコードしてデコードするもので、実際に実行して出力を確認しています。
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
2026年10月26日にPython 3.14.4で実行し、コメントのとおりに出力されました。
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
2026年10月26日にNode.js 22.23.2で実行し、コメントのとおりに出力されました。
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
2026年10月26日にOpenJDK 25.0.2で実行し、コメントのとおりに出力されました。
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
2026年10月26日に.NET 10.0.103で実行し、コメントのとおりに出力されました。
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
2026年10月26日にGo 1.25.5で実行し、コメントのとおりに出力されました。
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
2026年10月26日にPowerShell 7.5.5で実行し、コメントのとおりに出力されました。
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
2026年10月26日にmacOS 26.6のbase64コマンド(bash)で実行し、コメントのとおりに出力されました。
base64 -dは、古いmacOSでは-Dです。 出典: gnu.org, developer.mozilla.orgBase64の変換表:0〜63のアルファベット
6ビットのグループはそれぞれ0〜63の数で、この表で文字を引きます。Base64は大文字と小文字を区別します。Aは0、aは26なので、文字の大文字・小文字を変えると文字列が壊れます。
見た目で覚えておくと便利です。Aの連続はゼロのバイトの連続で、JVBERで始まるBase64文字列はPDF、iVBORならPNG、/9j/ならJPEGです。
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +URLセーフでは-62
- /URLセーフでは_63
0–25がA–Z、26–51がa–z、52–61が0–9です。2つのアルファベットで異なるのは表の最後の2文字だけで、上に印を付けています。=は表にまったく含まれません。値ではなく、最後の3バイトのグループが足りなかったことを示す印です。
Base64:よくある質問
Base64デコードとは?
Base64のファイルをデコードするには?
Base64は何に使われますか?
data: URI、JSONやXMLのバイナリフィールド、JSON Web Token、HTTP Basic認証、PEMファイルの証明書や鍵などです。どれも生のバイトを変えたり落としたりしかねない経路を通るため、データはただの英数字として運ばれます。Base64は暗号化ですか?
Base64をオンラインでデコードしても安全ですか?
Base64が元のデータより33%大きくなるのはなぜ?
=のパディングが付き、メール用に76文字ごとに改行するとすべての行に改行が加わるので、長い文字列は運ぶバイトより35%ほど大きくなることがよくあります。gzipなどの圧縮で、その大半は取り戻せます。URLセーフなBase64とは?
+を-に、/を_に置き換えたBase64で、結果をエスケープせずにURL、ファイル名、Cookieに入れられます。JSON Web Tokenのように、パディングも省略するのが一般的です。このツールは、1つの文字列に混在していても両方のアルファベットを読み取り、どちらでも書き出せます。Base64のデコードが失敗するのはなぜ?
Base64を画像に変換できますか?
data:image/png;base64,のような接頭辞があってもなくても、文字列を貼り付ければ画像が表示され、形式、サイズ、ファイル自体のヘッダーから読み取った実際のピクセルサイズがわかります。あとは正しい拡張子でダウンロードするだけです。PNG、JPEG、GIF、WebP、BMP、ICO、AVIFはプレビューでき、SVGはスクリプトを含められるため、まずテキストとして表示します。Base64の末尾の=は何を意味しますか?
=1つに、1バイトなら2文字と==になります。パディング自体はデータをまったく持たず、バイトがどこで終わるかをデコーダーに伝えるだけです。このツールを含む多くのデコーダーは、パディングが省略されたBase64も読み取れます。サイズの上限はありますか?
ここでJWTをデコードできますか?
iatとexpのクレームの横には日時が、署名はバイトとして表示されます。このページは3つのbase64urlの部分をデコードするだけで、署名を検証せず、トークンを有効と判断することもありません。トークンを信頼するかどうかの判断には使わないでください。足りないものはありますか?機能や新しいツールを提案する
関連ツール
二進数変換(バイナリ翻訳)
文字を二進数に、二進数を文字に翻訳:自動判定、16進数・10進数・8進数にも対応
UUID生成
UUID v4、v7、v1、v5、v3やGUIDを任意の形式で一括生成し、UUIDのバージョンとタイムスタンプをデコード
CSR・SSL証明書デコード
CSRやSSL証明書をデコード:サブジェクト、SAN、鍵長、有効期間、発行者、フィンガープリント、署名検証、CSRと証明書の一致確認
空白文字コピー
空白文字をワンクリックでコピー&ペースト。テキストに隠れた不可視文字の検出・削除にも対応
UNIX時間(unixtime)変換
Unixタイムスタンプを日時に、日時をepoch時間に、任意のタイムゾーンで変換。一括変換にも対応