











サイトマップチェッカー
ドメインかサイトマップのURLを貼り付けるだけで、全体像がわかります。インデックス内のすべてのファイル、プロトコルが定めるすべてのルール、検索エンジンが拒否するURLとその理由、そして日付に意味があるかどうか。Search Console でサイトマップが「取得できませんでした」と表示されたときの原因調べにも使えます。
ドメインだけで大丈夫です。robots.txt を読み、一般的な場所を探します。example.com/sitemap.xml のようにファイルを指定することもできます。
- robots.txt最初に読み、その意味を判断
- サイトマップrobots.txt、次に一般的なパス
- 読み取ったファイルインデックスと、その中の10ファイル
- 検証全ルールと robots.txt との照合
XMLサイトマップをチェックする方法
上の欄にドメインを入力し、「サイトマップをチェック」を選びます。robots.txt を読み、そこに記載されたファイルを見つけ、そのファイルと、そこに含まれるファイルのうち最大10件を読み取り、URLをサンプル取得したうえで、検索エンジンがそれをどう受け取るかを表示します。
ドメインだけでも、ファイル自体のアドレスでも構いません。ドメインなら、まず robots.txt の Sitemap: の行を読み、次に一般的なパスを試します。アドレスなら、指定されたものをそのまま読み取ります。どちらの場合もファイル全体を読み取り、最初の100 URLで止まることはありません。サイトマップインデックスなら、その中のファイルも最大10件まで読み取ります。
サイトマップが役目を果たしているかは、4つの点で決まります。ファイルを解析できること、プロトコルの上限に収まっていること、robots.txt やページ自身の noindex と矛盾しないこと、そして日付に意味があることです。上の表示では、形式と上限は ファイル と 問題、矛盾は robots.txt と サンプルページ、日付は URL で確認できます。
200sitemap_index.xml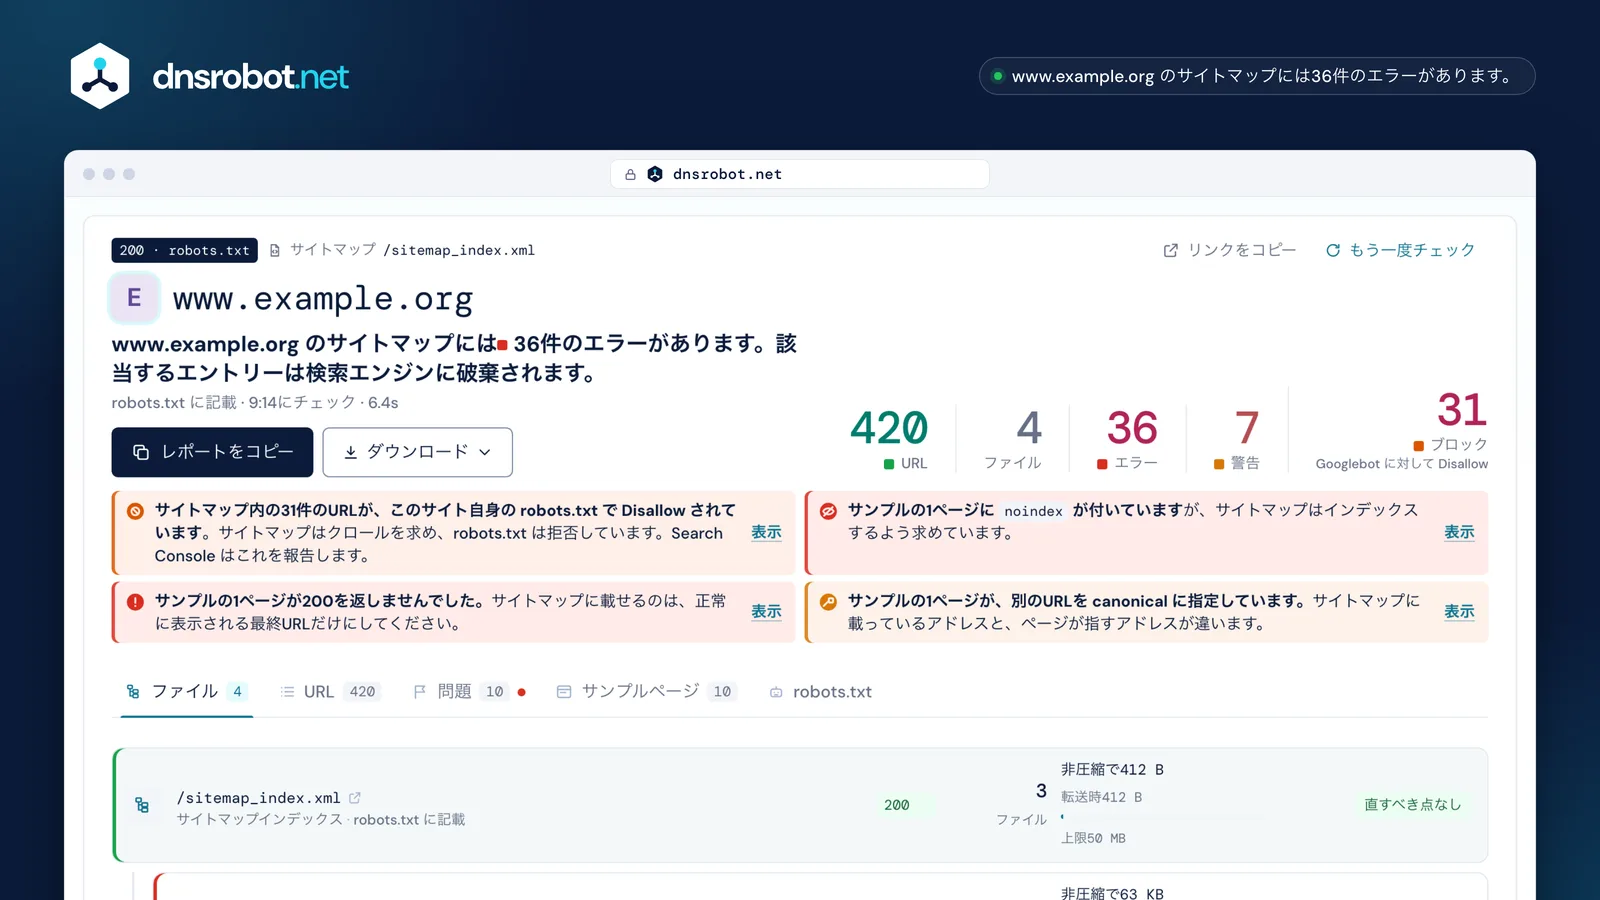
 判定このサイトマップの何が問題かを1文で示し、それを支える5つの数字を添えます。URL、ファイル、エラー、警告、そして robots.txt が拒否するURLです。robots.txt とその意味ステータスコードだけでなく、それがサイト全体にとって何を意味するかを示します。4xx ならすべてクロールでき、5xx なら何もクロールしてはいけません。インデックスの全ファイル各ファイルについて、含まれるURL、50 MBの上限に対する解凍後のサイズ、その横に転送サイズ、そしてそのファイル自身の指摘を示します。矛盾サイトマップがクロールを求めているのに robots.txt が拒否しているURLと、noindex が付いていたり、別のURLを canonical に指定していたりするサンプルのページです。
サイトマップが無効になる原因
サイトマップが無効になるのは、パーサーが読み取れないときです。エスケープされていない &、間違ったルート要素、名前空間の欠落、相対URL、XML宣言の前に出力された空白などです。それ以外は警告であって、拒否されるわけではありません。
最も多いのは、エスケープされていないアンパサンドです。XMLは & を文字参照の始まりとして読むので、エスケープされていないものが1つあるだけで、パーサーにとってファイルはそこで終わり、それ以降は読まれません。& と書き、<、>、"、' も同じようにエスケープしてください(sitemaps.org)。<loc> は、プロトコルから始まる完全なURLで、2,048文字未満でなければなりません。
名前空間は正確に http://www.sitemaps.org/schemas/sitemap/0.9 で、https のサイトでも http:// のままです。これはパーサーのための名前であって、誰かが取得するアドレスではありません。ファイルは UTF-8 で、<?xml の前には空行1つも置いてはいけません。そこに置けるのは、UTF-8 のバイトオーダーマークだけです。
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1宣言の前に空行がある
- 2名前空間はこの文字列そのまま、http:// で
- 3エスケープされていない & で、パーサーにとってファイルが終わる
- 4パスはURLではない:プロトコルから始める
- 5時刻にはタイムゾーンが必要、または時刻ごと省く
Search Console のサイトマップエラー:「取得できませんでした」などの意味
Google Search Console はサイトマップに、成功、エラーがあります、取得できませんでしたの3つのステータスのいずれかを表示します。表示されるのは所有権を確認したプロパティだけで、どの行が間違っているかは教えてくれません。このページは、公開されているどのサイトマップもチェックし、該当する行を示します。
取得できませんでしたは、Google のリクエストに対して読み取れるファイルが返ってこなかったことを意味します。4xx や 5xx、リダイレクトの連鎖、タイムアウト、Google を拒否するファイアウォール、サイトマップ自身のパスを Disallow する robots.txt のルールなどです。エラーがありますは、ファイルは読み取れたものの、その中の何かがルールに違反していることを意味します。横の図に、よく見るメッセージとその原因になる行をまとめています。
そのうち2つは、形式ではなくサイズの問題です。50,000件を超えるURLを載せたサイトマップ(「URL の制限数超過」)と、50,000件を超えるサイトマップを載せたサイトマップインデックス(「サイトマップの制限数超過」)です(Google)。大きすぎるサイトマップは、インデックスに載せた複数のファイルに分けてください。大きすぎるインデックスは複数のインデックスに分け、それぞれを個別に送信します。robots.txt でブロックされているURLを載せたサイトマップも報告されますが、これは形式の誤りではなく、自分のファイル同士の矛盾です。
3つのステータス
よく見るメッセージ
- 取得できませんでした4xx や 5xx、リダイレクトの連鎖、ファイアウォール、またはサイトマップ自身のパスを Disallow する robots.txt。
- URL の制限数超過1つのサイトマップに50,000件を超えるURL。警告ではなくエラーです。インデックスの下に分割してください。
- 解析エラーURLの中のエスケープされていない & が原因のことが多くあります。& と書いてください。
- 無効な日付W3C Datetime 形式ではない lastmod、またはタイムゾーンの無い時刻。
- 無効な URL ですスペース、引用符など、URLに含められない文字、または htp:// のような壊れたスキーム。
- robots.txt によってブロックされている URL がサイトマップに含まれています2つのファイルが矛盾しています。どちらが正しいかを決めてください。
所有権を確認したプロパティのみSearch Console がサイトマップを報告するのは、自分が所有するプロパティだけです。このページは公開されているどのサイトマップもチェックし、該当行も示します。
lastmod の日付は正確でなければいけませんか?
はい。Google が <lastmod> を使うのは「一貫して、検証できるほど正確な」場合です。そのため、すべてのURLで同じ日付や、ファイルを書き出すたびに変わる日付は、日付が無いよりも悪く、Google にこのタグを無視することを覚えさせます。
ほかのサイトマップチェッカーが読むのは、日付の形式だけです。W3C Datetime になっているか、時刻にタイムゾーンが付いているか。形式は簡単なほうの半分にすぎません。タグが役に立つかどうかを決めるのは、その値が示すとおりの意味を持っているかどうかで、見分けるポイントは、すべてのエントリーで繰り返される同じタイムスタンプと、いつも今日になっている日付の2つです。Bing も lastmod を使ってクロールの予定を決めており、いつも今日の日付になっているものは無視することがあります。
そのためこのチェッカーは、日付の書き方だけでなく、日付が実際にどうなっているかを報告します。日付を持つエントリーの数、最も古い日付と最も新しい日付、そして同じ値の繰り返しかどうかです。<lastmod> を省くのは有効で、失うものはありません。でっち上げれば、サイト全体でこのタグの信用を失います。示すべきは最後の重要な変更、つまり本文、構造化データ、リンクの変更であり、著作権表示の年の更新ではありません(Google)。
lastmod がまったく無い有効。予定を立てる手がかりは無く、疑われる日付も無い。
50,000 URLと50 MB:分割するタイミング
1つのサイトマップに入れられるのは、最大50,000 URL、非圧縮で50 MBまでです。どちらか先に達した上限を超えたら、URLを複数のファイルに分け、それらをサイトマップインデックスにまとめて、インデックスを送信します。
サイズの上限は、.xml.gz として配信していても、解凍後のファイルを対象にします。だからこのチェッカーは、非圧縮のサイズと転送サイズを並べて表示します。gzip で配信される30 KBのサイトマップは、転送時には1.6 KBになることもあり、その数字は上限について何も教えてくれません。Naver Search Advisor は10 MBを超えるファイルを受け付けないので、韓国向けのサイトにはプロトコルより低い上限があります。
インデックスに載せられるサイトマップは最大50,000件で、同じサイト上のファイルに限られ、別のインデックスは決して載せられません。入れ子になったインデックスは読まれません。xhtml:link で書いた言語の代替URLは、50,000件には数えません。このチェッカーは1回でインデックスとその中のファイルを最大10件まで読み取り、それぞれの件数、サイズ、指摘を示します。
6.2 MB転送時812 KBgzip で送るとファイルは小さくなりますが、上限は解凍後のサイズで数えます。sitemap_index.xmlインデックスに別のインデックスは載せられないrobots.txt とサイトマップ:ページを失う原因になる矛盾
サイトマップは検索エンジンにURLの一覧をクロールするよう求め、robots.txt はクロールしてはいけないものを伝えます。2つが食い違うと robots.txt が優先され、サイトマップのエントリーは無駄になります。そして Search Console がそれを報告します。
最初に読むべきは robots.txt 自体のステータスですが、それが何を意味するかを報告するツールはほとんどありません。4xx は「利用できない」で、ルールが無いため、すべてクロールできます。5xx や応答がまったく無い場合は「到達できない」で、RFC 9309 に従うクローラーはサイト上で何もクロールしてはいけません。Google は429も同じように扱います。同じ壊れたファイルが正反対の結果を生むので、読み取れない robots.txt の上に「ブロックされているURLはありません」と表示するツールは、ファイルが 5xx か 429 を返したとき、または応答しなかったときには、間違っています。
次に、正常なファイルの中の矛盾です。サイトマップに載っているのに robots.txt で Disallow されているURL、そして見落としやすいのが、サイトマップ自身のパスが Disallow されているケースで、これはどのクローラーも読めないファイルを公開していることになります。逆方向の対策は手軽で、やる価値があります。robots.txt の Sitemap: の行は、どこのアカウントも要らず、どのクローラーも読みます。
ステータスと、その結果
矛盾
/search/?q=pepperDisallow: /search/エントリーは何の役にも立たず、Search Console がそれを報告する
さらに、サイトマップ自身のパスが Disallow されている場合:どのクローラーも読めないファイルを公開していることになる。
サイトマップに載せるべきでないURL
載せるのは、検索結果に出したい正規URLだけで、1ページにつき1つです。200を返し、インデックス可能で、robots.txt でブロックされていない最終的なアドレスです。リダイレクト、noindex のページ、別のURLを canonical に指定するURL、エラー、パラメータ違いのバリエーションは、どれもサイトマップには載せません。
リダイレクトするURLをサイトマップに載せると、クローラーは必要以上に1回余分に移動することになり、Google は代わりにリダイレクト先のURLを載せるよう求めています。サイトマップに noindex のページがあるのは明らかな矛盾です。ファイルは「インデックスして」と言い、ページは「しないで」と言っています。ページの指示が優先され、そのエントリーは何の役にも立ちません。
どれも致命的ではありません。サイトマップのURLはすべて提案にすぎず、何をインデックスするかは Google が決めます。それでも、間違ったエントリーは1つ1つ、検索エンジンが割り引いて見ることを覚えるものです。だからこのチェッカーは、ファイルを解析するだけでなく、URLのサンプルを取得します。解析だけでは、載っているページが今は404を返していることまではわかりません。
/shop/raised-beds/有効記載どおりにインデックス/shop/raised-bed/リダイレクト無駄になる/shop/?sort=pricecanonical が別URL無駄になる/tags/autumn/noindex無駄になる/shop/old-kit/404無駄になる/search/?q=pepperブロック無駄になる画像・動画・hreflang のエントリー
<url> エントリーにはアドレス以外の情報も入れられます。ページの画像、ほかの言語版、動画やニュースのメタデータで、それぞれがエントリーの中で独自の名前空間を使います。
画像は Google の画像用の名前空間を使い、1ページにつき最大1,000件までです。今も意味があるのは <image:image> と <image:loc> だけで、caption、title、license、geo_location は2022年に廃止されました。このチェッカーは、見つかった画像のエントリーを数え、URLごとに表示します。
言語版は、hreflang のコードを付けた xhtml:link で書きます。コードは ISO 639-1 の言語に、任意で ISO 3166-1 の地域を添えたもので、地域だけを書くことはできません。各言語版は、自分自身を含むすべての版を載せなければならず、そうでなければGoogle はそのセットを無視します。代替URLは50,000 URLの上限に数えないので、各エントリーに12の言語版を載せても、件数が12倍になることはありません。
https://www.example.org/guides/raised-beds/2026-09-1431ページにつき最大1,000件en · de · frすべての版が、自分を含むすべての版を載せる代替URLは50,000件には数えない
検索エンジンはどのくらいの頻度でサイトマップを読むのか?
Google は、公表していない独自のスケジュールでサイトマップを読みます。送信はあくまで合図で、命令ではありません。Bing は見つけ次第読み取り、その後は通常1日に1回以上読み取ります。どちらも、頼んだからといって頻繁に読み直すことはありません。
以前の匿名の ping はもうありません。Bing は2022年5月13日に bing.com/ping を停止し、Google は2023年6月に自社の ping を終了すると告知しました。現在は404を返します。今も「Google に ping を送る」とうたうツールは、何もしていません。
変更したページの次のクロールを早めるのは、正確な lastmod です。だからこそ、このタグの正直さが重要なのです。そして、変更した個々のURLには IndexNow が使えます。1回の送信で Bing、Yandex、Naver、Seznam などに届きますが、Google には届きません。変わっていないサイトマップを手動で再送信しても、何も変わりません。
正確な lastmod は、変更したページの次のクロールを早める
そもそもサイトマップは必要ですか?
すべてのページが互いにリンクしている小さなサイトなら、無くても困らないかもしれません。Google はその目安を500ページ程度以下としています。効果が大きいのは、大規模なサイト、外部からのリンクが少ない新しいサイト、画像や動画が多いサイトです。
Google 自身のスタートガイドもサイトマップは任意としており、送信はあくまで合図で、指示ではありません。ページの掲載順位を上げるものでも、インデックス登録を保証するものでもありません。役割は、URLの存在をクローラーに確実に知らせることで、自分のサイトのリンクが届かないページで最も役立ちます。
サイトマップを用意するなら、正しくしておく価値があります。リダイレクト、noindex のページ、robots.txt でブロックされたURLだらけのサイトマップは中立ではなく、検索エンジンが信用しなくなる一覧です。チェックは1分で済みます。自分のサイトから新しく作り直すにはクロールが必要です。
出典
- sitemaps.org のプロトコルとFAQ:形式、必須と任意のタグ、50,000件 / 50 MB の上限、インデックス、設置場所のルール
- Google 検索セントラル:サイトマップの作成、大規模なサイトマップ、サイトマップ レポートとそのエラー、各言語版のページ、lastmod と廃止された ping
- Bing:lastmod タグ(2023年)、AI時代の検索とサイトマップ(2025年)、廃止された ping(2022年)
- RFC 9309、robots.txt の標準:4xx と 5xx がクローラーにとって何を意味するか
- Naver Search Advisor:フィードとIndexNow
- 大規模なサイト
- 新しいサイト、外部からのリンクが少ない
- 画像や動画が多い
- 内部リンクが届かないページ
サイトマップチェッカーのよくある質問
XMLサイトマップが有効かどうかを確認するには?
サイトマップでよくあるエラーは何ですか?
Search Console でサイトマップが「取得できませんでした」になるのはなぜですか?
サイトマップのURLが robots.txt で Disallow されていると問題ですか?
lastmod は正確でなければいけませんか?
1つのサイトマップにURLはいくつまで入れられますか?
Google は priority と changefreq を使いますか?
このサイトマップチェッカーは無料ですか?URLの上限はありますか?
Google Search Console とは何が違いますか?
サイトマップインデックスとは?別のインデックスを載せられますか?
サイトマップは robots.txt に記載しなければいけませんか?
サイトマップがあれば、ページはインデックスされますか?
足りないものはありますか?機能や新しいツールを提案する
クロールとSEOのほかのツール
Robots.txtチェッカー
サイトのrobots.txtを取得し、URLがGooglebotやAIクローラーにブロックされていないかをテストして、構文エラーを検出
サイトマップ生成
ウェブサイトをクロールし、XMLサイトマップ、HTMLサイトマップ、サイト構造図を取得
リンク解析
dofollow/nofollow検出とHTTPステータスチェック付きでページ内リンクを分析
リダイレクトチェッカー
SEO向けにURLリダイレクト、リダイレクトチェーン、HTTPステータスコードを確認
HTTPヘッダーチェッカー
HTTPレスポンスヘッダーとセキュリティヘッダーのグレーディング分析
サイトダウンチェッカー
落ちてるのは全員か自分だけか?11か所とお使いの回線からサイトを確認し、実際の画面のスクリーンショットも表示
CMS判定ツール
サイトが使うCMS・テーマ・プラグイン・技術を、それぞれの根拠付きで判定