











Проверка Sitemap
Чтобы проверить карту сайта онлайн, вставьте домен или URL sitemap и получите полную картину: каждый файл индекса, каждое правило протокола, URL, которые отвергнут поисковые системы, с объяснением причин — и то, значат ли что-нибудь даты в файле.
Достаточно домена: мы прочитаем robots.txt и заглянем в обычные места. Подойдёт и сам файл, например example.com/sitemap.xml.
- robots.txtЧитаем первым и объясняем, что он значит
- Sitemaprobots.txt, затем обычные пути
- Прочитанные файлыИндекс и десять его файлов
- ПровереноКаждое правило и сверка с robots.txt
Как проверить карту сайта онлайн
Введите домен выше и нажмите «Проверить sitemap»: мы прочитаем robots.txt, найдём указанный в нём XML-sitemap, прочитаем его и до десяти его файлов, загрузим выборку его URL, а затем покажем, что поисковая система сделала бы со всем этим.
Можно указать просто домен или адрес самого файла. По домену мы сначала берём строки Sitemap: из robots.txt, а затем пробуем обычные пути; по адресу читаем ровно то, что вы указали. В любом случае файл читается целиком, а не первые сто URL, а вместе с ним — до десяти файлов индекса sitemap.
Работает ли sitemap, решают четыре вещи: файл разбирается, укладывается в пределы протокола, ничто в нём не противоречит robots.txt и noindex самих страниц, а его даты что-то значат. Всё это покрывают разделы выше: Файлы и Проблемы — формат и пределы, robots.txt и Выборка страниц — противоречия, а URL — даты.
200sitemap_index.xml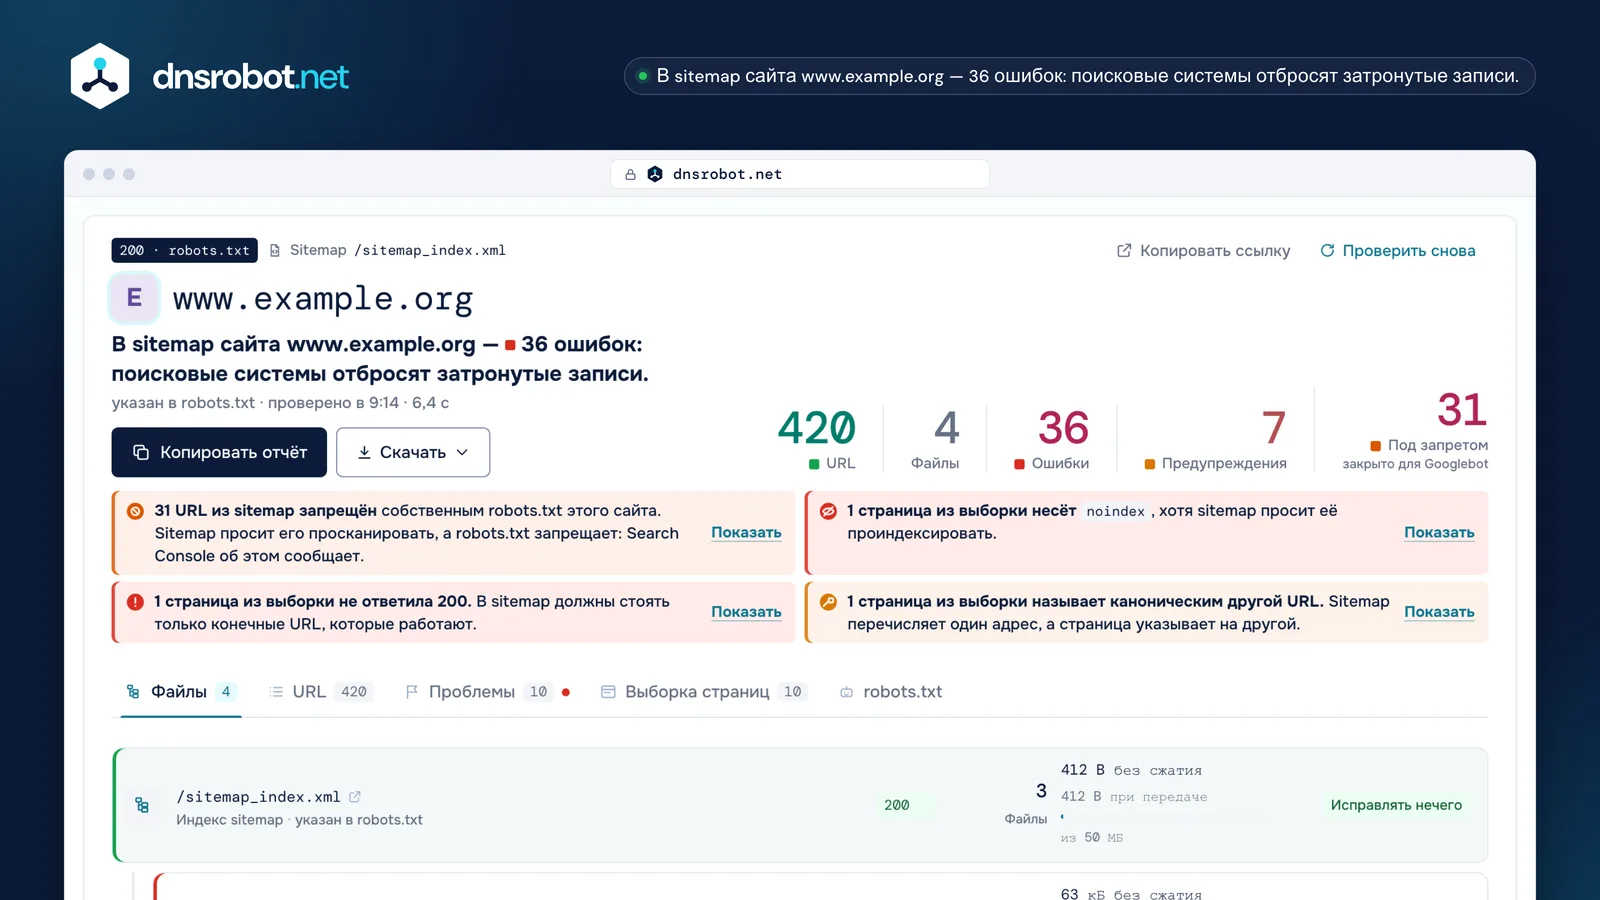
 ВердиктЧто не так с этим sitemap — одним предложением и пятью числами, на которых оно держится: URL, файлы, ошибки, предупреждения и URL, которые запрещает robots.txt.robots.txt и его последствияНе только код ответа, но и то, что он значит для всего сайта. При 4xx сканировать можно всё; при 5xx — ничего.Каждый файл индексаКаждый файл с его URL, размером после распаковки против предела в 50 МБ, размером при передаче рядом и собственными находками.ПротиворечияURL, которые sitemap просит просканировать, а robots.txt запрещает, и страницы из выборки, которые несут noindex или называют каноническим другой URL.
Из-за чего sitemap становится невалидным
Sitemap невалиден, когда парсер не может его прочитать: голый &, неверный корневой элемент, отсутствующее пространство имён, относительный URL или пробелы перед объявлением XML. Всё остальное — предупреждение, а не отказ.
Самое частое — неэкранированный амперсанд. XML читает & как начало ссылки на символ, поэтому один-единственный голый амперсанд обрывает файл для парсера, и всё, что после него, остаётся непрочитанным. Пишите его как & и так же экранируйте <, >, " и ' (sitemaps.org). <loc> должен быть полным URL, который начинается с протокола и короче 2048 символов.
Пространство имён должно быть ровно http://www.sitemaps.org/schemas/sitemap/0.9, на http:// даже для сайта на https: это имя для парсеров, а не адрес, который кто-то загружает. Файл должен быть в UTF-8, и перед <?xml не может стоять ничего, даже пустой строки; единственное, что там допустимо, — метка порядка байтов UTF-8.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Пустая строка перед объявлением
- 2Пространство имён — ровно эта строка, на http://
- 3Голый & обрывает файл для парсера
- 4Путь — не URL: адрес должен начинаться с протокола
- 5Время указывайте с часовым поясом или не указывайте вовсе
Ошибки sitemap в Search Console и что означает каждая
Google Search Console присваивает sitemap один из трёх статусов — Успешно, Обнаружены проблемы или Не получено — и только для подтверждённых ресурсов, причём не говорит, в какой строке ошибка. Эта страница проверяет любой публичный sitemap и называет строку.
Не получено значит, что запрос Google не вернул читаемый файл: 4xx или 5xx, цепочка редиректов, тайм-аут, файрвол, который не пускает Google, или правило robots.txt, запрещающее путь самого sitemap. Обнаружены проблемы значит, что файл прочитан, но что-то в нём нарушает правило, — на схеме рядом перечислены сообщения, которые вы, скорее всего, увидите, и строка, которая стоит за каждым.
Два из них касаются размера, а не формата: sitemap, в котором больше 50 000 URL, и индекс sitemap, в котором больше 50 000 файлов sitemap (Google). Слишком большой sitemap разбейте на файлы, перечисленные в индексе; слишком большой индекс превращается в несколько индексов, каждый из которых отправляется отдельно. Search Console сообщает и о sitemap, который перечисляет URL, закрытые в robots.txt, — а это уже противоречие в ваших собственных файлах, а не ошибка формата.
Три статуса
Сообщения, которые вы, скорее всего, увидите
- Не получено4xx или 5xx, цепочка редиректов, файрвол или robots.txt, запрещающий путь самого sitemap.
- Слишком много URLБольше 50 000 URL в одном sitemap: это ошибка, а не предупреждение. Разбейте файл под индексом.
- Ошибка синтаксического анализаЧасто это голый & внутри URL. Пишите его как &.
- Неправильно введена датаlastmod не в формате W3C Datetime или время без часового пояса.
- Недопустимый URLПробел, кавычка или другой символ, которого не может быть в URL, либо испорченная схема вроде htp://.
- Файл Sitemap содержит URL, доступ к которым заблокирован в файле robots.txtДва файла противоречат друг другу. Решите, какой из них прав.
Только подтверждённые ресурсыSearch Console сообщает о sitemap только для ресурса, которым вы владеете. Эта страница проверяет любой публичный sitemap и называет строку.
Должен ли lastmod быть честным?
Да. Google использует <lastmod>, «если он последовательно и достоверно точен», поэтому дата, одинаковая на всех URL или меняющаяся при каждой записи файла, хуже, чем отсутствие даты: она приучает Google игнорировать тег.
Все остальные инструменты проверки sitemap смотрят на формат даты: W3C Datetime ли это и есть ли у времени часовой пояс. Формат — лёгкая половина. Делает ли тег хоть что-то, решает другое: значит ли значение то, что заявляет, а выдают его две приметы — одна метка, повторённая во всех записях, и дата, которая всегда сегодняшняя. Bing тоже планирует обходы по lastmod и может не учитывать даты, которые всегда текущие.
Поэтому эта проверка сообщает, каковы даты на самом деле, а не только как они записаны: сколько записей несут дату, самая ранняя и самая поздняя и не одно ли это значение, повторённое везде. Не указать <lastmod> — допустимо и ничего не стоит; выдуманная дата стоит тегу доверия на всём сайте. Отмечайте последнее значимое изменение — основного содержимого, структурированных данных, ссылок, — а не новый год в копирайте (Google).
lastmod нет вовсеДопустимо. Планировать не по чему, но и не верить нечему.
50 000 URL и 50 МБ: когда разбивать файл
В одном sitemap может быть не больше 50 000 URL и 50 МБ в несжатом виде. За тем пределом, который вы перешагнёте первым, разложите URL по нескольким файлам, перечислите эти файлы в индексе sitemap и отправьте индекс.
Предел размера считается по распакованному файлу, даже если вы отдаёте его как .xml.gz, поэтому эта проверка показывает несжатый размер и рядом — размер при передаче: sitemap в 30 КБ, отданный в gzip, при передаче может весить 1,6 КБ, и это число ничего не говорит о пределе. Naver Search Advisor не принимает файлы больше 10 МБ, так что у корейского сайта потолок ниже, чем у протокола.
Индекс может перечислять до 50 000 файлов sitemap, только файлы со своего же сайта и никогда другой индекс: вложенный индекс не читается. Языковые версии, записанные через xhtml:link, в счёт 50 000 не идут. Эта проверка за один запуск читает индекс и до десяти его файлов и для каждого показывает число URL, размер и находки.
6,2 МБПри передаче812 кБgzip уменьшает файл при отправке; предел всё равно считается по размеру после распаковки.sitemap_index.xmlИндекс не может называть другой индексrobots.txt и ваш sitemap: противоречия, которые стоят вам страниц
Ваш sitemap просит поисковые системы просканировать список URL; robots.txt говорит им, что сканировать нельзя. Когда они расходятся, побеждает robots.txt, и запись в sitemap пропадает впустую — а Search Console об этом сообщает.
Первое, на что стоит смотреть, — код ответа самого robots.txt, и почти никто не сообщает, что он значит. 4xx — это «недоступен»: правил нет, поэтому сканировать можно всё. 5xx или полное отсутствие ответа — это «недостижим», и робот, который следует RFC 9309, тогда не должен сканировать на сайте ничего; 429 Google понимает так же. Один и тот же сломанный файл даёт противоположные результаты, и инструмент, который пишет «ни один URL не закрыт» поверх нечитаемого robots.txt, ошибается всякий раз, когда файл ответил 5xx или 429 либо не ответил вовсе.
Затем идут противоречия внутри работающего файла: URL из sitemap, которые запрещает robots.txt, и — это легко упустить — запрещённый путь самого sitemap, из-за которого опубликован файл, который ни один робот не вправе прочитать. Обратное направление дёшево и того стоит: строке Sitemap: в robots.txt не нужен никакой аккаунт, и её читает любой робот.
Код ответа и его последствия
Противоречие
/search/?q=pepperDisallow: /search/Запись ничего не даёт, а Search Console об этом сообщает
А ещё запрещённый путь самого sitemap: файл опубликован, но ни один робот не вправе его прочитать.
Каким URL не место в sitemap
Место там только каноническим URL, которые вы хотите видеть в выдаче, по одному на страницу: конечным адресам, которые отвечают 200, индексируются и не запрещены в robots.txt. Редиректам, страницам с noindex, URL с canonical на другой адрес, ошибкам и вариантам с параметрами место где угодно, только не здесь.
Sitemap, где указан URL с редиректом, отправляет робота на один переход дальше, чем нужно, а Google просит указывать вместо него URL, на котором редирект заканчивается. Страница с noindex в sitemap — прямое противоречие: файл говорит «индексируй это», а страница — «не надо». Побеждает страница, и запись ничего не даёт.
Ничто из этого не смертельно — каждый URL в sitemap лишь предложение, и что индексировать, Google всё равно решает сам, — но каждую неверную запись поисковая система учится не принимать в расчёт. Поэтому эта проверка загружает выборку URL, а не только разбирает файл: разбор не скажет вам, что указанная страница теперь отвечает 404.
/shop/raised-beds/В порядкеИндексируется, как указано/shop/raised-bed/Редиректвпустую/shop/?sort=priceCanonical на другой адресвпустую/tags/autumn/noindexвпустую/shop/old-kit/404впустую/search/?q=pepperПод запретомвпустуюЗаписи об изображениях, видео и hreflang
Запись <url> может нести не только адрес: изображения страницы, её версии на других языках и метаданные видео или новостей — каждое в своём пространстве имён внутри этой записи.
Изображения используют пространство имён Google для картинок, до 1000 на страницу; в счёт по-прежнему идут только <image:image> и <image:loc>, а caption, title, license и geo_location отменены в 2022 году. Эта проверка считает найденные записи об изображениях и показывает их для каждого URL.
Языковые версии используют xhtml:link с кодом hreflang: язык по ISO 639-1 с необязательным регионом по ISO 3166-1, но никогда один только регион. Каждая версия страницы должна перечислять все остальные версии, включая саму себя, иначе Google игнорирует весь набор. Языковые версии не идут в счёт предела в 50 000 URL, так что двенадцать языковых версий в каждой записи не умножают счёт на двенадцать.
https://www.example.org/guides/raised-beds/2026-09-143до 1000 на страницуen · de · frкаждая версия перечисляет все версии, включая саму себяЯзыковые версии не идут в счёт 50 000
Как часто поисковые системы читают ваш sitemap?
Google читает sitemap по собственному расписанию, которое не публикует: отправка — это подсказка, а не приказ. Bing читает файл, как только находит его, а затем обычно не реже раза в сутки. Ни одна из них не перечитывает файл чаще оттого, что вы попросили.
Старых анонимных пингов больше нет: Bing отключил bing.com/ping 13 мая 2022 года, а Google объявил в июне 2023 года, что его пинг перестанет работать; теперь он отвечает 404. Инструмент, который до сих пор предлагает «пингануть Google», не делает ровным счётом ничего.
Следующее сканирование изменённой страницы действительно приближает точный lastmod — именно поэтому так важна честность этого тега, — а для отдельных изменённых URL ещё и IndexNow: одна отправка доходит до Bing, Yandex, Naver, Seznam и других, но не до Google. Повторная ручная отправка неизменившегося sitemap ничего не даёт.
Точный lastmod приближает следующее сканирование изменённой страницы
А нужен ли вам sitemap вообще?
Небольшому сайту, все страницы которого ссылаются друг на друга, он может и не понадобиться: Google оценивает такой размер примерно в 500 страниц или меньше. Больше всего выигрывают крупные сайты, новые сайты, на которые мало ссылаются со стороны, и сайты с множеством изображений или видео.
Собственное руководство для начинающих от Google называет sitemap необязательным, и его отправка — лишь подсказка, а не указание: она не поднимает страницу в выдаче и не гарантирует индексирования. Зато робот точно узнаёт, что URL существует, — а это важнее всего для страниц, до которых не доходят ваши собственные ссылки.
Если sitemap у вас есть, пусть он будет правильным. Sitemap, полный редиректов, страниц с noindex и URL, закрытых в robots.txt, не нейтрален — это список, которому поисковая система учится доверять меньше. Проверка занимает минуту; собрать новый sitemap по вашему сайту — один обход.
Источники
- Протокол sitemaps.org и его FAQ: формат, обязательные и необязательные теги, пределы 50 000 / 50 МБ, индекс и правило расположения файла
- Google Search Central: как собрать sitemap, большие карты сайта, отчёт о файлах Sitemap и его ошибки, версии на других языках и lastmod и отключённый пинг
- Bing: тег lastmod (2023), карты сайта в поиске с ИИ (2025) и убранный пинг (2022)
- RFC 9309 — стандарт robots.txt: что значат 4xx и 5xx для робота
- Naver Search Advisor: фиды и IndexNow
- крупные сайты
- новые сайты, на которые мало ссылаются
- много изображений или видео
- страницы, до которых не доходит ни одна внутренняя ссылка
Проверка sitemap: частые вопросы
Как проверить, что мой XML-sitemap валиден?
Какие ошибки в sitemap встречаются чаще всего?
Почему Search Console пишет «Не получено»?
Плохо ли, если URL из моего sitemap запрещён в robots.txt?
Должен ли lastmod быть точным?
Сколько URL может быть в одном sitemap?
Использует ли Google priority и changefreq?
Эта проверка sitemap бесплатна? Есть ли предел по числу URL?
Чем это отличается от Google Search Console?
Что такое индекс sitemap и может ли он называть другой индекс?
Обязательно ли указывать sitemap в robots.txt?
Обеспечит ли sitemap индексирование моих страниц?
Чего-то не хватает?Предложите функцию или новый инструмент
Ещё инструменты для сканирования и SEO
Проверка robots.txt
Загрузка robots.txt любого сайта, проверка, закрыт ли URL для Googlebot или AI-краулеров, и поиск синтаксических ошибок
Генератор карты сайта
Сканирование сайта и создание XML карты сайта, HTML карты сайта и наглядного дерева сайта
Анализ ссылок
Анализ всех ссылок на странице с определением dofollow/nofollow и проверкой HTTP статуса
Проверка редиректов
Проверка редиректов URL, цепочек перенаправлений и кодов HTTP статуса для SEO
Проверка HTTP-заголовков
Анализ HTTP заголовков ответа и оценка заголовков безопасности
Проверка доступности сайта
Сайт не работает у всех или только у вас? Проверьте доступность сайта из 11 точек и с вашего подключения, со скриншотом в реальном времени
Определить CMS сайта
Какая CMS, тема, плагины и технологии у сайта, с доказательством для каждого