











Base64 декодер и кодировщик: в PDF, картинку или файл
Вставьте Base64 и получите файл обратно: PDF, картинку, текст или JWT. Или перетащите файл, чтобы перевести его в Base64. Всё в этой вкладке.
Три байта — это 24 бита. Base64 режет те же 24 бита на четыре группы по шесть, и каждая группа обозначает один из 64 символов. Белые линии — там, где кончаются байты: они не совпадают с границами групп, и в этом весь фокус.
16 + 2 + 1 = 19 T
Индекс 19 в стандартном алфавите.
Как пользоваться Base64 декодером и кодировщиком онлайн
Вставьте что угодно в одно поле (текст, Base64, целый data: URI или JWT), нажмите Выбрать файл или перетащите файл на карточку. Инструмент сам понимает, в какую сторону преобразовывать, пишет это на метке и позволяет одним кликом прочитать ввод наоборот.
При декодировании файла вы получаете тип, определённый по самим байтам, размер, размер изображения в пикселях, вкладку Просмотр для изображения или PDF и скачивание с правильным расширением. Если закодировать файл в Base64, вы получите сам Base64, готовый data: URI и то, во сколько кодирование обошлось по размеру. Параметры Алфавит, Дополнение и Переносы строк под результатом меняют вывод.
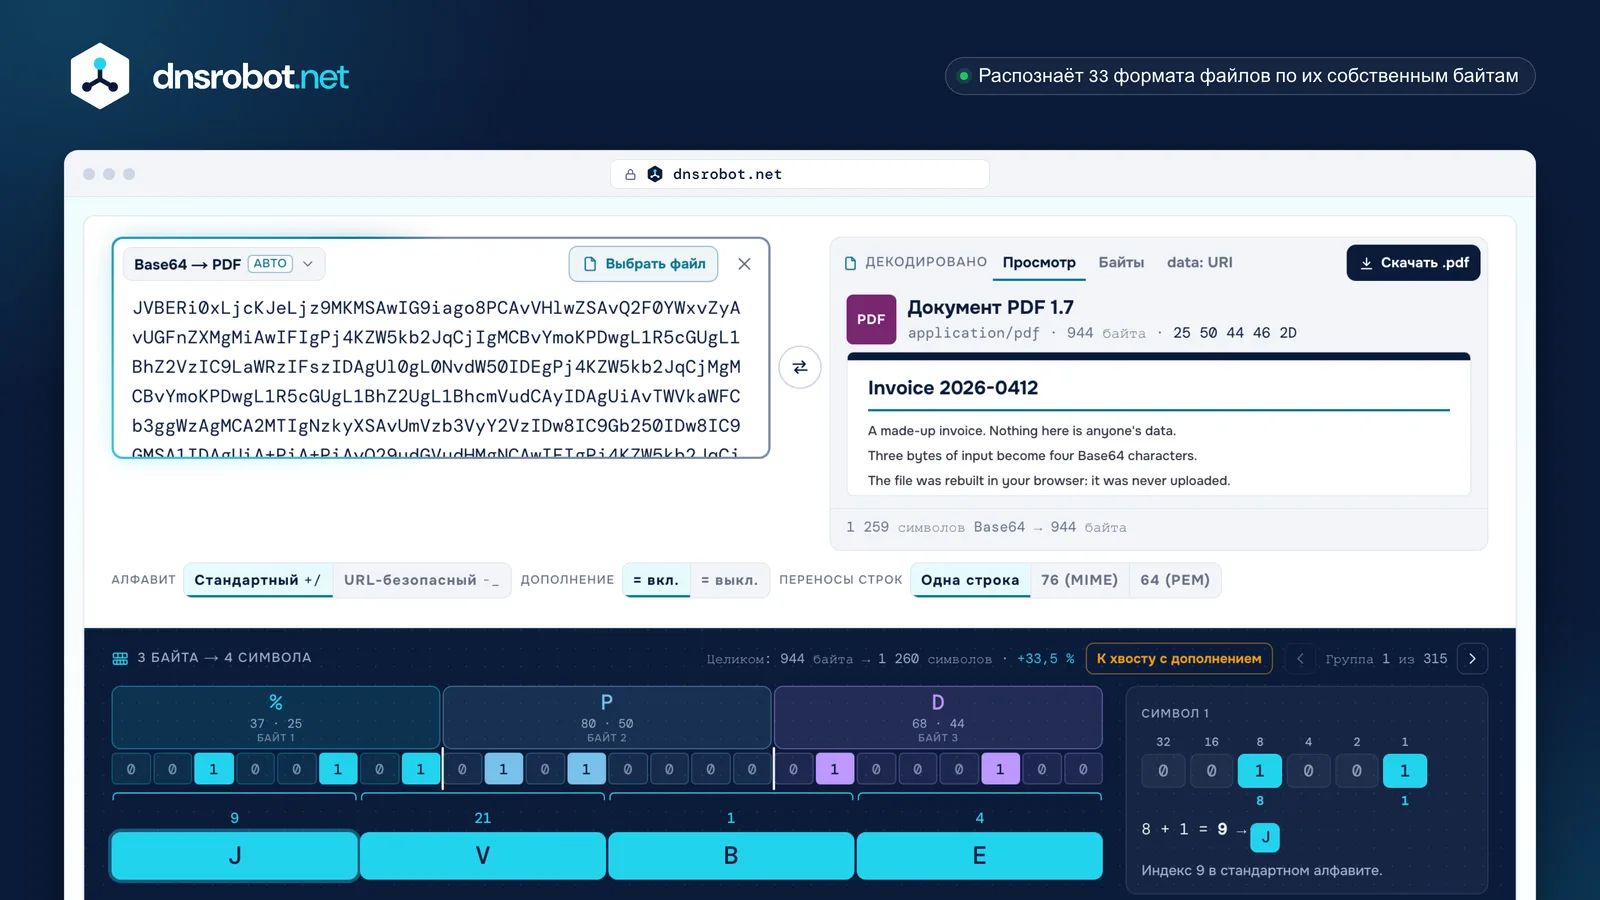
 Одно поле в обе стороныВставьте текст, Base64, data: URI или JWT. Метка показывает, как это прочитано, а меню меняет направление.Выбрать файлИли перетащите файл в любое место карточки: он станет Base64 и data: URI, не покидая вкладку.Что это за байтыПри декодировании результат начинается с типа файла, размера и сигнатуры, затем идут просмотр и скачивание.Параметры выводаСтандартный или URL-безопасный алфавит, дополнение вкл. или выкл. и переносы строк для MIME или PEM.3 байта → 4 символаВаши собственные байты, заново разрезанные на группы по шесть бит. Наведите на символ, чтобы увидеть, как складываются его биты.
Что такое Base64 и зачем он нужен?
Base64 записывает любые байты 64 символами, которые проходят где угодно: A–Z, a–z, 0–9, + и /. Он существует потому, что почта, URL, JSON и XML создавались для текста, а сырой байт может оказаться управляющим кодом, кавычкой или нулевым байтом и сломать их.
Он берёт по три байта за раз, выстраивает их 24 бита в ряд и режет этот ряд на четыре группы по шесть. В шесть бит помещается 64 значения, поэтому каждая группа обозначает ровно один символ. Три байта на входе, четыре символа на выходе, всегда: вот почему Base64 примерно на треть больше исходных данных.
Три байта — это 24 бита. Base64 заново режет их на четыре группы по шесть, и каждая группа обозначает один из 64 печатных символов, поэтому три байта всегда превращаются в четыре символа. Отсюда и рост на 33 %.
Два байта — это 16 бит. Base64 добавляет 2 нулевых бита, чтобы закончить третью группу, а один = стоит на месте четвёртого символа.
Один байт — это 8 бит. Base64 добавляет 4 нулевых бита, чтобы закончить вторую группу, а два = стоят на месте третьего и четвёртого символов. = вообще не несёт битов.
Как декодировать Base64 в PDF?
Вставьте строку, и инструмент восстановит PDF: покажет версию и размер, откроет документ во встроенном просмотрщике PDF вашего браузера и даст его скачать. Не нужно указывать, что это PDF, и не нужно сначала убирать префикс data:.
PDF узнаётся по первым пяти байтам, %PDF-, поэтому файл определяется, даже если его имя, тип, заявленный отправителем, или поле, в котором он пришёл, говорят другое. Если байты — не PDF, страница скажет, что это, вместо того чтобы безуспешно открывать документ, которого никогда не было.
Файл собирается в вашем браузере. Ничего не загружается на сервер, а это важно, когда PDF — расчётный листок, договор или счёт.
"document": "JVBERi0xLjcKJeLjz9MKMS…"Поле в ответе. Кавычки не входят в Base64.Content-Transfer-Encoding: base64MIME разбивает тело на строки по 76 символов. Вставляйте вместе с переносами: они пропускаются.data:application/pdf;base64,JVBERi0x…Вставляйте целиком. Префикс прочитается сам, убирать его вручную не нужно.- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
Первые 5 байт, %PDF-, — это и есть вся сигнатура. Байты с 6 по 8 — это версия: 1.7. Расширение файла здесь ни при чём, поэтому PDF, который кто-то назвал .txt, всё равно вернётся как PDF.
Как перевести картинку в Base64 и когда это стоит делать?
Перетащите изображение и получите его Base64 и готовый data: URI, чтобы вставить в HTML или CSS. Стоит ли это делать — вопрос сложнее: Base64 всегда обходится примерно на треть дороже, а встроенную картинку нельзя закешировать отдельно.
В обратную сторону, из Base64 в картинку, вы получаете формат, размер и настоящий размер в пикселях, прочитанный из заголовка самого файла, а не с картинки на экране, и скачивание с правильным расширением.
- Файл на диске12,9 кБ 100 %
- В виде Base6417,3 кБ +33,4 %
- С переносом через 76 символов (MIME)17,5 кБ +35,1 %
- Файл после gzip11,7 кБ -9,5 %
- Base64 после gzip12,5 кБ -3,2 %
- скачивается один раз
- кешируется браузером и CDN
- загружается рядом со страницей, а не внутри неё
- на треть больше до сжатия
- кешируется только вместе с файлом, в котором лежит
- разбирается вместе с таблицей стилей или HTML
Сжатие возвращает почти всю разницу: после gzip Base64 всего на 7 % больше сжатого файла. Чего оно не вернёт, так это собственной записи изображения в кеше: встроенное в HTML-страницу, оно скачивается заново с каждой страницей, где встречается.
Практическое правило: встраивайте несколько сотен байт (иконку, разделитель, логотип в письме), а всё, что больше, подключайте ссылкой. Это изображение PNG (12,9 кБ) уже за этой чертой.
Base64 и URL-безопасный Base64: в чём разница?
URL-безопасный Base64 (RFC 4648 §5) — та же кодировка, в которой заменены два символа: + становится -, а / становится _. Дополнение при этом тоже часто опускают.
Используйте его везде, где результат попадает в URL, имя файла или cookie. JSON Web Token использует его во всех частях, поэтому части токена никогда не заканчиваются на =. Этот инструмент читает оба алфавита и сообщает, если в одной строке есть символы обоих.
+/8=-_8=-_8+→-Индекс 62. В строке запроса декодер форм читает+как пробел, и данные возвращаются испорченными./→_Индекс 63. В пути/начинает новый сегмент, и значение разрезается надвое.=отброшенВ URL знак=обычно кодируется процентами как%3D(RFC 4648 §5). JWT отбрасывает его совсем (RFC 7515 §2): одна только длина говорит, где кончаются байты.
Первые 62 символа двух алфавитов одинаковы, поэтому инструмент, который читает оба алфавита, декодирует любой из них, а эта страница сообщает, если в строке есть символы обоих.
Base64 — это шифрование? Нет.
Base64 ничего не скрывает. Нет ни ключа, ни секрета, а обратное преобразование не требует никаких усилий: декодер вроде этого делает его прямо при вводе.
Особенно это важно для аутентификации HTTP Basic: заголовок несёт имя пользователя и пароль одной строкой Base64, которую может прочитать любой, кто её увидит, поэтому RFC 7617 считает такую схему безопасной только поверх зашифрованного соединения, например TLS. Если что-то должно оставаться нечитаемым, нужно шифрование. Base64 лишь безопасно проводит байты через канал, созданный для текста.
Заголовок Authorization в том виде, как его строит RFC 7617 §2
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordRFC 7617 строит заголовок шаг за шагом, и последний шаг — это вся его «защита»: клиент «получает basic-credentials, кодируя эту последовательность октетов с помощью Base64». Его §1 объясняет, что это значит: если соединение не защищено TLS или подобной системой, «идентификатор пользователя и пароль передаются по сети открытым текстом». У Base64 нет ключа, поэтому и взламывать нечего: у кого есть строка, у того есть пароль.
Почему декодированный текст превратился в кракозябры?
Потому что Base64 переносит байты, а байты становятся буквами, только когда что-то выбирает кодировку символов. Прочитайте текст в UTF-8 как ISO-8859-1, и é превратится в é; прочитайте ISO-8859-1 как UTF-8, и получится знак замены.
data: URI может объявлять свою кодировку, и эта страница читает текст именно в ней, а не прогоняет всё через UTF-8. Если в вашем браузере нет декодера для объявленной кодировки, страница прямо об этом скажет, а не будет молча показывать неверные буквы.
В UTF-8 é — это 2 байта, в ISO-8859-1 — 1 байт. Base64 переносит байты, а не буквы, поэтому сама строка не может подсказать декодеру, что имелось в виду.
Base64 в Python, JavaScript, Java, C#, Go, PowerShell и в терминале
Base64 встроен в каждый язык. Ловушки везде одни и те же: кодируйте байты, а не строку, и указывайте, в какой кодировке записан текст.
Самое острое место — btoa() в JavaScript: он принимает только символы до U+00FF, поэтому всё, что выходит за пределы Latin-1, сначала нужно превратить в байты UTF-8 через TextEncoder. Каждый пример ниже кодирует и декодирует «Man», и каждый был запущен, чтобы проверить вывод.
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
Запущено 26 октября 2026 г.: Python 3.14.4 выводит то, что показано в комментариях.
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
Запущено 26 октября 2026 г.: Node.js 22.23.2 выводит то, что показано в комментариях.
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
Запущено 26 октября 2026 г.: OpenJDK 25.0.2 выводит то, что показано в комментариях.
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
Запущено 26 октября 2026 г.: .NET 10.0.103 выводит то, что показано в комментариях.
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
Запущено 26 октября 2026 г.: Go 1.25.5 выводит то, что показано в комментариях.
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
Запущено 26 октября 2026 г.: PowerShell 7.5.5 выводит то, что показано в комментариях.
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
Запущено 26 октября 2026 г.: команда base64 в macOS 26.6 (bash) выводит то, что показано в комментариях.
base64 -d в терминале пишут -D. Источник: gnu.org, developer.mozilla.orgАлфавит Base64: от 0 до 63
Каждая группа из шести бит — число от 0 до 63, а это таблица, по которой его ищут. Base64 чувствителен к регистру: A — это 0, а a — 26, так что смена регистра буквы ломает строку.
Его стоит узнавать с первого взгляда: ряд A — это ряд нулевых байтов, а строка Base64, которая начинается с JVBER, — это PDF, с iVBOR — PNG, а с /9j/ — JPEG.
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +URL-безопасный: -62
- /URL-безопасный: _63
0–25 — это A–Z, 26–51 — a–z, 52–61 — 0–9. Два алфавита различаются только двумя последними символами таблицы, они отмечены выше. = в таблице нет вовсе: это не значение, а знак того, что последняя группа из трёх байтов была неполной.
Base64: вопросы и ответы
Что значит декодировать Base64?
Как декодировать файл из Base64?
Для чего используется Base64?
data: URI внутри HTML и CSS, в двоичных полях JSON и XML, в JSON Web Token, в аутентификации HTTP Basic, в сертификатах и ключах в файлах PEM. Везде данные проходят через канал, который может изменить или потерять сырые байты, поэтому они путешествуют обычными буквами и цифрами.Base64 — это шифрование?
Безопасно ли декодировать Base64 онлайн?
Почему Base64 на 33 % больше оригинала?
=, а перенос строк через 76 символов для почты добавляет разрыв в каждую строку, поэтому длинная строка часто примерно на 35 % больше байтов, которые она несёт. Сжатие вроде gzip возвращает большую часть этой разницы.Что такое URL-безопасный Base64?
+ заменён на -, а / — на _, как определяет RFC 4648 §5, так что результат можно поставить в URL, имя файла или cookie без экранирования. Дополнение обычно тоже убирают, как в JSON Web Token. Этот инструмент читает оба алфавита, даже вперемешку в одной строке, и умеет записывать любой из них.Почему не получается декодировать Base64?
Можно ли перевести Base64 в картинку?
data:image/png;base64, или без него, и появится изображение с форматом, размером и настоящим размером в пикселях, прочитанным из заголовка самого файла. Затем скачайте его с правильным расширением. PNG, JPEG, GIF, WebP, BMP, ICO и AVIF показываются сразу; SVG сначала показывается как текст, потому что SVG может содержать скрипт.Что означает = в конце Base64?
=, а один оставшийся байт — двумя символами и ==. Само дополнение не несёт никаких данных: оно лишь подсказывает декодеру, где кончаются байты. Многие декодеры, включая этот, читают и Base64 без дополнения.Есть ли ограничение по размеру?
Можно ли здесь декодировать JWT?
iat и exp, а подпись — в виде байтов. Страница только декодирует три части base64url: она не проверяет подпись и никогда не утверждает, что токен действителен, поэтому не решайте по ней, можно ли ему доверять.Чего-то не хватает?Предложите функцию или новый инструмент
Похожие инструменты
Бинарный переводчик
Перевод текста в двоичный код и обратно: автоопределение, hex, десятичная и восьмеричная запись
Генератор UUID
Генерация UUID v4, v7, v1, v5 и v3 или GUID пачкой в любом формате и декодирование версии и времени создания UUID
Декодер CSR и сертификатов
Расшифровка CSR или SSL сертификата: субъект, SAN, размер ключа, срок действия, издатель, отпечаток, проверка подписи и соответствия CSR
Невидимый символ
Копирование невидимого символа и пустого пробела, поиск и удаление скрытых символов в тексте
Конвертер Unix-времени
Перевод Unix timestamp в дату и даты в epoch-время в любом часовом поясе, с пакетной конвертацией