











Base64 디코딩 & 인코딩: PDF·이미지·파일로 변환
Base64를 PDF·이미지·텍스트·JWT로 디코딩하거나 파일을 놓아 Base64로 인코딩하세요. 모두 이 탭에서 처리합니다.
3바이트는 24비트입니다. Base64는 같은 24비트를 6비트씩 네 묶음으로 나누고, 각 묶음은 64개 문자 중 하나를 가리킵니다. 흰 선은 바이트가 끝나는 자리로, 묶음의 경계와 맞지 않습니다. 이것이 이 방식의 전부입니다.
16 + 2 + 1 = 19 T
표준 알파벳의 인덱스 19입니다.
Base64 디코딩 방법: 디코더와 인코더 사용법
입력란 하나에 무엇이든(텍스트, Base64, data: URI 전체, JWT) 붙여넣거나, 파일 선택을 누르거나, 카드에 파일을 끌어다 놓으세요. 도구가 변환 방향을 알아내 방향 표시에 보여 주고, 반대 방향으로 읽기도 클릭 한 번이면 됩니다.
파일을 디코딩하면 바이트 자체로 판별한 형식, 크기, 이미지의 픽셀 크기, 이미지나 PDF의 미리보기, 올바른 확장자의 다운로드를 얻습니다. 파일을 인코딩하면 Base64, 바로 쓸 수 있는 data: URI, 인코딩으로 늘어난 크기를 볼 수 있습니다. 결과 아래의 알파벳, 패딩, 줄 바꿈 옵션으로 출력을 바꿀 수 있습니다.
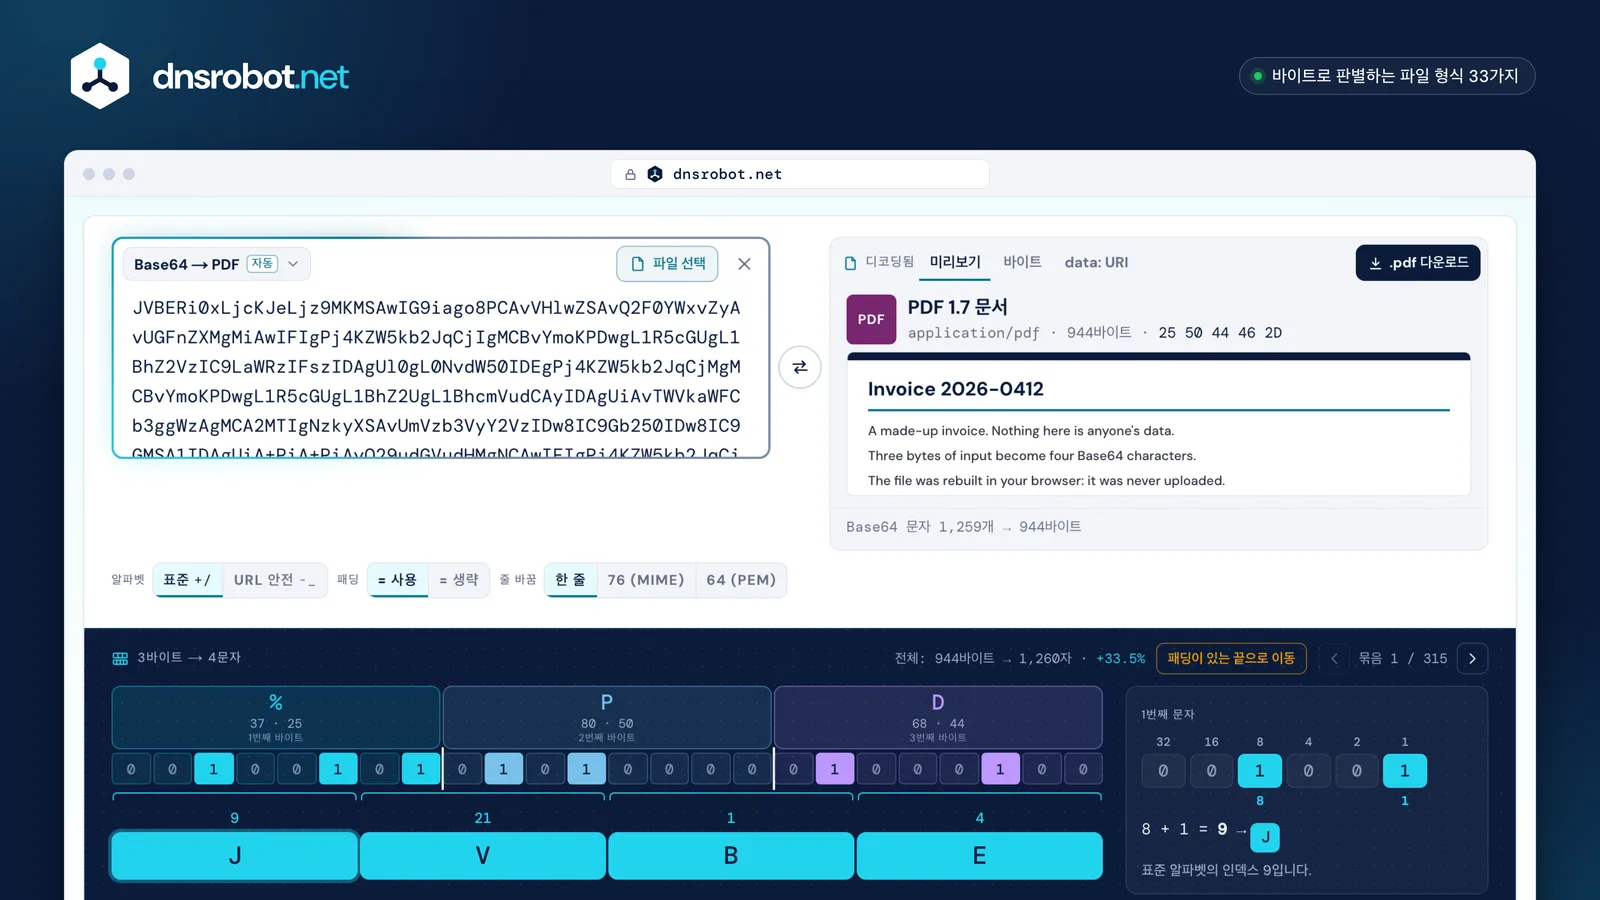
 입력란 하나로 양방향텍스트, Base64, data: URI, JWT를 붙여넣으세요. 방향 표시가 어떻게 읽었는지 알려 주고, 메뉴로 바꿀 수 있습니다.파일 선택또는 카드 아무 곳에나 파일을 끌어다 놓으세요. 탭을 벗어나지 않고 Base64와 data: URI로 바뀝니다.바이트의 정체디코딩하면 결과 맨 위에 파일의 형식, 크기, 시그니처가 나오고, 이어서 미리보기와 다운로드가 나옵니다.출력 옵션표준 또는 URL 안전 알파벳, 패딩 사용 여부, MIME이나 PEM용 줄 바꿈을 고릅니다.3바이트 → 4문자내 바이트를 6비트씩 묶음으로 다시 나눠 보여 줍니다. 문자를 가리키면 비트가 더해지는 과정을 볼 수 있습니다.
Base64란 무엇이며 왜 필요한가요?
Base64는 어디서든 깨지지 않는 64개 문자(A–Z, a–z, 0–9, +, /)로 어떤 바이트든 나타냅니다. 이메일, URL, JSON, XML은 텍스트를 위해 만들어졌고, 날것의 바이트는 제어 코드나 따옴표, 널 문자가 되어 이들을 망가뜨릴 수 있기 때문에 Base64가 존재합니다.
한 번에 3바이트씩 가져와 24비트를 한 줄로 늘어놓고, 그 줄을 6비트씩 네 묶음으로 자릅니다. 6비트는 64가지 값을 담으므로 각 묶음은 정확히 한 문자를 가리킵니다. 3바이트가 들어가면 언제나 4문자가 나오므로, Base64는 원래 데이터보다 약 3분의 1 커집니다.
3바이트는 24비트입니다. Base64는 이를 6비트씩 네 묶음으로 다시 나누고, 각 묶음은 출력 가능한 64개 문자 중 하나를 가리키므로 3바이트는 언제나 4문자가 됩니다. 33% 증가는 바로 여기서 생깁니다.
2바이트는 16비트입니다. Base64는 0 비트 2개를 더해 세 번째 묶음을 채우고, 네 번째 문자 자리에는 = 하나가 들어갑니다.
1바이트는 8비트입니다. Base64는 0 비트 4개를 더해 두 번째 묶음을 채우고, 세 번째와 네 번째 문자 자리에는 = 두 개가 들어갑니다. = 기호는 비트를 전혀 담지 않습니다.
Base64를 PDF로 디코딩하는 방법은?
문자열을 붙여넣으면 도구가 PDF를 복원합니다. 버전과 크기를 보여 주고, 브라우저에 내장된 PDF 뷰어로 문서를 열며, 다운로드도 제공합니다. PDF라고 알려 줄 필요도, data: 접두사를 먼저 지울 필요도 없습니다.
PDF는 첫 5바이트인 %PDF-로 알아보므로, 파일 이름이나 보낸 사람이 주장한 형식, 담겨 온 필드가 다르게 말해도 파일을 식별합니다. 바이트가 PDF가 아니면, 처음부터 없던 문서를 열다가 실패하는 대신 그 바이트가 무엇인지 알려 줍니다.
파일은 브라우저 안에서 복원됩니다. 아무것도 업로드되지 않으며, 급여 명세서, 계약서, 청구서 같은 PDF라면 이 점이 중요합니다.
"document": "JVBERi0xLjcKJeLjz9MKMS…"응답 안의 필드입니다. 따옴표는 Base64의 일부가 아닙니다.Content-Transfer-Encoding: base64MIME은 본문을 한 줄에 76자씩 줄 바꿈합니다. 줄 바꿈이 있는 그대로 붙여넣으세요. 줄 바꿈은 건너뜁니다.data:application/pdf;base64,JVBERi0x…전체를 그대로 붙여넣으세요. 접두사는 손으로 지우지 않아도 읽어 냅니다.- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
첫 5바이트 %PDF- 자체가 시그니처 전체입니다. 6~8번째 바이트가 버전을 나타내며, 값은 1.7입니다. 파일 확장자는 관계가 없으므로, 누군가 .txt라는 이름을 붙인 PDF도 PDF로 되돌아옵니다.
이미지를 Base64로 변환하는 방법은? 언제 써야 하나요?
이미지를 끌어다 놓으면 Base64와, HTML이나 CSS에 바로 붙여넣을 수 있는 data: URI를 얻습니다. 더 어려운 질문은 그래야 하느냐입니다. Base64는 언제나 약 3분의 1 더 크고, 인라인 이미지는 따로 캐시될 수 없습니다.
반대 방향인 Base64 이미지 변환에서는 화면 속 그림이 아니라 파일 자체의 헤더에서 읽은 형식, 크기, 실제 픽셀 크기를 얻고, 올바른 확장자로 다운로드할 수 있습니다.
- 디스크의 파일12.9kB 100%
- Base64로 바꾼 것17.3kB +33.4%
- MIME용 76자 줄 바꿈17.5kB +35.1%
- 파일을 gzip 압축11.7kB -9.5%
- Base64를 gzip 압축12.5kB -3.2%
- 한 번만 다운로드
- 브라우저와 CDN이 캐시
- 페이지 안이 아니라 페이지 옆에서 가져옴
- 압축 전 3분의 1 더 큼
- 이미지를 담은 파일의 일부로만 캐시
- 스타일시트나 HTML의 일부로 파싱
압축으로 대부분 되찾습니다: gzip으로 압축하면 Base64는 gzip 압축한 파일보다 7%만 더 큽니다. 되찾을 수 없는 것은 이미지 자체의 캐시 항목입니다. HTML 페이지에 인라인으로 넣으면, 그 이미지를 담은 페이지마다 다시 다운로드됩니다.
경험칙: 수백 바이트(아이콘, 스페이서, 이메일 속 로고)는 인라인으로 넣고, 그보다 큰 것은 링크하세요. 이 12.9kB PNG 이미지는 이미 그 선을 넘었습니다.
Base64와 URL 안전 Base64의 차이는?
URL 안전 Base64(RFC 4648 §5)는 두 문자만 바꾼 같은 인코딩입니다. + 대신 -, / 대신 _를 씁니다. 패딩도 흔히 생략합니다.
결과가 URL, 파일 이름, 쿠키에 들어간다면 어디서든 이 방식을 쓰세요. JSON Web Token은 전체에 이 방식을 쓰므로 토큰의 각 부분은 절대 = 기호로 끝나지 않습니다. 이 도구는 두 알파벳을 모두 읽고, 한 문자열에 둘이 섞여 있으면 알려 줍니다.
+/8=-_8=-_8+→-인덱스 62. 쿼리 문자열에서는 폼 디코더가+기호를 공백으로 읽으므로 데이터가 잘못 복원됩니다./→_인덱스 63. 경로에서는/기호가 새 세그먼트를 시작하므로 값이 둘로 나뉩니다.=생략URL에서=기호는 보통%3D로 퍼센트 인코딩됩니다(RFC 4648 §5). JWT는 아예 빼 버립니다(RFC 7515 §2). 길이만으로 바이트가 끝나는 곳을 알 수 있기 때문입니다.
두 알파벳의 처음 문자 62개는 똑같습니다. 그래서 두 알파벳을 모두 읽는 도구는 어느 쪽이든 디코딩할 수 있고, 이 페이지는 한 문자열에 둘이 섞여 있으면 알려 줍니다.
Base64는 암호화인가요? 아닙니다
Base64는 아무것도 숨기지 않습니다. 키도 비밀도 없어서 흔히 말하는 ‘Base64 복호화’에는 아무런 노력도 들지 않습니다. 이 페이지 같은 디코더는 입력하는 즉시 되돌립니다.
이 점이 가장 중요한 곳은 HTTP Basic 인증입니다. 헤더에 사용자 이름과 비밀번호가 하나의 Base64 문자열로 담겨, 보는 사람 누구나 읽을 수 있습니다. 그래서 RFC 7617은 TLS 같은 암호화된 연결에서만 안전하다고 봅니다. 읽을 수 없게 지켜야 하는 것이라면 암호화가 필요합니다. Base64는 텍스트용으로 만들어진 통로에 바이트를 안전하게 통과시킬 뿐입니다.
RFC 7617 §2 방식으로 만든 Authorization 헤더
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordRFC 7617은 헤더를 단계별로 만들며, 마지막 단계가 그 ‘보호’의 전부입니다. 거기서 클라이언트는 “이 옥텟 시퀀스를 Base64로 인코딩하여 basic-credentials를 얻는다”고 되어 있습니다. 그것이 무슨 뜻인지는 §1에 나옵니다. TLS 같은 시스템이 연결을 보호하지 않는 한 “사용자 ID와 비밀번호가 평문으로 네트워크를 통해 전달된다”는 것입니다. Base64에는 키가 없으므로 깨뜨릴 것도 없습니다. 문자열을 가진 사람은 곧 비밀번호를 가진 셈입니다.
디코딩한 텍스트가 깨진 글자로 보이는 이유는?
Base64는 바이트를 담고, 바이트는 무언가가 문자 인코딩을 골라야 비로소 글자가 되기 때문입니다. UTF-8 텍스트를 ISO-8859-1인 것처럼 읽으면 é 문자가 é 같은 글자로 바뀌고, ISO-8859-1을 UTF-8로 읽으면 대체 문자가 됩니다.
data: URI는 charset을 선언할 수 있으며, 이 페이지는 모든 것을 UTF-8로 밀어붙이지 않고 그 charset으로 텍스트를 읽습니다. 선언된 charset의 디코더가 브라우저에 없으면, 틀린 글자를 조용히 보여 주는 대신 그렇다고 알려 줍니다.
UTF-8에서 é 문자는 2바이트이고, ISO-8859-1에서는 1바이트입니다. Base64는 글자가 아니라 바이트를 담으므로, 어느 쪽을 뜻했는지 디코더가 문자열만 보고 알 수는 없습니다.
Python, JavaScript, Java, C#, Go, PowerShell, 셸에서 Base64 쓰기
모든 언어에 Base64가 내장되어 있습니다. 함정은 어디서나 같습니다. 문자열이 아니라 바이트를 인코딩하고, 텍스트가 어떤 문자 인코딩인지 밝혀야 합니다.
가장 까다로운 것은 JavaScript의 btoa()입니다. U+00FF까지의 문자만 받으므로, Latin-1을 넘는 문자는 먼저 TextEncoder로 UTF-8 바이트로 바꿔야 합니다. 아래 예제는 모두 ‘Man’을 인코딩하고 디코딩하며, 실제로 실행해 출력을 확인했습니다.
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
Python 3.14.4 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
Node.js 22.23.2 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
OpenJDK 25.0.2 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
.NET 10.0.103 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
Go 1.25.5 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
PowerShell 7.5.5 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
macOS 26.6의 bash(base64 명령) 환경에서 2026년 10월 26일에 실행했으며, 주석에 적힌 그대로 출력합니다.
base64 -d는 옛 macOS에서는 -D입니다. 출처: gnu.org, developer.mozilla.orgBase64 알파벳 표: 0부터 63까지
6비트 묶음은 각각 0부터 63까지의 수이고, 이 표에서 문자를 찾습니다. Base64는 대소문자를 구분합니다. A는 0, a는 26이므로 글자의 대소문자를 바꾸면 문자열이 깨집니다.
눈으로 익혀 둘 만합니다. A가 이어지면 값이 0인 바이트가 이어진 것이고, JVBER로 시작하는 Base64 문자열은 PDF, iVBOR로 시작하면 PNG, /9j/로 시작하면 JPEG입니다.
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +URL 안전: -62
- /URL 안전: _63
0–25: A–Z, 26–51: a–z, 52–61: 0–9. 두 알파벳에서 다른 것은 표의 마지막 두 문자뿐이며, 위에 표시했습니다. = 기호는 표에 아예 없습니다. 값이 아니라, 마지막 3바이트 묶음이 모자랐다는 표시입니다.
Base64: 자주 묻는 질문
Base64 디코딩(복호화)이란 무엇인가요?
Base64 파일을 디코딩하는 방법은?
Base64는 어디에 쓰이나요?
data: URI, JSON과 XML의 바이너리 필드, JSON Web Token, HTTP Basic 인증, PEM 파일 속 인증서와 키가 그 예입니다. 어느 경우든 데이터는 날것의 바이트를 바꾸거나 빠뜨릴 수 있는 통로를 지나야 하므로, 평범한 영문자와 숫자로 이동합니다.Base64는 암호화인가요?
Base64를 온라인에서 디코딩해도 안전한가요?
Base64는 왜 원본보다 33% 더 큰가요?
= 패딩 문자가 최대 2개 붙을 수 있고, 이메일용으로 76자마다 줄을 바꾸면 줄마다 줄 바꿈이 더해지므로, 긴 문자열은 담고 있는 바이트보다 35% 정도 더 큰 경우가 많습니다. gzip 같은 압축으로 그 대부분을 되찾을 수 있습니다.URL 안전 Base64란 무엇인가요?
+ 대신 -, / 대신 _를 쓰는 Base64로, 결과를 이스케이프하지 않고 URL, 파일 이름, 쿠키에 넣을 수 있습니다. JSON Web Token처럼 패딩도 보통 생략합니다. 이 도구는 한 문자열에 섞여 있어도 두 알파벳을 모두 읽고, 어느 쪽으로든 쓸 수 있습니다.Base64 디코딩이 실패하는 이유는?
Base64를 이미지로 변환할 수 있나요?
data:image/png;base64, 같은 접두사가 있든 없든 문자열을 붙여넣으면 이미지가 나타나고, 형식, 크기, 파일 자체의 헤더에서 읽은 실제 픽셀 크기를 보여 줍니다. 그다음 올바른 확장자로 다운로드하세요. PNG, JPEG, GIF, WebP, BMP, ICO, AVIF는 미리 볼 수 있고, SVG는 스크립트를 담을 수 있으므로 처음에는 텍스트로 보여 줍니다.Base64 끝에 붙는 = 기호는 무슨 뜻인가요?
= 하나가 되고, 남은 1바이트는 2문자 뒤에 == 기호가 붙습니다. 패딩은 데이터를 전혀 담지 않으며, 바이트가 끝나는 곳을 디코더에 알려 줄 뿐입니다. 이 도구를 포함한 많은 디코더는 패딩이 생략된 Base64도 읽습니다.크기 제한이 있나요?
여기서 JWT를 디코딩할 수 있나요?
iat와 exp 클레임 옆에는 날짜가, 서명은 바이트로 표시됩니다. 이 페이지는 세 개의 base64url 부분을 디코딩할 뿐, 서명을 검증하지 않으며 토큰이 유효하다고 말하지도 않습니다. 그러니 토큰을 믿을지 결정하는 데 쓰지 마세요.부족한 점이 있습니까?기능 또는 새 도구 제안하기
관련 도구
바이너리 번역기 (바이너리 변환)
텍스트를 바이너리로, 바이너리를 텍스트로 번역: 자동 감지, 16진수·10진수·8진수 지원
UUID 생성기
UUID v4, v7, v1, v5, v3 또는 GUID를 원하는 형식으로 대량 생성하고, UUID의 버전과 타임스탬프를 디코딩
CSR·인증서 디코더
CSR 또는 SSL 인증서 디코딩: 주체, SAN, 키 크기, 유효 기간, 발급자, 지문, 서명 검증 및 CSR·인증서 일치 확인
공백문자
보이지 않는 공백문자를 복사해 붙여넣고, 텍스트에 숨은 문자를 찾아 제거
유닉스 타임스탬프 변환기
Unix 타임스탬프를 날짜로, 날짜를 epoch 시간으로 원하는 시간대에서 변환하고 일괄 변환도 지원