











Giải Mã & Mã Hóa Base64: Sang PDF, Ảnh hoặc Tệp
Giải mã Base64 online: dán mã Base64 để lấy lại tệp PDF, ảnh, văn bản hay JWT, hoặc thả tệp vào để có Base64 của nó. Mọi thứ diễn ra ngay trong tab này.
Ba byte là 24 bit. Base64 cắt chính 24 bit đó thành bốn nhóm sáu bit, và mỗi nhóm chỉ đến một trong 64 ký tự. Các vạch trắng là chỗ các byte kết thúc: chúng không thẳng hàng với các nhóm, và đó là toàn bộ bí quyết.
16 + 2 + 1 = 19 T
Chỉ số 19 trong bảng chữ cái chuẩn.
Cách dùng công cụ giải mã và mã hóa Base64
Dán bất cứ thứ gì vào ô nhập duy nhất (văn bản, Base64, cả một data: URI hoặc một JWT), hoặc bấm Chọn tệp hay thả tệp lên khung. Công cụ tự xác định chiều chuyển đổi, ghi rõ trên nhãn, và để cách đọc còn lại chỉ cách một cú bấm.
Khi giải mã một tệp, bạn nhận được kiểu tệp đọc từ chính các byte, dung lượng, kích thước điểm ảnh của ảnh, thẻ Xem trước cho ảnh hoặc PDF, và bản tải về với đúng phần mở rộng. Khi mã hóa một tệp, bạn nhận được Base64, một data: URI dùng ngay được và mức dung lượng mà việc mã hóa tốn thêm. Các tùy chọn Bảng chữ cái, Phần đệm và Ngắt dòng bên dưới kết quả thay đổi đầu ra.
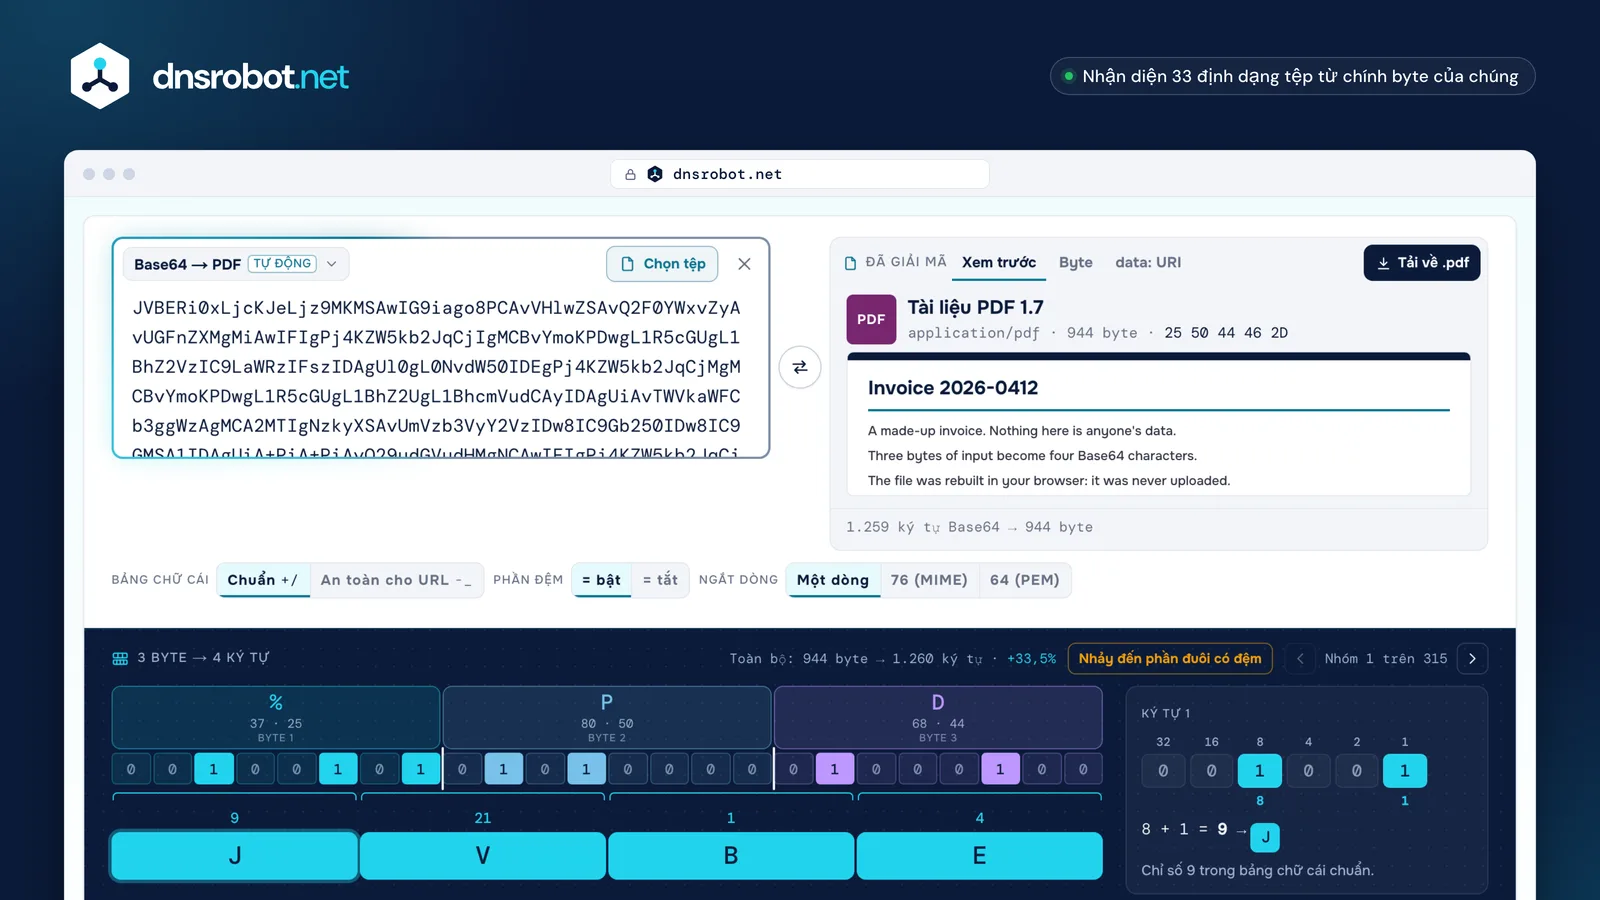
 Một ô, cả hai chiềuDán văn bản, Base64, data: URI hoặc JWT. Nhãn cho biết nội dung được đọc theo cách nào; menu cho phép đổi lại.Chọn tệpHoặc thả tệp vào bất kỳ đâu trên khung: tệp trở thành Base64 và một data: URI mà không rời khỏi tab.Các byte là gìKhi giải mã, kết quả mở đầu bằng kiểu tệp, dung lượng và chữ ký tệp, rồi đến bản xem trước và nút tải về.Tùy chọn đầu raBảng chữ cái chuẩn hoặc an toàn cho URL, bật hoặc tắt phần đệm, và ngắt dòng cho MIME hoặc PEM.3 byte → 4 ký tựChính các byte của bạn, được cắt lại thành từng nhóm sáu bit. Trỏ vào một ký tự để xem các bit của nó cộng lại.
Base64 là gì, và vì sao nó tồn tại?
Base64 viết mọi byte bằng 64 ký tự đi qua được mọi nơi: A–Z, a–z, 0–9, + và /. Nó tồn tại vì email, URL, JSON và XML được tạo ra cho văn bản, còn một byte thô có thể là mã điều khiển, dấu ngoặc kép hoặc ký tự null làm hỏng chúng.
Nó lấy ba byte một lần, xếp 24 bit của chúng thành một hàng rồi cắt hàng đó thành bốn nhóm sáu bit. Sáu bit chứa được 64 giá trị, nên mỗi nhóm chỉ đúng một ký tự. Ba byte vào, bốn ký tự ra, lần nào cũng vậy: đó là lý do Base64 lớn hơn dữ liệu gốc khoảng một phần ba.
Ba byte là 24 bit. Base64 cắt lại chúng thành bốn nhóm sáu bit, và mỗi nhóm chỉ đến một trong 64 ký tự in được, nên ba byte luôn tốn bốn ký tự. Mức tăng 33% đến từ chính chỗ đó.
Hai byte là 16 bit. Base64 thêm 2 bit 0 để hoàn tất nhóm thứ ba, và một dấu = đứng ở chỗ lẽ ra là ký tự thứ tư.
Một byte là 8 bit. Base64 thêm 4 bit 0 để hoàn tất nhóm thứ hai, và hai dấu = đứng ở chỗ lẽ ra là ký tự thứ ba và thứ tư. = hoàn toàn không mang bit nào.
Làm sao giải mã Base64 sang PDF?
Dán chuỗi vào và công cụ dựng lại tệp PDF: nó hiển thị phiên bản và dung lượng, mở tài liệu trong trình xem PDF có sẵn của trình duyệt và cho bạn nút tải về. Bạn không cần nói đó là PDF, cũng không cần xóa tiền tố data: trước.
Tệp PDF được nhận ra nhờ năm byte đầu tiên, %PDF-, nên tệp vẫn được xác định đúng ngay cả khi tên tệp, kiểu mà bên gửi khai báo hay trường dữ liệu chứa nó nói khác đi. Nếu các byte không phải PDF, trang sẽ cho biết chúng là gì thay vì cố mở một tài liệu vốn không hề có.
Tệp được dựng lại ngay trong trình duyệt của bạn. Không gì bị tải lên, điều này quan trọng khi tệp PDF là phiếu lương, hợp đồng hay hóa đơn.
"document": "JVBERi0xLjcKJeLjz9MKMS…"Một trường trong phản hồi. Dấu ngoặc kép không thuộc về Base64.Content-Transfer-Encoding: base64MIME ngắt phần thân thành các dòng 76 ký tự. Hãy dán nguyên cả dấu ngắt dòng: chúng sẽ được bỏ qua.data:application/pdf;base64,JVBERi0x…Dán nguyên cả chuỗi. Tiền tố được đọc, không cần tự tay cắt bỏ.- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
5 byte đầu tiên, %PDF-, là toàn bộ chữ ký tệp. Byte 6 đến 8 là phiên bản: 1.7. Phần mở rộng tệp không đóng vai trò gì, nên một tệp PDF bị ai đó đặt tên .txt vẫn được trả lại đúng là PDF.
Làm sao chuyển ảnh sang Base64, và khi nào nên làm?
Thả ảnh vào và bạn nhận được Base64 của nó cùng một data: URI dùng ngay được để dán vào HTML hoặc CSS. Có nên làm hay không mới là câu hỏi khó hơn: Base64 luôn tốn thêm khoảng một phần ba, và ảnh nhúng trực tiếp không thể được lưu vào bộ nhớ đệm riêng.
Theo chiều ngược lại, từ Base64 sang ảnh, bạn nhận được định dạng, dung lượng và kích thước điểm ảnh thật đọc từ header của chính tệp, không phải từ hình trên màn hình, cùng nút tải về với đúng phần mở rộng.
- Tệp trên ổ đĩa12,9 kB 100%
- Dưới dạng Base6417,3 kB +33,4%
- Ngắt dòng ở 76 ký tự cho MIME17,5 kB +35,1%
- Tệp, nén gzip11,7 kB -9,5%
- Base64, nén gzip12,5 kB -3,2%
- chỉ tải về một lần
- được trình duyệt và CDN lưu vào bộ nhớ đệm
- được tải riêng bên cạnh trang, không nằm bên trong trang
- lớn hơn một phần ba trước khi nén
- chỉ được lưu đệm như một phần của tệp chứa nó
- được phân tích như một phần của stylesheet hoặc HTML
Nén lấy lại được phần lớn: sau khi nén gzip, Base64 chỉ lớn hơn tệp nén gzip 7%. Thứ nén không trả lại được là mục bộ nhớ đệm riêng của ảnh: khi nhúng vào một trang HTML, ảnh bị tải lại cùng mỗi trang chứa nó.
Nguyên tắc dễ nhớ: nhúng trực tiếp vài trăm byte (một biểu tượng, một ảnh đệm, một logo trong email) và dùng liên kết cho mọi thứ lớn hơn. Ảnh PNG 12,9 kB này đã vượt ngưỡng đó.
Base64 và Base64 an toàn cho URL (URL-safe): khác nhau thế nào?
Base64 an toàn cho URL (RFC 4648 §5) là cùng một cách mã hóa nhưng đổi hai ký tự: + thành - và / thành _. Phần đệm cũng thường bị bỏ đi.
Hãy dùng nó ở bất cứ đâu kết quả đi vào URL, tên tệp hay cookie. JSON Web Token dùng nó cho mọi phần, vì vậy các phần của một token không bao giờ kết thúc bằng =. Công cụ này đọc được cả hai bảng chữ cái và báo cho bạn khi một chuỗi chứa cả hai.
+/8=-_8=-_8+→-Chỉ số 62. Trong chuỗi truy vấn, bộ giải mã form đọc+thành dấu cách, nên dữ liệu bị sai./→_Chỉ số 63. Trong đường dẫn,/mở đầu một đoạn mới, nên giá trị bị tách làm hai.- Bỏ
=Trong URL,=thường được mã hóa phần trăm thành%3D(RFC 4648 §5). JWT bỏ hẳn nó (RFC 7515 §2): chỉ riêng độ dài đã cho biết các byte kết thúc ở đâu.
62 ký tự đầu tiên của hai bảng chữ cái giống hệt nhau, vì vậy một công cụ đọc được cả hai bảng chữ cái có thể giải mã chuỗi viết bằng bảng nào cũng được, và vì vậy trang này báo cho bạn khi một chuỗi chứa cả hai.
Base64 có phải là mã hóa bảo mật không? Không.
Base64 không che giấu gì cả. Không có khóa, không có bí mật, và đảo ngược nó chẳng tốn chút công sức nào: một công cụ giải mã như công cụ này làm việc đó ngay khi bạn gõ.
Xác thực HTTP Basic là nơi điều này quan trọng nhất: header mang tên người dùng và mật khẩu dưới dạng một chuỗi Base64, ai nhìn thấy cũng đọc được, vì vậy RFC 7617 chỉ coi nó là an toàn khi đi qua một kết nối được mã hóa như TLS. Nếu thứ gì đó phải được giữ kín, nó cần mã hóa bảo mật (encryption). Base64 chỉ giúp các byte đi qua an toàn một kênh được tạo ra cho văn bản.
Một header Authorization, theo cách RFC 7617 §2 tạo ra nó
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordRFC 7617 tạo header từng bước, và bước cuối cùng là toàn bộ sự “bảo vệ” của nó: client “thu được basic-credentials bằng cách mã hóa chuỗi octet này bằng Base64”. §1 của RFC nói rõ điều đó nghĩa là gì: trừ khi TLS hoặc một hệ thống tương tự bảo vệ kết nối, “user-id và mật khẩu được truyền qua mạng dưới dạng bản rõ”. Base64 không có khóa, nên chẳng có gì để phá: ai có chuỗi này là có mật khẩu.
Vì sao văn bản giải mã ra bị lỗi bảng mã (mojibake)?
Vì Base64 mang byte, và byte chỉ trở thành chữ khi có thứ gì đó chọn một bảng mã ký tự. Đọc văn bản UTF-8 như thể nó là ISO-8859-1 thì é biến thành é; đọc ISO-8859-1 như UTF-8 thì nó thành một dấu thay thế.
Một data: URI có thể khai báo charset, và trang này đọc văn bản theo đúng charset đó thay vì ép mọi thứ qua UTF-8. Khi trình duyệt của bạn không có bộ giải mã cho bảng mã được khai báo, trang sẽ nói rõ điều đó thay vì lặng lẽ hiển thị sai chữ.
Trong UTF-8, é là 2 byte; trong ISO-8859-1, nó là 1 byte. Base64 mang byte, không mang chữ, nên bản thân chuỗi không thể cho bộ giải mã biết bảng mã nào mới đúng.
Base64 trong Python, JavaScript, Java, C#, Go, PowerShell và shell
Ngôn ngữ nào cũng có sẵn Base64. Cái bẫy thì ở đâu cũng giống nhau: hãy mã hóa byte chứ không phải chuỗi, và nói rõ văn bản dùng bảng mã ký tự nào.
btoa() của JavaScript là chỗ dễ vấp nhất: nó chỉ nhận ký tự đến U+00FF, nên mọi thứ vượt ngoài Latin-1 phải được chuyển thành byte UTF-8 bằng TextEncoder trước. Mỗi ví dụ dưới đây mã hóa và giải mã “Man”, và đều đã được chạy để kiểm tra kết quả.
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
Đã chạy bằng Python 3.14.4 vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
Đã chạy bằng Node.js 22.23.2 vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
Đã chạy bằng OpenJDK 25.0.2 vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
Đã chạy bằng .NET 10.0.103 vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
Đã chạy bằng Go 1.25.5 vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
Đã chạy bằng PowerShell 7.5.5 vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
Đã chạy bằng lệnh base64 của macOS 26.6 (bash) vào 26 tháng 10, 2026: kết quả in ra đúng như phần chú thích.
base64 -d của shell là -D trên các bản macOS cũ. Nguồn: gnu.org, developer.mozilla.orgBảng chữ cái Base64, từ 0 đến 63
Mỗi nhóm sáu bit là một số từ 0 đến 63, và đây là bảng để tra số đó. Base64 phân biệt chữ hoa chữ thường: A là 0 còn a là 26, nên đổi hoa thường của một chữ cái sẽ làm hỏng chuỗi.
Bảng này đáng để nhận ra bằng mắt: một dãy A là một dãy byte 0, và một chuỗi Base64 bắt đầu bằng JVBER là tệp PDF, iVBOR là PNG, còn /9j/ là JPEG.
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +An toàn cho URL: -62
- /An toàn cho URL: _63
0–25 là A–Z, 26–51 là a–z, 52–61 là 0–9. Chỉ hai ký tự cuối của bảng khác nhau giữa hai bảng chữ cái, được đánh dấu ở trên. = hoàn toàn không có trong bảng: nó không phải một giá trị, mà là dấu cho biết nhóm ba byte cuối cùng bị thiếu.
Base64: hỏi và đáp
Base64 là gì, và giải mã Base64 là gì?
Làm sao giải mã một tệp Base64?
Base64 dùng để làm gì?
data: URI trong HTML và CSS, các trường nhị phân trong JSON và XML, JSON Web Token, xác thực HTTP Basic, cùng chứng chỉ và khóa trong tệp PEM. Ở mỗi trường hợp, dữ liệu phải đi qua một kênh có thể làm thay đổi hoặc đánh rơi byte thô, nên nó được truyền đi dưới dạng chữ cái và chữ số thông thường.Base64 có phải là mã hóa bảo mật không?
Giải mã Base64 online có an toàn không?
Vì sao Base64 lớn hơn bản gốc 33%?
= ở cuối, và việc ngắt dòng ở 76 ký tự cho email thêm một dấu ngắt dòng vào mỗi dòng, nên một chuỗi dài thường lớn hơn khoảng 35% so với các byte nó mang. Nén như gzip lấy lại được phần lớn mức chênh đó.Base64 an toàn cho URL (URL-safe) là gì?
+ được thay bằng - và / được thay bằng _, như RFC 4648 §5 định nghĩa, để kết quả có thể đi vào URL, tên tệp hay cookie mà không cần thoát ký tự. Phần đệm thường cũng bị bỏ, như trong JSON Web Token. Công cụ này đọc được cả hai bảng chữ cái, kể cả khi chúng lẫn trong cùng một chuỗi, và có thể viết theo bảng nào cũng được.Vì sao giải mã Base64 bị lỗi?
Có chuyển Base64 sang ảnh được không?
data:image/png;base64, đều được, và ảnh hiện ra kèm định dạng, dung lượng và kích thước điểm ảnh thật đọc từ header của chính tệp. Sau đó tải ảnh về với đúng phần mở rộng. PNG, JPEG, GIF, WebP, BMP, ICO và AVIF đều xem trước được; SVG được hiển thị dưới dạng văn bản trước, vì SVG có thể chứa script.Dấu = ở cuối Base64 nghĩa là gì?
=, còn một byte còn lại trở thành hai ký tự và ==. Phần đệm hoàn toàn không mang dữ liệu: nó chỉ cho bộ giải mã biết các byte kết thúc ở đâu. Nhiều bộ giải mã, kể cả công cụ này, cũng đọc được Base64 đã bị bỏ phần đệm.Có giới hạn dung lượng không?
Có giải mã JWT ở đây được không?
iat và exp, còn chữ ký hiện dưới dạng byte. Trang này chỉ giải mã ba phần base64url: nó không xác minh chữ ký và không bao giờ nói một token là hợp lệ, nên đừng dùng nó để quyết định có nên tin một token hay không.Còn thiếu điều gì?Đề xuất tính năng hoặc công cụ mới
Công cụ liên quan
Dịch Mã Nhị Phân
Dịch văn bản sang mã nhị phân và nhị phân sang văn bản: tự nhận diện, hex, thập phân và bát phân
Tạo UUID
Tạo UUID v4, v7, v1, v5 và v3 hoặc GUID hàng loạt, theo mọi định dạng, và giải mã phiên bản cùng timestamp của UUID
Giải Mã CSR & Chứng Chỉ
Giải mã CSR hoặc chứng chỉ SSL: subject, SAN, kích thước khóa, thời hạn, nhà phát hành, fingerprint, kiểm tra chữ ký và độ khớp CSR với chứng chỉ
Kí Tự Trống
Sao chép và dán kí tự trống hoặc dấu cách tàng hình, tìm và xóa ký tự ẩn trong văn bản
Chuyển Đổi Epoch
Chuyển Unix timestamp sang ngày giờ và ngày giờ sang epoch theo mọi múi giờ, hỗ trợ chuyển đổi hàng loạt