











Kiểm Tra Sitemap
Dán một tên miền hoặc URL sitemap để kiểm tra sitemap toàn diện: mọi tệp trong chỉ mục, mọi quy tắc mà giao thức đặt ra, những URL công cụ tìm kiếm sẽ từ chối cùng lý do, và các ngày trong đó có ý nghĩa gì không.
Chỉ cần tên miền: chúng tôi đọc robots.txt và tìm ở các vị trí quen thuộc. Nhập thẳng một tệp cũng được, như example.com/sitemap.xml.
- robots.txtĐọc trước tiên, kèm ý nghĩa của nó
- Sitemaprobots.txt, rồi tới các đường dẫn quen thuộc
- Tệp đã đọcChỉ mục và mười tệp của nó
- Đã kiểm traMọi quy tắc, đối chiếu với robots.txt
Cách xem sitemap của website và kiểm tra sitemap XML
Hãy nhập tên miền của bạn ở trên rồi chọn Kiểm tra sitemap: chúng tôi đọc robots.txt, tìm tệp mà nó nêu, đọc tệp đó cùng tối đa mười tệp của nó và tải một loạt URL rải đều, rồi cho thấy công cụ tìm kiếm sẽ hiểu tất cả những thứ đó ra sao.
Bạn có thể nhập một tên miền trần hoặc chính địa chỉ của tệp. Từ một tên miền, chúng tôi lấy các dòng Sitemap: trong robots.txt trước, rồi thử các đường dẫn quen thuộc; từ một địa chỉ, chúng tôi đọc đúng thứ bạn đưa. Dù cách nào thì cả tệp đều được đọc, không chỉ một trăm URL đầu tiên, cùng tối đa mười tệp của một chỉ mục sitemap.
Bốn điều quyết định một sitemap có làm đúng việc của nó không: tệp phân tích được, nằm trong giới hạn của giao thức, không có gì trong đó mâu thuẫn với robots.txt hay với noindex của chính các trang, và các ngày trong đó có ý nghĩa. Các khung ở trên bao quát cả bốn: Tệp và Vấn đề cho định dạng và giới hạn, robots.txt và Trang mẫu cho các mâu thuẫn, và URL cho các ngày.
200sitemap_index.xml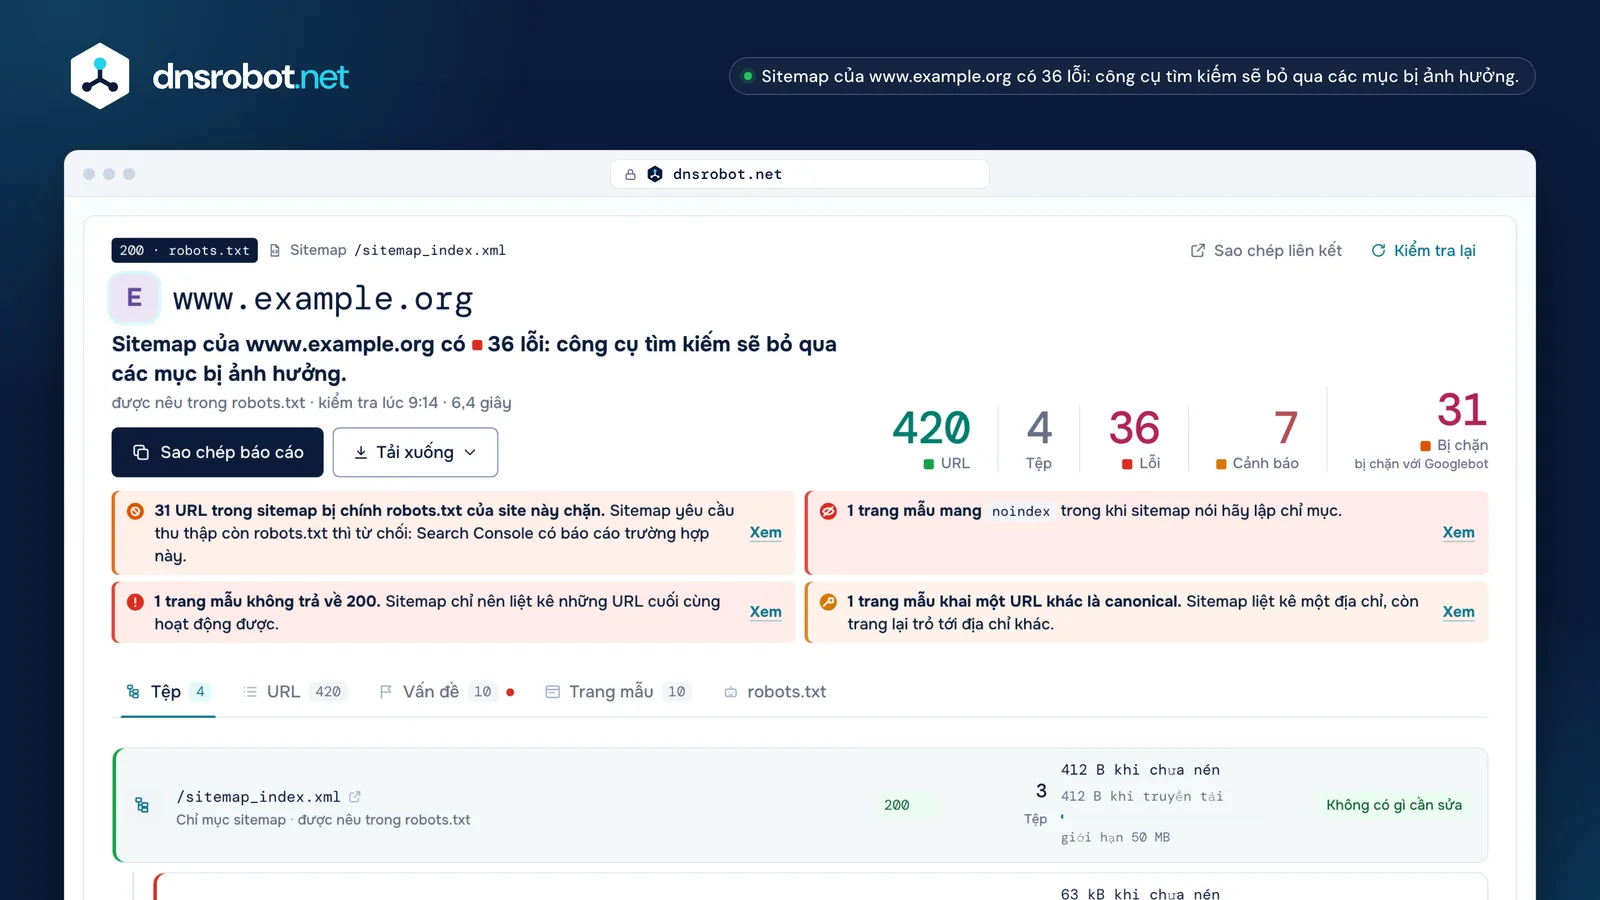
 Kết luậnĐiều sai trong sitemap này gói trong một câu, cùng năm con số làm nên nó: URL, tệp, lỗi, cảnh báo và số URL bị robots.txt từ chối.robots.txt và hệ quả của nóKhông chỉ mã trạng thái, mà ý nghĩa của mã đó với toàn bộ site. 4xx nghĩa là mọi thứ đều được phép thu thập; 5xx nghĩa là không được thu thập gì.Mọi tệp của chỉ mụcMỗi tệp kèm số URL nó chứa, kích thước sau giải nén so với giới hạn 50 MB, kích thước truyền tải bên cạnh, và các phát hiện riêng của nó.Các mâu thuẫnNhững URL sitemap yêu cầu công cụ tìm kiếm thu thập trong khi robots.txt từ chối, và các trang mẫu mang noindex hoặc khai URL khác là canonical.
Điều gì khiến một sitemap không hợp lệ
Sitemap không hợp lệ khi trình phân tích không đọc được nó: một dấu & trần, sai phần tử gốc, thiếu namespace, URL tương đối, hoặc khoảng trắng in ra trước phần khai báo XML. Mọi thứ khác là cảnh báo, không phải lý do bị từ chối.
Phổ biến nhất là dấu & chưa thoát. XML đọc & là phần mở đầu của một tham chiếu ký tự, nên chỉ một dấu trần thôi cũng kết thúc tệp đối với trình phân tích, và mọi thứ sau nó không được đọc. Hãy viết nó thành &, và thoát <, >, " và ' theo cách tương tự (sitemaps.org). Một <loc> phải là URL đầy đủ, bắt đầu bằng giao thức và ngắn hơn 2.048 ký tự.
Namespace phải chính xác là http://www.sitemaps.org/schemas/sitemap/0.9, với http:// kể cả trên site https: đó là một cái tên dành cho trình phân tích, không phải địa chỉ để ai đó tải về. Tệp phải là UTF-8, và không có gì, kể cả một dòng trống, được đứng trước <?xml; dấu thứ tự byte (BOM) của UTF-8 là thứ duy nhất được phép ở đó.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Một dòng trống trước phần khai báo
- 2Namespace phải đúng chuỗi này, với http://
- 3Một dấu & trần kết thúc tệp đối với trình phân tích
- 4Đường dẫn không phải URL: phải bắt đầu bằng giao thức
- 5Giờ cần có múi giờ, hoặc bỏ hẳn phần giờ
Lỗi sitemap trong Search Console, và ý nghĩa của từng lỗi
Google Search Console gán cho mỗi sitemap một trong ba trạng thái — Thành công, Có lỗi hoặc Không thể tìm nạp — chỉ cho các tài sản đã xác minh, và không cho bạn biết dòng nào sai. Trang này kiểm tra mọi sitemap công khai và chỉ ra đúng dòng đó.
Không thể tìm nạp nghĩa là yêu cầu của Google không nhận về được một tệp đọc được: một 4xx hoặc 5xx, một chuỗi chuyển hướng, hết thời gian chờ, một tường lửa từ chối Google, hoặc một quy tắc robots.txt chặn chính đường dẫn của sitemap. Có lỗi nghĩa là tệp đã được đọc và có thứ gì đó trong đó vi phạm một quy tắc — hình bên cạnh liệt kê những thông báo bạn hay gặp nhất và dòng đứng sau mỗi thông báo.
Hai trong số đó nói về kích thước chứ không phải định dạng: một sitemap liệt kê hơn 50.000 URL, và một chỉ mục sitemap liệt kê hơn 50.000 sitemap (Google). Hãy chia một sitemap quá lớn thành nhiều tệp được liệt kê trong một chỉ mục; một chỉ mục quá lớn thì tách thành nhiều chỉ mục, mỗi chỉ mục gửi riêng. Một sitemap liệt kê URL bị robots.txt chặn cũng bị báo cáo, và đó là mâu thuẫn trong chính các tệp của bạn chứ không phải lỗi định dạng.
Ba trạng thái
Những thông báo bạn hay gặp nhất
- Không thể tìm nạpMột 4xx hoặc 5xx, một chuỗi chuyển hướng, một tường lửa, hoặc robots.txt chặn chính đường dẫn của sitemap.
- Có quá nhiều URLHơn 50.000 URL trong một sitemap: là lỗi, không phải cảnh báo. Hãy chia nhỏ dưới một chỉ mục.
- Lỗi phân tích cú phápThường là một dấu & trần bên trong URL. Hãy viết thành &.
- Ngày không hợp lệMột lastmod không theo W3C Datetime, hoặc có giờ mà không có múi giờ.
- URL không hợp lệMột dấu cách, dấu ngoặc kép hay ký tự khác mà URL không chứa được, hoặc một giao thức viết sai như htp://.
- Sơ đồ trang web chứa các URL bị tệp robots.txt chặnHai tệp mâu thuẫn nhau. Hãy quyết định bên nào đúng.
Chỉ tài sản đã xác minhSearch Console chỉ báo cáo sitemap cho tài sản bạn sở hữu. Trang này kiểm tra mọi sitemap công khai, và chỉ ra đúng dòng.
lastmod có phải trung thực không?
Có. Google sử dụng <lastmod> “nếu giá trị đó chính xác một cách nhất quán và có thể xác minh”, nên một ngày giống nhau trên mọi URL, hay một ngày đổi mỗi lần tệp được ghi ra, còn tệ hơn không có ngày nào — nó dạy Google bỏ qua thẻ này.
Mọi công cụ kiểm tra sitemap khác đều đọc định dạng của ngày: có phải W3C Datetime không, phần giờ có kèm múi giờ không. Định dạng là nửa dễ. Câu hỏi quyết định thẻ có tác dụng gì không là giá trị đó có đúng như nó tuyên bố không, và hai dấu hiệu lộ ra là một dấu thời gian duy nhất lặp lại trên mọi mục và một ngày lúc nào cũng là hôm nay. Bing cũng lên lịch thu thập theo lastmod và có thể bỏ qua những ngày lúc nào cũng là hiện tại.
Vì thế công cụ kiểm tra này báo các ngày là gì, chứ không chỉ cách chúng được viết: bao nhiêu mục có ngày, ngày cũ nhất và mới nhất, và chúng có phải là một giá trị lặp lại không. Bỏ <lastmod> là hợp lệ và không tốn gì; bịa ra một ngày thì làm mất uy tín của thẻ cho cả site. Hãy đánh dấu lần thay đổi đáng kể gần nhất — nội dung chính, dữ liệu có cấu trúc, các link — chứ không phải một năm bản quyền mới (Google).
Không có lastmod nàoHợp lệ. Không có gì để lên lịch, và cũng không có gì để nghi ngờ.
50.000 URL và 50 MB: khi nào cần chia nhỏ
Một sitemap chứa tối đa 50.000 URL và 50 MB khi chưa nén. Vượt quá giới hạn nào đến trước, hãy chia các URL ra nhiều tệp và liệt kê những tệp đó trong một chỉ mục sitemap, rồi gửi chỉ mục.
Giới hạn kích thước tính trên tệp sau giải nén, kể cả khi bạn phục vụ nó dưới dạng .xml.gz, vì thế công cụ kiểm tra này hiển thị kích thước chưa nén cùng kích thước truyền tải bên cạnh: một sitemap 30 KB phục vụ dạng gzip có thể chỉ còn 1,6 KB khi truyền, và con số đó không nói gì về giới hạn. Naver Search Advisor từ chối tệp lớn hơn 10 MB, nên một site tiếng Hàn có mức trần thấp hơn mức của giao thức.
Một chỉ mục có thể liệt kê tối đa 50.000 sitemap, chỉ gồm các tệp trên chính site của nó, và không bao giờ là một chỉ mục khác: chỉ mục lồng nhau sẽ không được đọc. Các bản thay thế ngôn ngữ viết bằng xhtml:link không tính vào 50.000. Công cụ kiểm tra này đọc chỉ mục và tối đa mười tệp của nó trong một lượt, mỗi tệp kèm số URL, kích thước và các phát hiện riêng.
6,2 MBKhi truyền tải812 kBgzip làm tệp nhỏ hơn khi gửi; giới hạn vẫn tính kích thước sau khi giải nén.sitemap_index.xmlChỉ mục không được nêu một chỉ mục khácrobots.txt và sitemap của bạn: những mâu thuẫn làm bạn mất trang
Sitemap yêu cầu công cụ tìm kiếm thu thập một danh sách URL; robots.txt cho chúng biết những gì không được thu thập. Khi hai bên bất đồng, robots.txt thắng và mục trong sitemap thành vô ích — và Search Console có báo cáo việc này.
Trạng thái của chính robots.txt là điều đầu tiên cần đọc, và hầu như không ai báo nó có nghĩa là gì. 4xx là “không khả dụng”: không có quy tắc nào, nên mọi thứ đều được phép thu thập. 5xx hoặc không có câu trả lời nào là “không truy cập được”, và khi đó một trình thu thập tuân theo RFC 9309 không được thu thập gì trên site; Google hiểu 429 theo cách tương tự. Cùng một tệp hỏng cho ra hai kết quả trái ngược, và một công cụ in “không có URL nào bị chặn” trên một robots.txt không đọc được là sai mỗi khi tệp đó trả về 5xx hoặc 429, hoặc không trả lời.
Sau đó là các mâu thuẫn bên trong một tệp hoạt động bình thường: URL mà sitemap liệt kê nhưng robots.txt chặn, và — dễ bỏ sót — chính đường dẫn của sitemap bị chặn, tức là công bố một tệp mà không trình thu thập nào được đọc. Chiều ngược lại thì rẻ và đáng làm: một dòng Sitemap: trong robots.txt không cần tài khoản ở đâu cả, và mọi trình thu thập đều đọc nó.
Mã trạng thái, và hệ quả của nó
Mâu thuẫn
/search/?q=pepperDisallow: /search/Mục đó chẳng có tác dụng gì, và Search Console có báo cáo
Và chính đường dẫn của sitemap bị chặn: một tệp được công bố mà không trình thu thập nào được đọc.
Những URL nào không nên có trong sitemap
Chỉ những URL canonical bạn muốn có trong kết quả tìm kiếm, mỗi trang một URL: các địa chỉ cuối cùng trả về 200, lập chỉ mục được và không bị robots.txt chặn. Chuyển hướng, trang noindex, URL có canonical trỏ nơi khác, lỗi và các biến thể tham số đều không thuộc về sitemap.
Một sitemap liệt kê URL chuyển hướng khiến trình thu thập phải đi thêm một bước không cần thiết, và Google yêu cầu liệt kê URL đích cuối cùng của chuyển hướng thay vào đó. Một trang noindex trong sitemap là mâu thuẫn rõ ràng: tệp nói “hãy lập chỉ mục trang này”, trang nói “đừng”. Trang thắng, và mục đó chẳng có tác dụng gì.
Không điều nào trong số này là chết người — mọi URL trong sitemap chỉ là gợi ý, và Google vẫn tự quyết định lập chỉ mục gì — nhưng mỗi mục sai là một mục mà công cụ tìm kiếm học cách xem nhẹ. Đó là lý do công cụ kiểm tra này tải một loạt URL rải đều thay vì chỉ phân tích tệp: phân tích không thể cho bạn biết một trang được liệt kê giờ đang trả về 404.
/shop/raised-beds/Hợp lệĐược lập chỉ mục như đã liệt kê/shop/raised-bed/Chuyển hướngvô ích/shop/?sort=priceCanonical trỏ nơi khácvô ích/tags/autumn/noindexvô ích/shop/old-kit/404vô ích/search/?q=pepperBị chặnvô íchMục hình ảnh, video và hreflang
Một mục <url> có thể mang nhiều hơn một địa chỉ: hình ảnh của trang, các phiên bản ở ngôn ngữ khác, và siêu dữ liệu video hay tin tức, mỗi loại trong namespace riêng bên trong mục đó.
Hình ảnh dùng namespace hình ảnh của Google, tối đa 1.000 ảnh mỗi trang; chỉ <image:image> và <image:loc> còn có giá trị, còn caption, title, license và geo_location đã bị loại bỏ năm 2022. Công cụ kiểm tra này đếm các mục hình ảnh nó tìm thấy và hiển thị chúng theo từng URL.
Phiên bản ngôn ngữ dùng xhtml:link kèm một mã hreflang: một ngôn ngữ ISO 639-1 với vùng ISO 3166-1 tùy chọn, không bao giờ chỉ có vùng. Mỗi phiên bản của một trang phải liệt kê mọi phiên bản khác, kể cả chính nó, nếu không Google sẽ bỏ qua cả cụm. Bản thay thế không tính vào giới hạn 50.000 URL, nên liệt kê mười hai phiên bản ngôn ngữ trong mỗi mục không nhân số lượng lên mười hai lần.
https://www.example.org/guides/raised-beds/2026-09-143tối đa 1.000 mỗi trangen · de · frmỗi phiên bản liệt kê mọi phiên bản, kể cả chính nóBản thay thế không tính vào 50.000
Công cụ tìm kiếm đọc sitemap của bạn thường xuyên đến mức nào?
Google đọc sitemap theo lịch riêng mà họ không công bố: gửi sitemap là một gợi ý, không phải mệnh lệnh. Bing đọc sitemap ngay khi tìm thấy và sau đó thường ít nhất mỗi ngày một lần. Không bên nào đọc lại tệp thường xuyên hơn chỉ vì bạn yêu cầu.
Các lượt ping ẩn danh ngày trước đã không còn: Bing tắt bing.com/ping ngày 13 tháng 5 năm 2022 và Google thông báo vào tháng 6 năm 2023 rằng lượt ping của họ sẽ ngừng hoạt động; giờ nó trả về 404. Công cụ nào vẫn mời bạn “ping Google” thì chẳng làm được gì cả.
Điều thật sự giúp lần thu thập tiếp theo của một trang vừa thay đổi đến sớm hơn là một lastmod chính xác, cũng chính là lý do sự trung thực của thẻ này quan trọng, và IndexNow cho từng URL thay đổi — một lần gửi tới được Bing, Yandex, Naver, Seznam và những bên khác, dù không có Google. Gửi lại thủ công một sitemap không thay đổi chẳng đạt được gì.
Một lastmod chính xác giúp lần thu thập tiếp theo của trang vừa thay đổi đến sớm hơn
Bạn có thật sự cần một sitemap không?
Một site nhỏ mà các trang đều liên kết với nhau thì có thể không cần: Google đưa ra con số khoảng 500 trang trở xuống. Site lớn, site mới có ít link từ nơi khác, và site có nhiều hình ảnh hay video là được lợi nhiều nhất.
Chính hướng dẫn khởi đầu của Google gọi sitemap là tùy chọn, và gửi một sitemap là gợi ý chứ không phải chỉ thị: nó không làm trang được xếp hạng và không bảo đảm việc lập chỉ mục. Điều nó làm là bảo đảm trình thu thập biết một URL tồn tại, việc quan trọng nhất với những trang mà link của chính bạn không dẫn tới.
Nếu đã có sitemap, nó đáng được làm cho đúng. Một sitemap đầy chuyển hướng, trang noindex và URL bị robots.txt chặn không hề trung lập — đó là một danh sách mà công cụ tìm kiếm học cách ít tin hơn. Kiểm tra nó mất một phút; dựng một sitemap mới từ chính site của bạn chỉ cần một lượt thu thập.
Nguồn
- Giao thức sitemaps.org và phần hỏi đáp của nó: định dạng, các thẻ bắt buộc và tùy chọn, giới hạn 50.000 / 50 MB, chỉ mục và quy tắc vị trí
- Google Search Central: dựng một sitemap, sitemap lớn, báo cáo Sơ đồ trang web và các lỗi của nó, phiên bản theo ngôn ngữ và lastmod cùng lượt ping đã ngừng
- Bing: thẻ lastmod (2023), sitemap trong tìm kiếm có AI (2025) và lượt ping đã gỡ bỏ (2022)
- RFC 9309, chuẩn robots.txt: 4xx và 5xx có ý nghĩa gì với trình thu thập
- Naver Search Advisor: feed và IndexNow
- site lớn
- site mới, ít link từ nơi khác
- nhiều hình ảnh hoặc video
- trang không link nội bộ nào dẫn tới
Câu hỏi thường gặp về kiểm tra sitemap
Làm sao kiểm tra sitemap XML của tôi có hợp lệ không?
Những lỗi sitemap phổ biến nhất là gì?
Vì sao Search Console báo “Không thể tìm nạp”?
URL trong sitemap bị robots.txt chặn có phải là vấn đề không?
lastmod có phải chính xác không?
Một sitemap chứa được bao nhiêu URL?
Google có dùng priority và changefreq không?
Công cụ kiểm tra sitemap này có miễn phí không, và có giới hạn URL không?
Công cụ này khác Google Search Console thế nào?
Chỉ mục sitemap là gì, và nó có được nêu một chỉ mục khác không?
Sitemap của tôi có bắt buộc phải được nêu trong robots.txt không?
Sitemap có khiến trang của tôi được lập chỉ mục không?
Còn thiếu điều gì?Đề xuất tính năng hoặc công cụ mới
Thêm công cụ thu thập dữ liệu và SEO
Kiểm Tra Robots.txt
Tải robots.txt của bất kỳ website nào, test xem URL có bị chặn với Googlebot hoặc crawler AI không và tìm lỗi cú pháp
Tạo Sitemap
Thu thập dữ liệu website và nhận sitemap XML, sitemap HTML và cây cấu trúc site
Phân Tích Liên Kết
Phân tích tất cả liên kết trên trang web với phát hiện dofollow/nofollow và kiểm tra trạng thái HTTP
Kiểm tra Redirect
Kiểm tra chuyển hướng URL, chuỗi chuyển hướng và mã trạng thái HTTP cho SEO
Kiểm tra HTTP Header
Phân tích header phản hồi HTTP và chấm điểm header bảo mật
Kiểm Tra Website Sập
Web sập với mọi người hay chỉ mình bạn? Kiểm tra bất kỳ website nào từ 11 địa điểm và từ kết nối của bạn, kèm ảnh chụp màn hình trực tiếp
Check CMS Website
Website dùng CMS, theme, plugin và công nghệ gì, kèm bằng chứng cho từng mục