











Sprawdzanie sitemap XML
Wklej domenę albo adres pliku sitemap i zobacz pełny obraz: każdy plik w indeksie, każdą regułę protokołu, adresy, które wyszukiwarki odrzucą, razem z powodem, i to, czy daty w pliku coś znaczą.
Wystarczy domena: czytamy robots.txt i zaglądamy w typowe miejsca. Możesz też podać sam plik, np. example.com/sitemap.xml.
- robots.txtCzytamy go najpierw i wyjaśniamy skutki
- Sitemaprobots.txt, potem typowe ścieżki
- Odczytane plikiIndeks i dziesięć jego plików
- SprawdzonoKażda reguła, w zestawieniu z robots.txt
Jak sprawdzić sitemap XML
Wpisz powyżej swoją domenę i wybierz „Sprawdź sitemap”: czytamy robots.txt, znajdujemy wskazany w nim plik, czytamy go razem z maksymalnie dziesięcioma plikami, które on wymienia, i pobieramy adresy URL z różnych części pliku, a potem pokazujemy, co zrobiłaby z tym wszystkim wyszukiwarka.
Możesz podać samą domenę albo adres samego pliku. Przy domenie najpierw bierzemy wiersze Sitemap: z robots.txt, a potem sprawdzamy typowe ścieżki; przy adresie czytamy dokładnie ten plik. Tak czy inaczej czytamy cały plik, a nie pierwszych sto adresów URL, a razem z nim do dziesięciu plików indeksu sitemap.
O tym, czy sitemap spełnia swoje zadanie, decydują cztery rzeczy: plik się parsuje, mieści się w limitach protokołu, nic w nim nie przeczy robots.txt ani noindex samych stron, a jego daty coś znaczą. Obejmują je widoki powyżej: Pliki i Problemy — format i limity, robots.txt i Próbka stron — sprzeczności, a Adresy URL — daty.
200sitemap_index.xml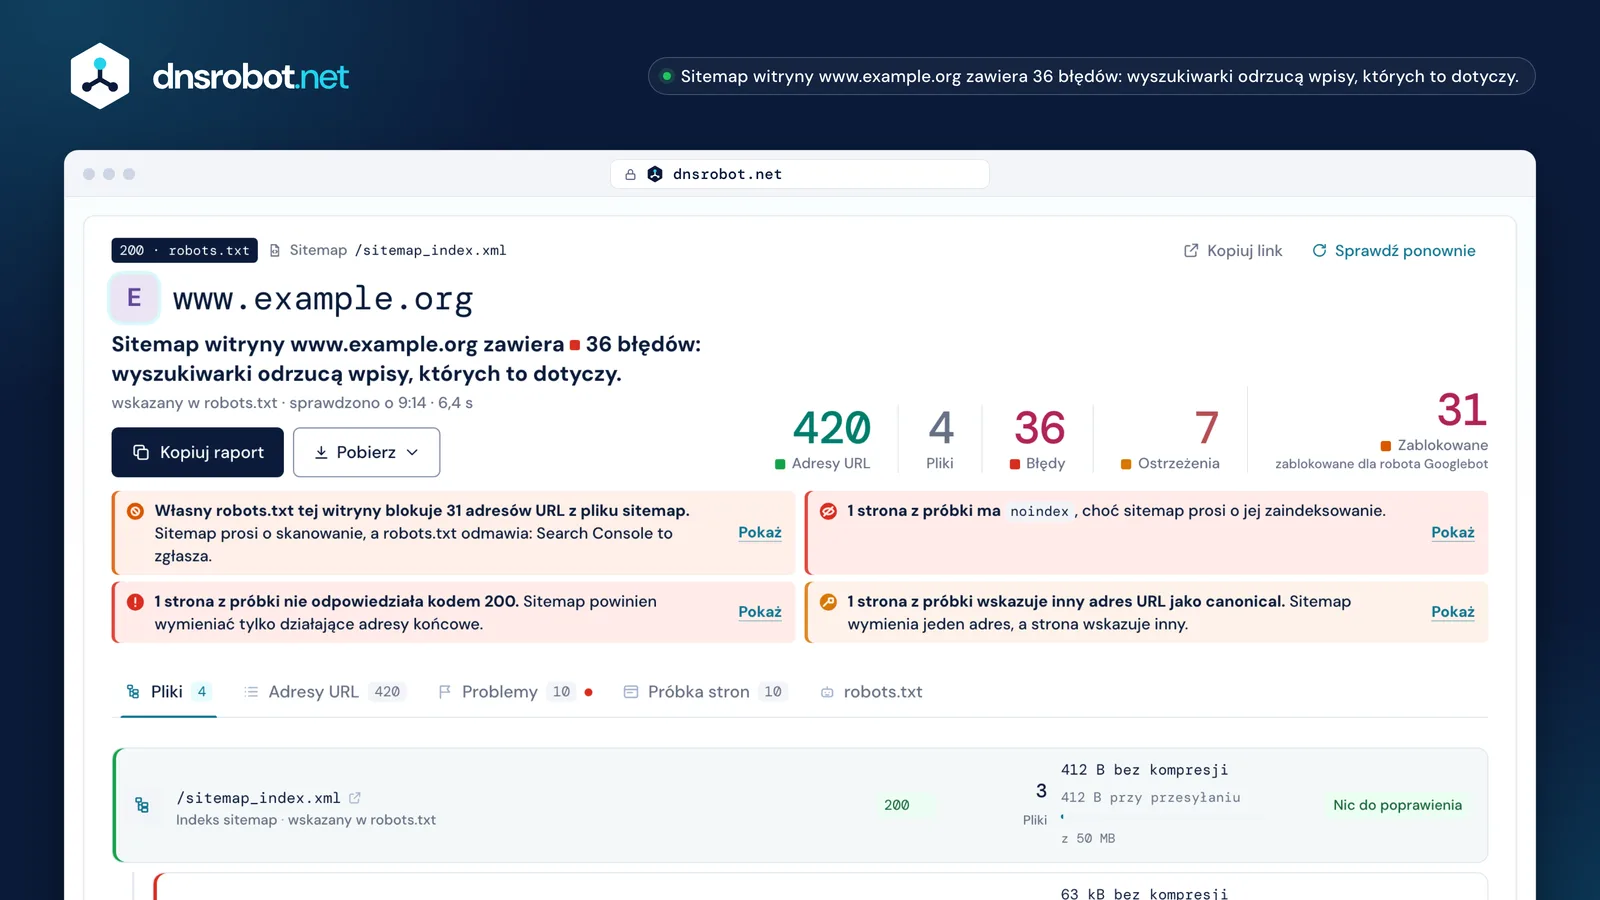
 WerdyktCo jest nie tak z tym plikiem sitemap — w jednym zdaniu, z pięcioma liczbami, które to pokazują: adresy URL, pliki, błędy, ostrzeżenia i adresy, na które robots.txt nie pozwala.robots.txt i jego skutkiNie tylko kod stanu, ale to, co oznacza dla całej witryny. Przy 4xx wolno skanować wszystko, przy 5xx — nic.Każdy plik indeksuKażdy plik z liczbą adresów URL, rozmiarem po rozpakowaniu na tle limitu 50 MB, rozmiarem przy przesyłaniu obok i własnymi problemami.SprzecznościAdresy URL, które sitemap każe wyszukiwarkom skanować, choć robots.txt na to nie pozwala, oraz strony z próbki, które mają noindex albo wskazują inny adres URL jako canonical.
Co sprawia, że sitemap jest nieprawidłowy
Sitemap jest nieprawidłowy, gdy parser nie może go odczytać: przez & bez encji, zły element główny, brak przestrzeni nazw, względny adres URL albo odstęp przed deklaracją XML. Cała reszta to ostrzeżenie, a nie odrzucenie.
Najczęstszy ze wszystkich jest ampersand bez encji. XML czyta & jako początek odwołania do znaku, więc jeden taki znak kończy plik dla parsera, a wszystko po nim zostaje nieodczytane. Zapisz go jako & i tak samo zamieniaj na encje <, >, " i ' (sitemaps.org). <loc> musi być pełnym adresem URL, który zaczyna się od protokołu i ma mniej niż 2048 znaków.
Przestrzeń nazw musi brzmieć dokładnie http://www.sitemaps.org/schemas/sitemap/0.9, z http:// nawet w witrynie na https: to nazwa dla parserów, a nie adres, który ktokolwiek pobiera. Plik musi być w UTF-8, a przed <?xml nie może stać nic, nawet pusty wiersz; jedyne, co wolno tam umieścić, to znacznik kolejności bajtów UTF-8.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Pusty wiersz przed deklaracją
- 2Przestrzeń nazw musi być dokładnie tym ciągiem, z http://
- 3Goły & kończy plik dla parsera
- 4Ścieżka to nie adres URL: musi zaczynać się od protokołu
- 5Godzina wymaga strefy czasowej — albo pomiń godzinę
Błędy sitemap w Search Console i co oznacza każdy z nich
Google Search Console nadaje plikowi sitemap jeden z trzech stanów — Sukces, Zawiera błędy lub Nie udało się pobrać — tylko w zweryfikowanych usługach i nie mówi, który wiersz jest błędny. Ta strona sprawdza każdy publiczny plik sitemap i wskazuje wiersz.
Nie udało się pobrać (na stronie szczegółów: „Nie udało się odczytać mapy witryny”) oznacza, że żądanie Google nie wróciło z plikiem, który da się odczytać: 4xx lub 5xx, łańcuch przekierowań, przekroczony czas oczekiwania, firewall odrzucający Google albo reguła w robots.txt blokująca ścieżkę samego pliku sitemap. Zawiera błędy oznacza, że plik odczytano, ale coś w nim narusza regułę — rysunek obok wymienia komunikaty, które najczęściej zobaczysz, i wiersz, który stoi za każdym z nich.
Dwa z nich dotyczą rozmiaru, a nie formatu: plik sitemap, który wymienia ponad 50 000 adresów URL, i indeks sitemap, który wymienia ponad 50 000 plików sitemap (Google). Zbyt duży plik sitemap podziel na pliki wymienione w indeksie; zbyt duży indeks staje się kilkoma indeksami, a każdy z nich zgłaszasz osobno. Zgłaszany jest też plik sitemap z adresami URL, które blokuje robots.txt, i to już sprzeczność w twoich własnych plikach, a nie błąd formatu.
Trzy stany
Komunikaty, które zobaczysz najczęściej
- Nie udało się odczytać mapy witryny4xx lub 5xx, łańcuch przekierowań, firewall albo robots.txt blokujący ścieżkę samego pliku sitemap.
- Zbyt wiele adresów URLPonad 50 000 adresów URL w jednym pliku sitemap: błąd, a nie ostrzeżenie. Podziel plik i wymień części w indeksie.
- Błąd analizy składniCzęsto goły & w adresie URL. Zapisz go jako &.
- Nieprawidłowa datalastmod, który nie jest w formacie W3C Datetime, albo godzina bez strefy czasowej.
- Nieprawidłowy URLSpacja, cudzysłów lub inny znak, którego adres URL nie może zawierać, albo zepsuty schemat, np. htp://.
- Mapa witryny zawiera URL-e blokowane przez plik robots.txtTe dwa pliki są ze sobą sprzeczne. Zdecyduj, który ma rację.
Tylko zweryfikowane usługiSearch Console pokazuje sitemap tylko dla usługi, której jesteś właścicielem. Ta strona sprawdza każdy publiczny plik sitemap i wskazuje wiersz.
Czy lastmod musi być uczciwy?
Tak. Google używa wartości <lastmod>, „jeśli jest ona spójna i zweryfikowana”, więc data, która jest taka sama przy każdym adresie URL albo zmienia się przy każdym zapisie pliku, jest gorsza niż brak daty — uczy Google ignorować ten tag.
Każde inne narzędzie do sprawdzania sitemap czyta format daty: czy to W3C Datetime i czy godzina ma strefę czasową. Format to łatwiejsza połowa. O tym, czy tag cokolwiek daje, decyduje to, czy wartość znaczy to, co twierdzi, a dwa sygnały ostrzegawcze to jeden stempel powtórzony w każdym wpisie i data, która zawsze jest dzisiejsza. Bing też planuje skanowanie według lastmod i może pomijać daty, które zawsze są bieżące.
Dlatego to narzędzie pokazuje, czym są daty, a nie tylko, jak są zapisane: ile wpisów je ma, najstarszą i najnowszą oraz to, czy to jedna powtarzana wartość. Pominięcie <lastmod> jest poprawne i nic nie kosztuje; wymyślona data kosztuje ten tag wiarygodność w całej witrynie. Oznaczaj ostatnią istotną zmianę — treści głównej, danych strukturalnych, linków — a nie nowy rok w nocie o prawach autorskich (Google).
Brak lastmodPoprawne. Nie ma na czym oprzeć planu, ale też nie ma czemu nie wierzyć.
50 000 adresów URL i 50 MB: kiedy dzielić plik
Jeden plik sitemap może zawierać najwyżej 50 000 adresów URL i 50 MB bez kompresji. Po przekroczeniu tego z limitów, który wypadnie pierwszy, rozłóż adresy na kilka plików, wymień je w indeksie sitemap, a potem zgłoś indeks.
Limit rozmiaru liczy plik po rozpakowaniu, nawet gdy serwujesz go jako .xml.gz, dlatego to narzędzie pokazuje rozmiar bez kompresji, a obok rozmiar przy przesyłaniu: sitemap o wielkości 30 KB serwowany z kompresją gzip może mieć przy przesyłaniu 1,6 KB, a ta liczba nic nie mówi o limicie. Naver Search Advisor odrzuca pliki większe niż 10 MB, więc koreańska witryna ma niższy pułap niż ten z protokołu.
Indeks może wymieniać do 50 000 plików sitemap, tylko z własnej witryny, i nigdy innego indeksu: zagnieżdżony indeks nie jest czytany. Wersje językowe zapisane przez xhtml:link nie liczą się do 50 000. To narzędzie czyta w jednym przebiegu indeks i do dziesięciu jego plików, każdy z własną liczbą adresów, rozmiarem i problemami.
6,2 MBPrzy przesyłaniu812 kBgzip zmniejsza plik do wysłania; limit i tak liczy rozmiar po rozpakowaniu.sitemap_index.xmlIndeks nie może wskazywać innego indeksurobots.txt i twój sitemap: sprzeczności, które kosztują cię strony
Twój sitemap prosi wyszukiwarki o skanowanie listy adresów URL; robots.txt mówi im, czego skanować nie wolno. Gdy te dwa pliki się nie zgadzają, wygrywa robots.txt, a wpis w pliku sitemap się marnuje — i Search Console to zgłasza.
Pierwsza rzecz do odczytania to kod stanu samego robots.txt, a prawie nikt nie mówi, co on oznacza. Kod 4xx to „niedostępny”: nie ma reguł, więc wolno skanować wszystko. Kod 5xx albo brak jakiejkolwiek odpowiedzi to „nieosiągalny” i robot zgodny z RFC 9309 nie może wtedy skanować w witrynie niczego; Google tak samo traktuje 429. Ten sam zepsuty plik prowadzi do przeciwnych skutków, a narzędzie, które nad nieodczytanym robots.txt pisze „żaden adres URL nie jest zablokowany”, myli się za każdym razem, gdy plik odpowiedział kodem 5xx lub 429 albo w ogóle nie odpowiedział.
Potem przychodzą sprzeczności w działającym pliku: adresy URL, które sitemap wymienia, a robots.txt blokuje, oraz — łatwa do przeoczenia — zablokowana ścieżka samego pliku sitemap, czyli opublikowany plik, którego żaden robot nie może odczytać. W drugą stronę jest tanio i warto: wiersz Sitemap: w robots.txt nie wymaga konta w żadnej usłudze, a czyta go każdy robot.
Kod stanu i jego skutek
Sprzeczność
/search/?q=pepperDisallow: /search/Wpis nic nie daje, a Search Console go zgłasza
A do tego zablokowana ścieżka samego pliku sitemap: opublikowany plik, którego żaden robot nie może odczytać.
Których adresów URL nie powinno być w pliku sitemap
Powinny tam być tylko kanoniczne adresy URL, które chcesz widzieć w wynikach wyszukiwania, po jednym na stronę: adresy końcowe, które odpowiadają kodem 200, są indeksowalne i nie są blokowane przez robots.txt. Przekierowania, strony z noindex, adresy z canonical wskazującym gdzie indziej, błędy i warianty z parametrami nie mają tam czego szukać.
Sitemap, który wymienia przekierowujący adres URL, każe robotowi zrobić jeden krok więcej, niż było trzeba, a Google prosi zamiast tego o adres, na którym kończy się przekierowanie. Strona z noindex w pliku sitemap to czysta sprzeczność: plik mówi „zaindeksuj to”, a strona „nie indeksuj”. Strona wygrywa, a wpis nic nie daje.
Nic z tego nie jest fatalne — każdy adres URL w pliku sitemap to sugestia, a o indeksowaniu i tak decyduje Google — ale każdy błędny wpis to taki, któremu wyszukiwarka uczy się mniej ufać. Dlatego to narzędzie pobiera adresy URL z różnych części pliku, zamiast tylko go parsować: samo parsowanie nie powie ci, że wymieniona strona odpowiada teraz kodem 404.
/shop/raised-beds/PoprawnyZaindeksowany tak, jak w pliku/shop/raised-bed/Przekierowaniezmarnowany/shop/?sort=priceCanonical gdzie indziejzmarnowany/tags/autumn/noindexzmarnowany/shop/old-kit/404zmarnowany/search/?q=pepperZablokowanyzmarnowanyWpisy obrazów, filmów i hreflang
Wpis <url> może zawierać więcej niż adres: obrazy strony, jej wersje w innych językach oraz metadane filmów lub wiadomości, każde we własnej przestrzeni nazw wewnątrz tego wpisu.
Obrazy korzystają z przestrzeni nazw Google dla obrazów, do 1000 na stronę; liczą się już tylko <image:image> i <image:loc>, a caption, title, license i geo_location zostały wycofane w 2022 roku. To narzędzie liczy znalezione wpisy obrazów i pokazuje je przy każdym adresie URL.
Wersje językowe korzystają z xhtml:link z kodem hreflang: język w ISO 639-1 z opcjonalnym regionem w ISO 3166-1, nigdy sam region. Każda wersja strony musi wymieniać wszystkie pozostałe wersje, łącznie z samą sobą, inaczej Google ignoruje cały zestaw. Wersje językowe nie liczą się do limitu 50 000 adresów URL, więc wymienienie dwunastu wersji językowych w każdym wpisie nie mnoży liczby adresów przez dwanaście.
https://www.example.org/guides/raised-beds/2026-09-143do 1000 na stronęen · de · frkażda wersja wymienia wszystkie wersje, łącznie z samą sobąWersje językowe nie liczą się do 50 000
Jak często wyszukiwarki czytają twój sitemap?
Google czyta sitemap według własnego harmonogramu, którego nie publikuje: zgłoszenie to podpowiedź, a nie polecenie. Bing czyta go, gdy tylko go znajdzie, a potem zwykle co najmniej raz dziennie. Żadna z nich nie czyta pliku częściej tylko dlatego, że o to poprosisz.
Dawne anonimowe pingi zniknęły: Bing wyłączył bing.com/ping 13 maja 2022 roku, a Google ogłosił w czerwcu 2023 roku, że jego ping przestanie działać; dziś odpowiada 404. Narzędzie, które nadal proponuje „pingowanie Google”, nie robi zupełnie nic.
Następne skanowanie zmienionej strony naprawdę przyspiesza dokładny lastmod — i właśnie dlatego uczciwość tego tagu ma znaczenie — oraz IndexNow dla pojedynczych zmienionych adresów URL: jedno zgłoszenie dociera do Bing, Yandex, Naver, Seznam i innych, choć nie do Google. Ręczne ponowne zgłaszanie niezmienionego pliku sitemap nic nie daje.
Dokładny lastmod przyspiesza następne skanowanie zmienionej strony
Czy w ogóle potrzebujesz pliku sitemap?
Mała witryna, której wszystkie strony linkują do siebie nawzajem, może się bez niego obejść: Google podaje próg około 500 stron lub mniej. Najwięcej zyskują duże witryny, nowe witryny z niewieloma linkami z zewnątrz oraz witryny z wieloma obrazami lub filmami.
Własny przewodnik startowy Google nazywa sitemap opcjonalnym, a jego zgłoszenie jest podpowiedzią, a nie poleceniem: nie daje stronie pozycji w wynikach i nie gwarantuje indeksowania. Daje za to pewność, że robot wie o istnieniu adresu URL, co najbardziej liczy się przy stronach, do których nie docierają twoje własne linki.
Jeśli go masz, warto, żeby był poprawny. Sitemap pełen przekierowań, stron z noindex i adresów URL blokowanych przez robots.txt nie jest neutralny — to lista, której wyszukiwarka uczy się ufać coraz mniej. Sprawdzenie zajmuje minutę; zbudowanie nowego z twojej własnej witryny wymaga jednego skanowania.
Źródła
- Protokół sitemaps.org i jego FAQ: format, tagi wymagane i opcjonalne, limity 50 000 / 50 MB, indeks i reguła lokalizacji pliku
- Google Search Central: budowa pliku sitemap, duże pliki sitemap, raport Mapy witryn i jego błędy, wersje zlokalizowane oraz lastmod i wycofany ping
- Bing: tag lastmod (2023), pliki sitemap w wyszukiwaniu z AI (2025) i usunięty ping (2022)
- RFC 9309, standard robots.txt: co oznaczają dla robota kody 4xx i 5xx
- Naver Search Advisor: kanały i IndexNow
- duże witryny
- nowe witryny z niewieloma linkami z zewnątrz
- dużo obrazów lub filmów
- strony, do których nie prowadzi żaden link wewnętrzny
Sprawdzanie sitemap: pytania i odpowiedzi
Jak sprawdzić, czy mój sitemap XML jest poprawny?
Jakie są najczęstsze błędy w plikach sitemap?
Dlaczego Search Console pokazuje „Nie udało się pobrać”?
Czy to problem, gdy adres URL z mojego pliku sitemap jest zablokowany w robots.txt?
Czy lastmod musi być dokładny?
Ile adresów URL może mieć jeden plik sitemap?
Czy Google używa priority i changefreq?
Czy to sprawdzanie sitemap jest darmowe i czy ma limit adresów URL?
Czym to narzędzie różni się od Google Search Console?
Czym jest indeks sitemap i czy może wskazywać inny indeks?
Czy mój sitemap musi być wpisany do robots.txt?
Czy sitemap sprawi, że moje strony zostaną zaindeksowane?
Czegoś brakuje?Zaproponuj funkcję lub nowe narzędzie
Więcej narzędzi do skanowania i SEO
Tester Robots.txt
Pobierz robots.txt dowolnej witryny, sprawdź, czy URL jest zablokowany dla Googlebot lub crawlerów AI, i znajdź błędy składni
Generator Mapy Strony
Przeskanuj swoją stronę i pobierz sitemap XML, mapę strony HTML oraz wizualne drzewo witryny
Analiza Linków
Analizuj wszystkie linki na stronie z wykrywaniem dofollow/nofollow i sprawdzaniem statusu HTTP
Sprawdzanie Przekierowań
Sprawdź przekierowania URL, łańcuchy przekierowań i kody statusu HTTP dla SEO
Sprawdzanie Nagłówków HTTP
Analizuj nagłówki odpowiedzi HTTP i ocenę nagłówków bezpieczeństwa
Czy strona działa?
Awaria dla wszystkich czy tylko u Ciebie? Sprawdź dowolną stronę z 11 miejsc i ze swojego łącza, ze zrzutem ekranu na żywo
Detektor CMS
Jaki CMS, motyw, wtyczki i technologie ma strona, z dowodem dla każdego