











Tester robots.txt
Ten test robots.txt pokazuje wszystko, na czym opiera wynik: regułę, która zdecydowała o twoim adresie URL, z numerem wiersza; grupę, którą robot naprawdę przeczytał, i powód, dla którego pominął pozostałe; oraz to, co kod stanu twojego pliku oznacza dla całej witryny. Sprawdź robots.txt, zamiast zgadywać.
Wpisz domenę, żeby przeczytać jej plik, albo pełny adres, np. example.com/admin/, żeby od razu przetestować też tę ścieżkę.
- PobranieGET /robots.txt
- Odczytgrupy, reguły, pliki sitemap
- Grupaktórych reguł przestrzega robot
- Werdyktco może skanować każdy robot
Jak sprawdzić robots.txt, gdy testera Google już nie ma
Wpisz domenę powyżej i wybierz „Sprawdź robots.txt”. Pobieramy plik raz, z naszego serwera, a potem w twojej przeglądarce testujemy względem niego każdy wpisany adres URL, dla dowolnego wybranego robota — czyli robimy to, co robił tester robots.txt od Google, zanim go wycofano.
Google ogłosił zmianę 15 listopada 2023 roku: „W ramach tej aktualizacji wycofujemy tester robots.txt”. Starsze narzędzie zniknęło w grudniu 2023 roku, a raport dotyczący pliku robots.txt w Search Console, który je zastąpił, to coś zupełnie innego.
Ten raport pokazuje pliki, które Google już pobrał dla 20 głównych hostów w usłudze, której jesteś zweryfikowanym właścicielem, z datą sprawdzenia, rozmiarem w bajtach i liczbą problemów. Nie przetestuje adresu URL względem reguły, nie sprawdzi robota spoza Google i nie zajrzy do witryny, która nie jest twoja. Ta strona robi wszystkie trzy rzeczy.
- Plik, który Google ostatnio pobrał
- Jego rozmiar i data sprawdzenia
- Liczba problemów z parsowaniem
- Czy ten URL jest dozwolony dla tego robota?
- Która reguła o tym zdecydowała i w którym wierszu
- Robot spoza Google
- Witryna, która nie jest twoja
Google ogłosił zmianę 15 listopada 2023 roku i usunął tester w grudniu 2023 roku.
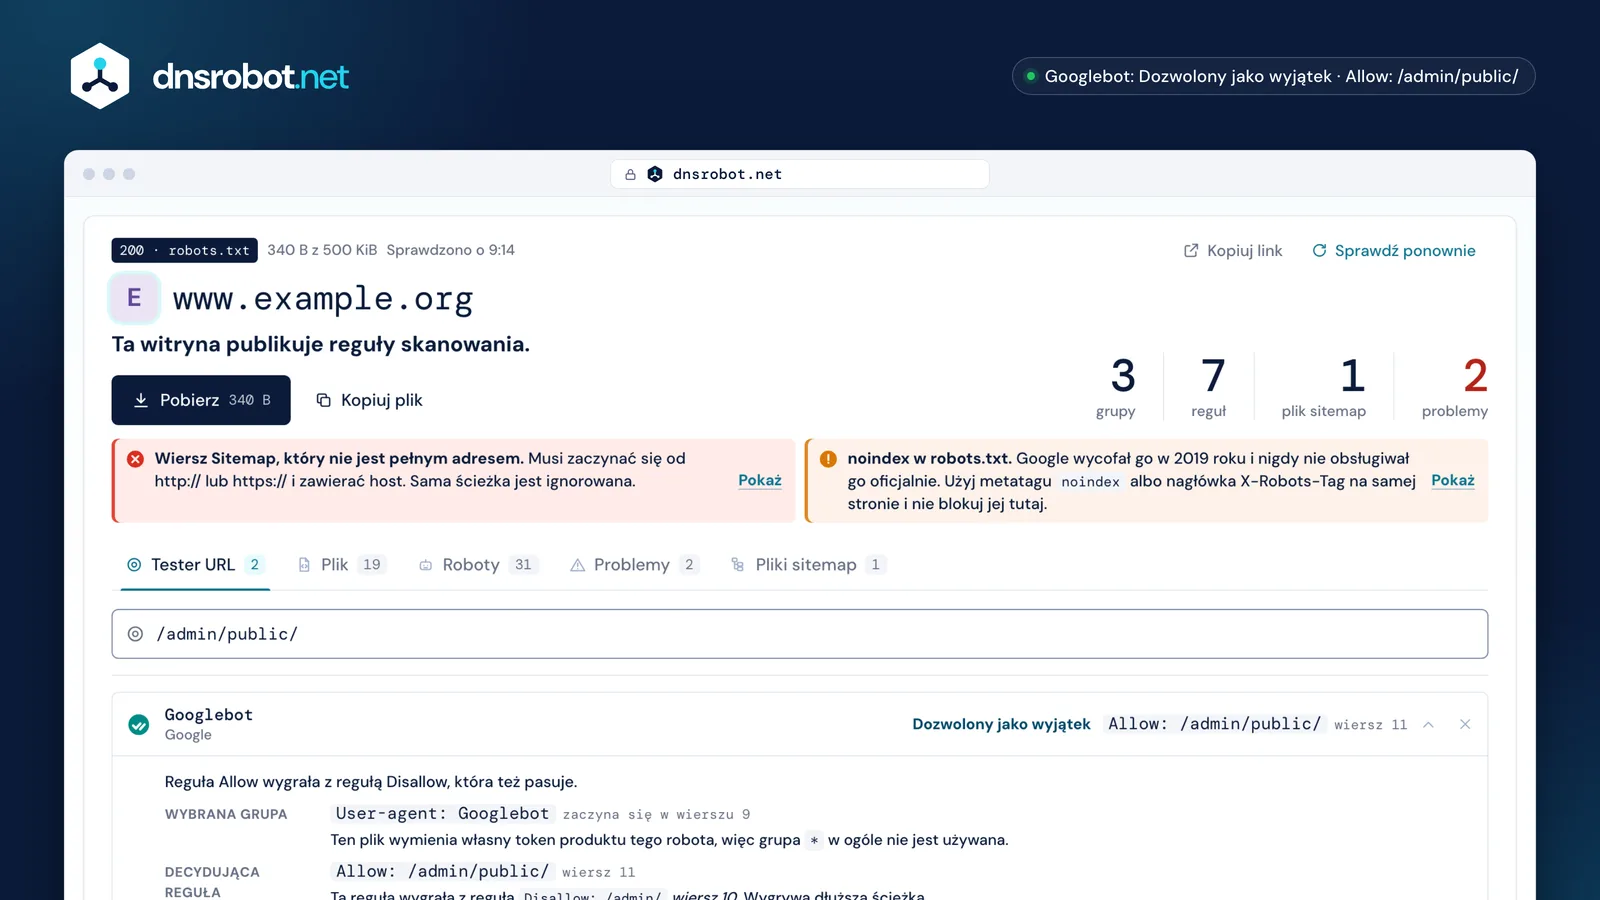
 KonsekwencjaNie sam kod stanu, tylko to, co oznacza dla całej witryny. 404 pozwala tu każdemu robotowi pobrać wszystko; 503 oznacza, że robot zgodny ze standardem nie pobiera niczego.Decydująca regułaReguła, która zdecydowała o tym adresie URL dla tego robota, z numerem wiersza i regułą, z którą wygrała. Wygrywa najdłuższe dopasowanie, a przy remisie wygrywa Allow.Wybrana grupaKtórą grupę robot naprawdę przeczytał i dlaczego pominął pozostałe. Tego kroku inne narzędzia nie pokazują.UwagiKażdy problem przy swoim wierszu pliku, razem z tym, co z nim zrobić.
Jak Google wybiera grupę, która obowiązuje robota?
Robot przestrzega dokładnie jednego zestawu reguł. Szuka grupy, której wiersz User-agent wymienia jego własny token produktu; dopiero gdy takiej nie ma, wraca do grupy oznaczonej *. Grupa * to rozwiązanie awaryjne, nigdy dodatek.
RFC 9309 mówi to wprost: „Roboty MUSZĄ stosować dopasowanie bez rozróżniania wielkości liter, aby znaleźć grupę pasującą do tokenu produktu” oraz „[jeśli] pasująca grupa nie istnieje, roboty MUSZĄ przestrzegać grupy z wierszem user-agent o wartości *, o ile taka jest”. Google mówi to samo własnymi słowami: „W przypadku konkretnego robota tylko jedna grupa jest prawidłowa”.
Wynikają z tego dwie rzeczy i razem odpowiadają za większość nieporozumień. Kilka grup wymieniających ten sam token łączy się w jedną, więc liczą się oba bloki User-agent: Googlebot. Ale grupa nazwana i grupa * nigdy się nie łączą: Allow: / pod * nic nie daje robotowi Googlebot, gdy tylko istnieje grupa Googlebot. Googlebot-Image i inne roboty Googlebot-* wracają do grupy googlebot, a to zachowanie, które robot dodaje ponad mechanizmem dopasowania — otwartoźródłowy mechanizm dopasowania od Google go nie implementuje.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Jakaś grupa wymienia własny token tego robota?Czyta tę grupę. Grupa
*nie jest używana. - 2Wymienia go kilka grup?Czyta je jako jedną grupę.
- 3Istnieje grupa
*?Czyta grupę*. - —Żadne reguły nie obowiązują. Wolno skanować wszystko.
Allow: / pod * nigdy nie jest czytane.
*.Allow czy Disallow: wygrywa najdłuższe dopasowanie
Gdy do adresu URL pasuje więcej niż jedna reguła, wygrywa ta z najdłuższą ścieżką, bez względu na jej rodzaj. Jeśli Allow i Disallow mają tę samą długość, wygrywa Allow.
RFC 9309: „Najbardziej szczegółowe znalezione dopasowanie MUSI zostać użyte. Najbardziej szczegółowe dopasowanie to to, które ma najwięcej oktetów” oraz „jeśli reguła allow i reguła disallow są równoważne, POWINNA zostać użyta reguła allow”. Google opisuje to samo zachowanie: przy sprzecznych regułach stosuje „regułę najmniej restrykcyjną”.
Oktety, a nie znaki: ścieżka z polskimi znakami albo z %2F jest porównywana po zakodowaniu procentowym i właśnie tu proste narzędzia się mylą. Porównywane są tylko ścieżka i ciąg zapytania, od pierwszego znaku, z rozróżnianiem wielkości liter, choć w nazwach dyrektyw wielkość liter nie ma znaczenia — Disallow: /File.pdf nie dotyczy /file.pdf.
/admin/report.pdfWygrywa Allow: dopasowuje większą część ścieżki.
Disallow: /files/7 znakówAllow: /files/7 znakówTa sama długość, więc wygrywa Allow: Google stosuje „regułę najmniej restrykcyjną”.
Jedyne dwa symbole wieloznaczne: `*` i `$`
* oznacza dowolny ciąg znaków, a $ koniec adresu URL. Nic więcej: żadnych wyrażeń regularnych i żadnego specjalnego znaczenia dla ?, ., [ ani +, które są zwykłymi znakami.
Reguła bez $ jest prefiksem, więc Disallow: /admin blokuje też /administrator i /admin-tools. Dodaj ukośnik na końcu (/admin/), gdy chodzi ci o katalog, a $, gdy chodzi dokładnie o ten adres. Disallow: /*.pdf$ blokuje każdy plik PDF; Disallow: /*? blokuje każdy adres URL z ciągiem zapytania.
Tester URL powyżej pokazuje ścieżki, które reguła obejmuje także, z tego samego mechanizmu dopasowania, który wydał werdykt, więc reguła sięgająca dalej, niż chciałeś, jest widoczna, zanim ją opublikujesz.
* i $ oraz to, co naprawdę obejmuje każdy wzorzec/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ i + to zwykłe znaki. W robots.txt nie ma wyrażeń regularnych.
Co oznacza kod stanu twojego robots.txt?
4xx i 5xx przy tym samym zepsutym pliku dają przeciwne skutki. 4xx jest traktowany tak, jakby pliku nie było, więc robot może pobrać wszystko. 5xx oznacza, że plik jest nieokreślony, więc robot zgodny ze standardem nie może pobrać niczego.
RFC 9309 §2.3.1.3: jeśli kod stanu mówi, że plik „jest niedostępny dla robota, robot MOŻE uzyskać dostęp do dowolnych zasobów na serwerze”. §2.3.1.4: jeśli „jest nieosiągalny z powodu błędów serwera lub sieci… robot MUSI przyjąć całkowity zakaz”. Google traktuje „wszystkie błędy 4xx oprócz 429 tak, jakby prawidłowy plik robots.txt nie istniał”, co stawia 429 po stronie 5xx.
Potem Google łagodzi przypadek 5xx własną drabiną: przez pierwsze 12 godzin przestaje skanować, przez kolejne 30 dni używa ostatniej prawidłowej kopii, a potem, jeśli reszta witryny działa, zachowuje się tak, jakby pliku robots.txt w ogóle nie było. Google podąża za co najmniej pięcioma skokami przekierowań, potem przerywa i „przyjmuje dla pliku robots.txt kod 404”, co oznacza swobodne skanowanie. A nazwa, której nie ma w DNS, to nie witryna, która kogokolwiek blokuje — nie ma tam pliku ani werdyktu.
200Przestrzega reguł z pliku.301, 302Podąża za co najmniej pięcioma skokami, potem przerywa. Google traktuje wtedy plik jak 404.403, 404Skanuje wszystko, jakby pliku nie było.429Nie skanuje niczego. Google zalicza ten kod do odpowiedzi 5xx, a nie 4xx.500, 503Według standardu nie skanuje zupełnie niczego.Nie ma takiej nazwyNie ma witryny do odczytania, więc nie ma werdyktu.- 1Pierwsze 12 godzinPrzestaje skanować witrynę i wciąż ponawia próby pobrania pliku
- 2Do 30 dniUżywa ostatniej prawidłowej kopii robots.txt
- 3Po 30 dniachJeśli witryna działa, zachowuje się tak, jakby nie było robots.txt
Czy robots.txt chroni stronę przed indeksowaniem w Google?
Nie. Prosi robota, żeby nie pobierał strony; nie prosi wyszukiwarki, żeby nie umieszczała jej w wynikach. Google nie odczyta zablokowanych stron, ale „nadal może indeksować ich adresy URL i wyświetlać je w wynikach wyszukiwania bez fragmentu treści”, gdy linkują do nich inne strony.
Tak wygląda status Search Console „Strona zindeksowana, ale zablokowana przez plik robots.txt”: „Google nie wyśle żądania skanowania strony ani jej nie zeskanuje, ale może ją zindeksować, wykorzystując informacje z innej strony, która zawiera do niej link”. Rozwiązanie Google, jego własnymi słowami: „usuń blokadę z pliku robots.txt i użyj dyrektywy noindex”.
Dlatego najczęstszy błąd w robots.txt to para, a nie pojedynczy wiersz: adres URL, który jest tu jednocześnie zablokowany i ma noindex. Google mówi to wprost: „Jeśli zablokujesz stronę w pliku robots.txt lub będzie ona niedostępna dla robota, nie odnajdzie on reguły noindex i możliwe, że strona będzie się w dalszym ciągu wyświetlać w wynikach wyszukiwania”. Wybierz jedno: zablokuj skanowanie albo wpuść robota i powiedz mu, żeby nie indeksował.
- Robot
- Czyta robots.txt
- Adres URL jest zablokowany
- Nie pobiera strony
<meta name="robots" content="noindex">Nigdy nie zostaje odczytanyŻeby strona nie trafiła do indeksu: wpuść robota i użyj noindex albo wymagaj logowania.
Jak zablokować ChatGPT, Claude i inne roboty AI?
Zwykłą grupą dla każdego z nich. Firmy AI publikują tokeny produktów dokładnie tak jak wyszukiwarki, a większość z nich ma kilka robotów: jednego do trenowania, jednego do odpowiadania na pytania z linkiem zwrotnym i jednego, który pobiera stronę, bo poprosiła o nią konkretna osoba.
Warto je od siebie odróżniać. Zablokowanie robota trenującego trzyma twoje strony z dala od modelu; zablokowanie robota od odpowiedzi usuwa cię też z cytowań, które pokazują te produkty. Widok Roboty powyżej podaje cel każdego z nich, jego token i to, czego według dokumentacji operatora przestrzega, więc możesz odmówić trenowania, nie znikając z odpowiedzi AI.
Niektórzy operatorzy mówią wprost, że robot pobierający stronę w imieniu jednej osoby może ignorować robots.txt, bo działa na rzecz użytkownika, a nie skanuje. Tabela je oznacza. A wiersze Content-Signal od Cloudflare, które publikuje coraz więcej witryn, to deklaracja, do czego wolno używać twoich treści, a nie reguła skanowania: ta strona je zachowuje i wyjaśnia, zamiast nazywać je błędem.
GPTBotPrzestrzegaOAI-SearchBotPrzestrzegaChatGPT-UserMoże ignorować
ClaudeBotPrzestrzegaClaude-SearchBotPrzestrzegaClaude-UserPrzestrzega
PerplexityBotPrzestrzegaPerplexity-UserMoże ignorowaćGoogle-ExtendedTylko tokenBrak takiego robotaBrak takiego robota
Applebot-ExtendedTylko tokenBrak takiego robotaBrak takiego robota
meta-externalagentPrzestrzegameta-webindexerPrzestrzegameta-externalfetcherMoże ignorować
AmazonbotPrzestrzegaBrak takiego robotaAmzn-UserMoże ignorować- TrenowanieZbiera strony do trenowania modelu.
- Odpowiedzi AIPobiera strony, żeby odpowiedzieć na pytanie, zwykle z linkiem do ciebie.
- Prośba jednej osobyPobiera jedną stronę, bo ktoś o nią poprosił. Niektórzy operatorzy mówią, że ten robot może ignorować robots.txt.
Crawl-delay, Clean-param, Host i Content-Signal: kto co czyta?
Google czyta cztery pola i żadnych innych: user-agent, allow, disallow i sitemap. Wszystko inne w robots.txt czyta ktoś inny albo nikt — a nieznany wiersz nigdy nie jest błędem.
Google wymienia swoje cztery pola i dodaje, że „inne pola, np. crawl-delay, nie są obsługiwane”. Bing obsługuje Crawl-delay, co potwierdza jego własny blog: „dyrektywa crawl-delay przyjmuje jako wartości tylko dodatnie liczby całkowite”. Clean-param należy do Yandex i do nikogo innego. Host nie występuje ani w standardzie, ani na liście Google.
Żadna z nich nie psuje pliku. RFC 9309 stanowi, że parsowanie innych rekordów „NIE MOŻE zakłócać parsowania rekordów zdefiniowanych wprost”, więc robot, który nie zna danego wiersza, po prostu go pomija. Dwie dyrektywy, które naprawdę są martwe, to noindex i nofollow w robots.txt: Google wycofał kod, który je obsługiwał, w 2019 roku i dziś w Google nie robią one nic.

User-agentCzytaCzytaCzytaAllowCzytaCzytaCzytaDisallowCzytaCzytaCzytaSitemapCzytaCzytaCzytaCrawl-delayIgnorujeCzytaNiepotwierdzoneClean-paramIgnorujeIgnorujeCzytaHostIgnorujeIgnorujeNiepotwierdzonenoindexIgnorujeNiepotwierdzoneNiepotwierdzoneContent-SignalIgnorujeNiepotwierdzoneNiepotwierdzone- Google obsługuje cztery pola i mówi to wprost: user-agent, allow, disallow i sitemap.
- Własny blog Bing potwierdza Crawl-delay. Nie podajemy dla niego zakresu ani jednostki: aktualnej strony pomocy Bing nie udało się odczytać, żeby je sprawdzić.
- Wycofany przez Google w 2019 roku i nigdy niebędący częścią standardu.
- Content Signals Policy od Cloudflare: deklaracja, jak wolno używać treści, a nie reguła skanowania.
Limit 500 KiB i to, co leży za nim
Google czyta pierwsze 500 kibibajtów pliku robots.txt i ignoruje wszystko dalej, nigdzie nie zgłaszając błędu. RFC 9309 ustala 500 KiB jako dolną granicę limitu parsowania robota; Google podaje tę wartość jako górną granicę.
Google: „W Google obowiązuje limit rozmiaru pliku robots.txt wynoszący 500 kibibajtów (KiB). Po przekroczeniu maksymalnego rozmiaru pliku dalsza treść jest ignorowana”. Nic cię nie ostrzeże. Plik o rozmiarze 600 KiB nie jest nieprawidłowy — jego ostatnie 100 KiB po prostu nie istnieje dla robota Googlebot, a Disallow w tamtym miejscu niczego nie chroni.
Witryny dochodzą do tej granicy częściej, niż myślisz: jedna reguła na każdy parametr kampanii, na każdy filtr fasetowy, na każdy stary katalog testowy. Sprawdzenie powyżej mierzy plik względem tej granicy i mówi, ile leży za nią. Zastąp długie listy wzorcami (Disallow: /*?filter=) i umieść najważniejsze reguły na górze.
Disallow: /cart/ · Wiersz 12PrzestrzeganaDisallow: /private/ · Wiersz 9412Nigdy nie zostaje odczytanaPlik nadal odpowiada 200 i nadal się parsuje. Nic nigdzie nie mówi, że resztę odrzucono.
Częste błędy w robots.txt i jak je znaleźć
Większość zepsutych plików robots.txt psuje się na jeden z sześciu sposobów i żaden z nich nie wychodzi na jaw, dopóki ktoś go nie przetestuje: plik nadal odpowiada 200, nadal się parsuje i nadal wygląda dobrze.
Ten, który zna każdy, to Disallow: / pozostawione po wersji testowej, gdy witryna rusza publicznie. Pozostałe pięć: reguła, która sięga dalej, niż chciałeś, jak Disallow: /admin, która obejmuje też /administrator; Allow: / pod *, które nazwana grupa po cichu ignoruje; wiersz Sitemap: zapisany jako ścieżka zamiast pełnego adresu; ścieżka bez ukośnika na początku, która niczego nie dopasowuje; oraz wiersz noindex, którego Google przestał czytać w 2019 roku.
Uruchom sprawdzenie powyżej, a potem przeczytaj widok Problemy: każdy problem stoi przy swoim wierszu pliku, razem z tym, co z nim zrobić. Jeśli edytujesz plik, a nie go audytujesz, generator robots.txt napisze plik, który ten sam tester już przeczytał.
Źródła
- RFC 9309, Robots Exclusion Protocol: grupy, pierwszeństwo, dopasowanie po zakodowaniu procentowym, kody stanu i dolna granica 500 KiB
- Google Search Central: jak Google interpretuje plik robots.txt, tworzenie i przesyłanie pliku robots.txt oraz blokowanie indeksowania za pomocą noindex
- Pomoc Google Search Console: raport dotyczący pliku robots.txt i raport Indeksowanie stron
- Bing: Crawl-delay i robot Bing oraz Yandex: Clean-param
- Otwartoźródłowy parser robots.txt od Google, mechanizm dopasowania, którego używa sam Googlebot
- Token, cel i zachowanie każdego robota wobec robots.txt pochodzą z dokumentacji jego operatora, podlinkowanej obok w widoku Roboty
Disallow: /Pozostałość po wersji testowej: cała działająca witryna jest zamknięta dla każdego robota.Disallow: /adminBlokuje też /administrator i /admin-tools. Dodaj ukośnik na końcu.Allow: / pod User-agent: *Robot, który ma własną grupę w dowolnym miejscu pliku, nigdy tego nie czyta.Sitemap: /sitemap.xmlWiersz Sitemap musi być pełnym adresem z hostem.Disallow: adminŚcieżka zaczyna się od /. Ta reguła niczego nie dopasowuje.noindex: /private/Martwe od 2019 roku. Strona nadal może być skanowana i indeksowana.Test robots.txt: częste pytania
Co się stało z testerem robots.txt od Google i jak teraz sprawdzić robots.txt?
Dlaczego moje Allow: / pod User-agent: * jest ignorowane?
* jest całkowicie pomijana — to rozwiązanie awaryjne, a nie dodatek. Grupy łączą się tylko wtedy, gdy kilka z nich wymienia ten sam token. Tester URL powyżej pokazuje, którą grupę wybrano dla każdego robota i dlaczego nie wybrano pozostałych.Czy robots.txt chroni stronę przed zaindeksowaniem?
noindex albo nagłówek X-Robots-Tag, albo ukryj stronę za logowaniem.Dlaczego mój noindex nie działa?
noindex też nie, więc strona może dalej pojawiać się w wynikach wyszukiwania dzięki linkom z innych miejsc. Google mówi to wprost: „aby reguła noindex działała poprawnie, nie możesz blokować strony lub zasobu w pliku robots.txt”. Usuń wiersz Disallow i zostaw noindex.Co oznacza 404 dla robots.txt? A 500?
Jeśli pasują i Allow, i Disallow, która reguła wygrywa?
Jakie symbole wieloznaczne działają w robots.txt?
* oznacza dowolny ciąg znaków, a $ koniec adresu URL. Wszystko inne jest dosłowne: ?, ., [, ] i + pasują same do siebie i nie ma wyrażeń regularnych. Reguła bez $ jest prefiksem, więc Disallow: /admin obejmuje też /administrator. W ścieżkach wielkość liter ma znaczenie, a w nazwach dyrektyw, takich jak Disallow, nie ma.Czy Google obsługuje Crawl-delay?
Jak duży może być plik robots.txt?
Jak zablokować roboty AI, takie jak GPTBot i ClaudeBot?
Disallow: /, dokładnie tak jak wyszukiwarce. Większość firm AI ma kilka robotów z różnymi zadaniami: jednego do trenowania, jednego do odpowiadania na pytania z linkiem do ciebie i jednego, który pobiera pojedynczą stronę w imieniu konkretnej osoby. Widok Roboty powyżej podaje każdy token, jego cel i to, czego według operatora przestrzega, więc możesz odmówić trenowania, nie tracąc cytowań w AI.Czy test robots.txt to to samo co walidacja?
Czy robots.txt to zagrożenie dla bezpieczeństwa?
Disallow: /admin-backup/ to drogowskaz prowadzący dokładnie do tego, co chciałeś ukryć. Nic w nim nie blokuje dostępu; robot przestrzega go tylko dlatego, że tak zdecydował jego operator. Chroń prywatne ścieżki uwierzytelnianiem albo regułą firewalla, a ten tester wskaże w twoim pliku ścieżki, które wyglądają jak zaproszenie.Czegoś brakuje?Zaproponuj funkcję lub nowe narzędzie
Więcej narzędzi do skanowania i indeksowania
Sprawdzanie Sitemap
Znajdź i zwaliduj sitemap XML witryny: składnia, limity URL, daty lastmod, konflikty z robots.txt oraz uszkodzone lub przekierowane adresy URL
Generator Mapy Strony
Przeskanuj swoją stronę i pobierz sitemap XML, mapę strony HTML oraz wizualne drzewo witryny
Sprawdzanie Nagłówków HTTP
Analizuj nagłówki odpowiedzi HTTP i ocenę nagłówków bezpieczeństwa
Sprawdzanie Przekierowań
Sprawdź przekierowania URL, łańcuchy przekierowań i kody statusu HTTP dla SEO
Jaki Jest Mój User Agent
Wykryj przeglądarkę, system operacyjny, typ urządzenia, silnik renderowania i architekturę CPU z ciągu User Agent
Analiza Linków
Analizuj wszystkie linki na stronie z wykrywaniem dofollow/nofollow i sprawdzaniem statusu HTTP