











Testeur robots.txt
Ce testeur robots.txt vérifie votre fichier et montre son raisonnement : la règle qui a décidé de votre URL, avec son numéro de ligne, le groupe qu'un robot a réellement lu et pourquoi les autres ont été ignorés, et ce que le code d'état de votre fichier signifie pour tout le site.
Saisissez un domaine pour lire son fichier, ou une URL complète comme example.com/admin/ pour tester aussi ce chemin.
- RécupérationGET /robots.txt
- Lecturegroupes, règles, sitemaps
- Groupeles règles qu'un robot suit
- Verdictce que chaque robot peut explorer
Comment tester votre robots.txt maintenant que l'outil de test de Google a disparu
Saisissez un domaine ci-dessus et choisissez Vérifier le robots.txt. Nous récupérons le fichier une seule fois depuis notre serveur, puis nous testons dans votre navigateur chaque URL que vous saisissez, pour le robot de votre choix — ce que faisait l'outil de test robots.txt de Google avant d'être retiré.
Google a annoncé le changement le 15 novembre 2023 : « Dans le cadre de cette mise à jour, nous abandonnons l'outil de test du fichier robots.txt. » L'ancien outil a disparu en décembre 2023, et le rapport robots.txt de Search Console qui l'a remplacé est un outil d'une tout autre nature.
Ce rapport liste les fichiers que Google a déjà récupérés pour les 20 principaux hôtes d'une propriété que vous possédez et avez validée, avec la date de vérification, la taille en octets et le nombre de problèmes. Il ne peut pas tester une URL par rapport à une règle, tester un robot qui n'est pas celui de Google, ni examiner un site qui ne vous appartient pas. Cette page fait les trois.
- Le fichier que Google a récupéré en dernier
- Sa taille et la date de vérification
- Le nombre de problèmes d'analyse
- Cette URL est-elle autorisée pour ce robot ?
- Quelle règle a décidé, et sur quelle ligne
- Un robot qui n'est pas celui de Google
- Un site qui ne vous appartient pas
Google a annoncé le changement le 15 novembre 2023 et retiré l'outil de test en décembre 2023.
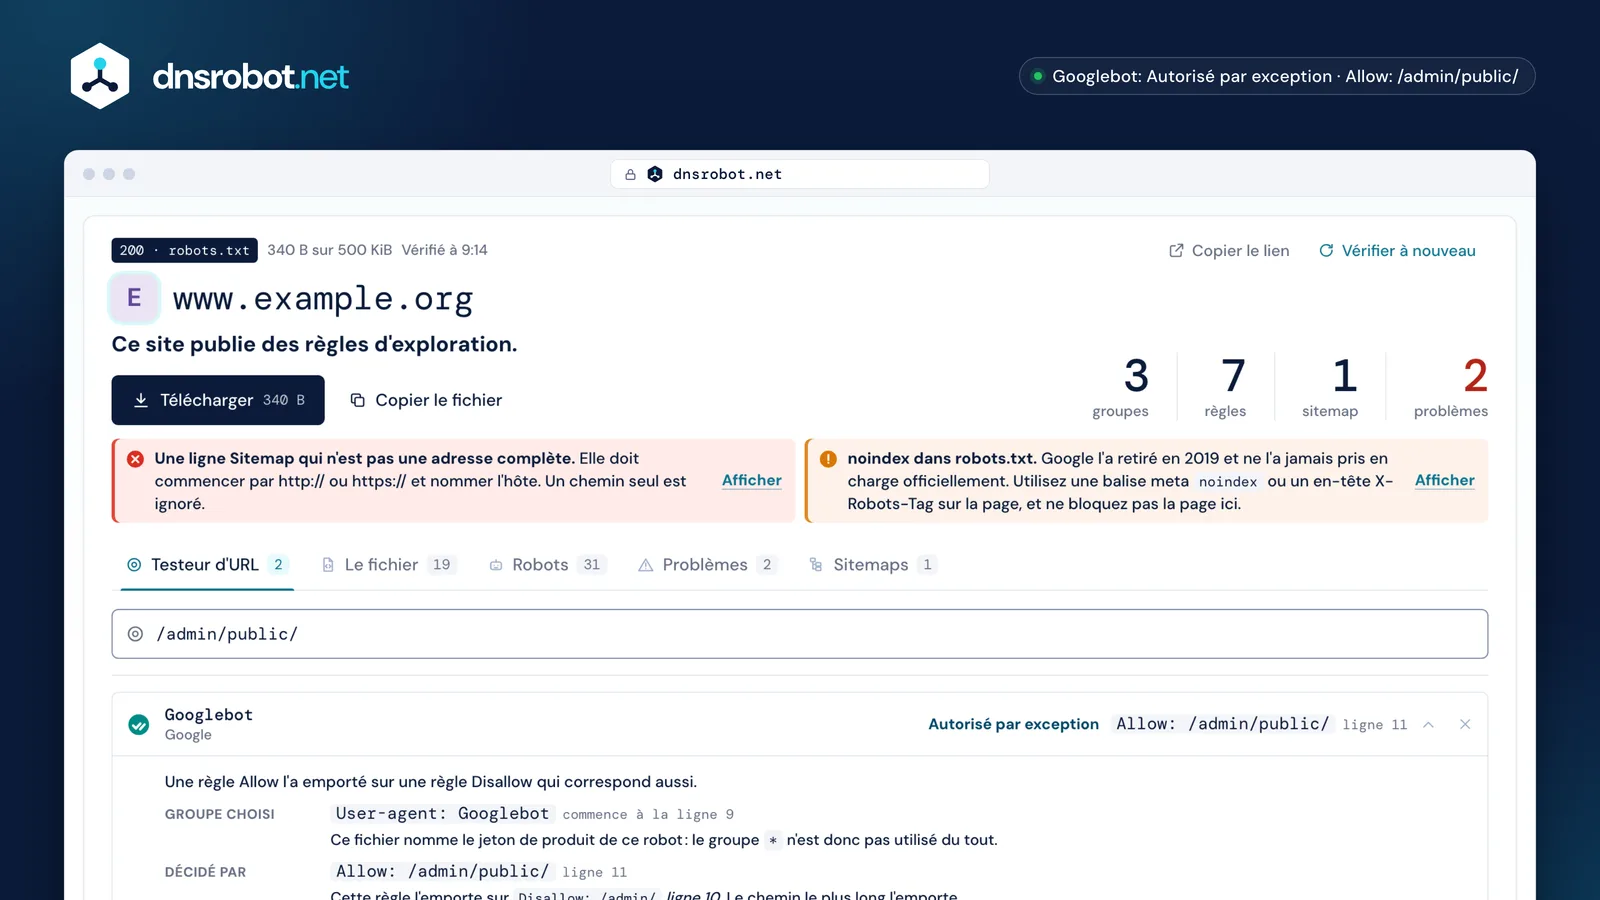
 La conséquencePas le code d'état seul : ce qu'il signifie pour tout le site. Un 404 ici laisse chaque robot tout prendre ; un 503 signifie qu'un robot qui suit la norme ne prend rien.La règle décisiveLa règle qui a décidé de cette URL pour ce robot, avec son numéro de ligne et la règle qu'elle a battue. La correspondance la plus longue l'emporte, et une règle Allow l'emporte en cas d'égalité.Le groupe choisiLe groupe que le robot a réellement lu, et pourquoi les autres ont été ignorés. C'est l'étape que tous les autres outils laissent de côté.Les constatsChaque problème sur sa propre ligne du fichier, avec ce qu'il faut faire.
Comment Google choisit-il le groupe qui s'applique à un robot ?
Un robot obéit à un seul ensemble de règles. Il cherche un groupe dont la ligne User-agent nomme son propre jeton de produit ; ce n'est que s'il n'y en a aucun qu'il se rabat sur le groupe nommé *. Le groupe * est un repli, jamais un ajout.
La RFC 9309 le dit clairement : « Les robots DOIVENT utiliser une correspondance insensible à la casse pour trouver le groupe qui correspond au jeton de produit », et « [si] aucun groupe correspondant n'existe, les robots DOIVENT obéir au groupe dont la ligne user-agent a la valeur *, s'il est présent. » Google dit la même chose avec ses propres mots : « Un seul groupe est valide pour un robot d'exploration particulier. »
Deux conséquences en découlent, et à elles deux elles causent l'essentiel de la confusion. Plusieurs groupes qui nomment le même jeton sont fusionnés en un seul : deux blocs User-agent: Googlebot comptent tous les deux. Mais un groupe nommé et le groupe * ne sont jamais fusionnés : un Allow: / sous * ne fait rien pour Googlebot dès qu'un groupe Googlebot existe. Googlebot-Image et les autres robots Googlebot-* se rabattent sur le groupe googlebot, un comportement que le robot ajoute au-dessus du moteur de correspondance — le moteur de correspondance open source de Google lui-même ne l'implémente pas.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Un groupe nomme le jeton de ce robot ?Lire ce groupe. Le groupe
*n'est pas utilisé. - 2Plusieurs le nomment ?Les lire comme un seul groupe.
- 3Un groupe
*existe ?Lire le groupe*. - —Aucune règle ne s'applique. Tout peut être exploré.
Allow: / sous * n'est jamais lue.
*.Allow ou Disallow : la correspondance la plus longue l'emporte
Quand plusieurs règles correspondent à une URL, celle dont le chemin est le plus long l'emporte, quel que soit son type. Si une règle Allow et une règle Disallow ont la même longueur, c'est l'Allow qui l'emporte.
RFC 9309 : « La correspondance la plus spécifique trouvée DOIT être utilisée. La correspondance la plus spécifique est celle qui compte le plus d'octets », et « si une règle allow et une règle disallow sont équivalentes, alors la règle allow DEVRAIT être utilisée. » Google décrit le même comportement : en cas de règles contradictoires, il utilise « la règle la moins restrictive ».
Des octets, pas des caractères : un chemin avec des lettres accentuées ou un %2F est comparé après l'encodage-pourcent, et c'est là que les outils naïfs se trompent. Seuls le chemin et la requête sont comparés, à partir du premier caractère, et ils sont sensibles à la casse alors que les noms de directives ne le sont pas — Disallow: /File.pdf ne fait rien à /file.pdf.
/admin/report.pdfLa règle Allow l'emporte : elle couvre une plus grande partie du chemin.
Disallow: /files/7 caractèresAllow: /files/7 caractèresMême longueur : c'est donc l'Allow qui l'emporte. « La règle la moins restrictive », comme le dit Google.
Les deux seuls caractères génériques : `*` et `$`
* remplace n'importe quelle suite de caractères, et $ marque la fin de l'URL. Il n'y a rien d'autre : pas d'expressions régulières, et aucun sens particulier pour ?, ., [ ou +, qui sont tous des caractères ordinaires.
Une règle sans $ est un préfixe : Disallow: /admin bloque donc aussi /administrator et /admin-tools. Ajoutez une barre oblique finale (/admin/) quand vous visez le dossier, et un $ quand vous visez exactement cette URL. Disallow: /*.pdf$ bloque tous les PDF ; Disallow: /*? bloque toutes les URL qui ont une chaîne de requête.
Le Testeur d'URL ci-dessus montre les chemins qu'une règle couvre aussi, à partir du même moteur de correspondance que le verdict : une règle qui va plus loin que prévu se voit avant même d'être publiée.
* et $, et ce que chaque motif couvre vraiment/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ et + sont des caractères ordinaires. Il n'y a pas d'expressions régulières dans robots.txt.
Que signifie le code d'état de votre robots.txt ?
Un 4xx et un 5xx sur le même fichier défaillant ont des effets opposés. Un 4xx est traité comme s'il n'y avait pas de fichier : un robot peut alors tout prendre. Un 5xx signifie que le fichier est indéfini : un robot conforme ne doit rien prendre.
RFC 9309 §2.3.1.3 : si le code d'état indique que le fichier « est indisponible pour le robot, alors le robot PEUT accéder à toutes les ressources du serveur ». §2.3.1.4 : s'il « est inaccessible en raison d'erreurs du serveur ou du réseau… le robot DOIT supposer une interdiction complète. » Google traite « toutes les erreurs 4xx, à l'exception de 429, comme s'il n'existait pas de fichier robots.txt valide », ce qui place le 429 du côté des 5xx.
Google adoucit ensuite le cas 5xx par une échelle qui lui est propre : il cesse d'explorer pendant les 12 premières heures, utilise sa dernière copie valide pendant les 30 jours suivants, puis, si le reste du site est accessible, se comporte comme s'il n'y avait pas de robots.txt du tout. Google suit au moins cinq sauts de redirection, puis s'arrête et « le traite comme un code d'état 404 pour le fichier robots.txt », ce qui veut dire explorer librement. Et un nom qui n'existe pas dans le DNS n'est pas un site qui bloque qui que ce soit — il n'y a pas de fichier, et pas de verdict.
200Suit les règles du fichier.301, 302Suit au moins cinq sauts, puis s'arrête. Google traite alors le fichier comme un 404.403, 404Explore tout, comme s'il n'y avait pas de fichier.429N'explore rien. Google le range avec les réponses 5xx, pas avec les 4xx.500, 503N'explore rien du tout, selon la norme.Nom introuvableIl n'y a aucun site à lire, donc aucun verdict.- 112 premières heuresCesse d'explorer le site et réessaie de récupérer le fichier
- 2Jusqu'à 30 joursUtilise sa dernière copie valide de robots.txt
- 3Après 30 joursSi le site est accessible, se comporte comme s'il n'y avait pas de robots.txt
Le fichier robots.txt empêche-t-il une page d'apparaître dans Google ?
Non. Il demande à un robot de ne pas récupérer la page ; il ne demande pas à un moteur de recherche de ne pas la référencer. Google ne peut pas lire une page interdite, mais il « peut tout de même indexer l'URL et l'afficher dans les résultats de recherche sans extrait » quand d'autres pages pointent vers elle.
C'est le statut de Search Console « Indexée malgré le blocage par le fichier robots.txt » : « Google ne demande pas et n'explore pas la page. Toutefois, nous pouvons tout de même l'indexer à l'aide des informations provenant de la page qui renvoie vers celle que vous avez bloquée. » La correction de Google, dans ses propres termes : « Supprimez le bloc robots.txt et utilisez la directive noindex ».
L'erreur la plus courante dans robots.txt est donc une paire, pas une ligne : une URL à la fois interdite ici et porteuse d'un noindex. Google est explicite : « si la page est bloquée par un fichier robots.txt […], la règle noindex n'est pas détectée par le robot d'exploration », et la page peut toujours apparaître dans les résultats de recherche. Choisissez : bloquez l'exploration, ou laissez entrer le robot et dites-lui de ne pas indexer.
- Robot
- Lit robots.txt
- L'URL est interdite
- Ne récupère pas la page
<meta name="robots" content="noindex">Jamais luPour tenir une page à l'écart : laissez entrer le robot et utilisez noindex, ou exigez une connexion.
Comment bloquer ChatGPT, Claude et les autres robots d'IA ?
Avec un groupe ordinaire pour chacun. Les entreprises d'IA publient des jetons de produit exactement comme les moteurs de recherche, et la plupart en exploitent plusieurs : un pour l'entraînement, un pour répondre à une question avec un lien vers vous, et un qui récupère une page parce qu'une personne l'a demandée.
Ces trois-là méritent d'être distingués. Bloquer un robot d'entraînement tient vos pages à l'écart d'un modèle ; bloquer un robot de réponse vous retire aussi des citations que ces produits affichent. La vue Robots ci-dessus donne l'usage de chacun, son jeton et ce que la documentation de son opérateur dit qu'il respecte : vous pouvez ainsi refuser l'entraînement sans disparaître des réponses d'IA.
Certains opérateurs disent ouvertement que le robot qui récupère une page pour le compte d'une personne peut ignorer robots.txt, parce qu'il agit pour un utilisateur au lieu d'explorer. Le tableau les signale. Et les lignes Content-Signal de Cloudflare, que de plus en plus de sites publient, sont une déclaration sur l'usage permis de votre contenu plutôt qu'une règle d'exploration : cette page les conserve et les explique au lieu de les traiter comme une erreur.
GPTBotRespecteOAI-SearchBotRespecteChatGPT-UserPeut ignorer
ClaudeBotRespecteClaude-SearchBotRespecteClaude-UserRespecte
PerplexityBotRespectePerplexity-UserPeut ignorerGoogle-ExtendedJeton seulementPas de robot de ce typePas de robot de ce type
Applebot-ExtendedJeton seulementPas de robot de ce typePas de robot de ce type
meta-externalagentRespectemeta-webindexerRespectemeta-externalfetcherPeut ignorer
AmazonbotRespectePas de robot de ce typeAmzn-UserPeut ignorer- EntraînementCollecte des pages pour entraîner un modèle.
- Réponses d'IARécupère des pages pour répondre à une question, en général avec un lien vers vous.
- Demande d'une personneRécupère une page parce que quelqu'un l'a demandée. Certains opérateurs disent que celui-ci peut ignorer robots.txt.
Crawl-delay, Clean-param, Host et Content-Signal : qui lit quoi ?
Google lit quatre champs et aucun autre : user-agent, allow, disallow et sitemap. Tout le reste d'un robots.txt est lu par quelqu'un d'autre, ou par personne — et une ligne inconnue n'est jamais une erreur.
Google liste ses quatre champs et ajoute que « d'autres champs tels que crawl-delay ne sont pas acceptés ». Bing, lui, prend en charge Crawl-delay, d'après le blog de Bing : « la directive crawl-delay n'accepte comme valeurs que des nombres entiers positifs ». Clean-param est propre à Yandex, et à personne d'autre. Host ne figure ni dans la norme ni dans la liste de Google.
Aucune d'elles ne casse un fichier. La RFC 9309 l'impose : l'analyse d'autres enregistrements « NE DOIT PAS interférer avec l'analyse des enregistrements explicitement définis », si bien qu'un robot qui ne connaît pas une ligne la saute. Les deux directives vraiment mortes sont noindex et nofollow dans robots.txt : Google a retiré en 2019 le code qui les traitait, et elles ne font plus rien chez Google aujourd'hui.

User-agentLa litLa litLa litAllowLa litLa litLa litDisallowLa litLa litLa litSitemapLa litLa litLa litCrawl-delayL'ignoreLa litNon confirméClean-paramL'ignoreL'ignoreLa litHostL'ignoreL'ignoreNon confirménoindexL'ignoreNon confirméNon confirméContent-SignalL'ignoreNon confirméNon confirmé- Google prend en charge quatre champs et le dit : user-agent, allow, disallow et sitemap.
- Le blog de Bing confirme Crawl-delay. Nous ne publions ni plage ni unité pour cette directive : la page d'aide actuelle de Bing n'a pas pu être lue pour les vérifier.
- Retiré par Google en 2019, et jamais dans la norme.
- La Content Signals Policy de Cloudflare : une déclaration sur l'usage permis du contenu, pas une règle d'exploration.
La limite de 500 KiB, et ce qui la dépasse
Google lit les 500 premiers kibioctets d'un robots.txt et ignore tout ce qui suit, sans la moindre erreur nulle part. La RFC 9309 fixe 500 KiB comme plancher de la limite d'analyse d'un robot ; Google l'annonce comme son plafond.
Google : « Google applique une limite de taille de fichier robots.txt de 500 kibioctets (KiB). Tout contenu qui dépasse cette taille est ignoré. » Rien ne vous prévient. Un fichier de 600 KiB n'est pas invalide — ses 100 derniers KiB n'existent tout simplement pas pour Googlebot, et un Disallow placé là-bas ne protège rien.
Les sites l'atteignent plus souvent qu'on ne le croit : une règle par paramètre de campagne, par filtre de navigation à facettes, par ancien dossier de préproduction. La vérification ci-dessus mesure le fichier par rapport à cette limite et vous dit quelle part la dépasse. Remplacez les longues listes par des motifs (Disallow: /*?filter=), et placez en haut les règles qui comptent.
Disallow: /cart/ · Ligne 12RespectéeDisallow: /private/ · Ligne 9 412Jamais lueLe fichier répond toujours 200 et s'analyse toujours. Rien, nulle part, ne vous dit que la suite a été abandonnée.
Les erreurs courantes dans robots.txt, et comment les trouver
La plupart des robots.txt défaillants le sont de l'une de six façons, et aucune ne se voit tant que rien ne la teste : le fichier répond toujours 200, s'analyse toujours et a toujours l'air correct.
Celle que tout le monde connaît, c'est Disallow: / resté en place quand un site passe de la préproduction à la production. Les cinq autres : une règle qui va plus loin que prévu, comme Disallow: /admin, qui attrape aussi /administrator ; un Allow: / sous * qu'un groupe nommé ignore sans bruit ; une ligne Sitemap: écrite comme un chemin au lieu d'une adresse complète ; un chemin sans barre oblique initiale, qui ne correspond à rien ; et une ligne noindex, que Google a cessé de lire en 2019.
Lancez la vérification ci-dessus, puis lisez la vue Problèmes : chaque constat se trouve sur sa propre ligne du fichier, avec ce qu'il faut faire. Si vous rédigez le fichier plutôt que de l'auditer, le générateur de robots.txt écrit un fichier que ce même testeur a déjà lu.
Sources
- RFC 9309, le Robots Exclusion Protocol : les groupes, la priorité, la correspondance après encodage-pourcent, les codes d'état et le plancher de 500 KiB
- Google Search Central : comment Google interprète robots.txt, créer et envoyer un fichier robots.txt et bloquer l'indexation avec noindex
- Aide Google Search Console : le rapport robots.txt et le rapport sur l'indexation des pages
- Bing : Crawl-delay et le robot de Bing et Yandex : Clean-param
- L'analyseur robots.txt open source de Google, le moteur de correspondance qu'utilise Googlebot lui-même
- Le jeton, l'usage et le comportement face à robots.txt de chaque robot proviennent de la documentation de son propre opérateur, en lien à côté de lui dans la vue Robots
Disallow: /Un reste de la préproduction : tout le site en ligne est fermé à tous les robots.Disallow: /adminBloque aussi /administrator et /admin-tools. Ajoutez la barre oblique finale.Allow: / sous User-agent: *Jamais lu par un robot qui a son propre groupe, où que ce soit dans le fichier.Sitemap: /sitemap.xmlUne ligne Sitemap doit être une adresse complète, avec l'hôte.Disallow: adminUn chemin commence par /. Cette règle ne correspond à rien.noindex: /private/Mort depuis 2019. La page reste explorable et indexable.Testeur robots.txt : questions fréquentes
Qu'est devenu l'outil de test robots.txt de Google ?
Pourquoi mon Allow: / sous User-agent: * est-il ignoré ?
* est entièrement sauté — c'est un repli, pas un ajout. Les groupes ne sont fusionnés que lorsque plusieurs d'entre eux nomment le même jeton. Le Testeur d'URL ci-dessus montre quel groupe a été choisi pour chaque robot, et pourquoi les autres ne l'ont pas été.Le fichier robots.txt empêche-t-il l'indexation d'une page ?
noindex ou un en-tête X-Robots-Tag, ou placez la page derrière une connexion.Pourquoi mon noindex ne fonctionne-t-il pas ?
noindex compris : la page peut donc continuer d'apparaître dans les résultats grâce à des liens venus d'ailleurs. Google le dit directement : pour que noindex soit efficace, la page « ne doit pas être bloquée par un fichier robots.txt ». Retirez la ligne Disallow et gardez le noindex.Que signifie un 404 sur robots.txt ? Et un 500 ?
Si une règle Allow et une règle Disallow correspondent toutes les deux, laquelle l'emporte ?
Quels caractères génériques fonctionnent dans robots.txt ?
* remplace n'importe quelle suite de caractères et $ marque la fin de l'URL. Tout le reste est littéral : ?, ., [, ] et + ne correspondent qu'à eux-mêmes, et il n'y a pas d'expressions régulières. Une règle sans $ est un préfixe : Disallow: /admin couvre donc aussi /administrator. Les chemins sont sensibles à la casse, alors que les noms de directives comme Disallow ne le sont pas.Google prend-il en charge Crawl-delay ?
Quelle taille un fichier robots.txt peut-il avoir ?
Comment bloquer les robots d'IA comme GPTBot et ClaudeBot ?
Disallow: /, exactement comme pour un moteur de recherche. La plupart des entreprises d'IA exploitent plusieurs robots aux missions différentes : un pour l'entraînement, un pour répondre aux questions avec un lien vers vous, et un qui récupère une seule page pour le compte d'une personne. La vue Robots ci-dessus nomme chaque jeton, son usage et ce que son opérateur dit qu'il respecte : vous pouvez ainsi refuser l'entraînement sans perdre les citations dans les réponses d'IA.Vérifier un robots.txt, est-ce la même chose que le valider ?
Le fichier robots.txt est-il un risque de sécurité ?
Disallow: /admin-backup/ est donc un panneau indicateur pointant exactement vers ce que vous vouliez cacher. Rien dans ce fichier n'empêche l'accès ; un robot ne le respecte que parce que son opérateur l'a décidé. Protégez les chemins privés par une authentification ou une règle de pare-feu, et ce testeur vous signalera les chemins de votre fichier qui ressemblent à une invitation.Il vous manque quelque chose ?Suggérez une fonction ou un nouvel outil
Plus d'outils d'exploration et d'indexation
Vérificateur de Sitemap
Trouvez et validez le sitemap XML d'un site : syntaxe, limites d'URLs, dates lastmod, conflits avec robots.txt et URLs cassées ou redirigées
Générateur de Sitemap
Explorez votre site et obtenez un sitemap XML, un plan du site HTML et une arborescence visuelle
Vérificateur d'en-têtes HTTP
Analysez les en-têtes de réponse HTTP et la notation des en-têtes de sécurité
Vérificateur de Redirections
Vérifiez les redirections d'URL, les chaînes de redirection et les codes de statut HTTP pour le SEO
Quel Est Mon User Agent
Détectez votre navigateur, OS, type d'appareil, moteur de rendu et architecture CPU depuis votre user agent
Analyseur de Liens
Analysez tous les liens d'une page avec détection dofollow/nofollow et vérification de statut HTTP