robots.txt 검사기는 무엇을 하나요?
robots.txt는 웹사이트 루트(https://example.com/robots.txt)에 있는 일반 텍스트 파일로, 크롤러가 어떤 URL을 가져가도 되는지 알려 줍니다. 한 줄만 잘못 써도 사이트 전체가 Google에서 사라지거나, 막아 두려던 페이지를 AI 크롤러가 읽어 갈 수 있습니다.
이 검사기는 크롤러와 같은 방식으로 파일을 내려받고 Google의 매칭 로직으로 모든 규칙을 읽은 뒤, 어떤 URL과 어떤 봇이든 허용인지 차단인지, 그리고 어느 줄이 그 결과를 결정했는지 알려 줍니다. Google은 2023년 12월 Search Console에서 자체 robots.txt 테스터를 없앴기 때문에, 규칙을 바꾸기 전후에 빠르게 테스트하려면 이 도구를 사용하면 됩니다.
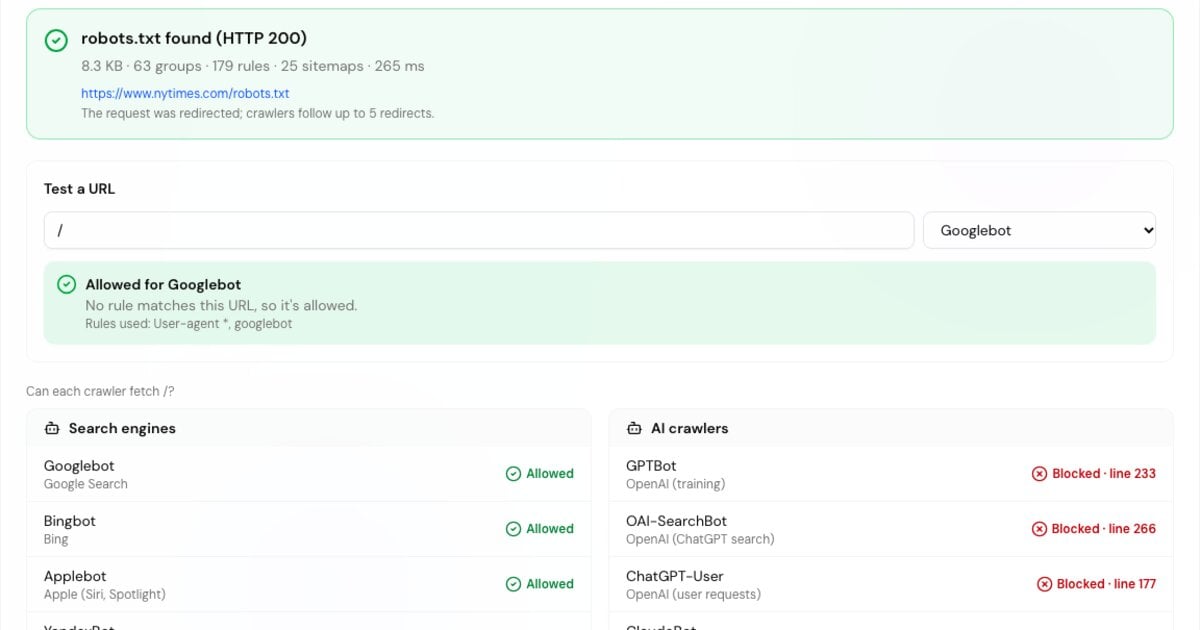
robots.txt 테스트 방법
example.com 같은 도메인을 입력하거나, 특정 페이지를 바로 테스트하려면 전체 페이지 URL을 입력합니다. 검사기는 사이트 루트에서 /robots.txt를 가져오며 리다이렉트를 따라갑니다.
200 응답이면 규칙이 적용됩니다. 404이면 크롤러가 모든 페이지를 가져가도 됩니다. 서버 오류가 나면 Google은 파일이 다시 로드될 때까지 사이트 크롤링을 멈춥니다.
/blog/post?id=1 같은 경로를 입력하고 크롤러를 고릅니다. 허용 또는 차단 여부와 함께 일치한 정확한 규칙과 줄 번호가 표시됩니다.
robots.txt 붙여넣기로 전환해 초안을 편집하면 결과를 즉시 볼 수 있습니다. 그런 다음 파일을 게시하고 실제 파일을 다시 확인하세요.
Advertisement
크롤러가 robots.txt를 읽는 방식
Google, Bing 등 규칙을 잘 지키는 크롤러 대부분은 로봇 배제 표준인 RFC 9309를 따릅니다. 거의 모든 결과는 다음 네 가지 규칙으로 결정됩니다.
크롤러는 자신의 이름과 일치하는 User-agent 가운데 가장 구체적인 그룹 하나만 따릅니다. Googlebot 전용 그룹이 있으면 Googlebot은 User-agent: * 그룹을 완전히 무시합니다.
여러 규칙이 한 URL과 일치하면 경로가 가장 긴 규칙이 이깁니다. /shop/sale/ 아래 페이지에서는 Allow: /shop/sale/ 규칙이 Disallow: /shop/ 규칙보다 우선합니다.
Allow 규칙과 Disallow 규칙의 길이가 같으면 Google은 덜 제한적인 쪽, 즉 Allow를 선택합니다.
*는 임의의 문자와 일치하고 $는 URL의 끝을 나타냅니다. Disallow: /*.pdf$는 모든 PDF를 차단하지만 /file.pdf?download=1은 차단하지 않습니다.
robots.txt의 HTTP 상태 코드가 뜻하는 것
크롤러는 규칙을 하나도 읽기 전에 먼저 응답 코드에 따라 동작을 정합니다. 경우별로 Google이 처리하는 방식은 다음과 같습니다.
파일을 읽고 그 규칙을 따릅니다. Google은 처음 500 KiB만 읽고 그 이후 내용은 무시합니다.
Google은 리다이렉트를 최소 5번까지 따라갑니다. 그래도 robots.txt에 도달하지 못하면 파일이 없는 것으로 처리합니다.
robots.txt가 없는 것으로 간주되어 모든 URL을 크롤링할 수 있습니다. 단, 429 Too Many Requests는 예외입니다.
오류가 이어지는 동안 Google은 사이트 전체를 차단된 것으로 처리합니다. 30일이 지나면 마지막으로 캐시된 사본을 사용하고, 사본이 없으면 제한이 없는 것으로 간주합니다.
Advertisement
robots.txt로 AI 크롤러 차단하기
AI 회사들은 모델 학습, AI 검색, 온디맨드 가져오기에 각각 다른 크롤러 이름을 쓰므로 하나만 골라 차단할 수 있습니다. Google-Extended를 차단하면 콘텐츠가 Gemini에 사용되지 않지만 Google 검색에는 영향이 없습니다. 반면 Googlebot을 차단하면 검색에도 영향을 줍니다.
검사기의 AI 크롤러 표에서 robots.txt가 AI 봇 13종 중 어떤 봇을 허용하는지 한눈에 볼 수 있습니다. 주요 학습용 크롤러를 차단하려면 다음 내용을 추가하세요.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: CCBot
User-agent: Applebot-Extended
Disallow: /
흔한 robots.txt 실수
스테이징 사이트에서 남은 `Disallow: /`는 모든 것을 차단합니다. 새 사이트가 Google에 전혀 나타나지 않는 가장 흔한 원인입니다.
robots.txt로 페이지 숨기기. 차단된 URL도 링크를 통해 색인될 수 있으며, 이때는 설명 없이 표시됩니다. 페이지를 검색 결과에서 빼려면 크롤링은 허용하고
noindex메타 태그나X-Robots-Tag헤더를 추가하세요.robots.txt의 `Noindex:` 줄. Google은 2019년 9월부터 이를 지원하지 않으므로 무시됩니다.
CSS와 JavaScript 차단. Google은 브라우저처럼 페이지를 렌더링하므로, 이런 파일을 차단하면 Google에는 페이지가 깨져 보일 수 있습니다.
대소문자 실수. 지시문 이름은 대소문자를 구분하지 않지만 경로는 구분합니다.
Disallow: /Admin/은/admin/을 차단하지 않습니다.모든 서브도메인에 파일 하나. robots.txt는 해당 호스트와 프로토콜에만 적용됩니다.
blog.example.com에는 별도의 파일이 필요합니다.Google용 Crawl-delay. Googlebot은 이를 무시하고, Bing은 따릅니다.
Advertisement
robots.txt 예시
필요한 패턴을 복사한 다음, 전체 파일을 검사기에 붙여 넣어 테스트하세요.
User-agent: *
Disallow:User-agent: *
Disallow: /admin/
Allow: /admin/public/User-agent: *
Disallow: /*?
Disallow: /*.pdf$Sitemap: https://example.com/sitemap.xmlSEO·크롤링 도구 더 보기
나머지 크롤링 설정도 만들고 점검하세요.