











사이트맵 생성기
검색엔진과 똑같이 사이트를 크롤링하는 무료 사이트맵 생성기입니다. 검색 결과에 나와야 할 페이지만 모아 XML 사이트맵을 만들고, 나머지 URL은 왜 뺐는지 하나하나 알려 줍니다.
도메인만 입력해도 됩니다. example.org처럼 입력하면 홈페이지부터 시작합니다.
- robots.txt먼저 읽고 따릅니다
- 현재 사이트맵찾아서 비교합니다
- 크롤링함최대 500페이지, 동시에 3개씩
- 판정noindex, canonical, 리다이렉트
사이트맵 만들기: 단계별 사이트맵 생성 방법
위에 홈페이지 주소를 넣고 “사이트맵 생성”을 선택하세요. 사이트맵 크롤러가 robots.txt를 읽고, 검색엔진처럼 링크를 따라가며, 실어야 할 페이지만 남겨, 사이트 루트에 올릴 sitemap.xml을 건네줍니다.
페이지가 실리는 조건은 200을 응답하고, HTML이며, noindex가 아니고, canonical로 자기 자신을 가리키며, robots.txt에 막혀 있지 않은 것입니다. 그 밖의 URL은 모두 이유와 함께 제외로 들어가므로, 실수인지 의도한 설정인지 가려낼 수 있습니다.
파일은 루트, https://www.example.org/sitemap.xml에 올립니다. 사이트맵에는 자신과 같은 폴더 아래의 URL만 실을 수 있어서, 루트에 두면 사이트 전체를 덮습니다(Google). 그런 다음 robots.txt에 Sitemap: 줄을 추가하고, Google Search Console과 Bing Webmaster Tools에서 제출하세요.
1홈페이지 주소 입력
example.org또는 URL 목록 붙여 넣기2크롤링하고 판정
robots.txt 200499/500사이트맵에 412개 · 87개 제외3파일 다운로드
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML, CSV4업로드하고 제출
/sitemap.xmlSitemap: https://www.example.org/…루트 · robots.txt · Search Console



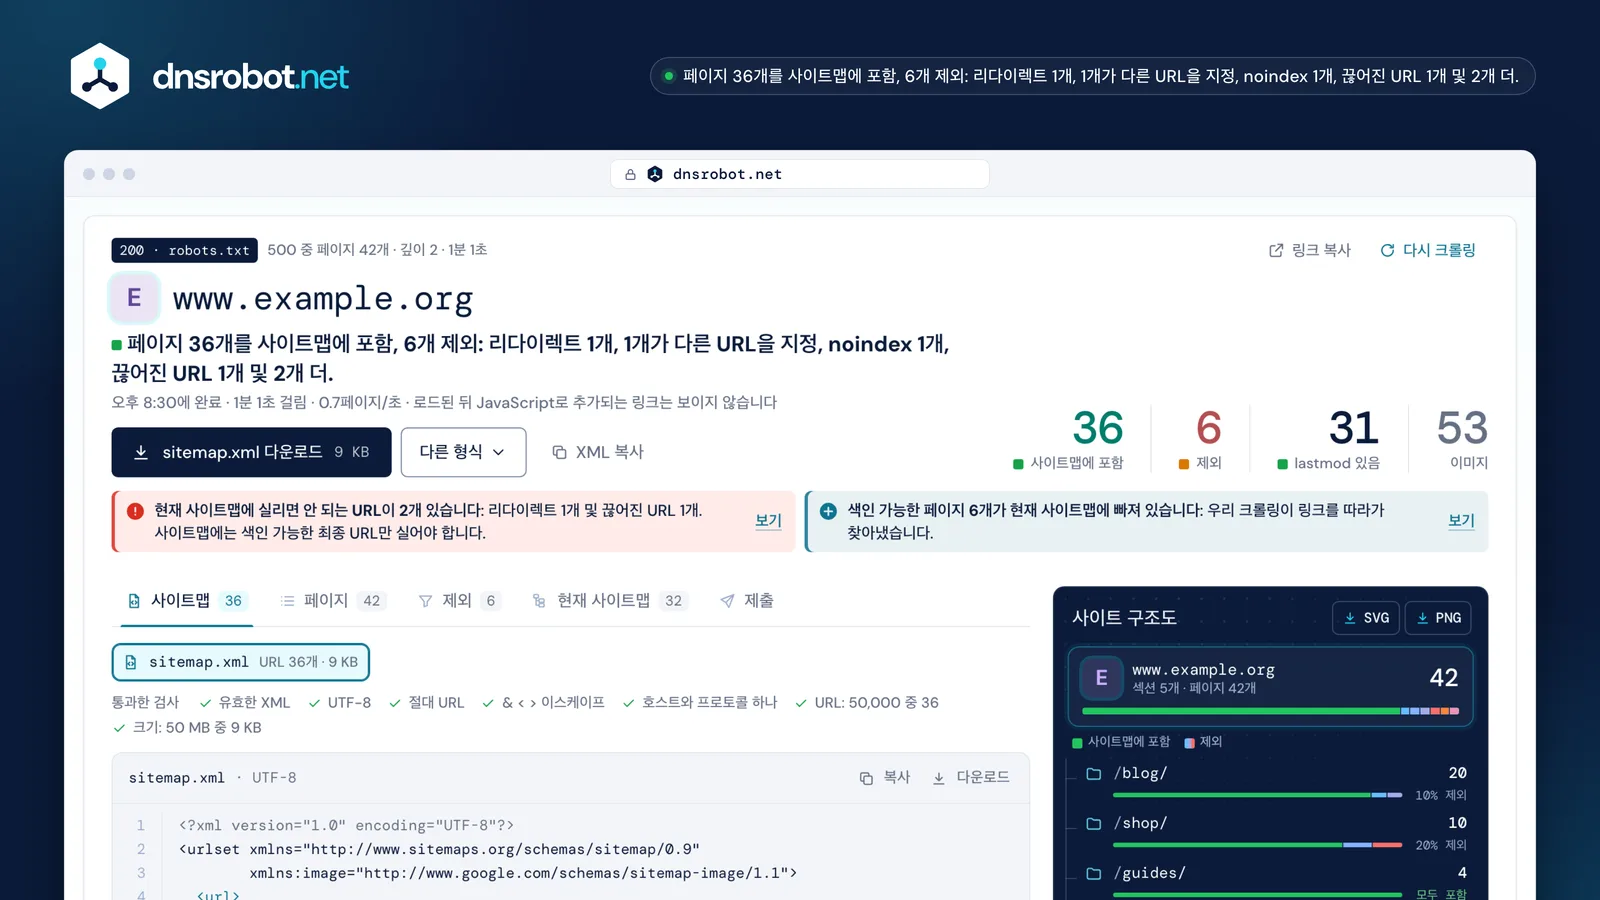
 판정몇 페이지가 들어가고, 몇 개가 왜 빠지는지를 한 문장으로 보여 줍니다. 큰 숫자가 그것을 다시 한번 말해 줍니다.다운로드sitemap.xml, 파일이 나뉘었을 때는 모든 파일과 인덱스를 담은 ZIP. 그 밖에 .xml.gz, TXT, HTML 사이트맵, 크롤링한 모든 페이지의 CSV도 있습니다.안내현재 사이트맵의 낡은 항목, 거기에 빠져 있는 페이지, 그리고 각 lastmod 날짜를 어디서 가져왔는지 알려 줍니다.사이트 구조도섹션마다 페이지 수와 제외된 비율을 보여 줍니다. 가지를 선택하면 페이지를 걸러 볼 수 있고, SVG나 PNG로 내려받을 수 있습니다.
XML 사이트맵(XML sitemap)은 어떤 모습인가요? sitemap.xml 예시
XML 사이트맵은 페이지마다 <url> 항목이 하나씩 들어 있는 UTF-8 파일입니다. 반드시 있어야 하는 것은 <urlset>, <url>, <loc>뿐이고, 나머지는 모두 선택입니다. 아래는 사이트맵 예시를 한 줄씩 짚은 것입니다.
<loc>은 프로토콜부터 시작하는 완전한 절대 URL이고 2,048자 미만이어야 하며, &는 &로 씁니다(sitemaps.org). <lastmod>는 그 페이지가 마지막으로 바뀐 날짜로, 2026-09-14 같은 W3C 형식입니다. 시각은 선택이지만, 쓰려면 시간대가 있어야 합니다.
네임스페이스는 https 사이트에서도 http:// 그대로입니다. 파서를 위한 이름일 뿐, 누가 가져가는 주소가 아니기 때문입니다. <changefreq>와 <priority>도 쓸 수 있지만, Google과 Bing은 무시합니다.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1첫 줄에서 UTF-8 선언
- 2네임스페이스는 http://, https:// 아님
- 3절대 URL, &는 &로 이스케이프
- 4실제 변경 날짜, 없으면 lastmod 자체를 빼기
- 5Google과 Bing은 무시
- 6lastmod 없음: 홈페이지는 다른 페이지를 모으기만 함
사이트맵에 어떤 페이지가 들어가고, 어떤 페이지가 빠지나요?
검색 결과에 내보내고 싶은 정규 URL을 페이지당 하나씩입니다. 200을 응답하는 최종 URL이고, 색인 가능하며, robots.txt에 막혀 있지 않은 것들입니다. 그 밖에는 모두 이유를 옆에 적어 뺍니다.
리다이렉트, noindex 페이지, canonical이 다른 URL을 가리키는 페이지는 검색엔진에 엇갈린 신호를 보냅니다. 사이트맵은 “이것을 색인해 달라”고 말하는데, 페이지는 다른 말을 하기 때문입니다. 사이트맵에 적는 URL과 rel=canonical의 URL을 다르게 두지 마세요(Google). 또 Search Console은 robots.txt가 막은 URL이 실린 사이트맵을 보고합니다.
사이트맵의 URL은 어디까지나 제안이고, 무엇이 중복인지는 결국 Google이 정합니다. 그래서 이 생성기는 뺀 페이지마다 이유를 보여 줍니다. 의도한 noindex라면 괜찮지만, 가장 중요한 상품 페이지의 noindex는 괜찮지 않습니다.
lastmod, changefreq, priority: 검색엔진은 무엇을 읽나요?
Google과 Bing은 changefreq와 priority를 무시합니다. lastmod는 둘 다 쓰지만, 정확할 때만입니다. 크롤링할 때마다 바뀌는 날짜는 그 날짜를 믿지 않도록 가르치는 셈입니다.
Google은 lastmod를 “일관되고 검증할 수 있을 만큼 정확할 때” 사용하며, 그 날짜는 본문이나 구조화된 데이터, 링크 같은 마지막 중요한 변경을 가리켜야지 저작권 연도를 새로 적은 것이어서는 안 됩니다(Google). 오래된 페이지에 계속 새 변경이 있다고 주장하는 lastmod는 신뢰를 잃습니다. Bing도 lastmod로 크롤링 일정을 잡으며, 늘 오늘로 찍히는 날짜는 무시할 수 있습니다. Yandex는 지금도 세 태그를 모두 읽습니다.
그래서 이 생성기는 오늘 날짜를 결코 쓰지 않습니다. lastmod는 아래 순서대로 페이지 자체의 데이터에서 가져오고, 아무것도 없으면 뺍니다. 홈페이지나 다른 페이지를 모으기만 하는 카테고리 페이지라면 없어도 괜찮습니다.
| 태그 | Bing | Yandex | |
|---|---|---|---|
| lastmod | 정확할 때 사용 | 정확할 때 사용 | 읽음 |
| changefreq | 무시 | 무시 | 읽음 |
| priority | 무시 | 무시 | 읽음 |
모든 페이지가 “오늘”이면 이렇게 보입니다
항목 412개에 날짜 하나: 변경 날짜가 아니라 생성 날짜입니다.
URL 50,000개, 50 MB, 그리고 사이트맵 인덱스
사이트맵 하나에는 URL 50,000개, 압축하지 않은 상태로 50 MB까지 담깁니다. 둘 중 먼저 넘는 쪽을 넘으면 URL을 여러 파일로 나눠 사이트맵 인덱스에 싣고, 그 인덱스를 제출하세요.
한도는 압축하지 않은 파일을 기준으로 하며, .xml.gz로 제공할 때도 마찬가지입니다. ZIP이 아니라 gzip입니다(sitemaps.org). 인덱스에는 사이트맵을 최대 50,000개까지 실을 수 있고, 같은 사이트의, 자신과 같은 폴더 이하에 있는 파일만 가능하며, 인덱스 안에 또 다른 인덱스는 넣을 수 없습니다. Naver Search Advisor는 10 MB가 넘는 파일을 받지 않으니, 한국 사이트라면 추가 옵션에서 10 MB 한도를 선택하세요.
언어 대체 URL(xhtml:link)은 50,000개 한도에 들어가지 않습니다. 이 생성기는 자동으로 나누고, 원하면 섹션별로도 나눕니다. 블로그에 한 파일, 상품에 한 파일 하는 식입니다.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
이미지와 hreflang 항목
사이트맵에는 각 페이지의 이미지와 다른 언어 버전을, 그 페이지의 <url> 항목 안에 함께 적을 수도 있습니다.
이미지는 Google의 이미지 네임스페이스를 쓰며, 페이지당 최대 1,000개입니다. 지금도 뜻이 있는 것은 <image:image>와 <image:loc>뿐이고, caption, title, license, geo_location은 2022년에 폐지되었습니다.
언어는 각 항목에 자기 자신을 비롯한 모든 버전을 xhtml:link와 hreflang 코드로 적습니다. 코드는 ISO 639-1 언어에 ISO 3166-1 지역을 선택적으로 붙인 것이며, 지역만 적을 수는 없습니다. 링크는 양방향이어야 하고, 그렇지 않으면 Google이 무시하므로 이 생성기는 모든 버전이 서로 링크하는 클러스터만 쓰고, 나머지는 무엇이 문제인지와 함께 보여 줍니다. x-default는 선택이며, 준비하지 않은 언어의 방문자를 위한 것입니다.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja에서 de로 링크하지만 de에서는 되돌아 링크하지 않음: 이 클러스터는 쓰지 않음이미지 항목 페이지당 최대 1,000개
사이트맵을 Google과 Bing에 제출하는 방법
모든 크롤러가 읽는 robots.txt에 Sitemap: 줄을 추가하고, Google Search Console과 Bing Webmaster Tools에서 파일을 제출하세요. 새로 만들거나 바뀐 페이지는 IndexNow로 Bing, Yandex, 네이버 등에 한 번에 알릴 수 있습니다.
Search Console에서 제출할 수 있는 사람은 소유 확인을 마친 소유자뿐이고, robots.txt 줄은 누구나 적을 수 있습니다. Search Console은 제출된 사이트맵의 리다이렉트를 따라가지 않으므로 최종 주소를 제출하세요. Bing은 사이트맵을 찾는 즉시 읽고, 그 뒤로는 하루 한 번쯤 읽습니다.
익명 ping은 사라졌습니다. Bing은 2022년 5월 13일에 bing.com/ping을 껐고, Google도 2023년 6월 26일에 자사 ping이 더는 동작하지 않을 것이라고 알렸습니다. 지금은 404를 응답합니다. 아직도 “Google에 ping을 보낸다”는 도구는 아무 일도 하지 않습니다.


XML 사이트맵과 HTML 사이트맵의 차이(그리고 비주얼 사이트맵)
XML 사이트맵은 크롤러용, HTML 사이트맵은 방문자를 위한 링크 목록 페이지, 비주얼 사이트맵은 구조를 짜기 위한 그림입니다. 검색엔진에 제출할 수 있는 것은 XML 사이트맵이나 TXT 목록뿐입니다.
HTML 사이트맵은 방문자에게 도움이 되고 깊은 페이지까지 링크를 퍼뜨리지만, XML 파일을 대신할 수는 없습니다. 텍스트 사이트맵은 한 줄에 URL 하나씩 적은, 확장자가 .txt인 파일일 뿐입니다.
이 생성기는 한 번의 크롤링으로 셋을 모두 만듭니다. sitemap.xml, 페이지에 붙여 넣을 HTML 사이트맵, 그리고 사이트 구조도입니다. 비주얼 사이트맵 생성기로서도 돈이 들지 않습니다. 구조도는 SVG나 PNG로 내려받을 수 있는데, 비주얼 사이트맵 서비스들은 보통 바로 이 부분에 요금을 매깁니다.
XML 사이트맵검색엔진용
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
HTML 사이트맵방문자용
Example Garden Co.
가드닝 일지화단 관리법고추 심는 법쇼핑점적관수 키트 입문 세트재배 가이드비주얼 사이트맵기획용
사이트맵이 꼭 필요한가요?
모든 페이지가 서로 링크되어 있는 작은 사이트라면 없어도 괜찮을 수 있습니다. Google은 그 기준을 약 500페이지 이하로 봅니다. 큰 사이트, 외부 링크가 적은 새 사이트, 이미지나 동영상이 많은 사이트가 가장 큰 도움을 받습니다.
Google의 SEO 기본 가이드도 사이트맵을 선택 사항이라고 하며, 제출은 명령이 아니라 힌트입니다. 그래도 품은 거의 들지 않고, 사이트맵을 만드는 크롤링에서 알아 둘 만한 것들이 드러납니다. 어떤 링크로도 닿지 않는 페이지, 메뉴가 아직 가리키고 있는 리다이렉트, 대부분이 noindex인 섹션 같은 것들입니다.
없어도 괜찮을 수 있음
약 500페이지 이하, 링크가 촘촘함
효과가 가장 큼
- 큰 사이트
- 새 사이트, 외부 링크가 적음
- 이미지나 동영상이 많음
- 사이트맵으로만 닿는 페이지 5개
Search Console의 사이트맵 오류와 해결 방법
Search Console의 사이트맵 오류는 대부분 사이트맵에 실으면 안 되는 URL, 이스케이프하지 않은 문자, 시간대가 없는 날짜, 한도를 넘은 파일 가운데 하나입니다. 아래에서는 각 오류의 원인이 되는 줄을 보여 줍니다.
허용되지 않는 URL
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
구문분석 오류
<loc>https://www.example.org/search?q=soil&page=2</loc>
날짜가 잘못되었습니다
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
지원되지 않는 형식
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
URL이 너무 많음
<url> × 50,001
사이트맵에 robots.txt에 의해 차단된 URL이 포함되어 있음
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
그 밖에: 가져올 수 없음(차단, 404, 서버 오류, 수동 조치, 낮은 크롤링 수요), 압축 오류(다시 gzip하세요), 불완전한 URL(인덱스 안의 각 파일에는 전체 URL이 있어야 합니다).
AI로 사이트맵을 만들 수 있나요?
AI는 기획 단계에서 사이트 구조를 그려 볼 수는 있지만, 사이트맵은 살아 있는 URL에 대한 사실의 목록입니다. 어떤 URL이 200을 응답하는지, 어떤 것이 noindex인지, 어떤 것이 리다이렉트하는지. 그것은 URL을 하나씩 가져와 봐야만 알 수 있습니다.
기존 사이트의 사이트맵을 모델에게 물으면 흔한 패턴을 보고 URL을 추측합니다. 상품 페이지가 이제 404를 응답한다는 것도, 태그 목록이 noindex라는 것도, 오래된 글이 리다이렉트한다는 것도 볼 수 없습니다. 파일에 들어간 그런 URL은 하나하나가 Search Console이 보고할 수 있는 항목입니다. 기획에는 AI를, 파일에는 크롤링을 쓰세요.
출처
- sitemaps.org 프로토콜과 FAQ: 형식, 50,000개 / 50 MB 한도, 인덱스, 텍스트 사이트맵
- Google 검색 센터: 사이트맵 만들기, 대규모 사이트맵, 현지화된 버전, 이미지 사이트맵, lastmod와 폐지된 ping, 사이트맵 보고서 오류
- Bing: AI 검색 시대의 사이트맵(2025년), lastmod 태그(2023년), 폐지된 ping(2022년)
- Yandex: sitemap, Naver Search Advisor: 피드, IndexNow
- RFC 9309, 이 크롤러가 따르는 robots.txt 표준
| URL | 추측 | 크롤링 |
|---|---|---|
| /blog/raised-care/ | 포함 | 사이트맵에 포함200 |
| /product/fern-varieties/ | 포함 | 4xx404 |
| /tag/native-bed/ | 포함 | noindexmeta |
| /2019/07/raised-care/ | 포함 | 리다이렉트301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | 포함 | canonical이 다른 URL→ /blog/pollinator-kit/ |
사이트맵 생성기 자주 묻는 질문
이 XML 사이트맵 생성기는 무료인가요?
제 페이지 일부가 사이트맵에 없는 이유는 무엇인가요?
sitemap.xml 파일은 어디에 두어야 하나요?
사이트맵 하나에 URL을 몇 개까지 넣을 수 있나요?
Google은 priority와 changefreq를 사용하나요?
lastmod 날짜가 없는 페이지가 있는 이유는 무엇인가요?
사이트맵에 리다이렉트나 noindex 페이지를 넣어도 되나요?
사이트맵을 Google에 제출하려면 어떻게 하나요?
CMS가 이미 사이트맵을 만듭니다. 이것도 필요한가요?
이 사이트맵 크롤러는 robots.txt를 따르나요?
JavaScript로 만든 사이트도 크롤링할 수 있나요?
IndexNow란 무엇이고, 그것이 있어도 사이트맵이 필요한가요?
부족한 점이 있습니까?기능 또는 새 도구 제안하기