











XMLサイトマップ作成ツール
無料のサイトマップ生成ツールです。検索エンジンと同じようにサイトをクロールし、検索結果に出すべきページだけを集めた sitemap.xml を作成します。そのほかのURLについては、なぜ除外したのかを1件ずつ表示します。
ドメインだけでも大丈夫です。example.org ならトップページから開始します。
- robots.txt最初に読んで従います
- 現在のサイトマップ探して比較します
- クロール済み最大500ページ、同時3件
- 判定noindex・canonical・リダイレクト
XMLサイトマップ作成の手順:sitemap.xmlを作って送信するまで
上の欄にトップページのURLを入れて「サイトマップを生成」を選びます。クローラーが robots.txt を読み、検索エンジンと同じようにリンクをたどり、載せるべきページだけを残して、サイトのルートにアップロードする sitemap.xml を渡します。
ページが載る条件は、200を返し、HTMLで、noindex でなく、canonical が自分自身を指していて、robots.txt でブロックされていないことです。それ以外のURLはすべて理由つきで「除外」に入るので、うっかりミスなのか意図した設定なのかを見分けられます。
ファイルはルート、https://www.example.org/sitemap.xml に置きます。サイトマップに載せられるのは自分と同じフォルダ以下のURLだけなので、ルートに置けばサイト全体をカバーできます(Google)。そのうえで robots.txt に Sitemap: の行を追加し、Google Search Console と Bing Webmaster Tools で送信します。
1トップページを入力
example.orgまたはURLのリストを貼り付け2クロールして判定
robots.txt 200499/500412件をサイトマップに掲載 · 87件を除外3ファイルをダウンロード
sitemap.xml93 KBXML・gzip・ZIP・TXT・HTML・CSV4アップロードして送信
/sitemap.xmlSitemap: https://www.example.org/…ルート · robots.txt · Search Console



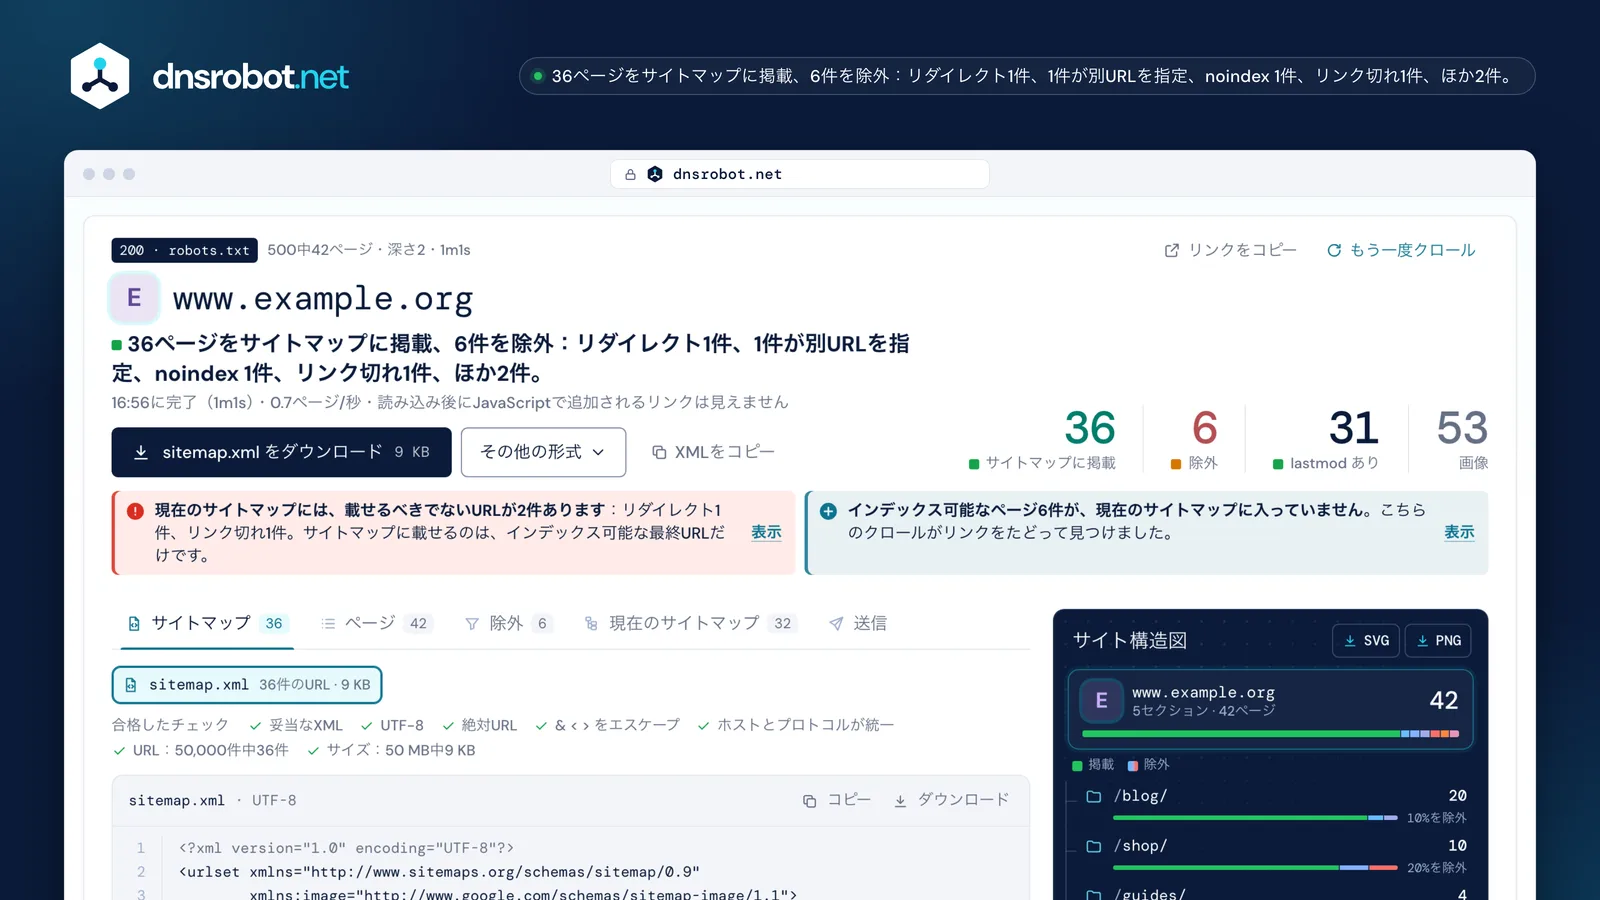
 判定何ページをサイトマップに載せ、何件をなぜ除外したのかを1文で示します。大きな数字はその繰り返しです。ダウンロードsitemap.xml、分割した場合は全ファイルとインデックスを入れたZIP。ほかに .xml.gz、TXT、HTMLサイトマップ、クロールした全ページのCSVもあります。注記現在のサイトマップの古いエントリー、抜けているページ、そして各 lastmod の日付をどこから取ったかを示します。サイト構造図各セクションのページ数と、除外した割合を表示します。枝を選ぶとページを絞り込め、SVGかPNGでダウンロードできます。
XMLサイトマップの中身は?sitemap.xml の記述例
XMLサイトマップは、1ページにつき1つの <url> エントリーを並べた UTF-8 のファイルです。必須なのは <urlset>、<url>、<loc> だけで、ほかはすべて任意です。以下は、サイトマップの記述例を1行ずつ説明したものです。
<loc> は、プロトコルから始まる完全な絶対URLで、2,048文字未満に収めます。& は & と書きます(sitemaps.org)。<lastmod> はそのページが最後に変更された日付で、2026-09-14 のようなW3C形式です。時刻は任意ですが、書くならタイムゾーンが必要です。
名前空間は https のサイトでも http:// のままです。これは解析する側のための名前であって、誰かが取得するアドレスではありません。<changefreq> と <priority> も書けますが、Google も Bing も無視します。
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 11行目で UTF-8 を宣言
- 2名前空間は http://、https:// ではない
- 3絶対URL、& は & にエスケープ
- 4実際の更新日、無ければ lastmod ごと書かない
- 5Google と Bing は無視
- 6lastmod なし:トップページはほかのページをまとめるだけ
サイトマップに載せるページと、除外されるページ
検索結果に出したい正規URLを、1ページにつき1つだけです。200を返す最終的なURLで、インデックス可能で、robots.txt でブロックされていないもの。それ以外はすべて、理由を添えて除外します。
リダイレクト、noindex のページ、canonical が別URLを指すページは、検索エンジンに矛盾した合図を送ります。サイトマップは「これをインデックスして」と言い、ページ側は違うと言っているからです。サイトマップに載せるURLと rel=canonical のURLを食い違わせないでください(Google)。また Search Console は、robots.txt がブロックしているURLを載せたサイトマップを報告します。
サイトマップのURLはあくまで提案で、どれが重複かは最終的に Google が判断します。だからこのツールは、除外したページごとに理由を表示します。意図した noindex なら問題ありませんが、一番大事な商品ページの noindex は問題です。
lastmod・changefreq・priority:検索エンジンが読むのはどれ?
Google と Bing は changefreq と priority を無視します。lastmod はどちらも使いますが、正確なときだけです。クロールのたびに変わる日付は、信用しないことを覚えさせてしまいます。
Google が lastmod を使うのは「一貫して、検証できるほど正確な」場合で、示すべきは最後の重要な変更です。本文、構造化データ、リンクのことであり、著作権表示の年を変えただけのものではありません(Google)。古いページについて新しい変更があると主張し続ける lastmod は、信用されなくなります。Bing も lastmod を見てクロールの予定を決めますが、いつも今日の日付になっているものは無視することがあります。Yandex は今も3つのタグすべてを読み取ります。
そのためこのツールは、今日の日付を書き込みません。lastmod は下の順序でページ自身のデータから取り、どこにも無ければ付けません。トップページや、ほかのページをまとめるだけのカテゴリページなら、付けなくても問題ありません。
| タグ | Bing | Yandex | |
|---|---|---|---|
| lastmod | 正確なら使う | 正確なら使う | 読み取る |
| changefreq | 無視する | 無視する | 読み取る |
| priority | 無視する | 無視する | 読み取る |
全ページが「今日」だとこう見える
412件が同じ日付です。更新日ではなく、生成した日付です。
50,000 URL、50 MB、そしてサイトマップインデックス
1つのサイトマップに入るのは、最大50,000 URL、非圧縮で50 MBまでです。先に超えたほうの上限を超えた時点で、URLを複数のファイルに分け、サイトマップインデックスにまとめて、そのインデックスを送信します。
上限の対象は非圧縮のファイルで、.xml.gz として配信する場合も変わりません(ZIPではなく gzip です)(sitemaps.org)。インデックスに載せられるサイトマップは最大50,000件で、同じサイトにあり、自分と同じフォルダ以下にあるファイルに限られます。インデックスの中に別のインデックスは入れられません。Naver Search Advisor は10 MBを超えるファイルを受け付けないので、韓国向けのサイトでは詳細オプションで10 MBの上限を選んでください。
言語の代替URL(xhtml:link)は50,000件の上限には数えません。このツールは自動で分割し、指定すればセクションごとにも分けます。ブログに1ファイル、商品に1ファイルという具合です。
4.4 MB
4.6 MB
4.5 MB
2.9 MB
画像と hreflang のエントリー
サイトマップには、各ページの画像や、ほかの言語版を、そのページ自身の <url> エントリーの中に並べることもできます。
画像は Google の画像用の名前空間を使い、1ページにつき最大1,000件までです。今も意味があるのは <image:image> と <image:loc> だけで、caption、title、license、geo_location は2022年に廃止されました。
言語については、各エントリーに自分自身を含むすべての版を、xhtml:link と hreflang のコードで並べます。コードは ISO 639-1 の言語に、任意で ISO 3166-1 の地域を添えたもので、地域だけを書くことはできません。リンクは双方向でなければGoogle は無視するので、このツールはどの版も相互にリンクしているクラスタだけを書き出し、残りは不備の内容とともに表示します。x-default は任意で、用意していない言語の訪問者向けです。
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja は de にリンクしているが、de からは返ってこない:このクラスタは書き出さない画像のエントリー 1ページにつき最大1,000件
サイトマップを Google と Bing に送信するには?
どのクローラーも読む robots.txt に Sitemap: の行を追加し、Google Search Console と Bing Webmaster Tools でファイルを送信します。新しいページや更新したページは、IndexNow を使えば Bing、Yandex、Naver などにまとめて知らせられます。
Search Console で送信できるのは、所有権を確認したサイトの所有者だけです。robots.txt の行なら誰でも書けます。Search Console は送信されたサイトマップのリダイレクトをたどらないので、最終的なアドレスを送信してください。Bing はサイトマップを見つけ次第読み取り、その後は1日1回ほど読み取ります。
匿名の ping はもうありません。Bing は2022年5月13日に bing.com/ping を停止し、Google も2023年6月26日に自社の ping を終了すると告知しました。現在は404を返します。今も「Google に ping を送る」とうたうツールは、何もしていません。


XMLサイトマップとHTMLサイトマップの違い(とビジュアルサイトマップ)
XMLサイトマップはクローラー向け、HTMLサイトマップは訪問者向けのリンク一覧ページ、ビジュアルサイトマップはサイト構造を考えるための図です。検索エンジンに送信できるのは、XMLのものか、TXTの一覧だけです。
HTMLサイトマップは訪問者の役に立ち、深い階層のページにもリンクを行き渡らせますが、XMLファイルの代わりにはなりません。テキスト形式のサイトマップは、1行に1つのURLを並べただけの、拡張子が .txt のファイルです。
このツールは1回のクロールから3つとも作ります。sitemap.xml、ページに貼り付けられるHTMLサイトマップ、そしてサイト構造図です。ビジュアルサイトマップの作成ツールとしても費用はかかりません。構造図はSVGかPNGでダウンロードでき、ビジュアルサイトマップのサービスでは通常これが有料です。
XMLサイトマップ検索エンジン向け
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
HTMLサイトマップ訪問者向け
Example Garden Co.
園芸日誌レイズドベッドの手入れ唐辛子の植え方ショップ点滴灌水キット 入門セット栽培ガイドビジュアルサイトマップ設計向け
そもそもサイトマップは必要ですか?
すべてのページが互いにリンクしている小さなサイトなら、無くても困らないかもしれません。Google はその目安を500ページ程度以下としています。効果が大きいのは、大規模なサイト、外部からのリンクが少ない新しいサイト、画像や動画が多いサイトです。
Google 自身のスタートガイドもサイトマップは任意としており、送信はあくまで合図で、命令ではありません。とはいえ手間はほとんどかからず、作るためのクロールから知る価値のあることが見えてきます。どのリンクからもたどれないページ、メニューが今も指しているリダイレクト、ほとんどが noindex になっているセクションなどです。
無くても困らないかもしれない
500ページ程度以下で、リンクが行き届いている
効果が大きい
- 大規模なサイト
- 新しいサイト、外部からのリンクが少ない
- 画像や動画が多い
- サイトマップからしかたどれないページ5件
Search Console のサイトマップエラーと、その直し方
Search Console のサイトマップエラーのほとんどは、載せてはいけないURL、エスケープしていない文字、タイムゾーンの無い日付、上限を超えたファイルのどれかです。下では、それぞれの原因になる行を示します。
許可されていない URL
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
解析エラー
<loc>https://www.example.org/search?q=soil&page=2</loc>
無効な日付
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
サポートされていない形式
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
URL の制限数超過
<url> × 50,001
robots.txt によってブロックされている URL がサイトマップに含まれています
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
そのほか:取得できませんでした(ブロック、404、サーバーエラー、手動による対策、クロールの必要性が低い)、圧縮エラー(gzip し直してください)、不完全な URL(インデックス内の各ファイルには完全なURLが必要です)。
AIでサイトマップを作成できますか?
AIはサイト構造の下書きには使えますが、サイトマップは生きているURLについての事実の一覧です。どれが200を返し、どれが noindex で、どれがリダイレクトするのか。実際に1つずつ取得しなければ分かりません。
既存サイトのサイトマップをモデルに頼むと、よくあるパターンからURLを推測します。商品ページが今は404になっていることも、タグ一覧が noindex であることも、古い記事がリダイレクトすることも見えません。そうしたURLは1件ずつ、Search Console が報告する対象になります。設計にはAIを、ファイルにはクロールを使ってください。
出典
- sitemaps.org のプロトコルとFAQ:形式、50,000件 / 50 MB の上限、インデックス、テキスト形式のサイトマップ
- Google 検索セントラル:サイトマップの作成、大規模なサイトマップ、各言語版のページ、画像サイトマップ、lastmod と廃止された ping、サイトマップレポートのエラー
- Bing:AI時代の検索とサイトマップ(2025年)、lastmod タグ(2023年)、廃止された ping(2022年)
- Yandex:サイトマップ、Naver Search Advisor:フィード、IndexNow
- RFC 9309。このクローラーが従う robots.txt の標準です
| URL | 推測 | クロール |
|---|---|---|
| /blog/raised-care/ | 載せる | サイトマップに掲載200 |
| /product/fern-varieties/ | 載せる | 4xx404 |
| /tag/native-bed/ | 載せる | noindexmeta |
| /2019/07/raised-care/ | 載せる | リダイレクト301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | 載せる | canonical が別URL→ /blog/pollinator-kit/ |