そのほかのすべてのクローラー
User-agent: *
専用のグループを持たないすべてのクローラーが読みます。
- サイト全体を許可します。
Google は無視し、Bing は読み取ります。
テーマ
信頼できる robots.txt を作成できます。各ルールを入力したそばから解説し、ファイルは当サイトのrobots.txtテスターが RFC 9309 と Google 自身の解釈に照らして読み直します。公開する前に、どのクローラーのどのパスについても、判定をその場で確認できます。
ファイルはホストとプロトコルごとに1つです。www.example.com と example.com には、それぞれ別のファイルが必要です。
出典:RFC 9309(2026年10月26日に確認)
専用のグループを持たないすべてのクローラーが読みます。
既知のクローラーごとに扱いを選んでください。専用のグループを持つクローラーは、そのグループだけを読みます。
検索インデックスを作るためにクロールします。ブロックしたページも、ほかのページからのリンクをもとに検索結果に載ることがありますが、ページの中身は何も読まれません。
モデルを学習させるためにページを収集します。トークンが別なので、検索結果には表示されたまま、学習だけを拒否できます。
質問に答えるためにページを取得し、あなたのサイトへのリンクを添えます。
人に頼まれたときに1ページだけ取得します。そのため、robots.txt を無視する場合があると述べている運営元もあります。
これらを拒否すると、拒否されるのはクロールではなく人です。誰かがAIアシスタントにあなたのページを開くよう頼んでも、ファイルに従うアシスタントはその人のためにページを読みません。拒否したいのが学習なら、上の学習用クローラーを拒否してください。
リンクプレビュー、サイト所有者向けツール、広告の確認、アーカイブ、そして運営元が別の役割を説明しているか、何も説明していないクローラーです。
あなたの robots.txt/robots.txt
User-agent: *Allow: /エラー警告注記500 KiB中23 B
警告1件
対処法 ファイルの中で最も手軽な行で、どのクローラーも読みます。サイトマップの完全なアドレスを付けて Sitemap: を追加してください。
クローラーとパスを選んでください。判定、それを決めたルール、クローラーが読むグループは、robots.txtテスター自身の照合ロジックで出しています。
このクローラーはこのURLをリクエストできます。
User-agent: *1行目から
このクローラーを指定するグループが無いため、* のグループが適用されます。
Allow: /2行目
/any-page
/
照合するのはパスとクエリだけで、パーセントエンコード後に1バイトずつ比較します。ホスト、スキーム、フラグメントはルールの対象になりません。
ルールを書き、robots.txt という名前の UTF-8 のプレーンテキストファイルとして保存し、サイトの最上位にアップロードして、https://example.com/robots.txt で配信されるようにします。送信の手順はありません。クローラーは自分からそのアドレスを取得しに来ます。
Google はこれを3つの文にまとめています。「ファイル名は『robots.txt』にする必要があります。各サイトに配置できる robots.txt ファイルは 1 つだけです。robots.txt ファイルは、適用するサイトホストのルートに配置する必要があります」。ファイルは「UTF-8 でエンコードされたテキスト ファイル」でなければならず、アップロードすれば「Google のクローラーが自動的に検出して使用を開始します」。
上の作成ツールはプリセットから始まり、入力したそばから各ルールを解説し、コピーする前に当サイトのrobots.txtテスターのパーサーと照合ロジックで結果を読み直します。ダウンロードするファイルの名前は robots.txt です。バイトオーダーマークなしの UTF-8、改行は LF のみで、頼んでいない日付やコメントは入りません。
https://example.com/robots.txt送信の手順はありません。Google のクローラーが自分でファイルを見つけます。
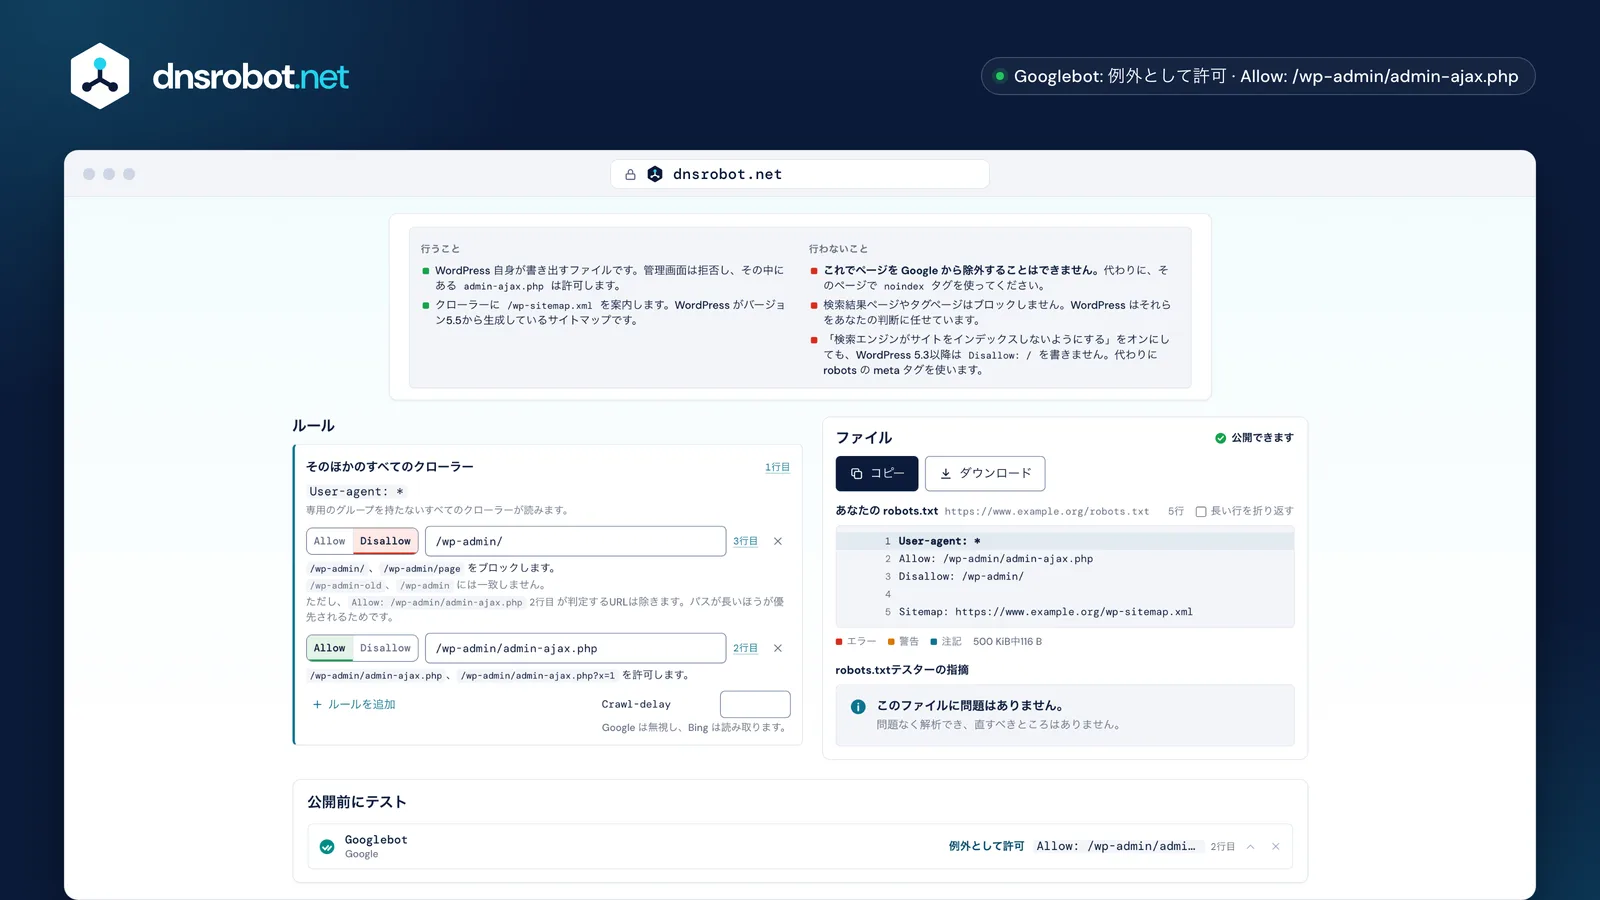
 プリセットが行うことそして行わないこと。どのプリセットもページを Google から除外するものではなく、それぞれがそう明記しています。各ルールの解説ルールがブロックするパスと取りこぼすパスを、すべての判定を決めるのと同じ照合ロジックで示し、例外を作る長いルールも表示します。ファイルと指摘事項行番号付きのファイルです。コピーする前に、robots.txtテスター自身の監査で読み直します。判定クローラーとパスを選ぶと、許可かブロックか、それを決めたルールとその行、クローラーが読むグループを表示します。
グループと Sitemap の行です。グループはクローラーを指定する1行以上の User-agent の行で始まり、そのクローラーが従う Allow と Disallow のルールが続きます。Sitemap の行はどのグループにも属さず、単独で置きます。
RFC 9309 はグループを「1行以上の user-agent 行と、それに続く1つ以上のルール」と定義しており、クローラーが従うグループはちょうど1つです。自分のプロダクトトークンを指定したグループか、それが無ければ * のグループです。Google が読むフィールドは user-agent、allow、disallow、sitemap の4つだけで、ほかは読みません。
フィールド名は大文字と小文字を区別しませんが、パスは区別します。Google 自身の例でも、disallow: /file.asp は /file.asp に適用されますが、/FILE.asp には「適用されません」。Sitemap: の行は、プロトコルとホストを含む完全なアドレスでなければなりません。このツールはそれ以外の書き方を受け付けず、その理由を表示します。
User-agent: *専用のグループを持たないすべてのクローラー向けのグループを開始Disallow: /cart/これらのクローラーが取得してはいけないパスAllow: /cart/help例外:Disallow より長いので優先される User-agent: GPTBot2つのクローラーを指定するグループを開始User-agent: ClaudeBotDisallow: /どちらもサイト全体を拒否される Sitemap: https://www.example.org/sitemap.xmlどのグループにも属さない:完全なアドレス* と $:ルールが一致する仕組み1つのURLに複数のルールが一致した場合、種類にかかわらずパスが最も長いルールが優先され、同じ長さなら Allow が優先されます。* は任意の文字列を、$ はURLの末尾を表し、パスの中でほかに特別な意味を持つ文字はありません。
RFC 9309:「最も具体的な一致を使わなければならない(MUST)。最も具体的な一致とは、最も多くのオクテットを持つ一致である」、そして「allow ルールと disallow ルールが同等であれば、allow ルールを使うべきである(SHOULD)」。WordPress 自身のファイルもこの仕組みで動いています。Disallow: /wp-admin/ がフォルダを閉じ、より長い Allow: /wp-admin/admin-ajax.php がその中の1つのファイルを開けます。
$ の無いルールは前方一致なので、Disallow: /admin は /administrator もブロックします。フォルダを指すときはスラッシュを付けてください(/admin/)。上のエディターは各ルールの下に、そのルールが一致するパスと一致しないパスの例を、すべての判定を決めるのと同じ照合ロジックで表示し、ほかのルールに常に負けるルールには印を付けます。
* と $、それぞれのパターンが実際に一致するもの/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?、.、[、+ はただの文字です。robots.txt に正規表現はありません。
/admin/report.pdfAllow が優先:パスのより多くの部分に一致しているため。
Disallow: /files/7文字Allow: /files/7文字長さが同じなので Allow が優先。Google の言う「制限が最も少ないルール」です。
3つとも最初から robots.txt を配信しており、上のプリセットは各プラットフォーム自身のドキュメントが説明する内容を書き出します。WordPress は管理画面を拒否しつつ admin-ajax.php を許可し、Shopify はカート、チェックアウト、絞り込みや並べ替えをしたコレクションを拒否し、Next.js は app/robots.txt に置いたファイルを配信します。
WordPress はファイルをコードで、do_robots() の中で書き出します。User-agent: *、管理画面のパスへの Disallow、admin-ajax.php への Allow、そして公開サイトでは WordPress 5.5以降、/wp-sitemap.xml を指す Sitemap: の行です。「検索エンジンがサイトをインデックスしないようにする」をオンにすると、WordPress 5.3以降は Disallow: / を書かなくなり、代わりに robots の meta タグを使います。
Shopify は、既定のファイルは「ほとんどのストアで問題なく機能する」と述べています。アップロードするファイルは無く、変更するにはテーマの robots.txt.liquid テンプレートを編集する必要があり、Shopify はこれを「サポート対象外のカスタマイズ」と呼んでいます。Next.js は app/robots.txt を書かれたとおりに配信するか、app/robots.ts からファイルを生成します。
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlWordPress 自身が書き出します。プラグインか robots_txt フィルターで変更します。
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlShopify の既定のファイルです。テーマの robots.txt.liquid テンプレートで変更します。
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlapp/robots.txt に置いた自分のファイル、または app/robots.ts から作るファイル。/robots.txt で配信されます。
クローラーを指定したグループの下に Disallow: / を書けば、robots.txt に従うと運営元が述べているクローラーには効きます。効くのはそれらだけです。これはクローラーが尊重するお願いであって鍵ではなく、ファイルを無視するクローラーはどのページでも取得できます。
ほとんどのAI企業は複数のクローラーを運用しているので、役割ごとに決めてください。GPTBot や ClaudeBot のような学習用クローラーを拒否すれば、モデルのためにページを収集するクローラーを拒否できます。OAI-SearchBot や PerplexityBot のような回答用クローラーを拒否すると、それらのアシスタントが表示するリンクからも外れます。Google の学習用トークンは Googlebot ではありません。「Google-Extended が Google 検索でのサイトの登録に影響したり、Google 検索でのランキング シグナルとして使用されたりすることはありません」。
3つ目の種類は性質が違います。ChatGPT-User、Claude-User、Perplexity-User、Amzn-User は、人がアシスタントにページを開くよう頼んだために1ページを取得するので、拒否するとその人を拒否することになります。しかも、これらの取得はいずれにしても robots.txt を無視する場合があると述べている運営元もあります。上のクローラー一覧でこれらを独立したセクションにしているのは、そのためです。
GPTBot従うOAI-SearchBot従うChatGPT-User無視する場合ありClaudeBot従うClaude-SearchBot従うClaude-User従うPerplexityBot従うPerplexity-User無視する場合ありGoogle-Extendedトークンのみ該当クローラーなし該当クローラーなしApplebot-Extendedトークンのみ該当クローラーなし該当クローラーなしmeta-externalagent従うmeta-webindexer従うmeta-externalfetcher無視する場合ありAmazonbot従う該当クローラーなしAmzn-User無視する場合ありrobots.txt はクローラーにページを取得しないよう求めるもので、検索エンジンに掲載しないよう求めるものではありません。ほかのページからリンクされていれば、Google は「URL をインデックスに登録して、スニペットなしで検索結果に表示することはできます」。ページを除外するには noindex を使い、そのタグを読めるよう、ページはクロール可能なままにしてください。
Search Console ではこれを「robots.txt によりブロックされましたが、インデックスに登録しました」と呼びます。そして Google ははっきり述べています。「noindex ディレクティブを有効にするためには、robots.txt ファイルでページやリソースをブロックせず、クローラがページにアクセスできるようにする必要があります」。Disallow したページ自身の noindex は決して読まれません。クローラーがそのページを取得しないからです。
だから上のどのプリセットも、行わないことを明記しています。ステージング用プリセットの Disallow: / はルールを守るクローラーを締め出しますが、どこかからリンクされたステージングのURLは掲載されることがあります。ステージング環境はパスワードで保護し、その行を本番サイトには決して持ち込まないでください。
<meta name="robots" content="noindex">読まれないページを除外するには:クローラーを入れて noindex を使うか、ログインを必須にする。
適用するホストのルートに /robots.txt として、ホストとプロトコルごとに1つ置きます。https://example.com/robots.txt は https://www.example.com についても https://shop.example.com についても何も定めません。それぞれに専用のファイルが必要で、フォルダの中の robots.txt は決して読まれません。
Google:「robots.txt ファイルは、サイトの最上位ディレクトリに配置し、サポート対象プロトコルでアクセスできるようにする必要があります」。Search Console の robots.txt レポートは、プロパティの上位20ホストのファイルを個別に一覧表示し、HTTP と HTTPS も別々に数えます。
作成ツールの一番上にサイトを入力すると、ファイルを配信すべき正確なアドレスを示し、そのホスト用の Sitemap: の行を入力し、robots.txtテスターへのリンクを表示します。ファイルを公開したら、テスターで公開中のファイルを読み取れます。
https://example.com/robots.txthttps://example.com 上のすべてのURLhttps://www.example.com/robots.txtwww.example.com のみ:別のホストhttp://example.com/robots.txthttp:// のサイトのみ:別のプロトコルhttps://shop.example.com/robots.txtshop.example.com のみhttps://example.com/blog/robots.txtなし:フォルダ内の robots.txt は決して読まれないGoogle はどれも読みません。Crawl-delay は Bing が、Clean-param は Yandex が読み、Host は標準にも Google の一覧にも無く、Cloudflare の Content-Signal はクロールしてよい範囲ではなく、コンテンツの利用目的を表明するものです。
Google は4つのフィールドを挙げ、「crawl-delay などの他のフィールドはサポートしていません」と付け加えています。Bing 自身のブログによると「crawl-delay ディレクティブに指定できる値は、正の整数だけ」なので、このエディターは小数を書き出さずに受け付けません。現在の Bing のヘルプページは読めず、値の範囲や単位を確認できなかったため、このページではどちらも記載していません。
どれもファイルを壊しはしません。RFC 9309 は、ほかのレコードの解析が「明示的に定義されたレコードの解析を妨げてはならない(MUST NOT)」と定めています。4つのうち、このツールが書き出すのは Crawl-delay だけで、誰が読むかを明記します。
User-agent読む読む読むAllow読む読む読むDisallow読む読む読むSitemap読む読む読むCrawl-delay無視する読む未確認Clean-param無視する無視する読むHost無視する無視する未確認noindex無視する未確認未確認Content-Signal無視する未確認未確認テストは2回です。公開する前に、上の公開前にテストでクローラーとパスを選び、判定を決めるルールを確認します。アップロードした後は、公開中のファイルを robots.txtテスターでチェックします。サーバーが何を返すかは、ファイルに何が書いてあるかと同じくらい重要だからです。
404を返すファイルはファイルが無いものとして読まれ、どのクローラーもすべてを取得できます。500や503を返す場合、標準に従うクローラーは何も取得してはいけません。RFC 9309 §2.3.1.4:クローラーは「完全な禁止を想定しなければならない(MUST)」。Google はこれを独自の段階的な対応で和らげており、その内容は図に示しています。
Google 自身の robots.txt テスターは終了しました。Google 検索セントラルが2023年11月15日に終了を告知し、その代わりとなった robots.txt レポートは Google が取得したファイルを表示するだけで、URLをルールに対してテストすることはできません。そのテストを行うのが、上の作成ツールにある公開前にテストとrobots.txtテスターです。
200ファイルのルールに従う。301, 302少なくとも5ホップたどり、そこで止まる。その後 Google はファイルを404として扱う。403, 404ファイルが無いものとして、すべてクロールする。429何もクロールしない。Google はこれを4xxではなく5xxの側に数える。500, 503標準に従い、一切クロールしない。存在しない名前読み取るサイトが無いため、判定も無い。致命的な間違いは、どれも短い1行です。ステージングから残った Disallow: /、意図より広く一致する前方一致、パスで書かれた Sitemap: の行、先頭のスラッシュが無いパス、そして Google が2019年に読まなくなった noindex の行です。
どれも、ファイルをコピーする前にここで見つかります。robots.txtテスター自身の監査が入力に合わせて実行され、その指摘はファイルの下に並びます。クローラーが受け付けない行はそもそも書き出さず、その理由はエディターの該当する行に表示します。
1行ではなく、組み合わせの間違いもあります。ここで Disallow したURLが、ページ側でも noindex を付けている場合です。クローラーはページを取得しないので noindex を目にすることがなく、URLは検索結果に残り続けることがあります。どちらか1つを選んでください。クロールをブロックするか、クロールさせたうえでインデックスに登録しないよう伝えるかです。
Disallow: /ステージングの名残:公開中のサイト全体が、すべてのクローラーに閉じている。Disallow: /admin/administrator や /admin-tools もブロックする。末尾にスラッシュを付ける。User-agent: * の下の Allow: /ファイル内のどこかに専用のグループがあるクローラーには読まれない。Sitemap: /sitemap.xmlSitemap の行は、ホストを含む完全なアドレスでなければならない。Disallow: adminパスは / から始まる。このルールは何にも一致しない。noindex: /private/2019年以降は無効。ページはクロールもインデックス登録もされたまま。* のグループをまったく読まない場合です。上のエディターはほかのルールに常に負けるルールに印を付け、公開前にテストは判定を決めたルールとクローラーが読んだグループを表示します。サイトのrobots.txtを取得し、URLがGooglebotやAIクローラーにブロックされていないかをテストして、構文エラーを検出
ウェブサイトをクロールし、XMLサイトマップ、HTMLサイトマップ、サイト構造図を取得
ウェブサイトのXMLサイトマップを見つけて検証:構文、URLの上限、lastmodの日付、robots.txtとの矛盾、リンク切れやリダイレクトするURL
ページのtitle、メタディスクリプション、canonical、hreflang、OGP、Xカードのタグを確認し、GoogleとSNSでの表示をプレビュー
HTTPレスポンスヘッダーとセキュリティヘッダーのグレーディング分析
User Agent文字列からブラウザ、OS、デバイスタイプ、レンダリングエンジン、CPU情報を検出