











リンク解析ツール
内部リンク・外部リンクのチェックとリンク分析を、Googleの読み方に合わせて行えます。ページ内のすべてのリンクについて、内部か外部か、followかnofollowか、sponsoredかugcか、実際の到達先はどこか、どれがリンク切れかを確認できます。
ドメインだけでもかまいません。example.orgと入力すると、トップページを読み込みます。
- 取得HTMLを1回読み込み
- リダイレクト最大10回、各ホップを確認
- Robotsmeta + X-Robots-Tag
- 検出したリンク<a>と<area>
リンク解析ツールは何をチェックしますか?
リンク解析ツールは1つのページを読み込み、そこにあるすべてのリンクを一覧にします。各リンクの行き先、検索エンジン向けの指定、アンカーテキストの内容、そして実際にたどったときの到達先までわかります。
ページのHTMLを、Googlebotが最初に見るのと同じ形で読み込みます。Googleがたどるのは、hrefを持つ<a>要素です(Google)。相対リンクは、ページの<base href>を基準に解決し、ない場合はリダイレクト後のアドレスを基準にします(HTML)。
その後、重複しない各URLを、GETで1回ずつリクエストし、リダイレクトを1ホップずつ追跡します。HEADリクエストのほうが速いものの、サーバーが実際の訪問とは違う応答を返すことが多いため、リダイレクトの先が404になるリンクも、ここではリンク切れとして数えます。
- 1行き先外部www.rfc-editor.org
- 2指定nofollowmw:extlink保持されるが、SEO上の意味はなし
- 3テキスト“1035”
- 4到達先↳ 301 /info/rfc1035/OK 200185 ms
- 5位置1,117件中187番目のリンク、「Contents」の下
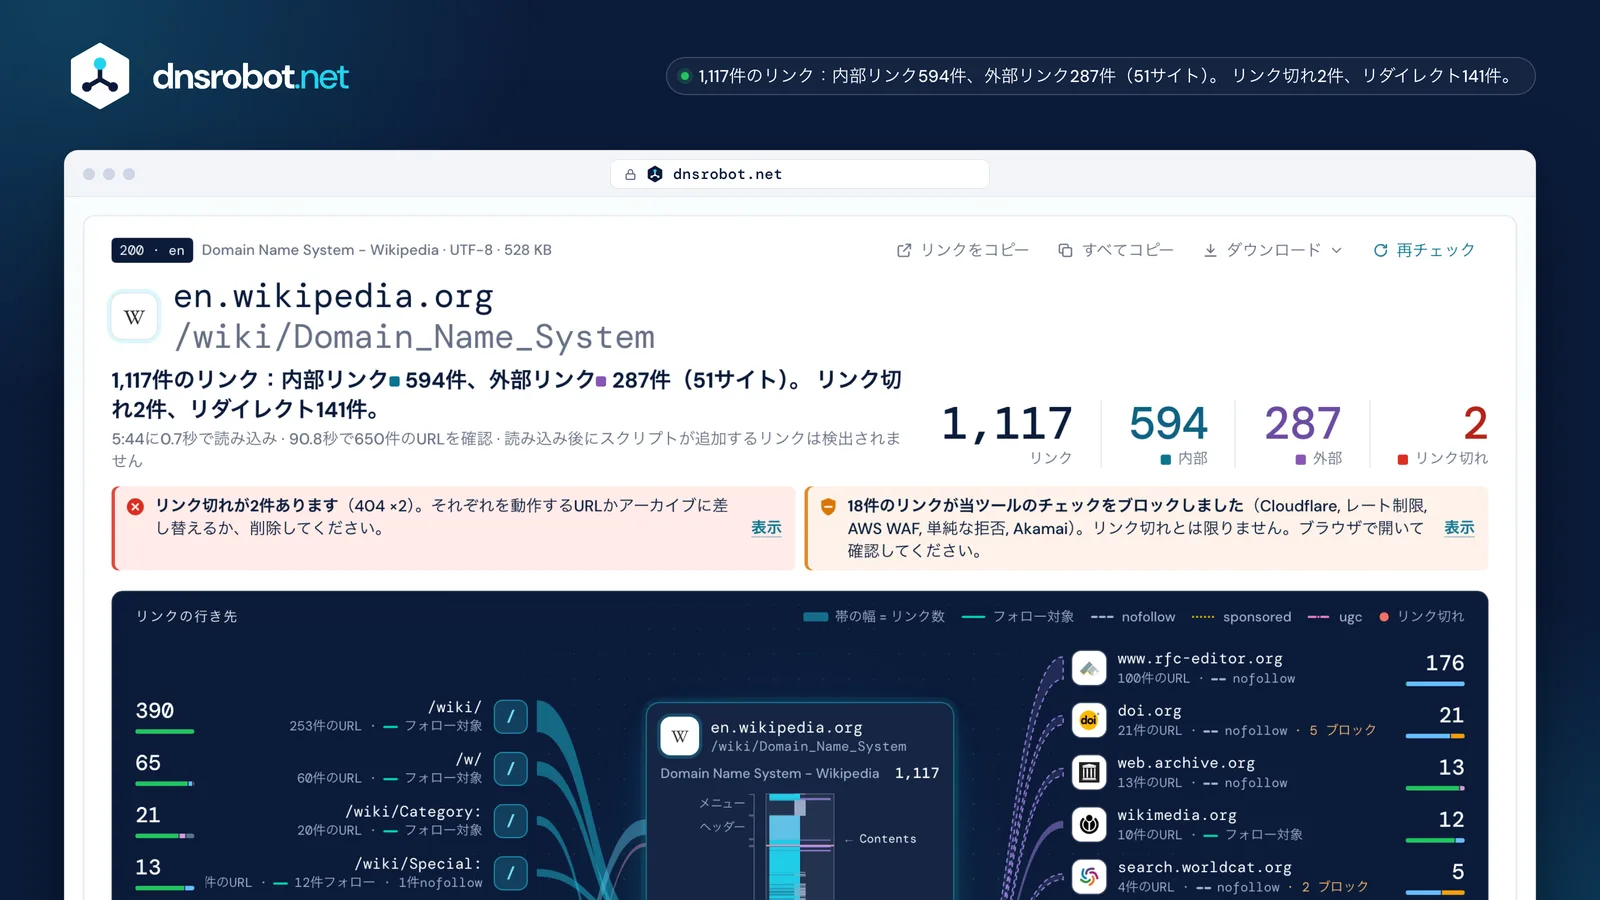
 まず答えをページのリンクの総数、サイト内にとどまる数、外へ出ていく数、リンク切れの数です。対処法つきの注記リンク切れ、ボット対策に止められただけのリンク、更新したほうがよいリダイレクト、空のアンカーを、それぞれの件数と対処法とともに示します。ページの上から下まで各リンクがページのどこにあるかを目盛り1つで表示します:メニュー、本文、参考文献、フッター。リンクの行き先セクションごと、サイトごとに1本の帯を、リンクの数に応じた幅で表示します。nofollowのリンクは破線です。
内部リンクと外部リンクのチェック:何がどちらになる?
内部リンクは、ページと同じホストを指すリンクです。外部リンクは、別のWebサイトを指すリンクです。同じサイトの別のホスト(たとえば、en.wikipedia.orgから見たde.wikipedia.org)へのリンクは、別に数えます。
内部リンクは、読者とクローラーがサイトの他のページを見つける助けになります。重要なページはすべて、他の少なくとも1ページからリンクされているべきです(Google)。外部リンクそのものがリスクになることはありません。信頼できる情報源を引用すれば、読者がページを信頼する助けになります。
Googleがnofollowを勧めるのは、自分が保証できないリンクだけで、外部リンクすべてではありません。#sectionへのリンクは同じページにとどまり、Googleはフラグメントを別のページとして扱いません(Google)。
- 同じホスト 514
- 同一サイト、別のホスト 80
- 別のサイト 287
- 同一ページ 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_name内部ページと同じホスト:内部リンクです。
- de.wikipedia.org/wiki/Domain_Name_System同一サイト同一サイト(wikipedia.org)の別のホスト:別に数えます。
- www.wikidata.org/wiki/Q8767外部Wikimediaが運営していても、別のドメイン:外部リンクです。
- www.rfc-editor.org/rfc/rfc1035外部別のドメイン:外部リンクです。
nofollow、sponsored、ugc(そして「dofollow」が属性ではない理由)
rel="nofollow"は、そのリンクを自分の推薦として数えないよう検索エンジンに求めるものです。rel="sponsored"は有料リンクや広告を、rel="ugc"はユーザーが書いたリンクを示します。どれも付いていないリンクはたどられます。dofollowという値はありません。
2019年9月10日からこの3つはすべて命令ではなくヒントとして扱われ、2020年3月1日からはクロールとインデックスについてもヒントです(Google)。ugc nofollowのように、スペースまたはカンマで区切って組み合わせることもできます。
最も重要なのは、sponsoredもnofollowもない有料リンクはGoogleのスパムに関するポリシーに違反するという点です(Google)。読み込んだWikipediaの記事では、外部リンク287件のうち267件にnofollowが付いています。MediaWikiがすべての出典に付けているためです。
<a href>デフォルトでフォロー:追加するものはありませんrel="nofollow"推薦しない:他の値に当てはまらないときrel="sponsored"有料または広告:有料リンクに必要(nofollowでも可)rel="ugc"ユーザーが書いた:コメント、フォーラムの投稿rel="ugc nofollow"両方:可。古いクローラー向けrel="dofollow"値ではありません:ブラウザもGoogleも無視します
- 2005Googleがnofollowを導入
- 2019-09-10sponsoredとugcが登場。3つともヒントに
- 2020-03-01クロールとインデックスでもヒントに
ページ自体がnofollowを指定していたら?
その場合、Googleは各リンクのrelにかかわらず、ページ内のどのリンクもたどりません。nofollowを指定したrobots metaタグやX-Robots-Tagヘッダーはページ全体に適用されます。このツールは各リンクに「nofollow(ページ)」と表示します。
Googleはrobotsとgooglebotの名前を大文字小文字を問わず、本文内にあっても読み取ります。noneはnoindexとnofollowを合わせた指定です(Google)。同じルールは、X-Robots-Tag: nofollowのようなヘッダーとしても指定できます。
Wikipediaの版の履歴ページには、意図的にnoindex,nofollowが付いています。このツールの以前のバージョンはこのタグを読んでおらず、履歴ページの最初の200件のリンクのうち194件をフォロー対象として数えていました。
最初の200件のリンクのうち:metaタグを読んでいませんでした
件のリンクはすべてnofollow(ページ):Googleはどれもたどりません
543 nofollow(ページ)6 nofollowX-Robots-Tag: none
リンク切れの見つけ方と直し方
リンク切れとは、URLが404 Not Foundや410 Goneなどのエラーを返す、そうしたエラーにリダイレクトされる、または名前自体が存在しないリンクのことです。ページを解析してから、「リンク切れ」タブを開いてください。
直し方は、ページの新しいアドレスにリンクする、アーカイブされたコピーにリンクする、またはリンクを外すかです。Googleは4xxのページをインデックスから外します(Google)。リンクをたどった読者も、どこにも行き着けません。
エラーがすべてリンク切れとは限りません。401はログインを求めるもので、ページは存在します(RFC 9110)。5xxやタイムアウトは自然に解消することも多いので、後でもう一度確認してください。読み込んだ記事では、656件のURLのうち2件がリンク切れで、どちらも参考文献にありました。もう1件は単純な403を返したため、ブロックとして表示しています。
- umbrella.cisco.com404
ページが削除されている
Ciscoがブログ記事を終了しました。サーバーもその旨をはっきり返しています。
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeweb.archive.orgのアーカイブにリンクするか、リンクを削除してください。- http://www.apwg.org301
- https://…/1H2010.pdf404
404で終わるリダイレクト
http://からhttps://に移動しますが、PDFがありません。リダイレクトではなくリンク切れとして数えます。
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfレポートの現在の場所を探すか、アーカイブを引用してください。- www.akamai.com403
単純な403:ブロックであり、リンク切れではない
ボット対策の兆候はなく、サーバーが当ツールのチェックを拒否しました。ファイルがなくなっているか、サーバーがボットを断っている可能性があります。
www.akamai.com/dl/technical_publications/network_overview_osr.pdfブラウザで開いてください。開けるなら、そのままで問題ありません。

リンクのリダイレクト:直すべき?
リダイレクトするリンクも動作はしますが、ホップのたびにリクエストと時間がかかります。リンクは最終的なアドレスに向けましょう。特に、両端を自分で管理できる自サイト内のリンクで効果があります。
301や308は恒久的な移動を、302、303、307は一時的な移動を示し、Googleは古いアドレスを表示し続けます(Google)。Googlebotは最大10ホップ、ブラウザは最大20ホップまでたどります(Google)。
rfc-editor.orgは現在、/rfc/のページを/info/に転送しているため、読み込んだ記事のリンク175件が余分に1ホップかかります。404で終わるリダイレクトは、ここではリダイレクトではなくリンク切れとして数えます。
- doi.org/10.17487/RFC1035302302:一時的。古いURLを使い続ける
- www.rfc-editor.org/info/rfc1035301301:恒久的に移動。新しいURLにリンクする
- www.rfc-editor.org/info/rfc1035/200
件のリンクがrfc-editor.org/rfc/…を指していて、現在は/info/…に転送されます
ページの656件のURLのうちリダイレクトする数
Googlebotがたどる最大ホップ数。ブラウザは20回であきらめます
「ここではブロックと表示されるが、ブラウザでは開ける」
多くのサイトは、ページの前にボット対策を置いています。JavaScriptを実行しない、またはスクリプトのように見えるアクセスを止めるため、お使いのブラウザは通過できても、当ツールのチェックは403や429を受け取ります。こうしたリンクは、リンク切れではなく「ブロック」として表示します。
Cloudflareは、チャレンジにcf-mitigated: challengeヘッダーを付けます(Cloudflare)。また、通常と異なるユーザーエージェントのクライアントには、デフォルトでチャレンジを出します。429はリクエストが多すぎることを意味します(RFC 6585)。
当ツールは偽りのないユーザーエージェントを送り、対策の回避は試みません。読み込んだ記事では18件のURLがブロックされました。17件はCloudflare、AWS WAF、Akamai、レート制限によるもので、1件は単純な403でした。何かを変更する前に、ご自身で開いて確認してください。
- Cloudflareのチャレンジ7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- レート制限(429)3search.worldcat.org · api.semanticscholar.org · 429
- Akamaiのボット対策1dyn.com → www.oracle.com · 403
1ページに置けるリンクの数は?
上限はありません。Googleのガイダンスには数の指定がなく、理想的な数もないとされています。リンクを100件未満に抑えるという昔のアドバイスは、Googleがページの一部しか読み込まなかった時代のものです。
大切なのは、各リンクが読者の役に立つこと、重要なリンクがHTML内の本物の<a href>リンクであること、そしてGoogleが検索用に読み込むHTMLの最初の2 MB以内にあることです(Google)。
読み込んだWikipediaの記事には、528 KBのHTMLに1,117件のリンクがあります。example.comはHTML内にリンクが1つもありません。唯一のリンクは、ページの読み込み後にスクリプトが追加するものです。
- wikipedia.org/wiki/Domain_Name_System1,117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0唯一のリンクはスクリプトが追加
アンカーテキストと画像リンク
アンカーテキストとは、リンクのクリックできる文字のことで、リンク先の内容を読者とGoogleに伝えます。画像リンクの場合、Googleは画像のalt属性をアンカーとして読み取るため、altが空の画像リンクは何も伝えません。
よいアンカーは、短く具体的で、リンク先を説明するものです。「こちらをクリック」や「続きを読む」では何も伝わりません(Google)。リンクに文字がない場合、Googleはtitle属性を代わりに使います。
このツールは、すべての画像リンクのalt属性を表示し、空のものに印を付け、繰り返されるアンカーを一覧にします。読み込んだ記事では、「edit」が49件のリンクのアンカーです。セクションの編集リンクなのでWikipediaでは問題ありませんが、他のサイトでは弱いアンカーです。
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>アンカーDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>アンカー画像Wikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>アンカー空なし:空のリンク
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blankとnoopener:まだ必要?
現在のブラウザでは不要です。target="_blank"のリンクは新しいタブで開きますが、主要なブラウザはどれも、これをrel="noopener"として扱います。開いた先のページから、元のページを操作することはできません。noopenerがないことは、リスクではなく注記として表示します。
HTMLの標準は2019年に、_blankがnoopenerを暗黙的に含むと定めました(HTML)。Safari 12.1、Firefox 79、Chrome 88が実装しています。noreferrerは訪問者の参照元も隠します。これはプライバシーとアクセス解析に関する選択であり、セキュリティ対策ではありません。
<a target="_blank">relの指定なしwindow.opener→ null- 2019-02HTML:_blankはnoopenerを含むwhatwg/html #4330
- 2019Safari 12.1暗黙のnoopener
- 2020Firefox 79暗黙のnoopener
- 2021Chrome 88暗黙のnoopener
- dnsrobot.net/blog/hosting-com-coupon23件中23件にnoopenerまたはnoreferrerあり
- github.com10件中10件にnoopenerまたはnoreferrerあり
- developer.mozilla.org/en-US/10件中10件にnoopenerまたはnoreferrerあり
リンクに関する俗説を、Google自身のページで検証
リンクに関するアドバイスの多くは、いくつかの古いルールの繰り返しです。それぞれについて、Googleのドキュメントが今日何と述べているかを示します。
| 俗説 | Googleの見解 | 情報源 |
|---|---|---|
| 誤り「dofollow」は追加する属性である | リンクはデフォルトでたどられます。意味を持つのはnofollow、sponsored、ugcだけです。 | developers.google.com |
| 誤り外部リンクにnofollowを付けるとサイトにペナルティが科される | Googleがnofollowやsponsoredを求めるのは、有料リンクと、自分が保証できないリンクだけです。 | developers.google.com |
| 古い情報1ページのリンクは100件未満に抑える | 1ページあたりのリンク数に、上限も理想的な数もありません。 | developers.google.com |
| 誤りnofollowを付けるとページがインデックスされない | ページをGoogleに載せたくない場合は、クロールを許可したうえでnoindexを使います。 | developers.google.com |
| 古い情報nofollowのリンクは何も渡さない | 2019年以降はヒントです。Googleが利用することがあります。ただし、ランキングでは通常、引き続き数えません。 | developers.google.com |
| 古い情報noopenerのないtarget=_blankはセキュリティ上の穴である | 現在のブラウザは、rel=openerでopenerを指定しない限り、_blankのリンクにnoopenerを暗黙的に適用します。 | html.spec.whatwg.org |
情報源
- Google Search Central:クロール可能なリンク、外向きリンクの修飾、robots metaタグ、HTTPステータスコード
- HTML Living Standard(リンク、rel値、ベースURL)とRFC 9110(ステータスコード)
- Cloudflare:チャレンジの検出
- 数値:en.wikipedia.org/wiki/Domain_Name_Systemでの当社の実測、2026年10月23日