











二進数変換(バイナリ翻訳)
文字を二進数に、二進数を文字に入力と同時に変換。16進数なども読み、各文字のビットを表示。
桁の重み
64 + 8 = 72 → H
- 1
- 0
- UTF-8の目印のビット
文字にポインターを合わせるか、カーソルを動かすと、そのビットの足し算が下に表示されます。文字をタップすると、そのビットの足し算が表示されます。
変換はブラウザー内で行われ、入力した内容はどこにも送信されません。
二進数変換ツールの使い方
文字を入力すると二進数に、二進数を貼り付けると文字に戻ります。このバイナリ変換ツールは入力と同時に変換し、結果の上の表示で入力をどう読み取ったかがわかります。
二進数はスペースの有無を問わず、7ビットの区切りでも、先頭に0bが付いていても貼り付けられます。48 69のような16進数、72 105のような10進数のバイト、U+0048のようなコードポイントも読み取ります。出力は2進数・16進数・10進数・8進数から選び、区切り文字と1バイトを8ビットにするか7ビットにするかを決めて、コピーまたはダウンロードします。下のバイト列にはすべての文字のバイトが並び、1つ選ぶとそのビットを足し算できます。
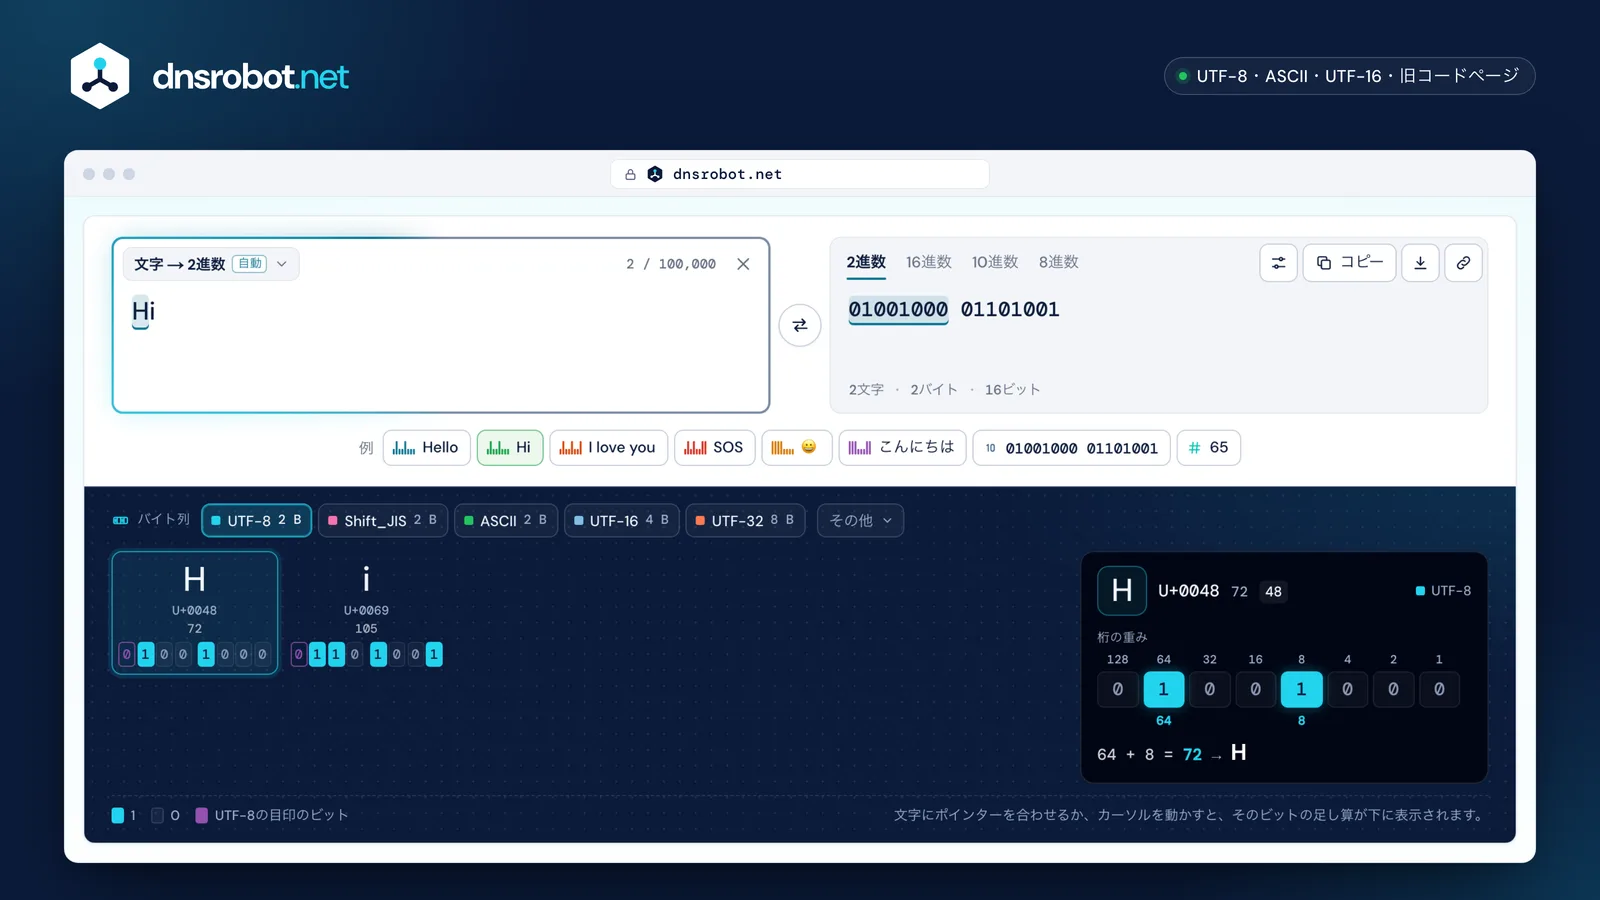
 文字か二進数か文字を入力するか、二進数・16進数・10進数を貼り付けます。どう読み取ったかは上の表示でわかり、自分で選ぶこともできます。変換結果2進数・16進数・10進数・8進数から好きな形で表示し、コピー、ダウンロード、リンクでの共有ができます。文字コード初期設定はUTF-8です。ASCII、UTF-16、古いコードページでは、同じ文字でも別のバイトになります。バイト列すべての文字をコードポイントとバイトで表示します。UTF-8の目印のビットは別の色です。ビットを足すバイトを選ぶと桁の重みが表示されます。64 + 8 = 72で、文字のHです。
文字を二進数に変換するには?
各文字の番号を調べ、その番号を8桁の二進数で書いて、バイトをつなげます。Hは72で01001000なので、「Hi」は01001000 01101001です。
コンピューターは文字を、共通の表で決められた番号として保存しています。ASCIIとUTF-8では、英字、数字、よく使う記号はどれも1バイト、つまり8ビットで書く0〜255の数です。数を二進数で書くには、2のべき乗に分けます。72 = 64 + 8なので、重み64と8のビットが1、残りは0です。英語以外の文字は、UTF-8では2〜4バイトになります。
- HU+0048= 720x481バイト01001000
- iU+0069= 1050x691バイト01101001
- éU+00E9= 2330xC30xA92バイト1100001110101001
Hi01001000 01101001
二進数の読み方は? 2進数を文字に変換する手順
ビットを8個ずつに区切り、1になっている桁の重み(128、64、32、16、8、4、2、1)を足して、その番号の文字を調べます。01001000は64 + 8 = 72で、文字のHです。
1バイトのいちばん左のビットの重みは128、いちばん右は1です。0で始まるバイトはただのASCII、11で始まるバイトはUTF-8の長い文字の始まり、10で始まるバイトはその続きです。先頭の0が省かれると、1001000のような7ビットの区切りになります。このツールは0を自動で補い、ちょうど1バイトにならない区切りがあればそのことを知らせます。
64 + 8 = 72 → H
64 + 32 + 8 + 1 = 105 → i
01001000 01101001Hi
二進数のアルファベット:AからZまでの文字
大文字はA = 01000001からZ = 01011010まで、小文字はa = 01100001からz = 01111010までです。
大文字と小文字の違いは、重み32のビット1つだけです。Aは01000001、aは01100001です。数字は0 = 00110000から9 = 00111001までで、下位4ビットがその数字そのものになり、スペースは00100000です。これらは1963年に初めて公開されたASCII(小文字が加わったのは1967年)の番号で、UTF-8もそのまま引き継いでいます。
- A01000001a01100001
- B01000010b01100010
- C01000011c01100011
- D01000100d01100100
- E01000101e01100101
- F01000110f01100110
- G01000111g01100111
- H01001000h01101000
- I01001001i01101001
- J01001010j01101010
- K01001011k01101011
- L01001100l01101100
- M01001101m01101101
- N01001110n01101110
- O01001111o01101111
- P01010000p01110000
- Q01010001q01110001
- R01010010r01110010
- S01010011s01110011
- T01010100t01110100
- U01010101u01110101
- V01010110v01110110
- W01010111w01110111
- X01011000x01111000
- Y01011001y01111001
- Z01011010z01111010
- 重み32のビット:大文字は0、小文字は1
- 先頭のビット:常に0(ASCIIは7ビット)
- 1
「Hello」「Hi」「I love you」を二進数で
「Hello」を二進数にすると01001000 01100101 01101100 01101100 01101111、「Hi」は01001000 01101001、「I love you」はスペースも含めて01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101です。
ASCIIとUTF-8では英字1文字が1バイトなので、英単語のバイト数は文字数と同じで、大文字、小文字、スペースにはそれぞれ別の番号があります。「SOS」は01010011 01001111 01010011です。上部の入力欄に好きな単語や名前を入力すれば二進数になり、入力欄の下の例を選ぶこともできます。
| 単語 | 二進数(ASCIIとUTF-8) | ビット |
|---|---|---|
| Hi | 01001000 01101001 | 16 |
| Hello | 01001000 01100101 01101100 01101100 01101111 | 40 |
| Hello World | 01001000 01100101 01101100 01101100 01101111 00100000 01010111 01101111 01110010 01101100 01100100 | 88 |
| I love you | 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101 | 80 |
| SOS | 01010011 01001111 01010011 | 24 |
| Yes | 01011001 01100101 01110011 | 24 |
| No | 01001110 01101111 | 16 |
| OK | 01001111 01001011 | 16 |
| Love | 01001100 01101111 01110110 01100101 | 32 |
| Thank you | 01010100 01101000 01100001 01101110 01101011 00100000 01111001 01101111 01110101 | 72 |
16・24・32ビットになる文字があるのはなぜ? UTF-8の仕組み
UTF-8は英語を1文字1バイトで、それ以外の文字を2〜4バイトで書きます。éは2バイト、€と中国語・日本語・韓国語の文字の大半は3バイト、絵文字は4バイトです。
最初のバイトが文字の長さを示します。110で始まれば2バイト、1110なら3バイト、11110なら4バイトの文字で、そのあとのバイトはすべて10で始まります。残りのビットをつなげたものがその文字のコードポイントで、éはU+00E9です。見た目は1つの絵文字でも、ゼロ幅接合子(ZWJ)でつないだ複数のコードポイントのことがあり、家族の絵文字👨👩👧は18バイトになります。上部のバイト列では、目印のビットをコードポイントのビットと色分けしています。
- 1バイト8ビットAU+004141001000001U+0000 – U+007FASCII:英字、数字、記号
- 2バイト16ビットéU+00E9C3 A9110110000111010101001U+0080 – U+07FFアクセント付きラテン文字、キリル文字、ギリシャ文字、ヘブライ文字、アラビア文字
- 3バイト24ビットあU+3042E3 81 8211101110001110100000011010000010U+0800 – U+FFFF中国語・日本語・韓国語の大半、インド系文字、€
- 4バイト32ビット😀U+1F600F0 9F 98 801111011110000101001111110100110001010000000U+10000 – U+10FFFF絵文字など、U+FFFFより上の文字
- 目印のビット:バイト数、または「続き」
- 文字自身のビット
- x:文字のビットが入る場所
ASCII・UTF-8・UTF-16の違い:どの文字コードを使うべき?
UTF-8を使ってください。Webの標準で、約99%のWebサイトが使っています(W3Techs、2026年10月)。ASCIIはその中の7ビットで英語だけの部分で、UTF-16はほとんどの文字を2バイトで表します。
同じ単語でも、文字コードによってビットが変わります。「Hello」はUTF-8とASCIIでは5バイト、UTF-16では10バイト、UTF-32では20バイトです。1文字を16ビットとして数える問題は、UTF-16を指しています。古いファイルでは、ロシア語のKOI8-RやWindows-1251、西ヨーロッパのWindows-1252、日本語のShift_JISといった昔の文字コードが使われています。二進数を変換して文字化けするときは、たいてい文字コードが原因なので、ツールで別の文字コードを選んでください。
“Hello” 5文字
- UTF-85バイト · 40ビット
- UTF-16BE10バイト · 80ビット
- UTF-32BE20バイト · 160ビット
- ASCII5バイト · 40ビット
- Shift_JIS5バイト · 40ビット
“こんにちは” 5文字
- UTF-815バイト · 120ビット
- UTF-16BE10バイト · 80ビット
- UTF-32BE20バイト · 160ビット
- ASCII5文字を書けません
- Shift_JIS10バイト · 80ビット
1文字のバイト: あ U+3042
- UTF-8E3 81 82
- UTF-16BE30 42
- UTF-32BE00 00 30 42
- Shift_JIS82 A0
65は数値か文字か? 10進数を2進数に変換
数値としての65は、二進数で1000001です。文字として入力すると6と5の2文字になり、00110110 00110101です。
数を二進数にするには、2で割り続け、余りを最後から最初へ逆に読みます。65では余りが1、0、0、0、0、0、1と出るので、1000001です。1バイトにそろえると01000001で、これは大文字Aの番号でもあります。上部に数だけを入力すると、その値の二進数と、各桁の文字の二進数の両方が表示されます。
数値としての65
| 数 | 商 | 余り | |
|---|---|---|---|
| 65 | ÷ 2 = | 32 | 1 |
| 32 | ÷ 2 = | 16 | 0 |
| 16 | ÷ 2 = | 8 | 0 |
| 8 | ÷ 2 = | 4 | 0 |
| 4 | ÷ 2 = | 2 | 0 |
| 2 | ÷ 2 = | 1 | 0 |
| 1 | ÷ 2 = | 0 | 1 |
余りを下から上へ読みます: 1000001
64 + 1 = 65 · 1バイトでは01000001 = A
文字としての「65」
- 6U+0036 = 5400110110
- 5U+0035 = 5300110101
2文字で2バイト: 00110110 00110101
ASCIIでは数字の0〜9が48〜57なので、「6」は54です。
PythonやJavaScriptなどで文字を二進数に変換する方法
文字列をUTF-8のバイトにエンコードし、各バイトを8桁の2進数で書きます。どの言語にも短く書ける方法があります。
ここに挙げた例はどれも「Hi」を01001000 01101001に変換して元に戻すもので、実際に実行して出力を確かめています。どれもUTF-8を使うため、このツールと同じビットになります。別の文字コードで書いたバイトはビットが変わるので、変換する側と戻す側で同じ文字コードを使ってください。
 Python
text = "Hi"
bits = " ".join(f"{b:08b}" for b in text.encode("utf-8"))
print(bits)
print(bytes(int(b, 2) for b in bits.split()).decode("utf-8"))
Python 3.14, 2026年10月25日で実行:上の行が出力されます。
 JavaScript
const bits = [...new TextEncoder().encode("Hi")]
  .map((b) => b.toString(2).padStart(8, "0")).join(" ");
console.log(bits);
console.log(new TextDecoder().decode(
  Uint8Array.from(bits.split(" "), (b) => parseInt(b, 2))));
Node.js 22, 2026年10月25日で実行:上の行が出力されます。
 Java
StringBuilder sb = new StringBuilder();
for (byte b : "Hi".getBytes(StandardCharsets.UTF_8))
    sb.append(String.format("%8s", Integer.toBinaryString(b & 0xFF))
        .replace(' ', '0')).append(' ');
String bits = sb.toString().trim();
System.out.println(bits);
String[] parts = bits.split(" ");
byte[] back = new byte[parts.length];
for (int i = 0; i < parts.length; i++) back[i] = (byte) Integer.parseInt(parts[i], 2);
System.out.println(new String(back, StandardCharsets.UTF_8));
Java 25, 2026年10月25日で実行:上の行が出力されます。
 C# · .NET
using System.Text;

var bits = string.Join(" ", Encoding.UTF8.GetBytes("Hi")
    .Select(b => Convert.ToString(b, 2).PadLeft(8, '0')));
Console.WriteLine(bits);
Console.WriteLine(Encoding.UTF8.GetString(
    bits.Split(' ').Select(b => Convert.ToByte(b, 2)).ToArray()));
.NET 10, 2026年10月25日で実行:上の行が出力されます。
 Go
var parts []string
for _, b := range []byte("Hi") {
	parts = append(parts, fmt.Sprintf("%08b", b))
}
bits := strings.Join(parts, " ")
fmt.Println(bits)

var back []byte
for _, p := range strings.Fields(bits) {
	n, _ := strconv.ParseUint(p, 2, 8)
	back = append(back, byte(n))
}
fmt.Println(string(back))
Go 1.25, 2026年10月25日で実行:上の行が出力されます。
二進数(バイナリコード)を発明したのは誰?
ゴットフリート・ライプニッツ(Gottfried Leibniz)はパリ科学アカデミーに寄せた1703年の論文で二進数を説明しましたが、それより前の1623年に、フランシス・ベーコン(Francis Bacon)が2種類の記号5つで文字を書く方法を発表していました。コンピューターが使う8ビットの文字コードは、ASCII(1963年)とUTF-8(1992年)から発展したものです。
1870年代のエミール・ボドー(Émile Baudot)の電信符号は、1文字をオンとオフの5単位で表しました。1974年にはアレシボ(Arecibo)電波望遠鏡が1,679ビットの絵を宇宙へ送り、2021年2月にはNASAの探査車Perseveranceが、「Dare mighty things」(果敢に挑め)を二進数で描いたパラシュートで火星に着陸しました。各文字は、アルファベットの何番目かで表されています。
1623
ベーコンの2文字アルファベット
フランシス・ベーコン(Francis Bacon)は、aとbの2種類の記号5つですべての文字を表しました。32通りの組み合わせで、当時の24文字のアルファベットをまかないます。1605年に示唆し、1623年に全体を発表しました。
aaaaa · aaaab · aaaba · aaabb … 2⁵ = 32
出典: archive.org
1703
ライプニッツの二進法
ゴットフリート・ライプニッツ(Gottfried Leibniz)は、パリ科学アカデミーに寄せた1703年の論文で、0と1だけで数える方法を説明しました。
1 · 10 · 11 · 100 · 101 · 110 · 111
出典: gallica.bnf.fr
1870年代
ボドーの5単位符号
エミール・ボドー(Émile Baudot)の印刷電信機は、1文字をオンとオフの5単位で送ります。その流れをくむITA2は、今もITU-T勧告(S.1)です。
5 → 2⁵ = 32
出典: itu.int
1948
「ビット」
クロード・シャノン(Claude Shannon)の論文 A Mathematical Theory of Communication は、binary digitを縮めたビットを情報の単位として使い、この語はJohn W. Tukeyによるものだとしています。
bit = binary digit
1956
「バイト」
ヴェルナー・ブッフホルツ(Werner Buchholz)が1956年6月にIBMでこの語を作りました。当時は1〜6ビットのまとまりを指し、IBMのSystem/360(1964年)で8ビットに定まりました。
1–6 bits → 8 bits
1963
ASCII
米国規格協会(American Standards Association)が1963年6月17日にASCIIを承認しました。7ビットで128の符号です。
A = 1000001
1974
アレシボ・メッセージ
1974年11月16日、アレシボ(Arecibo)電波望遠鏡が1,679ビットを宇宙へ送りました。1,679 = 73 × 23と素数2つの積なので、ビットの並べ方は1通りしかなく、1枚の絵になります。
1,679 = 73 × 23
23 × 73出典: news.cornell.edu
1992
UTF-8
ケン・トンプソン(Ken Thompson)が1992年9月、ロブ・パイク(Rob Pike)の示した条件に沿って、ベル研究所のPlan 9のためにUTF-8を設計しました。ASCIIを1バイトのまま保ち、どの文字も最大4バイトで表します。
é = 11000011 10101001
出典: cl.cam.ac.uk
2021
火星に届いたメッセージ
2021年2月18日、探査車Perseveranceのパラシュートは、オレンジと白のパネルで「DARE MIGHTY THINGS」(果敢に挑め)を示しました。各文字をアルファベットの何番目かで表し、それを二進数にしたものです(A = 1)。
DARE → 4 1 18 5 → 100 1 10010 101
二進数(バイナリコード):よくある質問
二進数(バイナリコード)とは?
2進数を英語の文字に変換するには?
「hello」を二進数にすると?
「I love you」を二進数にすると?
1文字は何ビットですか?
01001000 01101001はどういう意味ですか?
スペースなしの二進数も貼り付けられますか?
二進数の10101はどういう意味ですか?
二進数が�のような記号に文字化けするのはなぜ?
ASCIIは7ビットですか、8ビットですか?
65を二進数にすると?
入力した文字はサーバーに送信されますか?
足りないものはありますか?機能や新しいツールを提案する
関連ツール
モールス信号変換
文字とモールス信号を相互変換。音・光・振動で再生し、音声や写真から解読
小さい文字ジェネレーター
テキストを44種類のUnicodeフォントスタイルに変換 — 小文字、太字、斜体、筆記体など
空白文字コピー
空白文字をワンクリックでコピー&ペースト。テキストに隠れた不可視文字の検出・削除にも対応
IPから10進数変換
IPアドレスと10進数・16進数・2進数・8進数を相互変換、各オクテットの重みも表示
サブネット計算機
IPv4・IPv6ブロックのネットワーク、ブロードキャスト、使用可能なホスト、マスクを計算。VLSM、分割、クラウドのサブネットにも対応
UUID生成
UUID v4、v7、v1、v5、v3やGUIDを任意の形式で一括生成し、UUIDのバージョンとタイムスタンプをデコード