











Convertisseur et traducteur de code binaire
Texte en code binaire et retour, en direct : collez 0 et 1, hexa ou décimal, et voyez chaque bit.
Valeurs de position
64 + 8 = 72 → H
- 1
- 0
- Bits marqueurs UTF-8
Pointez un caractère ou déplacez le curseur : ses bits s'additionnent en dessous.Touchez un caractère pour voir ses bits s'additionner.
Traduit dans votre navigateur : rien de ce que vous tapez n'est envoyé nulle part.
Comment utiliser le convertisseur binaire
Tapez du texte pour obtenir le code binaire, ou collez du code binaire pour retrouver le texte : la conversion du binaire en texte et inversement se fait pendant la frappe, et l'étiquette au-dessus du résultat indique comment votre saisie a été lue.
Collez du binaire avec ou sans espaces, par groupes de 7 bits ou précédé de 0b ; l'hexadécimal comme 48 69, les octets en décimal comme 72 105 et les points de code comme U+0048 sont lus aussi. Choisissez une sortie en binaire, hexadécimal, décimal ou octal, le séparateur et 8 ou 7 bits par octet, puis copiez-la ou téléchargez-la. La bande en dessous montre les octets de chaque caractère : sélectionnez-en un pour additionner ses bits.
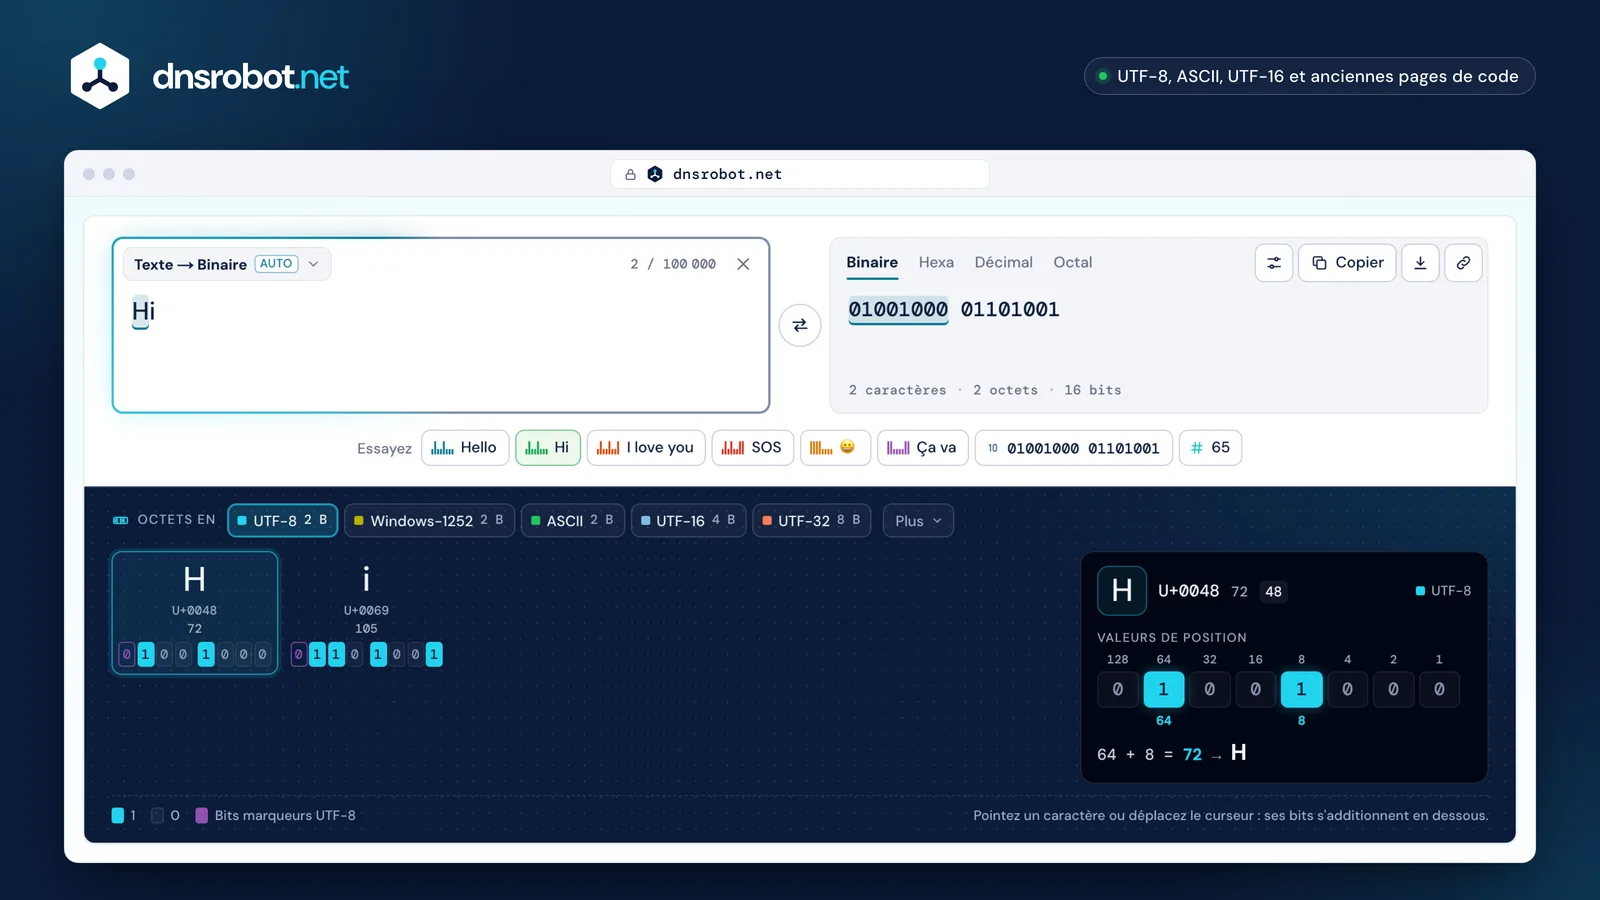
 Texte ou binaireTapez du texte ou collez du binaire, de l'hexa ou du décimal : l'étiquette indique comment il a été lu, et vous pouvez choisir.Le résultatBinaire, hexa, décimal ou octal, comme vous voulez : copiez-le, téléchargez-le ou partagez un lien.EncodageUTF-8 par défaut ; l'ASCII, l'UTF-16 et les anciennes pages de code donnent d'autres octets pour le même texte.La bande d'octetsChaque caractère avec son point de code et ses octets ; les bits marqueurs de l'UTF-8 dans leur propre couleur.Additionner les bitsSélectionnez un octet pour voir ses valeurs de position : 64 + 8 = 72, la lettre H.
Comment convertir du texte en code binaire ?
Cherchez le numéro de chaque caractère, écrivez ce nombre avec 8 chiffres binaires et mettez les octets bout à bout : H vaut 72, soit 01001000, donc « Hi » donne 01001000 01101001.
Les ordinateurs stockent le texte sous forme de nombres tirés d'une table commune. En ASCII et en UTF-8, chaque lettre de l'alphabet anglais, chaque chiffre et chaque signe courant tient sur un octet : un nombre de 0 à 255 écrit sur 8 bits. Pour écrire un nombre en binaire, décomposez-le en puissances de deux : 72 = 64 + 8, donc les bits qui valent 64 et 8 sont à 1 et les autres à 0. Les lettres absentes de l'alphabet anglais, comme les lettres accentuées, prennent de 2 à 4 octets en UTF-8.
- HU+0048= 720x481 octet01001000
- iU+0069= 1050x691 octet01101001
- éU+00E9= 2330xC30xA92 octets1100001110101001
Hi01001000 01101001
Comment lire le code binaire ? Traduction binaire en texte, étape par étape
Découpez les bits en groupes de 8, additionnez les valeurs de position des 1 (128, 64, 32, 16, 8, 4, 2, 1) et cherchez le nombre obtenu : 01001000 donne 64 + 8 = 72, la lettre H.
Le bit le plus à gauche d'un octet vaut 128 et le plus à droite 1. Un octet qui commence par 0 est de l'ASCII simple ; un octet qui commence par 11 ouvre un caractère UTF-8 plus long, et un octet qui commence par 10 le continue. Quand quelqu'un supprime le zéro de tête, on obtient des groupes de 7 bits comme 1001000 : ce traducteur les complète pour vous, et le signale quand un groupe ne peut pas former un octet entier.
64 + 8 = 72 → H
64 + 32 + 8 + 1 = 105 → i
01001000 01101001Hi
Alphabet binaire : les lettres de A à Z en binaire
Les majuscules vont de A = 01000001 à Z = 01011010, et les minuscules de a = 01100001 à z = 01111010.
Une majuscule et sa minuscule ne diffèrent que d'un bit, celui qui vaut 32 : A donne 01000001 et a donne 01100001. Les chiffres vont de 0 = 00110000 à 9 = 00111001, si bien que leurs quatre derniers bits sont le chiffre lui-même, et l'espace vaut 00100000. Ces codes sont ceux de l'ASCII, publié pour la première fois en 1963 (les minuscules sont arrivées en 1967), et l'UTF-8 les a gardés tels quels.
- A01000001a01100001
- B01000010b01100010
- C01000011c01100011
- D01000100d01100100
- E01000101e01100101
- F01000110f01100110
- G01000111g01100111
- H01001000h01101000
- I01001001i01101001
- J01001010j01101010
- K01001011k01101011
- L01001100l01101100
- M01001101m01101101
- N01001110n01101110
- O01001111o01101111
- P01010000p01110000
- Q01010001q01110001
- R01010010r01110010
- S01010011s01110011
- T01010100t01110100
- U01010101u01110101
- V01010110v01110110
- W01010111w01110111
- X01011000x01111000
- Y01011001y01111001
- Z01011010z01111010
- Le bit qui vaut 32 : 0 pour les majuscules, 1 pour les minuscules
- Le premier bit : toujours 0 (l'ASCII tient sur 7 bits)
- 1
Hello, Hi et I love you en code binaire
« Hello » en binaire donne 01001000 01100101 01101100 01101100 01101111 ; « Hi » donne 01001000 01101001, et « I love you » donne 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101, espaces compris.
Chaque lettre de l'alphabet anglais occupe un octet en ASCII et en UTF-8 : un mot compte donc autant d'octets que de lettres, et majuscules, minuscules et espaces ont chacun leur propre code. « SOS » donne 01010011 01001111 01010011. Pour voir « Bonjour », un autre mot ou votre prénom en binaire, tapez-le en haut ou choisissez un exemple sous le champ.
| Mot | Binaire (ASCII et UTF-8) | Bits |
|---|---|---|
| Hi | 01001000 01101001 | 16 |
| Hello | 01001000 01100101 01101100 01101100 01101111 | 40 |
| Hello World | 01001000 01100101 01101100 01101100 01101111 00100000 01010111 01101111 01110010 01101100 01100100 | 88 |
| I love you | 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101 | 80 |
| SOS | 01010011 01001111 01010011 | 24 |
| Yes | 01011001 01100101 01110011 | 24 |
| No | 01001110 01101111 | 16 |
| OK | 01001111 01001011 | 16 |
| Love | 01001100 01101111 01110110 01100101 | 32 |
| Thank you | 01010100 01101000 01100001 01101110 01101011 00100000 01111001 01101111 01110101 | 72 |
Pourquoi certains caractères prennent-ils 16, 24 ou 32 bits ? L'UTF-8 expliqué
L'UTF-8 écrit l'anglais avec un octet par caractère et tout le reste avec deux à quatre : é prend 2 octets, € et la plupart des caractères chinois, japonais et coréens 3, et les emoji 4.
Le premier octet indique la longueur du caractère : 110 ouvre un caractère de 2 octets, 1110 un caractère de 3 octets et 11110 un caractère de 4 octets, et chaque octet suivant commence par 10. Les bits restants, mis bout à bout, forment le point de code du caractère : é est U+00E9. Un seul emoji à l'écran peut réunir plusieurs points de code reliés par un liant sans chasse (ZWJ) : la famille 👨👩👧 prend 18 octets. La bande en haut colore les bits marqueurs à part de ceux du point de code.
- 1octet8 bitsAU+004141001000001U+0000 – U+007FASCII : lettres anglaises, chiffres, ponctuation
- 2octets16 bitsçU+00E7C3 A7110110000111010100111U+0080 – U+07FFLettres latines accentuées, cyrillique, grec, hébreu, arabe
- 3octets24 bits€U+20ACE2 82 AC11101110001010100000101010101100U+0800 – U+FFFFLa plupart des caractères chinois, japonais et coréens, écritures indiennes, €
- 4octets32 bits😀U+1F600F0 9F 98 801111011110000101001111110100110001010000000U+10000 – U+10FFFFEmoji et autres caractères au-dessus de U+FFFF
- Bits marqueurs : combien d'octets, ou « continue »
- Les bits propres au caractère
- x : une case pour les bits du caractère
ASCII, UTF-8 ou UTF-16 : quel encodage choisir ?
Utilisez l'UTF-8 : c'est la norme du Web, utilisée par environ 99 % des sites (W3Techs, octobre 2026). L'ASCII en est la partie sur 7 bits, limitée à l'anglais, et l'UTF-16 prend deux octets pour la plupart des caractères.
Le même mot n'a pas les mêmes bits d'un encodage à l'autre : « Hello » fait 5 octets en UTF-8 et en ASCII, 10 octets en UTF-16 et 20 en UTF-32. Un exercice qui compte 16 bits par caractère parle d'UTF-16. Les fichiers plus anciens utilisent des encodages historiques : des pages de code sur un octet comme KOI8-R et Windows-1251 pour le russe ou Windows-1252 pour l'Europe de l'Ouest, et Shift_JIS pour le japonais, avec 2 octets par kanji. Quand du binaire se transforme en symboles bizarres, l'encodage est généralement en cause : choisissez-en un autre dans l'outil.
“Hello” 5 caractères
- UTF-85 octets · 40 bits
- UTF-16BE10 octets · 80 bits
- UTF-32BE20 octets · 160 bits
- ASCII5 octets · 40 bits
- Windows-12525 octets · 40 bits
“Ça va” 5 caractères
- UTF-86 octets · 48 bits
- UTF-16BE10 octets · 80 bits
- UTF-32BE20 octets · 160 bits
- ASCIIne peut pas écrire 1 caractère
- Windows-12525 octets · 40 bits
Une lettre, ses octets : ç U+00E7
- UTF-8C3 A7
- UTF-16BE00 E7
- UTF-32BE00 00 00 E7
- Windows-1252E7
65, nombre ou texte ? Du décimal au binaire
En tant que nombre, 65 s'écrit 1000001 en binaire ; tapé comme texte, ce sont deux caractères, 6 et 5, soit 00110110 00110101.
Pour convertir un nombre en binaire, divisez-le par 2 encore et encore, puis lisez les restes du dernier au premier : 65 donne les restes 1, 0, 0, 0, 0, 0, 1, donc 1000001. Complété sur un octet, cela donne 01000001, qui est aussi le code du A majuscule. Tapez un nombre seul en haut et vous obtenez les deux : sa valeur en binaire et le binaire de ses chiffres.
65 comme nombre
| Nombre | Quotient | Reste | |
|---|---|---|---|
| 65 | ÷ 2 = | 32 | 1 |
| 32 | ÷ 2 = | 16 | 0 |
| 16 | ÷ 2 = | 8 | 0 |
| 8 | ÷ 2 = | 4 | 0 |
| 4 | ÷ 2 = | 2 | 0 |
| 2 | ÷ 2 = | 1 | 0 |
| 1 | ÷ 2 = | 0 | 1 |
Lisez les restes de bas en haut : 1000001
64 + 1 = 65 · sur un octet 01000001 = A
« 65 » comme texte
- 6U+0036 = 5400110110
- 5U+0035 = 5300110101
Deux caractères, deux octets : 00110110 00110101
Les chiffres 0 à 9 valent 48 à 57 en ASCII, donc « 6 » vaut 54.
Convertir du texte en binaire en Python, JavaScript et d'autres langages
Encodez le texte en octets UTF-8, puis écrivez chaque octet en base 2 sur huit chiffres : chaque langage a une façon courte de le faire.
Chaque exemple ici transforme « Hi » en 01001000 01101001 puis le relit, et chacun a été exécuté pour vérifier sa sortie. Tous utilisent l'UTF-8, donc leurs bits sont ceux de ce traducteur ; des octets écrits dans un autre encodage donnent d'autres bits, alors utilisez le même encodage des deux côtés.
 Python
text = "Hi"
bits = " ".join(f"{b:08b}" for b in text.encode("utf-8"))
print(bits)
print(bytes(int(b, 2) for b in bits.split()).decode("utf-8"))
Exécuté sur Python 3.14, 25 octobre 2026 : affiche les lignes ci-dessus.
 JavaScript
const bits = [...new TextEncoder().encode("Hi")]
  .map((b) => b.toString(2).padStart(8, "0")).join(" ");
console.log(bits);
console.log(new TextDecoder().decode(
  Uint8Array.from(bits.split(" "), (b) => parseInt(b, 2))));
Exécuté sur Node.js 22, 25 octobre 2026 : affiche les lignes ci-dessus.
 Java
StringBuilder sb = new StringBuilder();
for (byte b : "Hi".getBytes(StandardCharsets.UTF_8))
    sb.append(String.format("%8s", Integer.toBinaryString(b & 0xFF))
        .replace(' ', '0')).append(' ');
String bits = sb.toString().trim();
System.out.println(bits);
String[] parts = bits.split(" ");
byte[] back = new byte[parts.length];
for (int i = 0; i < parts.length; i++) back[i] = (byte) Integer.parseInt(parts[i], 2);
System.out.println(new String(back, StandardCharsets.UTF_8));
Exécuté sur Java 25, 25 octobre 2026 : affiche les lignes ci-dessus.
 C# · .NET
using System.Text;

var bits = string.Join(" ", Encoding.UTF8.GetBytes("Hi")
    .Select(b => Convert.ToString(b, 2).PadLeft(8, '0')));
Console.WriteLine(bits);
Console.WriteLine(Encoding.UTF8.GetString(
    bits.Split(' ').Select(b => Convert.ToByte(b, 2)).ToArray()));
Exécuté sur .NET 10, 25 octobre 2026 : affiche les lignes ci-dessus.
 Go
var parts []string
for _, b := range []byte("Hi") {
	parts = append(parts, fmt.Sprintf("%08b", b))
}
bits := strings.Join(parts, " ")
fmt.Println(bits)

var back []byte
for _, p := range strings.Fields(bits) {
	n, _ := strconv.ParseUint(p, 2, 8)
	back = append(back, byte(n))
}
fmt.Println(string(back))
Exécuté sur Go 1.25, 25 octobre 2026 : affiche les lignes ci-dessus.
Qui a inventé le code binaire ?
Gottfried Leibniz a décrit les nombres binaires dans son mémoire de 1703 pour l'Académie des sciences de Paris, mais Francis Bacon avait publié dès 1623 des lettres écrites avec cinq symboles de deux sortes ; les codes de texte sur 8 bits des ordinateurs sont issus de l'ASCII (1963) et de l'UTF-8 (1992).
Le code télégraphique d'Émile Baudot, dans les années 1870, utilisait cinq unités tout ou rien par lettre. En 1974, le radiotélescope d'Arecibo a envoyé dans l'espace une image de 1 679 bits, et en février 2021, le rover Perseverance de la NASA s'est posé sur Mars sous un parachute qui écrit « Dare mighty things » (« Osez de grandes choses ») en binaire, chaque lettre codée par son rang dans l'alphabet.
1623
L'alphabet à deux lettres de Bacon
Francis Bacon écrit chaque lettre avec cinq symboles de deux sortes, a et b : 32 motifs pour son alphabet de 24 lettres. Il l'évoque en 1605 et le publie en entier en 1623.
aaaaa · aaaab · aaaba · aaabb … 2⁵ = 32
Source: archive.org
1703
L'arithmétique binaire de Leibniz
Gottfried Leibniz explique comment compter avec seulement 0 et 1 dans son mémoire de 1703 pour l'Académie des sciences de Paris.
1 · 10 · 11 · 100 · 101 · 110 · 111
Source: gallica.bnf.fr
années 1870
Le code à 5 unités de Baudot
Le télégraphe imprimeur d'Émile Baudot envoie chaque caractère sous forme de cinq unités tout ou rien. Son descendant, l'ITA2, est encore une Recommandation de l'UIT-T (S.1).
5 → 2⁵ = 32
Source: itu.int
1948
« Bit »
A Mathematical Theory of Communication, de Claude Shannon, emploie le bit, abréviation de binary digit, comme unité d'information, et attribue le mot à John W. Tukey.
bit = binary digit
Source: people.math.harvard.edu
1956
« Byte »
Werner Buchholz forge le mot chez IBM en juin 1956 pour un groupe de 1 à 6 bits ; le System/360 d'IBM (1964) le fixe à 8.
1–6 bits → 8 bits
Source: archive.computerhistory.org
1963
ASCII
L'American Standards Association approuve l'ASCII le 17 juin 1963 : 128 codes sur 7 bits.
A = 1000001
Source: sensitiveresearch.com
1974
Le message d'Arecibo
Le 16 novembre 1974, le radiotélescope d'Arecibo envoie 1 679 bits dans l'espace. 1 679 = 73 × 23, deux nombres premiers : les bits ne tiennent donc que dans une seule grille, une image.
1 679 = 73 × 23
23 × 73Source: news.cornell.edu
1992
UTF-8
Ken Thompson conçoit l'UTF-8 en septembre 1992, selon les critères de Rob Pike, pour le Plan 9 des Bell Labs. Il garde l'ASCII sur 1 octet et écrit n'importe quel caractère sur 4 octets au plus.
é = 11000011 10101001
Source: cl.cam.ac.uk
2021
Un message sur Mars
Le 18 février 2021, le parachute de Perseverance affiche « DARE MIGHTY THINGS » dans ses bandes orange et blanches : chaque lettre à sa place dans l'alphabet, en binaire (A = 1).
DARE → 4 1 18 5 → 100 1 10010 101
Source: photojournal.jpl.nasa.gov
Code binaire : questions et réponses
Qu'est-ce que le code binaire ?
Comment traduire du code binaire en texte ?
Comment écrire « hello » en binaire ?
Comment dit-on « I love you » en binaire ?
Combien de bits compte une lettre ?
Que signifie 01001000 01101001 ?
Puis-je coller du binaire sans espaces ?
Que signifie 10101 en binaire ?
Pourquoi le binaire se transforme-t-il en symboles bizarres comme � ?
L'ASCII est-il sur 7 ou sur 8 bits ?
Combien fait 65 en binaire ?
Mon texte est-il envoyé à un serveur ?
Outils associés
Traducteur de Code Morse
Texte en Morse et retour, joué en son, en lumière ou en vibration, et décodé d'un audio ou d'une photo
Générateur de Petit Texte
Convertissez du texte en 44 styles de police Unicode — petit texte, gras, italique, script, fraktur et plus
Caractère invisible
Copiez-collez un caractère invisible ou un espace vide, et trouvez ou supprimez les caractères cachés d'un texte
Convertisseur IP en Décimal
Adresse IP en décimal, hexa, binaire et octal, et retour, avec les poids de chaque octet
Calculateur de sous-réseau
Réseau, broadcast, hôtes utilisables et masques de tout bloc IPv4 ou IPv6, avec VLSM, découpage et sous-réseaux cloud
Générateur UUID
Générez des UUID v4, v7, v1, v5 et v3 ou des GUID en masse, dans tous les formats, et décodez la version et le timestamp d'un UUID