Tous les autres robots
User-agent: *
Lu par chaque robot qui n'a pas de groupe à lui.
- Autorise tout le site.
Google l'ignore ; Bing le lit.
Thème
Créez un robots.txt digne de confiance : chaque règle expliquée pendant que vous la saisissez, le fichier relu par notre testeur robots.txt selon la RFC 9309 et la lecture de Google, et un verdict en direct pour n'importe quel robot et n'importe quel chemin avant la publication.
Un fichier par hôte et par protocole : www.example.com et example.com ont chacun besoin du leur.
Source : RFC 9309, consultée le 26 octobre 2026.
Lu par chaque robot qui n'a pas de groupe à lui.
Choisissez ce que reçoit chaque robot connu. Un robot qui a son propre groupe ne lit que ce groupe.
Ils explorent pour construire un index de recherche. Les pages bloquées peuvent quand même être référencées grâce à des liens venus d'ailleurs, mais rien n'y est lu.
Ils collectent des pages pour entraîner des modèles. Un jeton distinct vous permet de refuser l'entraînement tout en restant dans les résultats de recherche.
Ils récupèrent des pages pour répondre à des questions avec un lien vers vous.
Ils récupèrent une page parce qu'une personne l'a demandée : certains opérateurs disent donc qu'ils peuvent ignorer robots.txt.
Les refuser, c'est refuser une personne, pas une exploration : quand quelqu'un demande à un assistant d'IA d'ouvrir l'une de vos pages, un assistant qui respecte le fichier ne la lira pas pour lui. Si c'est l'entraînement que vous visez, refusez plutôt les robots d'entraînement ci-dessus.
Aperçus de liens, outils du propriétaire du site, vérifications publicitaires, archives, et robots dont les opérateurs annoncent une autre mission, ou aucune.
Votre robots.txt/robots.txt
User-agent: *Allow: /ErreurAvertissementRemarque23 B sur 500 KiB
1 avertissement
Que faire C'est la ligne la moins coûteuse du fichier, et tous les robots la lisent. Ajoutez Sitemap: avec l'adresse complète de votre sitemap.
Choisissez un robot et un chemin : le verdict, la règle qui en décide et le groupe que lit le robot viennent du moteur de correspondance du Testeur robots.txt lui-même.
Ce robot peut demander l'URL.
User-agent: *commence à la ligne 1
Aucun groupe ne nomme ce robot : le groupe * s'applique donc.
Allow: /ligne 2
/any-page
/
Seuls le chemin et la requête sont comparés, octet par octet après l'encodage-pourcent. L'hôte, le protocole et le fragment ne font jamais partie d'une règle.
Écrivez les règles, enregistrez-les dans un fichier texte brut nommé robots.txt, encodé en UTF-8, et déposez-le à la racine de votre site, pour qu'il réponde à https://example.com/robots.txt. Il n'y a rien à envoyer : les robots demandent cette adresse d'eux-mêmes.
Google le dit en trois phrases : « Le fichier doit être nommé robots.txt. Votre site ne peut contenir qu'un seul fichier robots.txt. Le fichier robots.txt doit se trouver à la racine de l'hôte du site auquel il s'applique. » Ce doit être « un fichier texte encodé au format UTF-8 », et « les robots d'exploration Google trouvent automatiquement votre fichier robots.txt et se mettent à l'utiliser ».
Le générateur ci-dessus part d'un préréglage, explique chaque règle pendant que vous la saisissez et relit le résultat avec l'analyseur et le moteur de correspondance de notre testeur robots.txt avant toute copie. Le téléchargement s'appelle robots.txt : UTF-8 sans marque d'ordre des octets, des fins de ligne LF uniquement, et aucune date ni aucun commentaire que vous n'avez pas demandés.
https://example.com/robots.txtIl n'y a pas d'étape d'envoi : les robots d'exploration Google trouvent le fichier d'eux-mêmes.
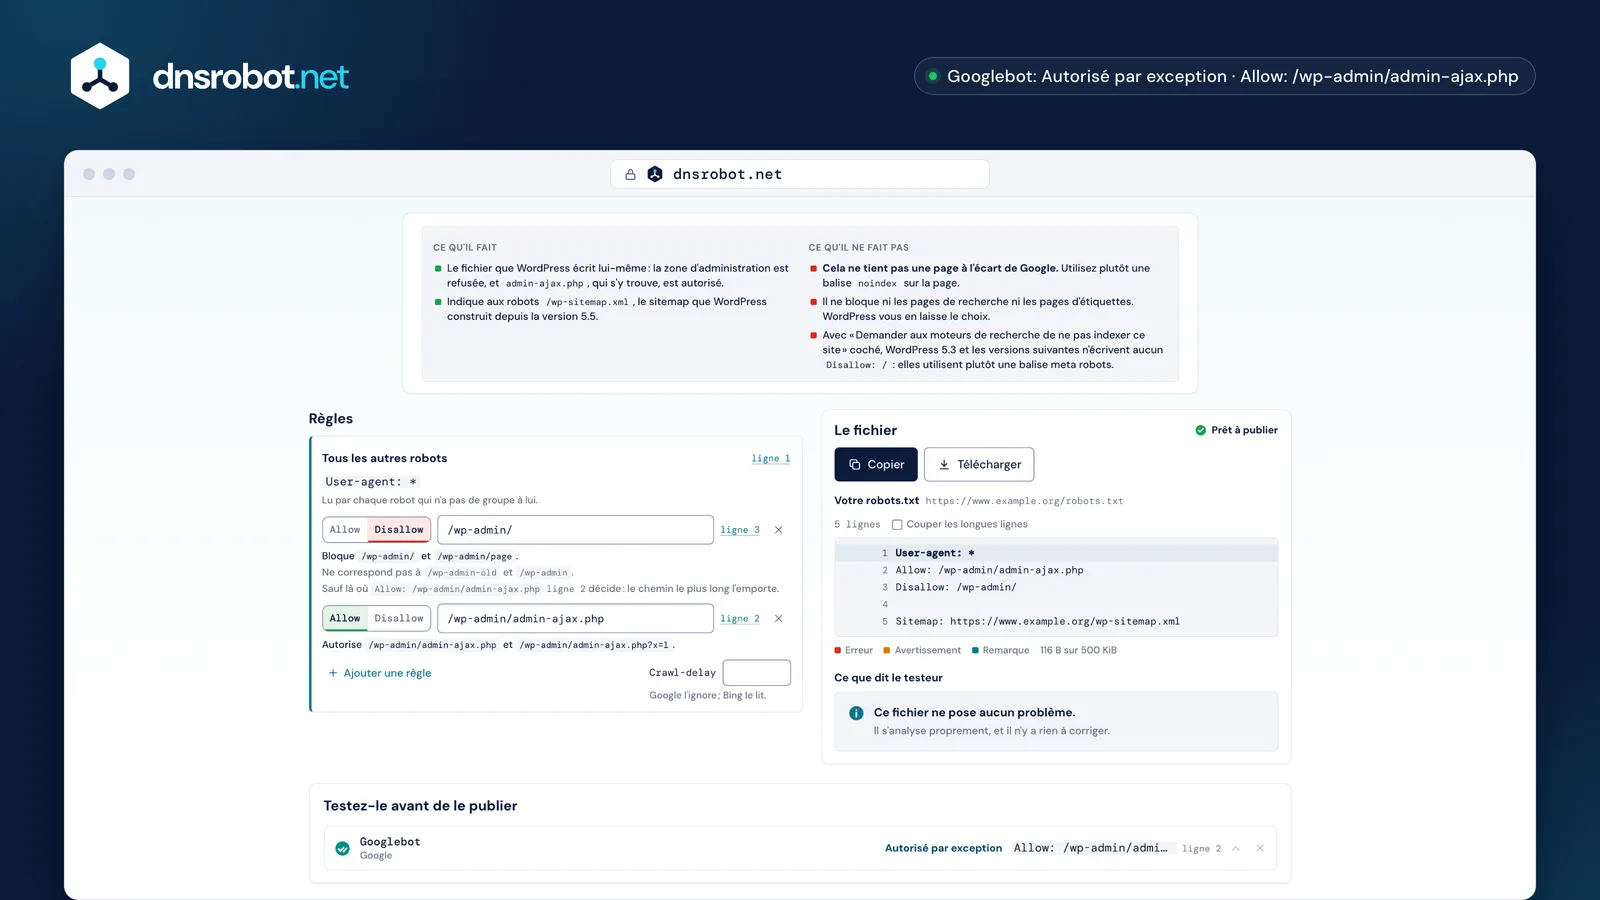
 Ce que fait le préréglageEt ce qu'il ne fait pas : aucun de ces préréglages ne tient une page à l'écart de Google, et chacun le dit.Chaque règle expliquéeLes chemins qu'une règle bloque et ceux qu'elle manque, d'après le moteur de correspondance qui décide de chaque verdict, et la règle plus longue qui crée une exception.Le fichier et ses constatsLe fichier avec ses numéros de ligne, relu par l'audit du Testeur robots.txt avant toute copie.Le verdictChoisissez un robot et un chemin : autorisé ou bloqué, la règle qui a décidé avec sa ligne, et le groupe que lit le robot.
Des groupes et des lignes Sitemap. Un groupe commence par une ou plusieurs lignes User-agent qui nomment des robots, suivies des règles Allow et Disallow auxquelles ces robots obéissent ; une ligne Sitemap est indépendante, en dehors de tout groupe.
La RFC 9309 définit un groupe comme « une ou plusieurs lignes user-agent suivies d'une ou plusieurs règles », et un robot obéit à un seul groupe : celui qui nomme son propre jeton de produit, ou le groupe * quand aucun ne le fait. Google lit quatre champs et aucun autre : user-agent, allow, disallow et sitemap.
Les noms de champs ne sont pas sensibles à la casse, les chemins le sont : dans l'exemple de Google, disallow: /file.asp s'applique à /file.asp « mais pas » à /FILE.asp. Une ligne Sitemap: doit être une adresse complète, avec le protocole et l'hôte ; ce générateur refuse toute autre forme et dit pourquoi.
User-agent: *Ouvre un groupe pour chaque robot qui n'a pas de groupe à luiDisallow: /cart/Un chemin que ces robots ne doivent pas récupérerAllow: /cart/helpUne exception : plus longue que le Disallow, elle l'emporte User-agent: GPTBotOuvre un groupe qui nomme deux robotsUser-agent: ClaudeBotDisallow: /Les deux sont refusés sur tout le site Sitemap: https://www.example.org/sitemap.xmlEn dehors de tout groupe : une adresse complète* et $ : comment une règle correspondQuand plusieurs règles correspondent à une URL, celle dont le chemin est le plus long l'emporte, quel que soit son type, et une règle Allow l'emporte en cas d'égalité. * remplace n'importe quelle suite de caractères et $ marque la fin de l'URL ; rien d'autre n'a de sens particulier dans un chemin.
RFC 9309 : « La correspondance la plus spécifique trouvée DOIT être utilisée. La correspondance la plus spécifique est celle qui compte le plus d'octets », et « si une règle allow et une règle disallow sont équivalentes, alors la règle allow DEVRAIT être utilisée. » Le fichier de WordPress fonctionne ainsi : Disallow: /wp-admin/ ferme le dossier, et la règle plus longue Allow: /wp-admin/admin-ajax.php y ouvre un fichier.
Une règle sans $ est un préfixe : Disallow: /admin bloque donc aussi /administrator ; ajoutez la barre oblique (/admin/) quand vous visez le dossier. Sous chaque règle, l'éditeur ci-dessus montre les chemins qu'elle couvre et certains qu'elle ne couvre pas, d'après le moteur de correspondance qui décide de chaque verdict, et il signale une règle qu'une autre bat toujours.
* et $, et ce que chaque motif couvre vraiment/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ et + sont des caractères ordinaires. Il n'y a pas d'expressions régulières dans robots.txt.
/admin/report.pdfLa règle Allow l'emporte : elle couvre une plus grande partie du chemin.
Disallow: /files/7 caractèresAllow: /files/7 caractèresMême longueur : c'est donc l'Allow qui l'emporte. « La règle la moins restrictive », comme le dit Google.
Les trois en servent déjà un, et les préréglages ci-dessus écrivent ce que décrit la documentation de chaque plateforme : WordPress refuse sa zone d'administration mais autorise admin-ajax.php, Shopify refuse les paniers, les paiements et les collections filtrées ou triées, et Next.js sert le fichier que vous placez dans app/robots.txt.
WordPress écrit son fichier dans le code, dans do_robots() : User-agent: *, un Disallow pour le chemin d'administration et un Allow pour admin-ajax.php, plus, sur un site public depuis WordPress 5.5, une ligne Sitemap: pour /wp-sitemap.xml. Avec « Demander aux moteurs de recherche de ne pas indexer ce site » coché, WordPress 5.3 et les versions suivantes n'écrivent plus Disallow: / ; elles utilisent plutôt une balise meta robots.
Shopify dit que son fichier par défaut « convient à la plupart des boutiques ». Il n'y a aucun fichier à déposer : le changer, c'est modifier le modèle robots.txt.liquid du thème, ce que Shopify appelle « une personnalisation non prise en charge ». Next.js sert app/robots.txt tel qu'il est écrit, ou construit le fichier à partir de app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlÉcrit par WordPress lui-même. Modifiez-le avec une extension ou le filtre robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlLe fichier par défaut de Shopify. Modifiez-le dans le modèle robots.txt.liquid du thème.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlVotre propre fichier dans app/robots.txt, ou app/robots.ts, servi à /robots.txt.
Un groupe qui nomme le robot, avec Disallow: / en dessous, fonctionne pour chaque robot dont l'opérateur dit qu'il respecte robots.txt, et seulement pour ceux-là. C'est une demande que le robot honore, pas un verrou : un robot qui ignore le fichier peut quand même récupérer chaque page.
La plupart des entreprises d'IA exploitent plusieurs robots : décidez donc mission par mission. Refuser un robot d'entraînement comme GPTBot ou ClaudeBot refuse celui qui collecte des pages pour les modèles ; refuser un robot de réponses comme OAI-SearchBot ou PerplexityBot vous retire aussi des liens que ces assistants affichent. Le jeton d'entraînement de Google n'est pas Googlebot : « Google-Extended n'a aucune incidence sur l'inclusion d'un site dans la recherche Google et n'est pas utilisé comme signal de classement dans celle-ci. »
Le troisième type est différent. ChatGPT-User, Claude-User, Perplexity-User et Amzn-User récupèrent une page parce qu'une personne a demandé à un assistant de l'ouvrir : les refuser, c'est refuser cette personne, et certains de leurs opérateurs disent que ces robots peuvent de toute façon ignorer robots.txt. C'est pourquoi la liste des robots ci-dessus leur réserve une section à part.
GPTBotRespecteOAI-SearchBotRespecteChatGPT-UserPeut ignorerClaudeBotRespecteClaude-SearchBotRespecteClaude-UserRespectePerplexityBotRespectePerplexity-UserPeut ignorerGoogle-ExtendedJeton seulementPas de robot de ce typePas de robot de ce typeApplebot-ExtendedJeton seulementPas de robot de ce typePas de robot de ce typemeta-externalagentRespectemeta-webindexerRespectemeta-externalfetcherPeut ignorerAmazonbotRespectePas de robot de ce typeAmzn-UserPeut ignorerIl demande aux robots de ne pas récupérer une page ; il ne demande pas à un moteur de recherche de ne pas la référencer. Google « peut tout de même indexer l'URL et l'afficher dans les résultats de recherche sans extrait » quand d'autres pages pointent vers elle. Pour tenir une page à l'écart, utilisez noindex, et laissez la page explorable pour que la balise puisse être lue.
Search Console appelle cela « Indexée malgré le blocage par le fichier robots.txt ». Et Google est explicite : « pour que la règle noindex soit efficace, la page ou la ressource ne doit pas être bloquée par un fichier robots.txt ». Le noindex d'une page interdite n'est donc jamais vu, puisque le robot ne récupère jamais la page.
C'est pourquoi chaque préréglage ci-dessus dit ce qu'il ne fait pas. Le Disallow: / du préréglage de préproduction tient à l'écart les robots respectueux, mais une URL de préproduction vers laquelle pointe un lien, où que ce soit, peut quand même être référencée : placez la préproduction derrière un mot de passe, et ne livrez jamais cette ligne sur le site en production.
<meta name="robots" content="noindex">Jamais luPour tenir une page à l'écart : laissez entrer le robot et utilisez noindex, ou exigez une connexion.
À la racine de l'hôte auquel il s'applique, sous la forme /robots.txt, un fichier par hôte et par protocole. https://example.com/robots.txt ne dit rien de https://www.example.com ni de https://shop.example.com : chacun a besoin de son propre fichier, et un robots.txt placé dans un dossier n'est jamais lu.
Google : « Vous devez placer le fichier robots.txt dans le répertoire racine d'un site, en utilisant un protocole compatible. » Le rapport robots.txt de Search Console liste séparément les fichiers des 20 principaux hôtes d'une propriété, HTTP et HTTPS comptés à part.
Saisissez votre site en haut du générateur : il donne l'adresse exacte à laquelle le fichier doit répondre, remplit la ligne Sitemap: pour cet hôte et renvoie vers le Testeur robots.txt, qui lit le fichier en ligne une fois qu'il est publié.
https://example.com/robots.txtChaque URL de https://example.comhttps://www.example.com/robots.txtSeulement www.example.com : un hôte distincthttp://example.com/robots.txtSeulement le site en http:// : un protocole distincthttps://shop.example.com/robots.txtSeulement shop.example.comhttps://example.com/blog/robots.txtRien : un robots.txt placé dans un dossier n'est jamais luGoogle ne lit aucune de ces directives. Bing lit Crawl-delay, Yandex lit Clean-param, Host ne figure ni dans la norme ni dans la liste de Google, et le Content-Signal de Cloudflare déclare l'usage permis de votre contenu plutôt que ce qui peut être exploré.
Google liste ses quatre champs et ajoute que « d'autres champs tels que crawl-delay ne sont pas acceptés ». Le blog de Bing dit que « la directive crawl-delay n'accepte comme valeurs que des nombres entiers positifs » : l'éditeur refuse donc une fraction plutôt que d'en écrire une. La page d'aide actuelle de Bing n'a pas pu être lue pour confirmer une plage ou une unité : cette page n'indique donc ni l'une ni l'autre.
Aucune d'elles ne casse un fichier : la RFC 9309 impose que l'analyse d'autres enregistrements « NE DOIT PAS interférer avec l'analyse des enregistrements explicitement définis ». Des quatre, le générateur n'écrit que Crawl-delay, en indiquant qui le lit.
User-agentLa litLa litLa litAllowLa litLa litLa litDisallowLa litLa litLa litSitemapLa litLa litLa litCrawl-delayL'ignoreLa litNon confirméClean-paramL'ignoreL'ignoreLa litHostL'ignoreL'ignoreNon confirménoindexL'ignoreNon confirméNon confirméContent-SignalL'ignoreNon confirméNon confirméDeux fois. Avant la publication, avec Testez-le avant de le publier ci-dessus : choisissez un robot et un chemin, et voyez la règle qui en décide. Après l'avoir déposé, lancez le Testeur robots.txt sur le fichier en ligne, car ce que répond le serveur compte autant que ce que dit le fichier.
Un fichier qui répond 404 est lu comme une absence de fichier : chaque robot peut alors tout prendre ; un fichier qui répond 500 ou 503 signifie qu'un robot qui suit la norme ne doit rien prendre. RFC 9309 §2.3.1.4 : le robot « DOIT supposer une interdiction complète ». Google adoucit cette règle par une échelle qui lui est propre, montrée dans la figure.
L'outil de test robots.txt de Google a disparu : Search Central a annoncé son retrait le 15 novembre 2023, et le rapport robots.txt qui l'a remplacé montre le fichier que Google a récupéré, sans tester une URL par rapport à une règle. Testez-le avant de le publier, dans le générateur ci-dessus, et le testeur robots.txt font ce test.
200Suit les règles du fichier.301, 302Suit au moins cinq sauts, puis s'arrête. Google traite alors le fichier comme un 404.403, 404Explore tout, comme s'il n'y avait pas de fichier.429N'explore rien. Google le range avec les réponses 5xx, pas avec les 4xx.500, 503N'explore rien du tout, selon la norme.Nom introuvableIl n'y a aucun site à lire, donc aucun verdict.Les erreurs les plus coûteuses tiennent chacune en une courte ligne : un Disallow: / resté de la préproduction, un préfixe qui va plus loin que prévu, une ligne Sitemap: écrite comme un chemin, un chemin sans sa barre oblique initiale, et une ligne noindex que Google a cessé de lire en 2019.
Chacune est repérée ici avant toute copie du fichier. L'audit du testeur tourne pendant que vous écrivez et ses constats s'affichent sous le fichier ; une ligne qu'un robot rejetterait n'est jamais écrite, et l'éditeur explique, à côté de la saisie concernée, pourquoi elle a été laissée hors du fichier.
Une erreur est une paire, pas une ligne : une URL interdite ici qui porte aussi un noindex sur la page. Le robot ne récupère jamais la page : il ne voit donc jamais le noindex, et l'URL peut rester dans les résultats de recherche. Choisissez : bloquez l'exploration, ou laissez entrer le robot et dites-lui de ne pas indexer.
Disallow: /Un reste de la préproduction : tout le site en ligne est fermé à tous les robots.Disallow: /adminBloque aussi /administrator et /admin-tools. Ajoutez la barre oblique finale.Allow: / sous User-agent: *Jamais lu par un robot qui a son propre groupe, où que ce soit dans le fichier.Sitemap: /sitemap.xmlUne ligne Sitemap doit être une adresse complète, avec l'hôte.Disallow: adminUn chemin commence par /. Cette règle ne correspond à rien.noindex: /private/Mort depuis 2019. La page reste explorable et indexable.* où figure votre Allow. L'éditeur ci-dessus signale une règle qu'une autre bat toujours, et Testez-le avant de le publier nomme la règle décisive et le groupe que le robot a lu.Récupérez le robots.txt de n'importe quel site, testez si une URL est bloquée pour Googlebot ou les crawlers IA et trouvez les erreurs de syntaxe
Explorez votre site et obtenez un sitemap XML, un plan du site HTML et une arborescence visuelle
Trouvez et validez le sitemap XML d'un site : syntaxe, limites d'URLs, dates lastmod, conflits avec robots.txt et URLs cassées ou redirigées
Vérifiez le titre, la meta description, la canonical, les hreflang et les balises Open Graph et X card d'une page, avec aperçus Google et réseaux sociaux
Analysez les en-têtes de réponse HTTP et la notation des en-têtes de sécurité
Détectez votre navigateur, OS, type d'appareil, moteur de rendu et architecture CPU depuis votre user agent