











Décoder et encoder en Base64 : en PDF, image ou fichier
Collez du Base64 pour récupérer le fichier (PDF, image, texte ou JWT), ou déposez un fichier pour obtenir son Base64. Tout se passe dans cet onglet.
Trois octets font 24 bits. Base64 découpe ces mêmes 24 bits en quatre groupes de six, et chaque groupe désigne l'un des 64 caractères. Les lignes blanches marquent la fin des octets : elles ne tombent pas sur les limites des groupes, et c'est là tout le principe.
16 + 2 + 1 = 19 T
Indice 19 dans l'alphabet standard.
Comment utiliser le décodeur et l'encodeur Base64
Collez n'importe quoi dans l'unique champ (du texte, du Base64, une data: URI complète ou un JWT), ou cliquez sur Choisir un fichier ou déposez un fichier sur la carte. L'outil détermine le sens, l'indique sur l'étiquette et garde l'autre lecture à un clic.
Au décodage d'un fichier, vous obtenez le type lu dans les octets eux-mêmes, la taille, la taille en pixels d'une image, l'onglet Aperçu pour une image ou un PDF, et un téléchargement avec la bonne extension. À l'encodage, vous obtenez le Base64, une data: URI prête à l'emploi et ce que l'encodage coûte en taille. Les options Alphabet, Remplissage et Retours à la ligne sous le résultat modifient la sortie.
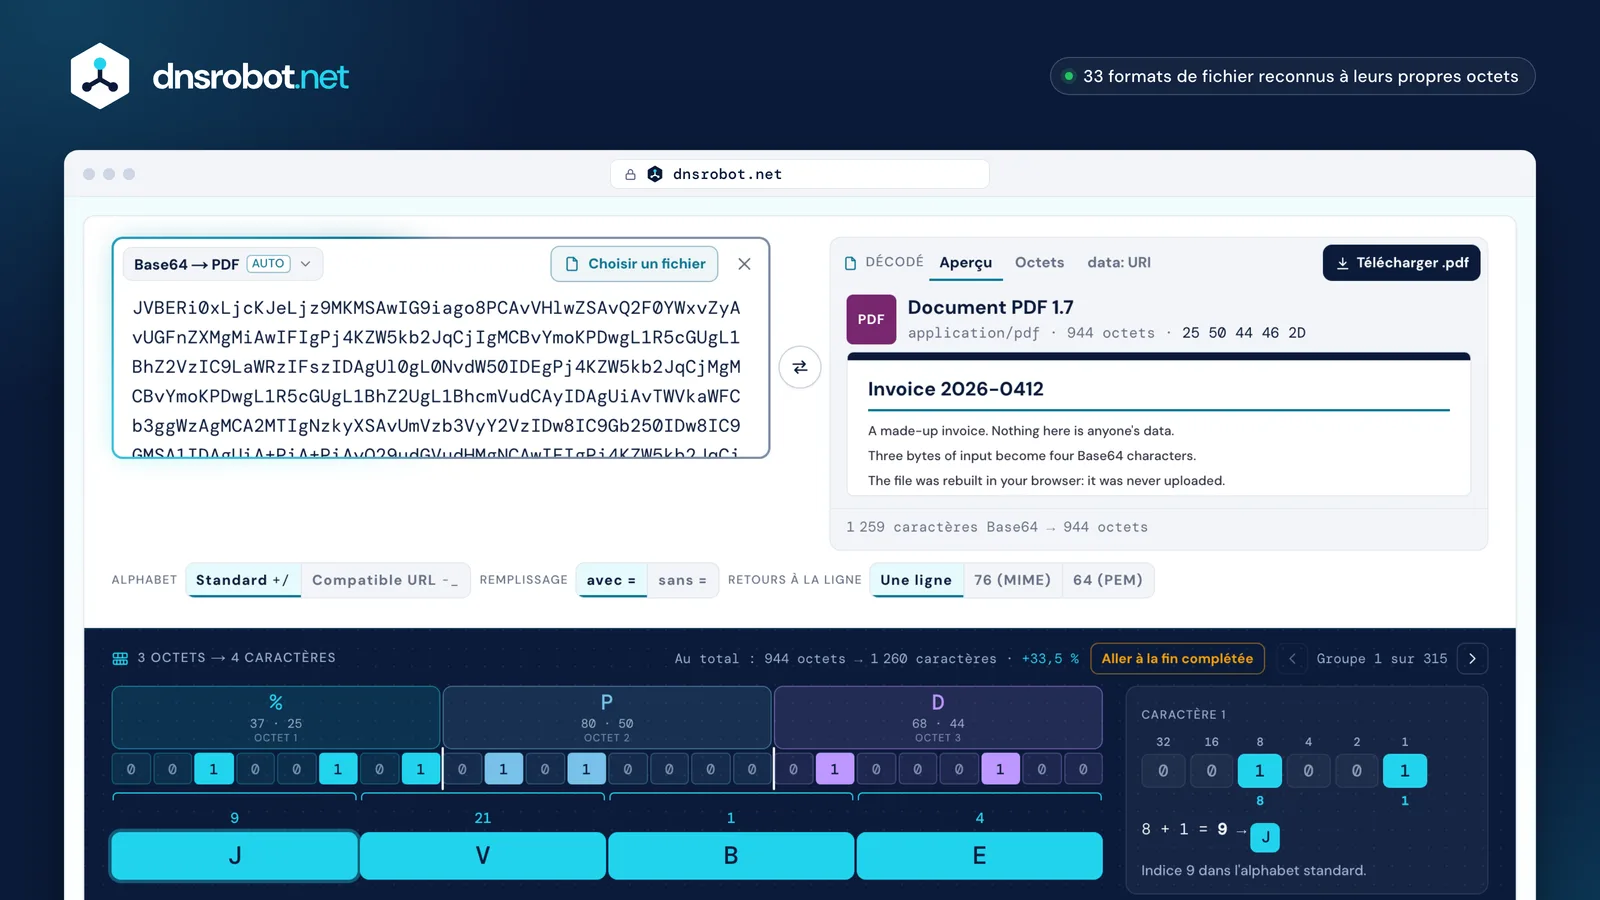
 Un seul champ, dans les deux sensCollez du texte, du Base64, une data: URI ou un JWT. L'étiquette indique comment c'est lu ; le menu permet de le changer.Choisir un fichierOu déposez-en un n'importe où sur la carte : il devient du Base64 et une data: URI, sans quitter l'onglet.Ce que sont les octetsAu décodage, le résultat s'ouvre sur le type, la taille et la signature du fichier, puis un aperçu et un téléchargement.Options de sortieAlphabet standard ou compatible URL, avec ou sans remplissage, et lignes coupées pour MIME ou PEM.3 octets → 4 caractèresVos propres octets, redécoupés en groupes de six. Pointez un caractère pour voir ses bits s'additionner.
Qu'est-ce que le Base64, et pourquoi existe-t-il ?
Le Base64 écrit n'importe quels octets avec 64 caractères qui passent partout : A–Z, a–z, 0–9, + et /. Il existe parce que l'e-mail, les URL, le JSON et le XML ont été conçus pour du texte, et qu'un octet brut peut être un code de contrôle, un guillemet ou un octet nul qui les casse.
Il prend trois octets à la fois, aligne leurs 24 bits et coupe la rangée en quatre groupes de six. Six bits donnent 64 valeurs : chaque groupe désigne donc exactement un caractère. Trois octets en entrée, quatre caractères en sortie, à chaque fois : c'est pourquoi le Base64 est environ un tiers plus gros que ce qui y est entré.
Trois octets font 24 bits. Base64 les redécoupe en quatre groupes de six, et chaque groupe désigne l'un des 64 caractères imprimables : trois octets coûtent donc toujours quatre caractères. C'est de là que vient la hausse de 33 %.
Deux octets font 16 bits. Base64 ajoute 2 bits à zéro pour compléter le troisième groupe, et un = tient la place du quatrième caractère.
Un octet fait 8 bits. Base64 ajoute 4 bits à zéro pour compléter le deuxième groupe, et deux = tiennent la place des troisième et quatrième caractères. = ne porte aucun bit.
Comment convertir du Base64 en PDF ?
Collez la chaîne et l'outil reconstitue le PDF : il affiche la version et la taille, ouvre le document dans la visionneuse PDF de votre navigateur et vous propose un téléchargement. Inutile de préciser qu'il s'agit d'un PDF ou de retirer d'abord un préfixe data:.
Un PDF se reconnaît à ses cinq premiers octets, %PDF- : le fichier est donc identifié même quand son nom, le type annoncé par l'expéditeur ou le champ d'où il vient disent autre chose. Si les octets ne sont pas un PDF, la page dit ce qu'ils sont au lieu d'échouer à ouvrir un document qui n'a jamais existé.
Le fichier est reconstitué dans votre navigateur. Rien n'est envoyé, ce qui compte quand le PDF est une fiche de paie, un contrat ou une facture.
"document": "JVBERi0xLjcKJeLjz9MKMS…"Un champ dans une réponse. Les guillemets ne font pas partie du Base64.Content-Transfer-Encoding: base64MIME coupe le corps à 76 caractères par ligne. Collez-le avec les retours à la ligne : ils sont ignorés.data:application/pdf;base64,JVBERi0x…Collez-la en entier. Le préfixe est lu, pas retiré à la main.- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
Les 5 premiers octets, %PDF-, forment la signature entière. Les octets 6 à 8 sont la version : 1.7. Aucune extension de fichier n'entre en jeu : un PDF que quelqu'un a nommé .txt revient quand même en PDF.
Comment encoder une image en Base64, et quand le faire ?
Déposez l'image et vous obtenez son Base64 et une data: URI prête à coller dans du HTML ou du CSS. Savoir s'il faut le faire est la vraie question : le Base64 coûte toujours environ un tiers de plus, et une image intégrée ne peut pas être mise en cache à part.
Dans l'autre sens, du Base64 en image, vous obtenez le format, la taille et la vraie taille en pixels, lue dans l'en-tête du fichier lui-même et non dans l'image à l'écran, ainsi qu'un téléchargement avec la bonne extension.
- Le fichier sur le disque12,9 ko 100 %
- En Base6417,3 ko +33,4 %
- Coupé à 76 caractères pour MIME17,5 ko +35,1 %
- Le fichier, compressé en gzip11,7 ko -9,5 %
- Le Base64, compressé en gzip12,5 ko -3,2 %
- téléchargé une fois
- mis en cache par le navigateur et le CDN
- chargé à côté de la page, pas dedans
- un tiers plus lourde avant compression
- mise en cache seulement avec le fichier qui la contient
- analysée avec la feuille de style ou le HTML
La compression en récupère l'essentiel : compressé en gzip, le Base64 n'est que 7 % plus lourd que le fichier compressé. Ce qu'elle ne peut pas rendre, c'est l'entrée de cache propre à l'image : intégrée dans une page HTML, elle est retéléchargée avec chaque page qui la contient.
La règle empirique : intégrez quelques centaines d'octets (une icône, un espaceur, un logo dans un e-mail) et liez tout ce qui est plus gros. Cette image PNG de 12,9 ko a déjà franchi la limite.
Base64 ou Base64 compatible URL : quelle différence ?
Le Base64 compatible URL (RFC 4648 §5) est le même encodage avec deux caractères échangés : + devient - et / devient _. Le remplissage est souvent omis aussi.
Utilisez-le partout où le résultat va dans une URL, un nom de fichier ou un cookie. Les JSON Web Tokens l'utilisent d'un bout à l'autre, c'est pourquoi les parties d'un jeton ne finissent jamais par =. Cet outil lit les deux alphabets et vous signale quand une chaîne contient les deux.
+/8=-_8=-_8+→-Indice 62. Dans une chaîne de requête, un décodeur de formulaire lit+comme une espace, et les données reviennent fausses./→_Indice 63. Dans un chemin,/ouvre un nouveau segment, et la valeur est coupée en deux.=suppriméDans une URL,=est généralement encodé en pourcent sous la forme%3D(RFC 4648 §5). Un JWT le supprime complètement (RFC 7515 §2) : la longueur seule indique où finissent les octets.
Les 62 premiers caractères des deux alphabets sont identiques : c'est pourquoi un outil qui lit les deux alphabets peut décoder l'un comme l'autre, et pourquoi cette page vous signale quand une chaîne contient les deux.
Le Base64 est-il un chiffrement ? Non.
Le Base64 ne cache rien. Il n'y a ni clé ni secret, et l'inverser ne demande aucun effort : un décodeur comme celui-ci le fait pendant que vous tapez.
C'est avec l'authentification HTTP Basic que cela compte le plus : l'en-tête transporte le nom d'utilisateur et le mot de passe sous la forme d'une seule chaîne Base64, lisible par quiconque la voit, et c'est pourquoi la RFC 7617 ne considère cette authentification comme sûre que sur une connexion chiffrée comme TLS. Si quelque chose doit rester illisible, il faut un chiffrement. Le Base64 ne fait que transporter des octets sans dommage à travers un canal conçu pour du texte.
Un en-tête Authorization, tel que le construit la RFC 7617 §2
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordLa RFC 7617 construit l'en-tête étape par étape, et la dernière étape est toute sa « protection » : le client « obtient les basic-credentials en encodant cette séquence d'octets en Base64 ». Son §1 dit ce que cela signifie : à moins que TLS ou un système similaire ne protège la connexion, « l'identifiant de l'utilisateur et le mot de passe sont transmis sur le réseau en clair ». Base64 n'a pas de clé, il n'y a donc rien à casser : quiconque a la chaîne a le mot de passe.
Pourquoi mon texte décodé affiche-t-il des caractères bizarres (mojibake) ?
Parce que le Base64 transporte des octets, et que les octets ne deviennent des lettres qu'une fois un encodage de caractères choisi. Lisez de l'UTF-8 comme si c'était de l'ISO-8859-1 et é devient é ; lisez de l'ISO-8859-1 comme de l'UTF-8 et il devient un caractère de remplacement.
Une data: URI peut déclarer son charset, et cette page lit le texte dans ce charset au lieu de tout forcer en UTF-8. Si votre navigateur n'a pas de décodeur pour celui qui est déclaré, la page le dit au lieu de vous montrer discrètement les mauvaises lettres.
En UTF-8, é occupe 2 octets ; en ISO-8859-1, 1 octet. Base64 transporte des octets, pas des lettres : la chaîne elle-même ne peut pas dire à un décodeur lequel était voulu.
Le Base64 en Python, JavaScript, Java, C#, Go, PowerShell et dans le shell
Tous les langages intègrent le Base64. Les pièges sont partout les mêmes : encodez des octets, pas une chaîne, et précisez dans quel encodage de caractères est le texte.
Le btoa() de JavaScript est le point le plus délicat : il n'accepte que les caractères jusqu'à U+00FF, donc tout ce qui dépasse le Latin-1 doit d'abord devenir des octets UTF-8 avec TextEncoder. Chaque exemple ci-dessous encode et décode « Man » et a été exécuté pour vérifier sa sortie.
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
Exécuté avec Python 3.14.4 le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
Exécuté avec Node.js 22.23.2 le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
Exécuté avec OpenJDK 25.0.2 le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
Exécuté avec .NET 10.0.103 le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
Exécuté avec Go 1.25.5 le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
Exécuté avec PowerShell 7.5.5 le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
Exécuté avec la commande base64 de macOS 26.6 (bash) le 26 octobre 2026 : le code affiche ce que montrent les commentaires.
base64 -d du shell s'écrit -D sur les anciennes versions de macOS. Source: gnu.org, developer.mozilla.orgL'alphabet Base64, de 0 à 63
Chaque groupe de six bits est un nombre de 0 à 63, et voici la table où il est cherché. Le Base64 est sensible à la casse : A vaut 0 et a vaut 26, donc changer la casse d'une lettre casse la chaîne.
Cela vaut la peine de le reconnaître à l'œil : une suite de A est une suite d'octets nuls, et une chaîne Base64 qui commence par JVBER est un PDF, par iVBOR un PNG et par /9j/ un JPEG.
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +Compatible URL : -62
- /Compatible URL : _63
0–25 sont A–Z, 26–51 sont a–z, 52–61 sont 0–9. Seuls les deux derniers caractères de la table diffèrent entre les deux alphabets, signalés ci-dessus. = n'est pas du tout dans la table : ce n'est pas une valeur, c'est la marque qui indique que le dernier groupe de trois octets était court.
Base64 : questions et réponses
Que veut dire décoder du Base64 (« Base64 decode ») ?
Comment décoder un fichier Base64 ?
À quoi sert le Base64 ?
data: URI dans le HTML et le CSS, champs binaires dans le JSON et le XML, JSON Web Tokens, authentification HTTP Basic, certificats et clés dans les fichiers PEM. Dans chaque cas, les données doivent traverser un canal qui pourrait modifier ou perdre des octets bruts : elles voyagent donc en simples lettres et chiffres.Le Base64 est-il un chiffrement ?
Est-il sûr de décoder du Base64 en ligne ?
Pourquoi le Base64 est-il 33 % plus gros que l'original ?
= peuvent s'ajouter à la fin, et couper les lignes à 76 caractères pour l'e-mail ajoute un retour à la ligne à chaque ligne : une longue chaîne est donc souvent environ 35 % plus grosse que les octets qu'elle transporte. Une compression comme gzip en récupère l'essentiel.Qu'est-ce que le Base64 compatible URL ?
+ est remplacé par - et / par _, comme le définit la RFC 4648 §5, pour que le résultat puisse aller dans une URL, un nom de fichier ou un cookie sans être échappé. Le remplissage est généralement supprimé aussi, comme dans les JSON Web Tokens. Cet outil lit les deux alphabets, même mélangés dans une seule chaîne, et peut écrire l'un ou l'autre.Pourquoi mon décodage Base64 échoue-t-il ?
Peut-on convertir du Base64 en image ?
data:image/png;base64,, et l'image apparaît avec son format, sa taille et sa vraie taille en pixels, lue dans l'en-tête du fichier lui-même. Téléchargez-la ensuite avec la bonne extension. PNG, JPEG, GIF, WebP, BMP, ICO et AVIF sont prévisualisés ; un SVG est d'abord affiché comme texte, car un SVG peut contenir du script.Que signifie le = à la fin d'un Base64 ?
=, un octet restant donne deux caractères et ==. Le remplissage ne porte aucune donnée : il indique seulement à un décodeur où finissent les octets. Beaucoup de décodeurs, dont celui-ci, lisent aussi le Base64 dont le remplissage a été omis.Y a-t-il une limite de taille ?
Puis-je décoder un JWT ici ?
iat et exp, et la signature sous forme d'octets. Cette page ne fait que décoder les trois parties base64url : elle ne vérifie pas la signature et ne dit jamais qu'un jeton est valide. Ne vous en servez donc pas pour décider de faire confiance à un jeton.Il vous manque quelque chose ?Suggérez une fonction ou un nouvel outil
Outils associés
Convertisseur et Traducteur Binaire
Traduisez du texte en binaire et du binaire en texte : détection auto, hex, décimal et octal
Générateur UUID
Générez des UUID v4, v7, v1, v5 et v3 ou des GUID en masse, dans tous les formats, et décodez la version et le timestamp d'un UUID
Décodeur CSR et certificat
Décodez un CSR ou un certificat SSL : sujet, SAN, taille de clé, validité, émetteur, empreinte, contrôle de signature et correspondance CSR-certificat
Caractère invisible
Copiez-collez un caractère invisible ou un espace vide, et trouvez ou supprimez les caractères cachés d'un texte
Convertisseur timestamp Unix
Convertissez des timestamps Unix en dates et des dates en temps epoch dans n'importe quel fuseau horaire, avec conversion par lot