











Base64 dekodieren & kodieren: in PDF, Bild oder Datei
Base64 einfügen und die Datei zurückerhalten, ob PDF, Bild, Text oder JWT, oder eine Datei ablegen und ihr Base64 erhalten. Alles geschieht in diesem Tab.
Drei Bytes haben 24 Bit. Base64 schneidet dieselben 24 Bit in vier Sechsergruppen, und jede Gruppe benennt eines von 64 Zeichen. Die weißen Linien zeigen, wo die Bytes enden: Sie fallen nicht mit den Gruppen zusammen, und genau das ist der ganze Trick.
16 + 2 + 1 = 19 T
Index 19 im Standardalphabet.
So nutzen Sie den Base64-Decoder und -Encoder
Fügen Sie alles in das eine Feld ein (Text, Base64, eine ganze data: URI oder ein JWT), klicken Sie auf Datei auswählen oder ziehen Sie eine Datei auf die Karte. Der B64-Converter erkennt selbst, in welche Richtung es geht, zeigt das in der Anzeige und hält die andere Lesart einen Klick entfernt bereit.
Dekodieren Sie eine Datei, erhalten Sie den Typ, gelesen aus den Bytes selbst, die Größe, bei Bildern die Pixelgröße, eine Vorschau von Bildern und PDFs und einen Download mit der richtigen Dateiendung. Kodieren Sie eine, erhalten Sie das Base64, eine fertige data: URI und was die Kodierung an Größe kostet. Die Optionen Alphabet, Padding und Zeilenumbrüche unter dem Ergebnis ändern die Ausgabe.
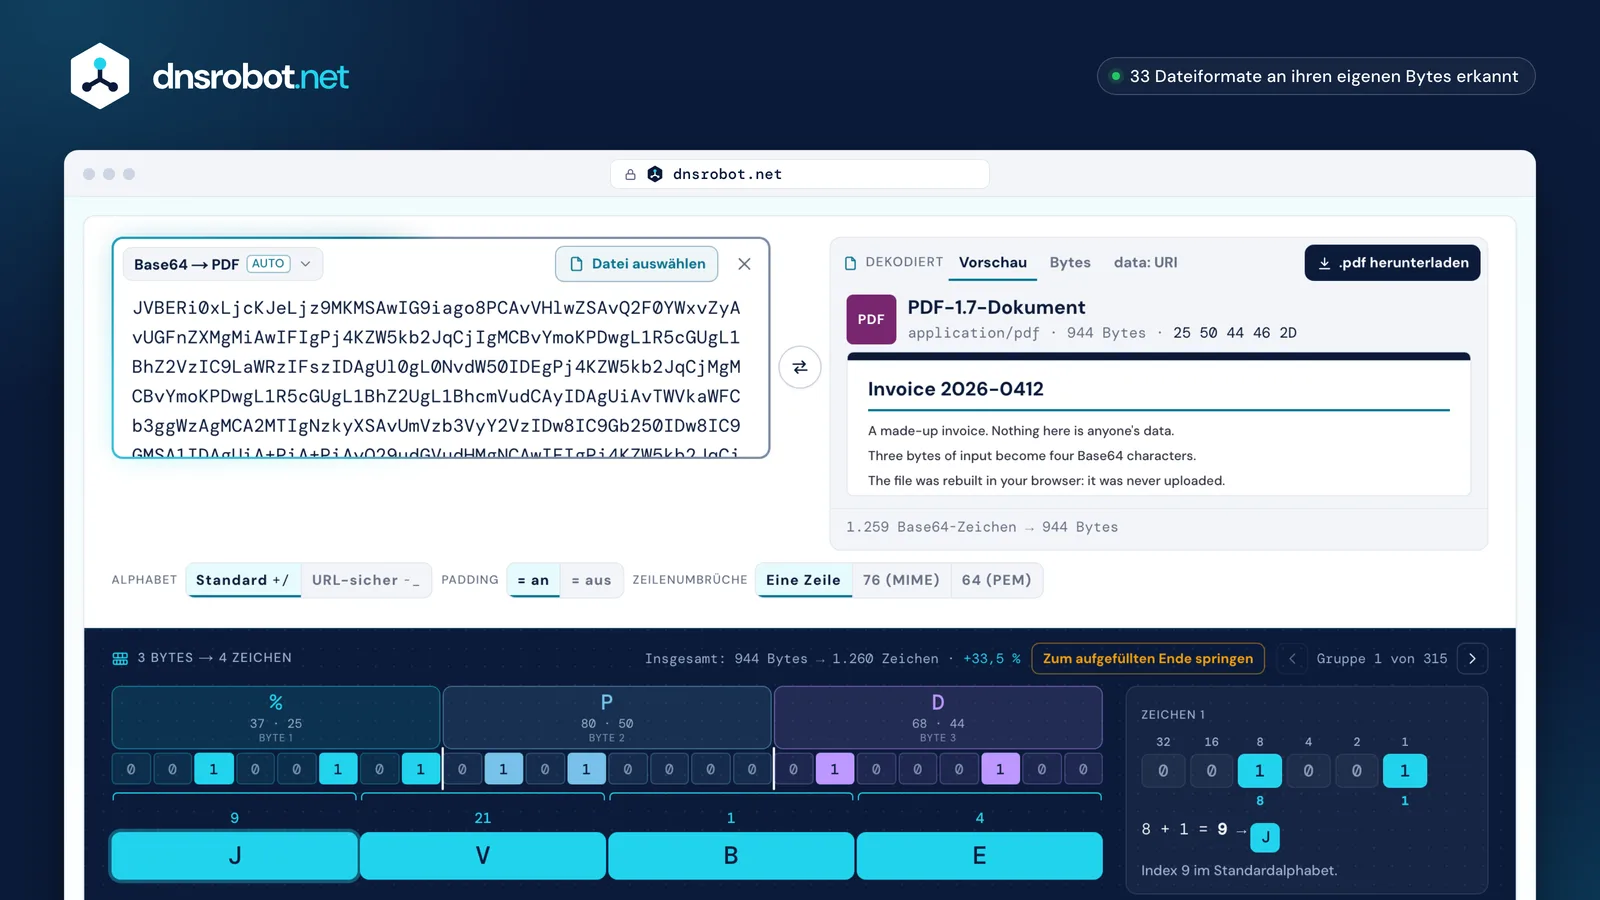
 Ein Feld, beide RichtungenText, Base64, eine data: URI oder ein JWT einfügen. Die Anzeige sagt, wie die Eingabe gelesen wurde; das Menü ändert es.Datei auswählenOder eine Datei irgendwo auf die Karte ziehen: Sie wird zu Base64 und einer data: URI, ohne den Tab zu verlassen.Was die Bytes sindBeim Dekodieren beginnt das Ergebnis mit Typ, Größe und Signatur der Datei, dann folgen eine Vorschau und ein Download.AusgabeoptionenStandard- oder URL-sicheres Alphabet, Padding an oder aus und Zeilenumbrüche für MIME oder PEM.3 Bytes → 4 ZeichenIhre eigenen Bytes, neu in Sechsergruppen geschnitten. Zeigen Sie auf ein Zeichen, um zu sehen, wie sich seine Bits addieren.
Was ist Base64-Codierung, und wozu gibt es sie?
Base64 schreibt beliebige Bytes mit 64 Zeichen, die überall durchkommen: A–Z, a–z, 0–9, + und /. Es gibt Base64, weil E-Mail, URLs, JSON und XML für Text gebaut wurden und ein rohes Byte ein Steuerzeichen, ein Anführungszeichen oder ein Nullbyte sein kann, das sie zerbricht.
Base64 nimmt jeweils drei Bytes, legt ihre 24 Bit in eine Reihe und schneidet die Reihe in vier Sechsergruppen. Sechs Bit fassen 64 Werte, also benennt jede Gruppe genau ein Zeichen. Drei Bytes hinein, vier Zeichen heraus, jedes Mal: Deshalb ist Base64 etwa ein Drittel größer als das, was hineinging.
Drei Bytes haben 24 Bit. Base64 schneidet sie neu in vier Sechsergruppen, und jede Gruppe benennt eines von 64 druckbaren Zeichen, also kosten drei Bytes immer vier Zeichen. Daher stammt das Plus von 33 %.
Zwei Bytes haben 16 Bit. Base64 ergänzt 2 Null-Bits, um die dritte Gruppe zu vervollständigen, und ein = steht dort, wo das vierte Zeichen wäre.
Ein Byte hat 8 Bit. Base64 ergänzt 4 Null-Bits, um die zweite Gruppe zu vervollständigen, und zwei = stehen dort, wo das dritte und vierte Zeichen wären. = trägt überhaupt keine Bits.
Wie wandle ich Base64 in PDF um?
Fügen Sie die Zeichenkette ein, und das Tool stellt das PDF wieder her: Es zeigt Version und Größe, öffnet das Dokument im eingebauten PDF-Viewer Ihres Browsers und bietet einen Download an. Sie müssen weder sagen, dass es ein PDF ist, noch vorher ein data:-Präfix entfernen.
Ein PDF erkennt man an seinen ersten fünf Bytes, %PDF-, daher wird die Datei auch dann erkannt, wenn ihr Name, der vom Absender angegebene Typ oder das Feld, aus dem sie kam, etwas anderes sagen. Sind die Bytes kein PDF, sagt die Seite, was sie stattdessen sind, statt an einem Dokument zu scheitern, das es nie gab.
Die Datei wird in Ihrem Browser wiederhergestellt. Nichts wird hochgeladen, und das zählt, wenn das PDF eine Gehaltsabrechnung, ein Vertrag oder eine Rechnung ist.
"document": "JVBERi0xLjcKJeLjz9MKMS…"Ein Feld in einer Antwort. Die Anführungszeichen gehören nicht zum Base64.Content-Transfer-Encoding: base64MIME bricht den Body nach 76 Zeichen pro Zeile um. Fügen Sie ihn mit den Zeilenumbrüchen ein: Sie werden übersprungen.data:application/pdf;base64,JVBERi0x…Fügen Sie alles ein. Das Präfix wird gelesen, nicht von Hand entfernt.- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
Die ersten 5 Bytes, %PDF-, sind die ganze Signatur. Die Bytes 6 bis 8 sind die Version: 1.7. Eine Dateiendung spielt keine Rolle, daher kommt ein PDF, das jemand .txt genannt hat, trotzdem als PDF zurück.
Wie wandle ich ein Bild in Base64 um, und wann lohnt sich das?
Legen Sie das Bild ab, und Sie erhalten sein Base64 und eine fertige data: URI zum Einfügen in HTML oder CSS. Ob Sie das tun sollten, ist die schwierigere Frage: Base64 kostet immer etwa ein Drittel mehr, und ein eingebettetes Bild lässt sich nicht für sich allein zwischenspeichern.
Wenn Sie umgekehrt Base64 in ein Bild umwandeln, erhalten Sie das Format, die Größe und die echte Pixelgröße, gelesen aus dem Header der Datei selbst, nicht aus dem Bild auf dem Bildschirm, dazu einen Download mit der richtigen Dateiendung.
- Die Datei auf der Festplatte12,9 kB 100 %
- Als Base6417,3 kB +33,4 %
- Für MIME bei 76 Zeichen umbrochen17,5 kB +35,1 %
- Die Datei, mit gzip komprimiert11,7 kB -9,5 %
- Das Base64, mit gzip komprimiert12,5 kB -3,2 %
- einmal heruntergeladen
- vom Browser und vom CDN zwischengespeichert
- neben der Seite geladen, nicht in ihr
- vor der Kompression ein Drittel größer
- nur als Teil der Datei zwischengespeichert, die es enthält
- als Teil des Stylesheets oder des HTML geparst
Kompression holt das meiste zurück: Mit gzip komprimiert ist das Base64 nur 7 % größer als die komprimierte Datei. Was sie nicht zurückgeben kann, ist der eigene Cache-Eintrag des Bildes: In eine HTML-Seite eingebettet, wird es mit jeder Seite, die es enthält, erneut heruntergeladen.
Die Faustregel: Betten Sie ein paar Hundert Bytes ein (ein Icon, einen Abstandhalter, ein Logo in einer E-Mail) und verlinken Sie alles Größere. Dieses PNG-Bild mit 12,9 kB liegt schon über der Grenze.
Base64 vs. URL-sicheres Base64: Was ist der Unterschied?
URL-sicheres Base64 (RFC 4648 §5) ist dieselbe Codierung mit zwei getauschten Zeichen: Aus + wird - und aus / wird _. Das Padding wird oft ebenfalls weggelassen.
Verwenden Sie es überall, wo das Ergebnis in eine URL, einen Dateinamen oder ein Cookie kommt. JSON Web Tokens verwenden es durchgehend, deshalb enden die Teile eines Tokens nie auf =. Dieses Tool liest beide Alphabete und sagt Ihnen, wenn eine Zeichenkette beide enthält.
+/8=-_8=-_8+→-Index 62. In einem Query-String liest ein Formular-Decoder+als Leerzeichen, und die Daten kommen falsch zurück./→_Index 63. In einem Pfad beginnt/ein neues Segment, und der Wert wird in zwei Teile gespalten.=entfälltIn einer URL wird=meist als%3Dprozentkodiert (RFC 4648 §5). Ein JWT lässt es ganz weg (RFC 7515 §2): Die Länge allein sagt, wo die Bytes enden.
Die ersten 62 Zeichen der beiden Alphabete sind identisch. Deshalb kann ein Tool, das beide Alphabete liest, jedes von beiden dekodieren, und deshalb sagt Ihnen diese Seite, wenn eine Zeichenkette beide enthält.
Ist Base64 eine Verschlüsselung? Nein.
Base64 verbirgt nichts. Es gibt keinen Schlüssel und kein Geheimnis, und die Umkehrung kostet keinerlei Mühe: Ein Decoder wie dieser erledigt sie schon beim Tippen.
Am meisten zählt das bei der Authentifizierung per HTTP Basic: Der Header trägt Benutzername und Passwort als eine einzige Base64-Zeichenkette, lesbar für jeden, der sie sieht. Deshalb hält RFC 7617 das Verfahren nur über eine verschlüsselte Verbindung wie TLS für sicher. Wenn etwas unlesbar bleiben muss, braucht es Verschlüsselung. Base64 bringt Bytes nur sicher durch einen Kanal, der für Text gebaut ist.
Ein Authorization-Header, wie RFC 7617 §2 ihn bildet
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordRFC 7617 baut den Header Schritt für Schritt auf, und der letzte Schritt ist sein ganzer „Schutz“: Der Client „erhält die basic-credentials, indem er diese Oktettfolge mit Base64 kodiert“. Sein §1 sagt, was das bedeutet: Sofern nicht TLS oder ein ähnliches System die Verbindung schützt, „werden Benutzerkennung und Passwort als Klartext über das Netzwerk übertragen“. Base64 hat keinen Schlüssel, also gibt es nichts zu knacken: Wer die Zeichenkette hat, hat das Passwort.
Warum wird mein dekodierter Text zu Zeichensalat?
Weil Base64 Bytes transportiert, und Bytes werden erst zu Buchstaben, wenn etwas eine Zeichenkodierung wählt. Lesen Sie UTF-8-Text, als wäre er ISO-8859-1, wird aus é ein é; lesen Sie ISO-8859-1 als UTF-8, wird daraus ein Ersatzzeichen.
Eine data: URI kann ihren Zeichensatz (charset) angeben, und diese Seite liest den Text in diesem Zeichensatz, statt alles in UTF-8 zu zwingen. Hat Ihr Browser keinen Decoder für den angegebenen, sagt die Seite das, statt Ihnen stillschweigend die falschen Buchstaben zu zeigen.
In UTF-8 belegt é 2 Bytes, in ISO-8859-1 1 Byte. Base64 transportiert Bytes, keine Buchstaben, daher kann die Zeichenkette selbst einem Decoder nicht sagen, was gemeint war.
Base64 in Python, JavaScript, Java, C#, Go, PowerShell und der Shell
Jede Sprache hat Base64 eingebaut. Die Fallen sind überall dieselben: Kodieren Sie Bytes, keinen String, und geben Sie an, in welcher Zeichenkodierung der Text vorliegt.
JavaScripts btoa() ist die schärfste Kante: Es nimmt nur Zeichen bis U+00FF, alles jenseits von Latin-1 muss also zuerst mit TextEncoder zu UTF-8-Bytes werden. Jedes Beispiel unten kodiert und dekodiert „Man“ und wurde ausgeführt, um seine Ausgabe zu prüfen.
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
Ausgeführt mit Python 3.14.4 am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
Ausgeführt mit Node.js 22.23.2 am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
Ausgeführt mit OpenJDK 25.0.2 am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
Ausgeführt mit .NET 10.0.103 am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
Ausgeführt mit Go 1.25.5 am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
Ausgeführt mit PowerShell 7.5.5 am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
Ausgeführt mit dem Befehl base64 von macOS 26.6 (bash) am 26. Oktober 2026: Es gibt aus, was die Kommentare zeigen.
base64 -d der Shell heißt auf älteren macOS-Versionen -D. Quelle: gnu.org, developer.mozilla.orgDas Base64-Alphabet, von 0 bis 63
Jede Sechsergruppe ist eine Zahl von 0 bis 63, und dies ist die Tabelle, in der sie nachgeschlagen wird. Base64 unterscheidet Groß- und Kleinschreibung: A ist 0 und a ist 26, wer also die Schreibung eines Buchstabens ändert, zerstört die Zeichenkette.
Es lohnt sich, Base64 auf einen Blick zu erkennen: Eine Reihe von A ist eine Reihe von Nullbytes, und eine Base64-Zeichenkette, die mit JVBER beginnt, ist ein PDF, mit iVBOR ein PNG und mit /9j/ ein JPEG.
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +URL-sicher: -62
- /URL-sicher: _63
0–25 sind A–Z, 26–51 sind a–z, 52–61 sind 0–9. Nur die letzten beiden Zeichen der Tabelle unterscheiden sich zwischen den beiden Alphabeten, oben markiert. = steht gar nicht in der Tabelle: Es ist kein Wert, sondern das Zeichen dafür, dass die letzte Gruppe aus drei Bytes kurz war.
Base64: Fragen und Antworten
Was bedeutet Base64 dekodieren?
Wie dekodiere ich eine Base64-Datei?
Wofür wird Base64 verwendet?
data: URIs in HTML und CSS, Binärfelder in JSON und XML, JSON Web Tokens, die Authentifizierung per HTTP Basic sowie Zertifikate und Schlüssel in PEM-Dateien. In jedem Fall müssen die Daten einen Kanal passieren, der rohe Bytes verändern oder verwerfen könnte, also reisen sie als einfache Buchstaben und Ziffern.Ist die Base64-Codierung eine Verschlüsselung?
Ist es sicher, Base64 online zu dekodieren?
Warum ist Base64 33 % größer als das Original?
= als Padding hinzukommen, und wer die Zeilen für E-Mail nach 76 Zeichen umbricht, fügt jeder Zeile einen Zeilenumbruch hinzu. Eine lange Zeichenkette ist daher oft etwa 35 % größer als die Bytes, die sie trägt. Kompression wie gzip holt das meiste davon zurück.Was ist URL-sicheres Base64?
+ durch - und / durch _ ersetzt ist, wie RFC 4648 §5 es definiert, damit das Ergebnis ohne Maskierung in eine URL, einen Dateinamen oder ein Cookie passt. Das Padding wird meist ebenfalls weggelassen, etwa in JSON Web Tokens. Dieses Tool liest beide Alphabete, sogar gemischt in einer Zeichenkette, und kann jedes von beiden schreiben.Warum schlägt das Dekodieren meines Base64 fehl?
Kann ich Base64 in ein Bild umwandeln?
data:image/png;base64,, und das Bild erscheint mit Format, Größe und echter Pixelgröße, gelesen aus dem Header der Datei selbst. Dann laden Sie es mit der richtigen Dateiendung herunter. PNG, JPEG, GIF, WebP, BMP, ICO und AVIF erhalten eine Vorschau; ein SVG wird zuerst als Text gezeigt, weil ein SVG Skript enthalten kann.Was bedeutet das = am Ende von Base64?
=, ein übriges Byte wird zu zwei Zeichen und ==. Das Padding trägt überhaupt keine Daten: Es sagt einem Decoder nur, wo die Bytes enden. Viele Decoder, darunter dieser, lesen auch Base64, bei dem das Padding weggelassen wurde.Gibt es eine Größenbeschränkung?
Kann ich hier ein JWT dekodieren?
iat und exp und der Signatur als Bytes. Diese Seite dekodiert nur die drei base64url-Teile: Sie prüft die Signatur nicht und sagt nie, dass ein Token gültig ist. Verwenden Sie sie also nicht, um zu entscheiden, ob Sie einem Token vertrauen.Fehlt Ihnen etwas?Funktion oder neues Tool vorschlagen
Verwandte Tools
Binär-Übersetzer
Text in Binär und Binär in Text übersetzen: automatische Erkennung, Hex, Dezimal und Oktal
UUID-Generator
UUID v4, v7, v1, v5 und v3 oder GUIDs in großer Menge und in jedem Format erzeugen und Version und Zeitstempel einer UUID dekodieren
CSR- & Zertifikat-Decoder
CSR oder SSL-Zertifikat dekodieren: Subject, SANs, Schlüsselgröße, Gültigkeit, Aussteller, Fingerprint, Signaturprüfung und CSR-Zertifikat-Abgleich
Unsichtbares Zeichen
Unsichtbares Zeichen oder Leerzeichen kopieren und einfügen sowie versteckte Zeichen in Text finden oder entfernen
Epoch-Konverter
Unix-Timestamps in ein Datum und Daten in Epoch-Zeit umrechnen, in jeder Zeitzone und mit Batch-Umrechnung