











Link-Analyzer
Interne Links analysieren und externe Links prüfen: Sie sehen jeden Link einer Seite so, wie Google ihn liest. Intern oder extern, gefolgt oder nofollow, sponsored oder ugc, wohin er wirklich führt und welche Links defekt sind.
Eine Domain genügt auch: example.org liest die Startseite.
- AbrufLiest das HTML einmal
- WeiterleitungenBis zu 10, jede geprüft
- Robotsmeta + X-Robots-Tag
- Gefundene Links<a> und <area>
Was prüft ein Link-Analyzer bei der Linkanalyse?
Ein Link-Analyzer liest eine Seite und listet jeden Link darauf auf: wohin er führt, wie er für Suchmaschinen markiert ist, was sein Ankertext sagt und wo er tatsächlich landet, wenn man ihm folgt.
Er liest das HTML der Seite so, wie Googlebot es zuerst sieht. Google folgt <a>-Elementen mit einem href (Google); relative Links werden gegen das <base href> der Seite aufgelöst, sonst gegen ihre Adresse nach Weiterleitungen (HTML).
Danach wird jede einzelne URL einmal per GET angefragt, ihre Weiterleitungen Schritt für Schritt verfolgt. Eine HEAD-Anfrage wäre schneller, doch Server antworten darauf oft anders als auf einen echten Besuch. Ein Link, der hinter einer Weiterleitung in einem 404 endet, gilt hier deshalb weiterhin als defekt.
- 1Wohin er führtexternwww.rfc-editor.org
- 2Wie er markiert istnofollowmw:extlinkbleibt, ohne SEO-Bedeutung
- 3Was er sagt“1035”
- 4Wo er landet↳ 301 /info/rfc1035/OK 200185 ms
- 5Wo er stehtLink 187 von 1.117, unter „Contents“
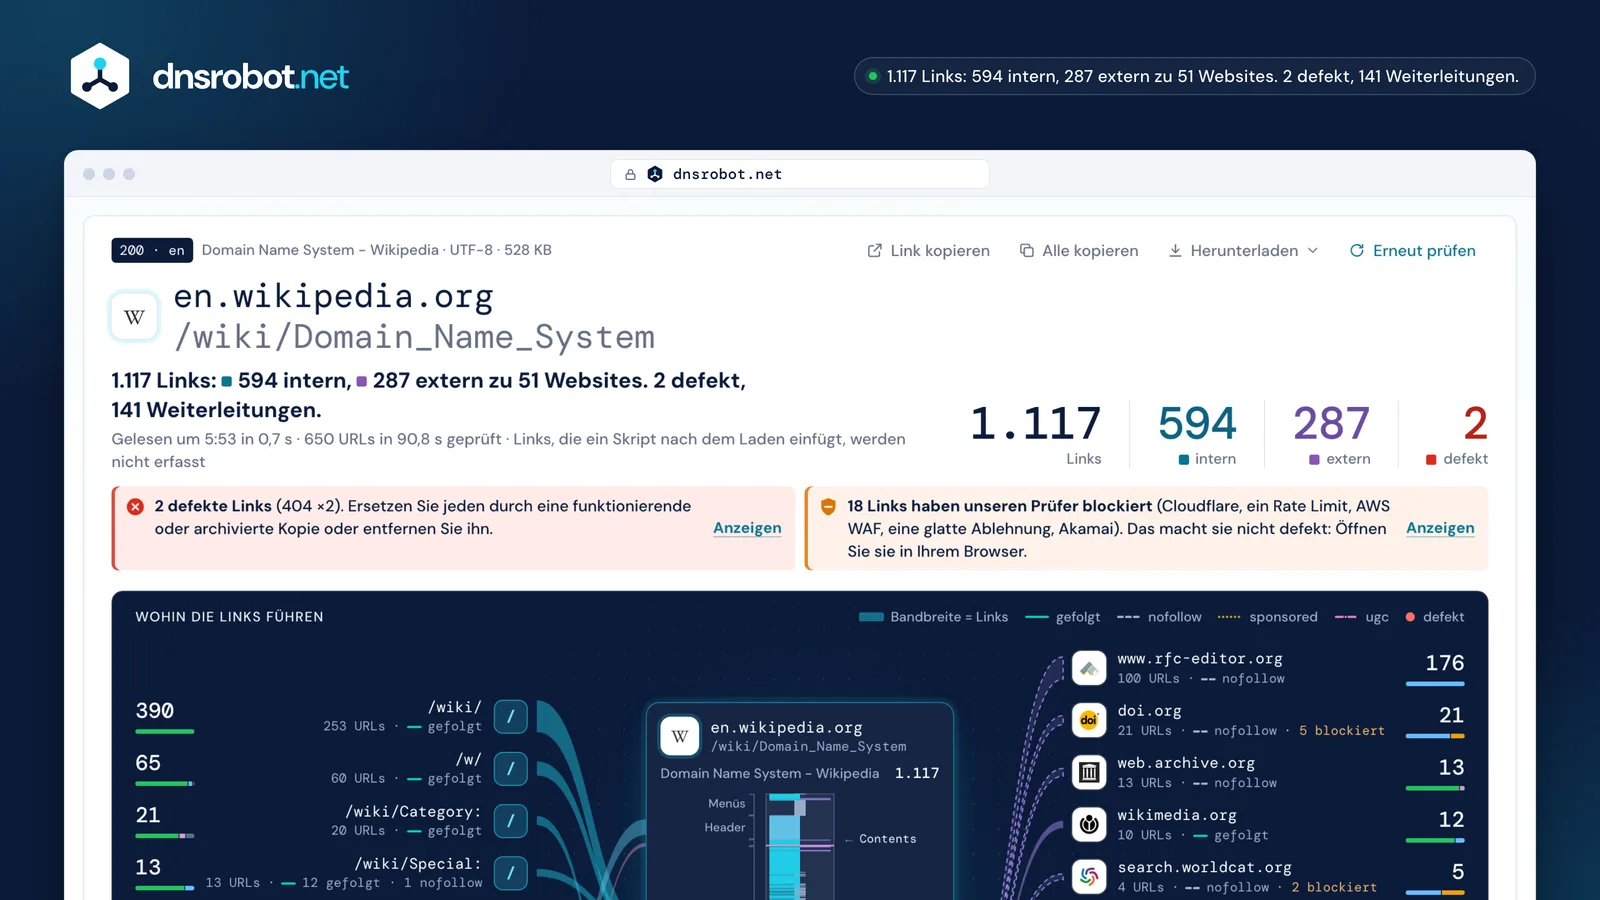
 Zuerst die AntwortWie viele Links die Seite hat, wie viele auf der Website bleiben und wie viele sie verlassen, und wie viele defekt sind.Hinweise mit LösungDefekte Links, Links, die nur der Bot-Schutz gestoppt hat, lohnende Weiterleitungen, leere Ankertexte: jeweils mit Anzahl und dem, was zu tun ist.Die Seite von oben nach untenEin Strich pro Link an der Stelle, an der er auf der Seite steht: Menüs, Artikel, Quellenangaben, Footer.Wohin die Links führenEin Band pro Bereich und pro Website, so breit wie die Zahl seiner Links, gestrichelt, wenn die Links nofollow sind.
Interne Verlinkung prüfen: Was zählt als intern, was als extern?
Ein interner Link zeigt auf denselben Host wie die Seite; ein externer Link zeigt auf eine andere Website. Links auf einen anderen Host derselben Website, etwa de.wikipedia.org von en.wikipedia.org aus, werden gesondert gezählt.
Interne Links helfen Lesern und Crawlern, die übrigen Seiten einer Website zu finden; jede wichtige Seite sollte von mindestens einer anderen verlinkt sein (Google). Externe Links sind für sich kein Risiko: Gute Quellen zu nennen hilft Lesern, einer Seite zu vertrauen.
Google empfiehlt nofollow nur für Links, für die Sie nicht bürgen, nicht für jeden externen Link. Ein Link auf #section bleibt auf derselben Seite, und Google behandelt Fragmente nicht als eigene Seiten (Google).
- gleicher Host 514
- gleiche Website, anderer Host 80
- andere Website 287
- gleiche Seite 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_nameinternGleicher Host wie die Seite: intern.
- de.wikipedia.org/wiki/Domain_Name_Systemgleiche WebsiteGleiche Website (wikipedia.org), anderer Host: gesondert gezählt.
- www.wikidata.org/wiki/Q8767externAndere Domain, auch wenn Wikimedia sie betreibt: extern.
- www.rfc-editor.org/rfc/rfc1035externAndere Domain: extern.
nofollow, sponsored und ugc (und warum „dofollow“ kein Attribut ist)
rel="nofollow" bittet Suchmaschinen, einen Link nicht als Ihre Empfehlung zu werten, rel="sponsored" kennzeichnet einen bezahlten Link oder eine Anzeige, und rel="ugc" kennzeichnet einen Link, den Ihre Nutzer geschrieben haben. Ein Link ohne einen dieser Werte wird gefolgt: Einen dofollow-Wert gibt es nicht.
Seit dem 10. September 2019 sind alle drei Hinweise, keine Befehle, und seit dem 1. März 2020 auch für Crawling und Indexierung (Google). Werte lassen sich kombinieren, etwa ugc nofollow, getrennt durch Leerzeichen oder Kommas.
Am wichtigsten: Ein bezahlter Link ohne sponsored oder nofollow verstößt gegen Googles Spam-Richtlinien (Google). Im gelesenen Wikipedia-Artikel tragen 267 der 287 externen Links nofollow, das MediaWiki bei jeder Quellenangabe ergänzt.
<a href>Gefolgt per Standard: nichts hinzuzufügenrel="nofollow"Keine Empfehlung: wenn kein anderer Wert passtrel="sponsored"Bezahlt oder Anzeige: bei bezahlten Links nötig (oder nofollow)rel="ugc"Von Nutzern geschrieben: Kommentare, Forenbeiträgerel="ugc nofollow"Beide: erlaubt, für ältere Crawlerrel="dofollow"Kein Wert: Browser und Google ignorieren ihn
- 2005Google führt nofollow ein
- 2019-09-10sponsored und ugc kommen; alle drei werden zu Hinweisen
- 2020-03-01Hinweise auch für Crawling und Indexierung
Was, wenn die Seite selbst nofollow sagt?
Dann folgt Google keinem ihrer Links, was auch immer das rel des einzelnen Links sagt. Ein robots-Meta-Tag oder ein X-Robots-Tag-Header mit nofollow gilt für die ganze Seite; dieses Tool markiert jeden Link mit „nofollow (Seite)“.
Google liest die Namen robots und googlebot in jedem Fall, selbst im Body, und none bedeutet noindex plus nofollow (Google). Dieselben Regeln können auch als Header kommen, etwa X-Robots-Tag: nofollow.
Die Versionsgeschichten von Wikipedia tragen noindex,nofollow mit Absicht. Die frühere Version dieses Tools las das Tag nie und zählte 194 der ersten 200 Links einer Versionsgeschichte als gefolgt.
der ersten 200 Links: Das Meta-Tag wurde nie gelesen
Links, alle nofollow (Seite): Google folgt keinem davon
543 nofollow (Seite)6 nofollowX-Robots-Tag: none
Defekte Links: so finden und beheben Sie sie
Ein Link ist defekt, wenn seine URL mit einem Fehler wie 404 Not Found oder 410 Gone antwortet oder auf einen solchen weiterleitet, oder wenn sein Name nicht existiert. Analysieren Sie die Seite und öffnen Sie dann den Tab „Defekt“.
Beheben Sie jeden, indem Sie auf die neue Adresse der Seite, eine archivierte Kopie oder auf nichts verlinken. Google entfernt 4xx-Seiten aus seinem Index (Google), und ein Leser, der dem Link folgt, landet im Leeren.
Nicht jeder Fehler bedeutet defekt: 401 verlangt ein Login, die Seite existiert also (RFC 9110), und 5xx oder eine Zeitüberschreitung vergehen oft, prüfen Sie sie später erneut. Im gelesenen Artikel waren 2 von 656 URLs defekt, beide in den Quellenangaben; eine dritte antwortete mit einem glatten 403, das wir als blockiert aufführen.
- umbrella.cisco.com404
Die Seite ist weg
Cisco hat den Blogbeitrag eingestellt; der Server sagt es unmissverständlich.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeVerlinken Sie die archivierte Kopie auf web.archive.org oder entfernen Sie den Link.- http://www.apwg.org301
- https://…/1H2010.pdf404
Eine Weiterleitung, die in einem 404 endet
http:// wechselt zu https://, und das PDF ist dort nicht. Als defekt gezählt, nicht als Weiterleitung.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfFinden Sie heraus, wo der Bericht jetzt liegt, oder zitieren Sie ein Archiv.- www.akamai.com403
Ein glattes 403: blockiert, nicht defekt
Der Server lehnte unseren Prüfer ohne Anzeichen von Bot-Schutz ab. Die Datei kann fehlen, oder der Server weist Bots ab.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfÖffnen Sie ihn im Browser; öffnet er sich, behalten Sie ihn.

Weiterleitungen in Links: lohnt sich die Korrektur?
Ein Link, der weiterleitet, funktioniert weiterhin, doch jeder Schritt kostet eine Anfrage und Zeit. Verweisen Sie auf die endgültige Adresse, vor allem bei Links innerhalb Ihrer eigenen Website, wo Sie beide Enden kontrollieren.
Ein 301 oder 308 sagt, der Umzug ist dauerhaft; ein 302, 303 oder 307 ist vorübergehend, und Google zeigt weiter die alte Adresse (Google). Googlebot folgt bis zu 10 Schritten, Browser bis zu 20 (Google).
rfc-editor.org leitet seine /rfc/-Seiten inzwischen auf /info/ weiter, daher brauchen 175 Links im gelesenen Artikel einen zusätzlichen Schritt. Eine Weiterleitung, die in einem 404 endet, zählt hier als defekt, nicht als Weiterleitung.
- doi.org/10.17487/RFC1035302302: vorübergehend, die alte URL bleibt maßgeblich
- www.rfc-editor.org/info/rfc1035301301: dauerhaft umgezogen, verlinken Sie die neue URL
- www.rfc-editor.org/info/rfc1035/200
Links zeigen auf rfc-editor.org/rfc/…, das jetzt auf /info/… weiterleitet
der 656 URLs der Seite leiten weiter
Schritte folgt Googlebot höchstens; Browser geben nach 20 auf
„Hier blockiert, aber im Browser funktioniert es“
Viele Websites stellen Bot-Schutz vor ihre Seiten. Er hält Besucher auf, die kein JavaScript ausführen oder automatisiert wirken, daher erhält unser Prüfer ein 403 oder 429, während Ihr Browser durchkommt. Diese Links erscheinen als Blockiert, nicht als defekt.
Cloudflare kennzeichnet seine Challenges mit einem cf-mitigated: challenge-Header (Cloudflare) und fordert Clients mit ungewöhnlichen User-Agents standardmäßig heraus; 429 bedeutet zu viele Anfragen (RFC 6585).
Wir senden einen ehrlichen User-Agent und versuchen nie, eine Sperre zu umgehen. Im gelesenen Artikel waren 18 URLs blockiert: 17 durch Cloudflare, AWS WAF, Akamai und Rate Limits, eine durch ein glattes 403. Öffnen Sie sie selbst, bevor Sie etwas ändern.
- Cloudflare-Challenge7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Rate Limit (429)3search.worldcat.org · api.semanticscholar.org · 429
- Akamai-Bot-Schutz1dyn.com → www.oracle.com · 403
Wie viele Links darf eine Seite haben?
Es gibt kein Limit. Googles Richtlinien nennen keine Zahl und sagen, dass es keine ideale Anzahl gibt; der alte Rat, unter 100 Links zu bleiben, stammt aus der Zeit, als Google nur einen Teil einer Seite las.
Entscheidend ist, dass jeder Link dem Leser hilft, dass die wichtigen echte <a href>-Links im HTML sind und dass sie in den ersten 2 MB HTML stehen, die Googlebot für die Suche überhaupt liest (Google).
Der gelesene Wikipedia-Artikel enthält 1.117 Links auf 528 KB HTML. example.com enthält in seinem HTML gar keinen: Sein einziger Link wird nach dem Laden der Seite von einem Skript eingefügt.
- wikipedia.org/wiki/Domain_Name_System1.117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0sein einziger Link wird von einem Skript eingefügt
Ankertext und Bildlinks
Der Ankertext ist der anklickbare Text eines Links; er sagt Lesern und Google, worum es beim Ziel geht. Bei einem Bildlink liest Google den alt-Text des Bildes als Anker, ein Bildlink mit leerem alt sagt also nichts.
Gute Anker sind kurz, konkret und beschreiben das Ziel; „hier klicken“ und „mehr lesen“ sagen niemandem etwas (Google). Hat ein Link keinen Text, greift Google auf das title-Attribut zurück.
Dieses Tool zeigt den alt-Text jedes Bildlinks, markiert leere und listet wiederholte Anker auf. Im gelesenen Artikel ist „edit“ der Anker von 49 Links: Bearbeiten-Links der Abschnitte, bei Wikipedia in Ordnung, anderswo schwach.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>AnkerDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>AnkerBildWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>AnkerLeernichts: ein leerer Link
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank und noopener: noch nötig?
Nicht in aktuellen Browsern. Ein Link mit target="_blank" öffnet einen neuen Tab, und jeder große Browser behandelt ihn heute wie rel="noopener": Die neue Seite kann nicht auf Ihre zurückgreifen und sie verändern. Fehlendes noopener wird als Hinweis aufgeführt, nicht als Risiko.
Der HTML-Standard ließ _blank 2019 noopener implizieren (HTML); Safari 12.1, Firefox 79 und Chrome 88 haben das umgesetzt. noreferrer verbirgt zudem, woher der Besucher kam: eine Entscheidung für Datenschutz und Analyse, keine Sicherheitslösung.
<a target="_blank">überhaupt kein relwindow.opener→ null- 2019-02HTML: _blank impliziert noopenerwhatwg/html #4330
- 2019Safari 12.1implizites noopener
- 2020Firefox 79implizites noopener
- 2021Chrome 88implizites noopener
- dnsrobot.net/blog/hosting-com-coupon23 von 23 haben noopener oder noreferrer
- github.com10 von 10 haben noopener oder noreferrer
- developer.mozilla.org/en-US/10 von 10 haben noopener oder noreferrer
Link-Mythen, geprüft an Googles eigenen Seiten
Die meisten Link-Ratschläge wiederholen ein paar alte Regeln. Hier steht, was Googles Dokumentation heute zu jeder sagt.
| Der Mythos | Was Google sagt | Quelle |
|---|---|---|
| Falsch„dofollow“ ist ein Attribut, das man hinzufügt | Links werden standardmäßig gefolgt; nur nofollow, sponsored und ugc bedeuten etwas. | developers.google.com |
| FalschNofollow bei externen Links führt zu einer Abstrafung der Website | Google verlangt nofollow oder sponsored nur bei bezahlten Links und Links, für die man nicht bürgt. | developers.google.com |
| ÜberholtEine Seite sollte unter 100 Links bleiben | Es gibt kein Limit und keine ideale Anzahl von Links pro Seite. | developers.google.com |
| FalschNofollow hält eine Seite aus dem Index | Um eine Seite aus Google herauszuhalten, erlauben Sie das Crawling und nutzen Sie noindex. | developers.google.com |
| ÜberholtNofollow-Links geben gar nichts weiter | Seit 2019 sind sie Hinweise: Google darf sie nutzen, zählt sie für das Ranking aber im Allgemeinen weiterhin nicht. | developers.google.com |
| Überholttarget=_blank ohne noopener ist eine Sicherheitslücke | Aktuelle Browser setzen bei _blank-Links noopener voraus, es sei denn, rel=opener verlangt den Opener. | html.spec.whatwg.org |
Quellen
- Google Search Central: crawlbare Links, qualifizierende ausgehende Links, robots-Meta-Tag, HTTP-Statuscodes
- HTML Living Standard (Links, rel-Werte, Basis-URL) und RFC 9110 (Statuscodes)
- Cloudflare: eine Challenge erkennen
- Die Zahlen: unser eigener Durchlauf auf en.wikipedia.org/wiki/Domain_Name_System, 23. Oktober 2026
FAQ zum Link-Analyzer
Ist dieser Link sicher zum Anklicken?
Wie finde ich alle Links einer Seite und kann ich die interne Verlinkung prüfen?
Was ist der Unterschied zwischen internen und externen Links?
Was bedeutet nofollow, und ist dofollow ein echtes Attribut?
Wann sollte ich rel="sponsored" oder rel="ugc" verwenden?
Warum ist ein Link „Blockiert“ markiert und nicht defekt?
Warum leitet ein Link weiter, und sollte ich ihn korrigieren?
Findet es Links, die JavaScript einfügt?
Die Seite blockiert automatische Abrufe. Kann ich sie trotzdem analysieren?
Wie viele interne und externe Links prüft das Tool?
Wie viele Links sollte eine Seite haben?
Ist der Link-Analyzer kostenlos, und speichern Sie die Seiten?
Weitere Website- und SEO-Tools
Subdomain-Finder
Alle Subdomains einer Domain entdecken
Website-Down-Checker
Ist die Seite für alle down oder nur für Sie? Prüfen Sie jede Website von 11 Orten und Ihrer eigenen Verbindung aus, mit Live-Screenshot
SSL-Zertifikat-Check
Gültigkeit und Sicherheitsdetails des SSL-Zertifikats überprüfen
Hosting-Checker
Finden Sie heraus, wer eine Website hostet: Webhoster, CDN, CMS, E-Mail-Anbieter, Registrar und SSL-Aussteller
WHOIS-Abfrage
Domain-Registrierung, Registrar und Inhaberdetails über RDAP nachschlagen
IP-Blacklist-Check
Prüfen, ob eine IP-Adresse auf Spam- oder Malware-Blacklists steht