











Анализатор ссылок
Анализ ссылок и проверка внешних ссылок: вы видите каждую ссылку страницы так, как её читает Google. Внутренняя или внешняя, с nofollow или без, sponsored или ugc, куда она ведёт на самом деле и какие ссылки битые.
Подойдёт и домен: example.org прочитает главную страницу.
- ЗагрузкаЧитает HTML один раз
- РедиректыДо 10, каждый проверяется
- Robotsmeta + X-Robots-Tag
- Найдено ссылок<a> и <area>
Что проверяет анализ ссылок на сайте?
Анализатор ссылок читает одну страницу и перечисляет все её ссылки: куда ведёт каждая, как она помечена для поисковых систем, что написано в её анкоре и куда она приводит на самом деле, если по ней перейти.
Он читает HTML страницы так, как его в первый раз видит Googlebot. Google переходит по элементам <a> с атрибутом href (Google); относительные ссылки разрешаются относительно <base href> страницы, а если его нет, то относительно её адреса после редиректов (HTML).
Затем каждый уникальный URL запрашивается один раз методом GET, а редиректы отслеживаются по одному переходу. Запрос HEAD быстрее, но серверы часто отвечают на него не так, как на настоящий визит, поэтому ссылка, которая за редиректом приводит на 404, здесь всё равно считается битой.
- 1Куда ведётвнешняяwww.rfc-editor.org
- 2Как помеченаnofollowmw:extlinkсохраняется, для SEO значения не имеет
- 3Что в ней сказано“1035”
- 4Куда приводит↳ 301 /info/rfc1035/OK 200185 ms
- 5Где стоитссылка 187 из 1 117, раздел «Contents»
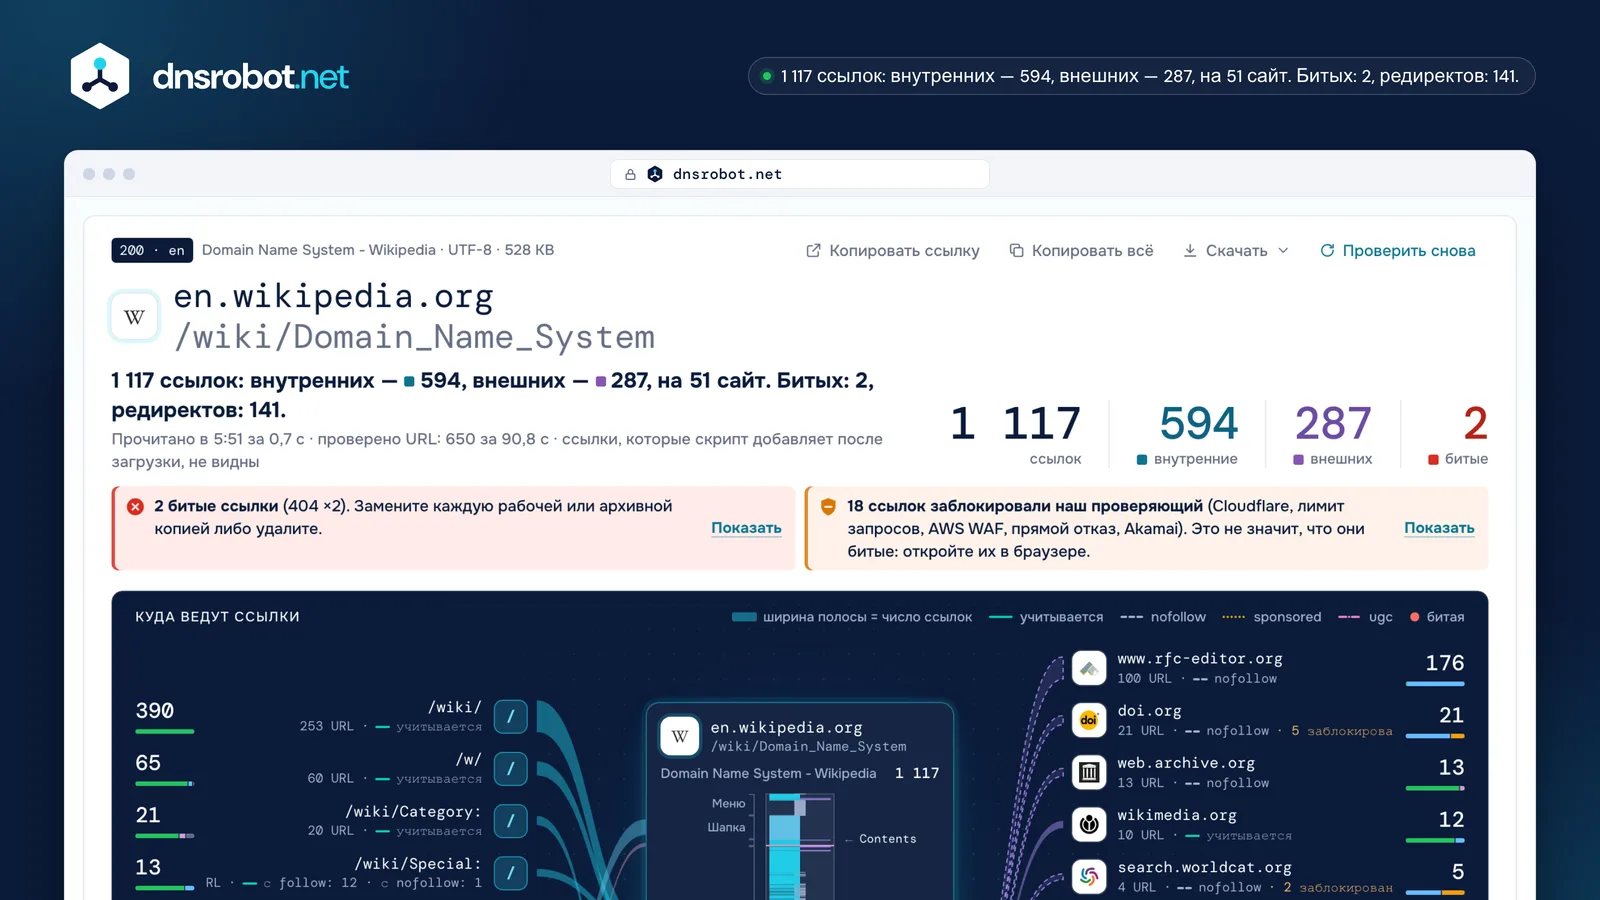
 Сначала ответСколько ссылок на странице, сколько остаётся на сайте, сколько ведёт наружу и сколько из них битых.Заметки с решениемБитые ссылки, ссылки, которые остановила только защита от ботов, редиректы, которые стоит обновить, пустые анкоры: у каждой заметки есть число и подсказка, что делать.Страница сверху внизОдна метка на ссылку там, где она стоит на странице: меню, статья, источники, подвал.Куда ведут ссылкиОдна полоса на раздел и на сайт, шириной с число ссылок, пунктиром, если ссылки nofollow.
Внутренние и внешние ссылки: анализ внешних ссылок и чем они отличаются
Внутренняя ссылка ведёт на тот же хост, что и страница; внешняя ведёт на другой сайт. Ссылки на другой хост того же сайта, например de.wikipedia.org с en.wikipedia.org, считаются отдельно.
Внутренние ссылки помогают читателям и поисковым роботам находить другие страницы сайта; на каждую важную страницу должна вести хотя бы одна ссылка с другой (Google). Внешние ссылки сами по себе не риск: ссылки на хорошие источники помогают читателям доверять странице.
Google советует nofollow только для ссылок, за которые вы не ручаетесь, а не для всех внешних. Ссылка на #section остаётся на той же странице, и Google не считает фрагменты отдельными страницами (Google).
- тот же хост 514
- тот же сайт, другой хост 80
- другой сайт 287
- эта же страница 235
- javascript: 1
- en.wikipedia.org/wiki/Domain_nameвнутренняяТот же хост, что и у страницы: внутренняя.
- de.wikipedia.org/wiki/Domain_Name_Systemтот же сайтТот же сайт (wikipedia.org), другой хост: считается отдельно.
- www.wikidata.org/wiki/Q8767внешняяДругой домен, хотя его ведёт Wikimedia: внешняя.
- www.rfc-editor.org/rfc/rfc1035внешняяДругой домен: внешняя.
nofollow, sponsored и ugc (и почему «dofollow» не атрибут)
rel="nofollow" просит поисковые системы не считать ссылку вашей рекомендацией, rel="sponsored" отмечает платную ссылку или рекламу, а rel="ugc" — ссылку, которую написали ваши пользователи. Ссылка без них учитывается: значения dofollow не существует.
С 10 сентября 2019 года все три значения — подсказки, а не команды, а с 1 марта 2020 года это относится и к сканированию и индексированию (Google). Значения можно сочетать, например ugc nofollow, через пробел или запятую.
Важнее всего одно: платная ссылка без sponsored или nofollow нарушает политику Google в отношении спама (Google). В статье Википедии, которую мы прочитали, nofollow есть у 267 из 287 внешних ссылок: MediaWiki добавляет его к каждому источнику.
<a href>Учитывается по умолчанию: ничего добавлять не нужноrel="nofollow"Не ручаюсь за неё: если другое значение не подходитrel="sponsored"Платная ссылка или реклама: нужно для платных ссылок (или nofollow)rel="ugc"Написана пользователями: комментарии, сообщения на форумахrel="ugc nofollow"Оба: разрешено, для более старых поисковых роботовrel="dofollow"Не значение: браузеры и Google его игнорируют
- 2005Google вводит nofollow
- 2019-09-10появляются sponsored и ugc; все три становятся подсказками
- 2020-03-01подсказки и для сканирования с индексированием
Что, если nofollow задан для всей страницы?
Тогда Google не переходит ни по одной её ссылке, что бы ни стояло в rel у самой ссылки. Мета-тег robots или заголовок X-Robots-Tag со значением nofollow действует на всю страницу; этот инструмент помечает каждую ссылку как «nofollow (страница)».
Google читает имена robots и googlebot в любом регистре, даже в теле страницы, а none означает noindex плюс nofollow (Google). Те же правила можно передать заголовком, например X-Robots-Tag: nofollow.
Страницы истории правок Википедии намеренно содержат noindex,nofollow. Прежняя версия этого инструмента такой тег не читала и считала учитываемыми 194 из первых 200 ссылок страницы истории.
из первых 200 ссылок: мета-тег не читался вовсе
ссылок, все nofollow (страница): Google не переходит ни по одной
543 nofollow (страница)6 nofollowX-Robots-Tag: none
Битые ссылки: как проверить внешние ссылки и исправить их
Ссылка битая, если её URL отвечает ошибкой вроде 404 Not Found или 410 Gone, ведёт на такой адрес через редирект или если её имени не существует. Проверьте страницу и откройте вкладку «Битые».
Исправьте каждую: поставьте новый адрес страницы, архивную копию или уберите ссылку. Google исключает страницы 4xx из индекса (Google), а читатель, перешедший по такой ссылке, никуда не попадает.
Не каждая ошибка означает, что ссылка битая: 401 просит войти, значит страница существует (RFC 9110), а 5xx или таймаут часто проходят сами, поэтому проверьте их позже. В прочитанной нами статье битыми оказались 2 из 656 URL, обе в источниках; третья ответила обычным 403, и мы показываем её как заблокированную.
- umbrella.cisco.com404
Страницы больше нет
Cisco убрала запись в блоге; сервер прямо об этом сообщает.
umbrella.cisco.com/blog/dnscrypt-critical-fundamental-and-about-timeУкажите архивную копию на web.archive.org или удалите ссылку.- http://www.apwg.org301
- https://…/1H2010.pdf404
Редирект, который заканчивается на 404
http:// переходит на https://, но PDF там нет. Считается битой ссылкой, а не редиректом.
www.apwg.org/reports/APWG_GlobalPhishingSurvey_1H2010.pdfНайдите, где отчёт лежит сейчас, или сошлитесь на архив.- www.akamai.com403
Обычный 403: заблокирована, а не битая
Сервер отказал нашему проверяющему без признаков защиты от ботов. Файла может уже не быть, или сервер не пускает ботов.
www.akamai.com/dl/technical_publications/network_overview_osr.pdfОткройте в браузере; если открывается, оставьте ссылку.

Редиректы в ссылках: стоит ли исправлять?
Ссылка с редиректом всё равно работает, но каждый переход стоит запроса и времени. Ведите ссылки на конечный адрес, прежде всего ссылки внутри своего сайта, где вы управляете обоими концами.
301 или 308 означает, что страница переехала навсегда; 302, 303 или 307 — временно, и Google продолжает показывать старый адрес (Google). Googlebot проходит не больше 10 переходов, браузеры — до 20 (Google).
rfc-editor.org теперь перенаправляет страницы /rfc/ на /info/, поэтому у 175 ссылок в прочитанной нами статье есть лишний переход. Редирект, который заканчивается на 404, здесь считается битой ссылкой, а не редиректом.
- doi.org/10.17487/RFC1035302302: временно, нужным остаётся старый URL
- www.rfc-editor.org/info/rfc1035301301: переехала навсегда, ссылайтесь на новый URL
- www.rfc-editor.org/info/rfc1035/200
ссылок ведут на rfc-editor.org/rfc/…, а он теперь перенаправляет на /info/…
из 656 URL страницы перенаправляют
переходов проходит Googlebot, браузеры сдаются после 20
«Здесь заблокирована, а в браузере открывается»
Многие сайты ставят перед страницами защиту от ботов. Она останавливает посетителей, которые не выполняют JavaScript или выглядят как скрипт, поэтому наш проверяющий получает 403 или 429, а ваш браузер проходит. Такие ссылки отмечены как заблокированные, а не битые.
Cloudflare помечает свои проверки заголовком cf-mitigated: challenge (Cloudflare) и по умолчанию проверяет клиентов с необычным user agent; 429 означает слишком много запросов (RFC 6585).
Мы отправляем честный user agent и не пытаемся обойти защиту. В прочитанной нами статье заблокированными оказались 18 URL: 17 из-за Cloudflare, AWS WAF, Akamai и лимитов запросов, один из-за обычного 403. Прежде чем что-то менять, откройте их сами.
- Проверка Cloudflare7dl.acm.org · onlinelibrary.wiley.com · queue.acm.org · 403
- AWS WAF6api.semanticscholar.org · ui.adsabs.harvard.edu · sgp.fas.org · 202 · 405
- Лимит запросов (429)3search.worldcat.org · api.semanticscholar.org · 429
- Защита от ботов Akamai1dyn.com → www.oracle.com · 403
Сколько ссылок может быть на странице?
Ограничений нет. Рекомендации Google не называют числа и говорят, что идеального количества не существует; старый совет держаться меньше 100 ссылок появился, когда Google читал лишь часть страницы.
Важно, чтобы каждая ссылка помогала читателю, чтобы важные из них были настоящими ссылками <a href> в HTML и чтобы они стояли в первых 2 МБ HTML, а только их Googlebot читает для Поиска (Google).
В статье Википедии, которую мы прочитали, 1 117 ссылок в 528 КБ HTML. В HTML example.com нет ни одной: его единственную ссылку добавляет скрипт после загрузки страницы.
- wikipedia.org/wiki/Domain_Name_System1 117
- www.wikipedia.org383
- developer.mozilla.org/en-US/158
- github.com142
- dnsrobot.net/blog/hosting-com-coupon100
- example.com0единственную ссылку добавляет скрипт
Текст анкора и ссылки-изображения
Текст анкора — это кликабельный текст ссылки; он подсказывает читателям и Google, о чём целевая страница. Для ссылки-изображения Google читает alt-текст картинки как анкор, поэтому у такой ссылки с пустым alt анкора нет.
Хорошие анкоры короткие, конкретные и описывают цель; «нажмите здесь» и «читать далее» ничего не говорят (Google). Если у ссылки нет текста, Google берёт атрибут title.
Этот инструмент показывает alt-текст каждой ссылки-изображения, отмечает пустые и перечисляет повторяющиеся анкоры. В прочитанной нами статье «edit» служит анкором 49 ссылок: это ссылки редактирования разделов, на Википедии нормально, в других местах слабо.
<a href="/wiki/DNS_over_HTTPS">DNS over HTTPS</a>анкорDNS over HTTPS<a href="/wiki/File:Wikiversity_logo_2017.svg"><img alt="Wikiversity logo"></a>анкорИзображениеWikiversity logo<a href="/wiki/File:DNS_Architecture.svg"><img alt=""></a>анкорПустоничего: пустая ссылка
- “edit”×49
- “Archived”×11
- “more...”×4
target=_blank и noopener: нужны ли ещё?
В современных браузерах нет. Ссылка с target="_blank" открывает новую вкладку, и все основные браузеры теперь считают её rel="noopener": новая страница не может обратиться к вашей и изменить её. Отсутствие noopener показано как заметка, а не как риск.
Стандарт HTML в 2019 году закрепил, что _blank подразумевает noopener (HTML); это реализовали Safari 12.1, Firefox 79 и Chrome 88. noreferrer дополнительно скрывает, откуда пришёл посетитель: это вопрос приватности и аналитики, а не исправление уязвимости.
<a target="_blank">вообще без relwindow.opener→ null- 2019-02HTML: _blank подразумевает noopenerwhatwg/html #4330
- 2019Safari 12.1неявный noopener
- 2020Firefox 79неявный noopener
- 2021Chrome 88неявный noopener
- dnsrobot.net/blog/hosting-com-couponnoopener или noreferrer есть у 23 из 23
- github.comnoopener или noreferrer есть у 10 из 10
- developer.mozilla.org/en-US/noopener или noreferrer есть у 10 из 10
Мифы о ссылках: проверка по страницам самого Google
Большинство советов о ссылках повторяют несколько старых правил. Вот что сегодня о каждом из них говорит документация Google.
| Миф | Что говорит Google | Источник |
|---|---|---|
| Неверно«dofollow» — атрибут, который нужно добавлять | Ссылки учитываются по умолчанию; значение имеют только nofollow, sponsored и ugc. | developers.google.com |
| НеверноNofollow на внешних ссылках приводит к штрафу для сайта | Google просит nofollow или sponsored только для платных ссылок и ссылок, за которые вы не ручаетесь. | developers.google.com |
| УстарелоНа странице должно быть меньше 100 ссылок | Ограничения нет, и идеального числа ссылок на странице тоже нет. | developers.google.com |
| НеверноNofollow не пускает страницу в индекс | Чтобы страницы не было в Google, разрешите сканирование и используйте noindex. | developers.google.com |
| УстарелоСсылки с nofollow вообще ничего не передают | С 2019 года это подсказки: Google может их учитывать, хотя при ранжировании в целом по-прежнему не считает. | developers.google.com |
| Устарелоtarget=_blank без noopener — дыра в безопасности | Современные браузеры подразумевают noopener для ссылок _blank, если только rel=opener не запрашивает opener. | html.spec.whatwg.org |
Источники
- Google Search Central: ссылки, по которым можно переходить, пометка исходящих ссылок, мета-тег robots, коды состояния HTTP
- HTML Living Standard (ссылки, значения rel, базовый URL) и RFC 9110 (коды состояния)
- Cloudflare: как распознать проверку
- Числа: наш собственный прогон на en.wikipedia.org/wiki/Domain_Name_System, 23 октября 2026 года
Анализатор ссылок: частые вопросы
Безопасно ли переходить по этой ссылке?
Как выполнить анализ ссылок на сайте и найти все ссылки страницы?
Как проверить внешние ссылки и чем они отличаются от внутренних?
Что значит nofollow и есть ли атрибут dofollow?
Когда использовать rel="sponsored" или rel="ugc"?
Почему при проверке внешних ссылок одна помечена «Заблокирована», а не битая?
Почему ссылка перенаправляет и нужно ли это исправлять?
Находит ли он ссылки, добавленные с помощью JavaScript?
Страница блокирует автоматическое чтение. Можно ли всё равно её проанализировать?
Сколько ссылок он проверяет?
Сколько ссылок должно быть на странице?
Бесплатен ли анализатор ссылок и хранятся ли страницы?
Другие инструменты для сайтов и SEO
Поиск поддоменов
Поиск всех поддоменов любого домена
Проверка доступности сайта
Сайт не работает у всех или только у вас? Проверьте доступность сайта из 11 точек и с вашего подключения, со скриншотом в реальном времени
Проверка SSL сертификата
Проверка действительности SSL сертификата и деталей безопасности
Проверка хостинга
Узнайте, кто хостит любой сайт: хостинг, CDN, CMS, почтовый провайдер, регистратор и издатель SSL
WHOIS Поиск
Поиск данных о регистрации домена, регистраторе и владельце через RDAP
Проверка IP в чёрных списках
Проверка IP адреса в списках спама и вредоносного ПО